 AIREITER
Qwen3.8-Max стала доступна в статусе GA с ценой $2 за миллион входных токенов и $6 за миллион выходных. По стоимости генерации она как минимум вчетверо дешевле Claude Opus 4.8, Claude Fable 5 и GPT-5.6 Sol. Однако параметр reasoning_effort по умолчанию установлен в xhigh, поэтому реальные расходы могут заметно отличаться от тарифной витрины уже с первого запроса.
Тарифы Qwen3.8-Max: вход, выход и кэш
Qwen3.8-Max — MoE-модель с 2,4 трлн параметров, из которых на каждый токен активны 95 млрд параметров. Она сменяет Qwen3.7-Max в роли флагманской модели Alibaba. Ниже — цены с страницы модели Alibaba, помеченной датой «Updated: Aug 2, 2026»:
| Позиция | Цена за 1 млн токенов |
|---|---|
| Входные токены | $2.00 |
| Выходные токены | $6.00 |
| Входные токены с неявным кэшем | $0.25 |
| Создание явного кэша | $2.50 |
| Чтение явного кэша | $0.17 |
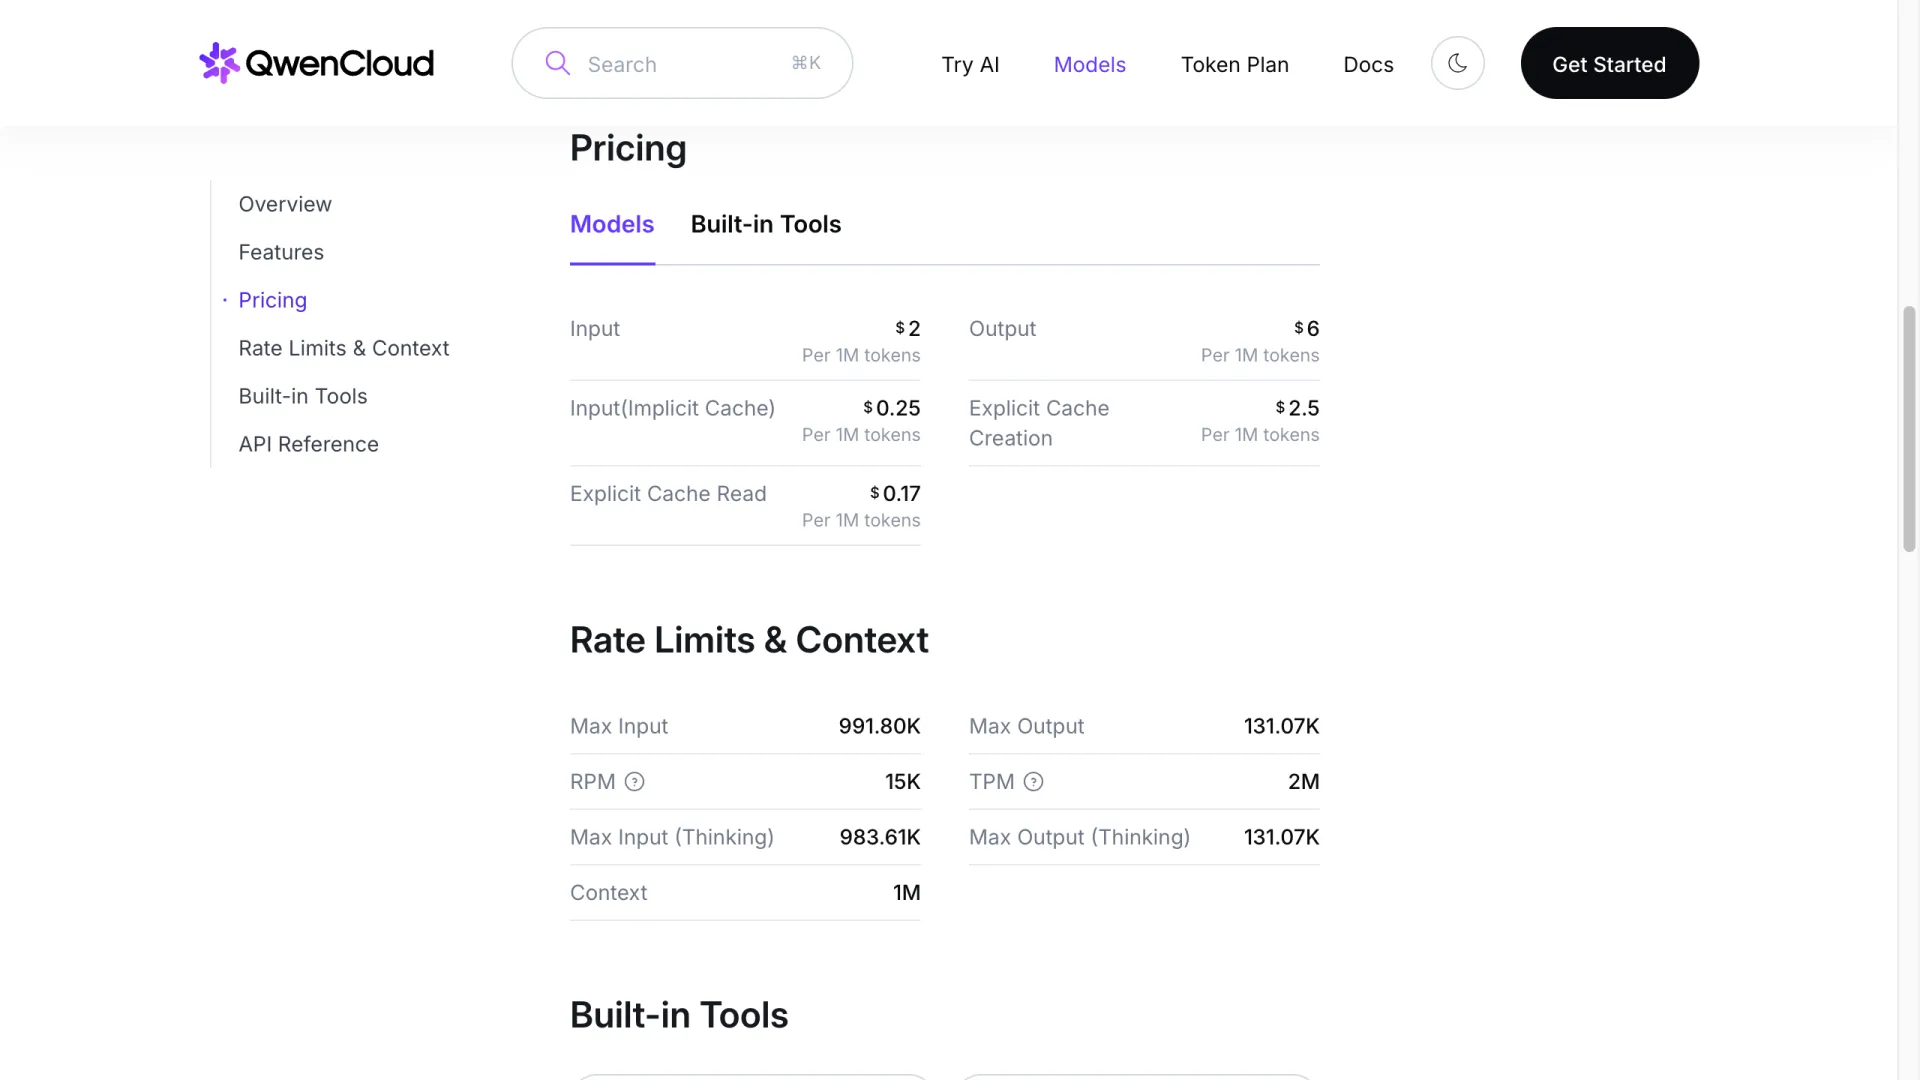
Неявный кэш работает автоматически и не требует изменений в коде: повторяющиеся префиксы тарифицируются по $0,25 — это одна восьмая обычной цены входа. С явным кэшем нужно принимать решение самостоятельно. Запись стоит $2,50, чтение — $0,17: по сравнению с некэшированным вводом схема начинает окупаться со второго чтения. Но неявный тариф $0,25 она обходит лишь примерно на тридцатом повторном чтении одного префикса. Для большинства приложений явный кэш можно просто не включать.
Есть и важное ограничение: API открыт, но веса пока нет. В анонсе Alibaba сказано, что веса Qwen3.8-Max появятся на Hugging Face и ModelScope на следующей неделе. Это первое конкретное обещание по срокам после нескольких недель с неопределённым «coming soon». По состоянию на 3 августа в боковой панели страницы модели всё ещё указано Open Source: No.
Почему $6 за выходной токен — не вся картина
Согласно документации к запуску, у reasoning_effort три режима, а по умолчанию выбран xhigh — самый глубокий из них. Ниже находятся medium, который «балансирует точность и скорость», и low, оптимизированный под скорость и стоимость. Параметр preserve_thinking также включён по умолчанию во всех сценариях. Токены рассуждений оплачиваются как выходные, то есть по ставке $6 ещё до того, как вы составите первый промпт.
Иными словами, оба ключевых параметра стоимости из коробки настроены не в вашу пользу, хотя каждый меняется одним параметром запроса. Переход на medium или low позволяет платить $6 за миллион только в тех задачах, где действительно нужна глубокая проработка, а не использовать её по умолчанию.
Один из первых тестировщиков сформулировал впечатление без дипломатии — прямо в заголовке обсуждения на r/LocalLLaMA:
Первые впечатления от Qwen 3.8 max: модель средняя и ужасна в режиме thinking
Это не бенчмарк и не готовый вывод о модели. Но это веская причина проверить каждый уровень effort на собственной нагрузке, прежде чем закреплять дефолтный режим в продакшене.
Длинный контекст до 1M без отдельной наценки
На странице Qwen3.8-Max указано по одной ставке для ввода и вывода — отдельных ценовых ступеней для контекста нет. У Gemini 3.1 Pro и GPT-5.6 Sol после определённого порога контекста включается более дорогой тариф:
| Модель | Вход (короткий контекст) | Выход (короткий контекст) | Вход (длинный контекст) | Выход (длинный контекст) |
|---|---|---|---|---|
| Qwen3.8-Max | $2.00 | $6.00 | $2.00 (до 1M) | $6.00 (до 1M) |
| Gemini 3.1 Pro | $2.00 (≤200K) | $12.00 | $4.00 (>200K) | $18.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $10.00 | $45.00 |
До 200K токенов Gemini 3.1 Pro совпадает с Qwen3.8-Max по цене входа, а затем удваивает ставку. У GPT-5.6 Sol при переходе в длинный контекст вход дорожает вдвое, а выход — ещё в полтора раза, причём это происходит поверх уже перестроенной тарифной сетки.
По мере роста контекста разрыв не остаётся прежним, а увеличивается. Входной промпт на 400K токенов обойдётся в $0,80 для Qwen3.8-Max, в $1,60 для Gemini 3.1 Pro и в $4,00 для GPT-5.6 Sol. В пайплайнах обработки документов, длинных агентных сессиях и задачах по целому репозиторию эта разница быстро накапливается. В коротких чат-диалогах она почти незаметна.
Как цена соотносится с моделями из сравнений Alibaba
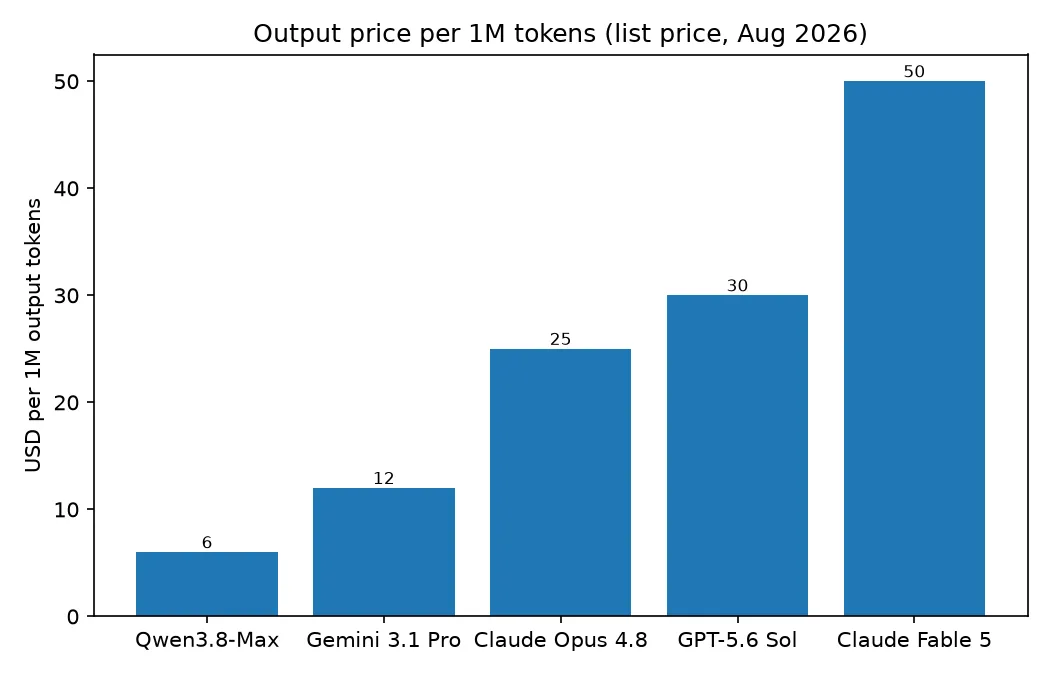
$6 за миллион выходных токенов — это менее четверти от $25 у Claude Opus 4.8 и пятая часть тарифа GPT-5.6 Sol в $30. Claude Fable 5 с ценой $50 стоит более чем в восемь раз дороже. Оправдана ли эта экономия с точки зрения возможностей — зависит от конкретной задачи. Alibaba приводит в пользу Qwen3.8-Max таблицу из 28 бенчмарков:
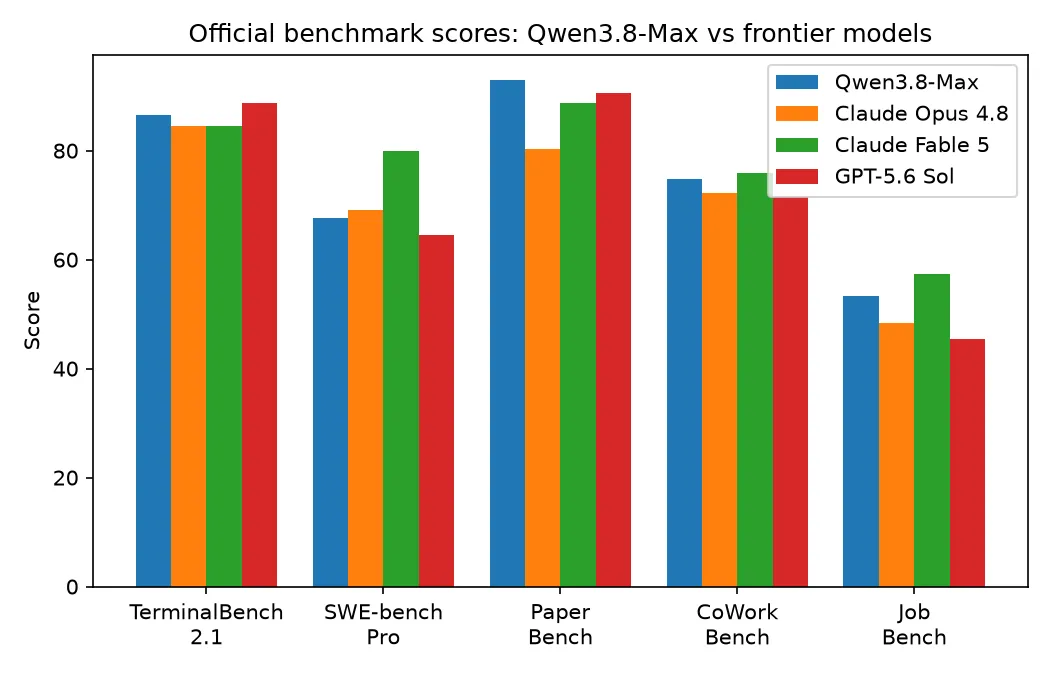
Qwen3.8-Max лидирует в PaperBench: 93,0 против 90,5 у GPT-5.6 Sol и 88,8 у Fable 5. В JobBench она набирает 53,4 против 48,4 у Opus 4.8, а в Terminal Bench 2.1 с результатом 86,6 немного опережает обе модели Claude. Зато в SWE-bench Pro отставание серьёзное: 80,0 у Fable 5 против 67,7 у Qwen3.8-Max — разрыв превышает двенадцать пунктов. Все эти результаты получены и опубликованы самим вендором на той же странице.
Практический выбор отсюда довольно очевиден. В агентных задачах с большим объёмом генерации — длинных циклах вызова инструментов, подготовке документов, воспроизведении исследований, которое измеряет PaperBench, — скидка на выходные токены в 4–8 раз меняет экономику запуска системы в принципе. В разработке на уровне целого репозитория, которую проверяет SWE-bench Pro, скидка сопровождается ощутимой потерей в возможностях. Здесь тарифы Fable 5 всё ещё могут быть оправданы.
Проверить это на своей нагрузке несложно: в анонсе Alibaba описаны совместимые с OpenAI вызовы chat-completions и responses, а также интерфейс, совместимый с Anthropic. Это те же два формата запросов, которые принимают Claude Opus 4.8 и GPT-5.6 Sol.
Что поменять в коде уже сейчас
Идентификатор модели — qwen3.8-max. На 3 августа это единственная запись серии 3.8 в каталоге моделей Alibaba: предварительный идентификатор qwen3.8-max-preview исчез. Поэтому перед расчётом на сохранившуюся preview-скидку проверьте своего relay-провайдера.
Оба интерфейса доступны через три региональных базовых URL: Пекин, Сингапур и Вирджиния в США. Вот лимиты, в которые вы упрётесь раньше всего:
| Лимит | Значение |
|---|---|
| Контекстное окно | 1M |
| Максимум входных токенов | 991.80K |
| Максимум входных токенов с thinking | 983.61K |
| Максимум выходных токенов | 131.07K |
| Запросов в минуту | 15K |
| Токенов в минуту | 2M |
Обратите внимание на разницу примерно в 8K токенов между двумя лимитами входа: включённый thinking забирает не только выходные токены, но и место в контекстном окне. А если обещанные на следующей неделе веса всё же выйдут, то показатель в 95 млрд активных параметров станет отправной точкой для сравнения самостоятельного хостинга с тарифом $2/$6.
FAQ
API Qwen бесплатный?
Нет. Qwen3.8-Max тарифицируется по токенам: $2 за миллион входных и $6 за миллион выходных. Подписка Token Plan, доступная на API-платформе Alibaba, — это отдельный продукт на основе кредитов, не связанный с поминутной тарификацией API по токенам.
Сколько стоит Qwen Max?
Для текущего поколения — $2 за миллион входных токенов и $6 за миллион выходных; неявное кэширование префиксов стоит $0,25. Более старые записи qwen-max в документации Alibaba Cloud относятся к предыдущим поколениям и имеют другие тарифы.
Есть ли у Qwen3.8-Max доплата за контекстное окно 1M?
Нет. Цена входа и выхода одинакова и при 5K токенов, и при 900K. Это главное структурное отличие от GPT-5.6 Sol и Gemini 3.1 Pro.
Qwen3.8-Max дешевле Qwen3.7-Max?
По официальным страницам ответить нельзя. На странице модели Qwen3.7-Max цены за токены отображаются как -- рядом с отметкой о скидке 50%, а не приводятся числом. Сравнивать не с чем.
Читайте также
- Тарифы Claude Fable 5: уровень $10/$50, с которым идёт сравнение
- Как сократить расходы на токены Claude Fable 5: те же рычаги effort и кэширования у другого вендора