В облачных тестах Inkling 2 Mini выжимает 280 токенов в секунду, но на ноутбуках ранние замеры дают от 8 до 220 токенов/с — всё зависит от железа и используемого рантайма. Это сильный вариант для офлайн-кодинговых агентов: модель с открытыми весами на 26,4 млрд параметров занимает примерно 20 ГБ. Но перед загрузкой стоит учитывать её слабые стороны в обычном чате, работе с фактами и доступности API.
Кому подойдёт Inkling 2 Mini, а кому лучше пройти мимо
Inkling 2 Mini уверенно закрывает одну задачу, но заметно хуже справляется с несколькими другими. Поэтому сначала определитесь со сценарием использования, а уже потом смотрите на таблицу бенчмарков. Сильная сторона модели — офлайн-помощь в программировании с инструментами и поиском. Для чата и работы только через API это далеко не лучший выбор.
| Ваш сценарий | Вердикт по Mini |
|---|---|
| Офлайн-кодинговый агент на Mac с 32 ГБ памяти и более или на DGX Spark | Отличный вариант: именно здесь получены лучшие результаты |
| Приватная работа с длинным контекстом (номинально до 1 млн токенов) | Стоит попробовать: на практике начните с контекста 32K |
| Многоходовой чат или строгое следование инструкциям | Лучше пропустить: здесь Qwen3.8-27B показывает себя лучше |
| Работа через готовый API уже сейчас | Лучше пропустить: серверлес-развёртывания пока нет, опубликованы только тарифы на семплирование и дообучение |
Дальше разберёмся, откуда берётся такой разрыв: что меняет циклическое выполнение слоёв, каким бенчмаркам можно доверять, какой скорости ждать локально и за что именно вы платите.
Что такое Inkling 2 Mini и как работает её цикл
Thinking Machines Lab выпустила Inkling 2 Mini 20 ноября 2026 года. Модель распространяется с открытыми весами по лицензии Apache 2.0. Веса доступны на Hugging Face под именем thinkingmachines/Inkling-2-Mini. Модель принимает текст и изображения, выдаёт текст и заявляет максимальный контекст в 1 млн токенов.
| Характеристика | Inkling 2 Mini |
|---|---|
| Релиз | 20 ноября 2026 года, Thinking Machines Lab |
| Лицензия | Apache 2.0 |
| Параметры | 26,4 млрд всего / 3,4 млрд активных на токен / 5,4 млрд эффективных с учётом циклов |
| Слои | 24 сохранённых; средние 12 выполняются 3 раза на токен (6 + 3×12 + 6 = 48 применений) |
| Маршрутизация MoE | 8 из 128 экспертов на токен в каждом слое |
| Точность | NVFP4 для 20 слоёв, MXFP8 для последних 4; чекпоинт около 20 ГБ (19,5 ГБ + 0,64 ГБ предиктора) |
| Контекст / модальности | До 1 млн токенов; на входе текст и изображения, на выходе текст |
| Локальные цели | Mac с 32 ГБ памяти и более через Ollama или один NVIDIA DGX Spark согласно карточке модели |
Число 3,4 млрд — это объём активных параметров, физически сохранённых в модели. Если учитывать три прохода через зацикленные слои, эффективная вычислительная нагрузка составляет примерно 5,4 млрд параметров. Повторное использование весов уменьшает размер файла, но увеличивает вычисления на каждый токен — это подробно разобрано в техническом разборе Hugging Face.
Циклы добавляют вычислительную работу, но не новые знания. В анонсе релиза Thinking Machines прямо отмечает, что Mini уступает старшим моделям Inkling в воспроизведении фактов: объём знаний в первую очередь растёт вместе с общим числом параметров. Поэтому поиск и внешние инструменты для этой модели особенно важны.
Каким бенчмаркам можно верить, а какие лучше воспринимать осторожно
Все приведённые ниже результаты получены в собственных тестовых стендах лаборатории и опубликованы в карточке модели на Hugging Face. Mini выигрывает в задачах, где нужно работать с инструментами и поиском, но уступает или идёт вровень в рассуждениях, работе с изображениями и дисциплине чата.
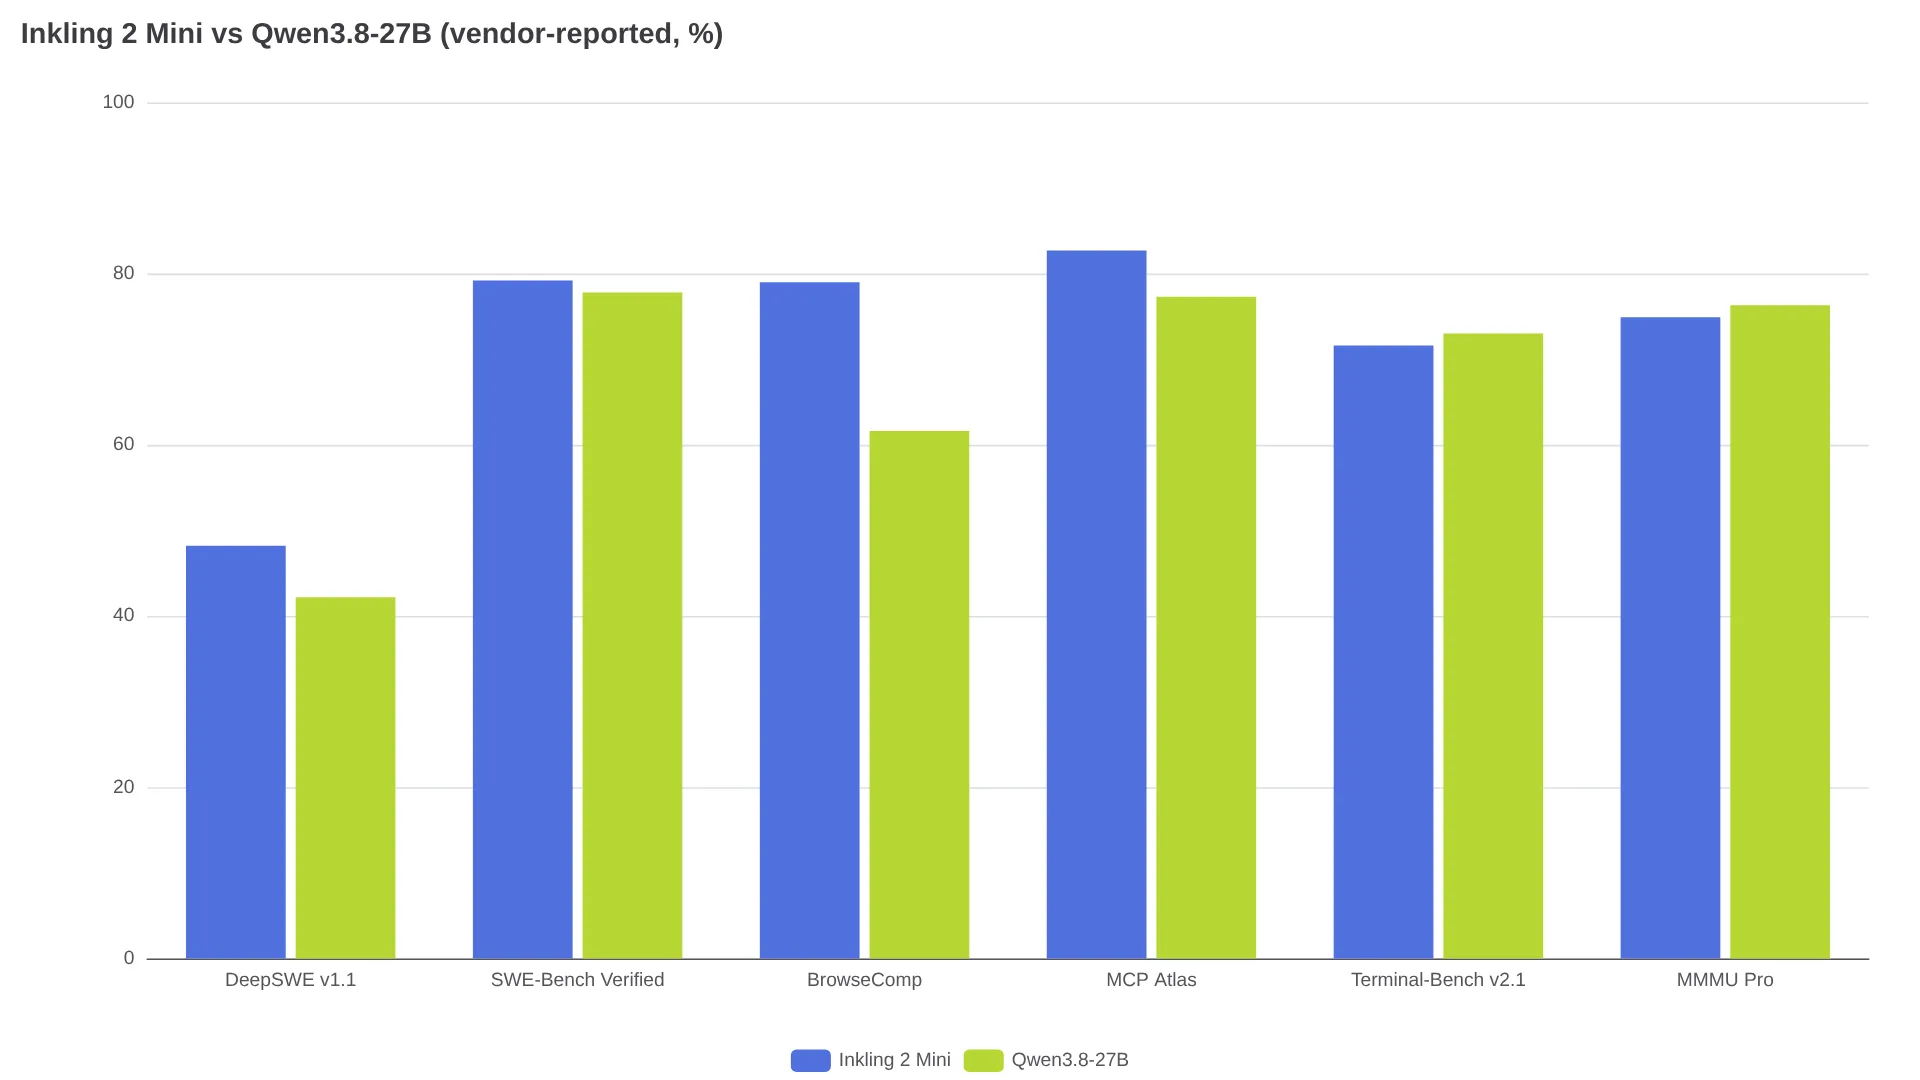
Mini опережает Qwen3.8-27B в DeepSWE v1.1 — 48,2% против 42,2%, SWE-Bench Verified — 79,2% против 77,8%, BrowseComp — 79,0% против 61,6% и MCP Atlas — 82,7% против 77,3%. По данным Artificial Analysis, обе модели получили по 20,1 балла в Intelligence Index, однако Mini выполнила тестовую задачу за 9,0 минуты против 38,2 минуты у Qwen. ARC Prize сообщает о результатах 84,5% в ARC-AGI-1 и 49,3% в ARC-AGI-2 на максимальной настройке рассуждений.
В остальных тестах Mini уступает. Согласно той же карточке модели, результат HLE-Diamond составляет 15,2% против 15,3%, MMMU Pro — 74,9% против 76,3%, а Terminal-Bench v2.1 — 71,6% против 73,0%. В фактической точности разрыв заметнее: в AA-Omniscience доля ответов без галлюцинаций — 63,4% против 71,4% у Qwen. В тестах ComplexConstraints (33,4%) и MultiChallenge (50,0%) Mini также отстаёт от Qwen.
Локальная скорость — это не одно фиксированное число
Официальная страница Ollama и карточка модели называют Mac с 32 ГБ памяти или DGX Spark целевыми платформами. Но поддержка looped-моделей пока развивается, поэтому реальная скорость сильно меняется. Облачный показатель в 280 токенов/с от Artificial Analysis почти ничего не говорит о производительности ноутбука.
| Конфигурация | Заявленная скорость | Источник |
|---|---|---|
| Облачный тест (Artificial Analysis) | 280 токенов/с | Замер сторонней площадки |
| RTX 4090, пропатченный vLLM + FP8/NVFP4 + drafter | ~190–220 токенов/с | Пользователь Reddit, только после патча (117 до патча) |
| M5 Max MacBook Pro | ~125 токенов/с | @alexocheema |
| M1 Max MacBook Pro, 64 ГБ, 4-битная квантизация | ~20 токенов/с | Пользователь Hacker News gregsadetsky, через обзор релиза eesel |
| Ранние сборки llama.cpp, разное железо | ~5–10 токенов/с | Обсуждение на r/LocalLLM |
«Не удалось добиться даже 5 токенов/с». — u/KURD_1_STAN, сравнительное обсуждение на r/LocalLLM
Большую часть разброса объясняют поддержка рантайма и квантизация. Свежие сборки лучше работают с зацикленными слоями, чем версии на старте, а выбор квантизации меняет занимаемый объём: рекомендуемый 4-битный вариант требует около 17,6 ГБ плюс 639 МБ для проектора зрения, согласно руководству Unsloth через Crewmark. При длинном контексте к этому добавляется нагрузка на KV-кэш.
В одном тесте сопоставления платежей при одинаковой задержке Qwen достигла точности 98,2% без ложных совпадений, а Mini — 96,9% с пятью ложными совпадениями:
«Проверили Inkling 2 Mini и Qwen3.8-27B на нашем реальном сценарии сопоставления платежей... Qwen: 98,2% точности, 0 ложных совпадений... Inkling: 96,9%, 5 ложных совпадений... Для этой задачи остаёмся на Qwen». — @exebat3 (пост)
Практический вывод простой: начните с контекста 32K, при нехватке памяти уменьшите его и обязательно проверьте, что ваша сборка рантайма поддерживает зацикленные слои. Иначе вы будете оценивать не саму модель, а проблемы совместимости.
Цена есть, а кнопки покупки нет
Согласно тарифам Tinker, приведённым на странице модели Artificial Analysis, миллион входных токенов стоит $0.15, кэшированных — $0.015, выходных — $0.50. Дообучение стоит $0.75 для контекста 64K и $1.50 для 256K. Если применить эти расценки к фактическому расходу токенов, одна задача из индекса обойдётся в $0.59 против $3.53 у Qwen3.8-27B.
Но $0.59 — это расчётная оценка, а не доступная для покупки цена размещённого сервиса. На момент обзора Mini не была представлена ни в одном серверлес-каталоге инференса — это проверено и описано в обзоре eesel для Tinker и OpenRouter. Кроме того, во время прогона индекса Mini сгенерировала 161 млн выходных токенов при медианном значении 85,7 млн, поэтому многословность частично съедает преимущество низкой цены за токен. При самостоятельном запуске сравнивайте стоимость железа, электричества и настройки с размещённым Qwen или API фронтирной модели.
Две настройки, от которых зависит результат
Интенсивность рассуждений можно выставить от none (0.0) через minimal (0.1), low (0.2), medium (0.7) и high (0.9, значение по умолчанию) до xhigh/max (0.99). Как отмечено в карточке модели, минимальное значение не отключает рассуждения полностью.
Меньшее значение иногда даёт лучший результат. В обсуждении Terminal-Bench на r/LocalLLM один из пользователей выполнил 10 из 13 задач при низкой интенсивности, тогда как средняя интенсивность неоднократно приводила к тайм-аутам. В другом тесте, о котором пишет обзор eesel, участник Hacker News потратил 19 200 токенов на рассуждения без инструментов и не завершил задачу; после включения поиска решение появилось, но с неправильным именем хука.
Ограничивайте число выходных токенов и ходов агента, запускайте работу с файловой системой в песочнице и проверяйте результаты человеком перед использованием в продакшене. Карточка модели предупреждает о разрушительных действиях без подтверждения и зацикливании рассуждений, особенно при отладке кода.
С чем придётся смириться перед загрузкой
Mini получает больше вычислений без увеличения размера чекпоинта за счёт повторного использования средних слоёв. Лаборатория также выпустила исследовательский чекпоинт с переменным числом циклов для изучения этого поведения (разбор). У модели есть вполне конкретные проблемные сценарии: зацикливание при отладке, зафиксированный пользователем внезапный переход на японский посреди ответа и вызовы инструментов, которым нужны жёсткие ограничения. Загружайте её для офлайн-программирования с защитными мерами. Если же вам нужен аккуратный чат или готовый API в один клик, лучше подождать.
FAQ
Запустится ли Inkling 2 Mini на ноутбуке?
Да, если использовать подходящую сборку: Mac на Apple Silicon с 32 ГБ памяти и более через Ollama или актуальную версию llama.cpp, желательно с 4-битной квантизацией (около 17,6 ГБ плюс проектор). На старом M1 Max стоит ожидать примерно 20 токенов/с, а на M5 — более 100 токенов/с. Непропатченные рантаймы могут работать на скорости в единицы токенов в секунду — см. таблицу выше.
Inkling 2 Mini лучше Qwen3.8-27B?
Для кодинговых агентов — да, для чата — нет. На графике выше видно, что Mini лидирует в DeepSWE, SWE-Bench Verified, BrowseComp и MCP Atlas, а Qwen — в Terminal-Bench v2.1, MMMU Pro, фактической точности и задачах с жёсткими ограничениями. Все показатели опубликованы разработчиками в карточке модели.
Почему источники указывают и 3,4 млрд, и 5,4 млрд активных параметров?
3,4 млрд — это сохранённые активные параметры, а 5,4 млрд учитывает три прохода через циклы примерно по 1,0 млрд каждый. Для оценки вычислительной нагрузки используйте 5,4 млрд, для оценки требований к памяти — 3,4 млрд.
Можно ли уже сейчас обращаться к Inkling 2 Mini через размещённый API?
Нет, на момент обзора собственного серверлес-эндпоинта не существовало. Tinker публикует тарифы на семплирование и дообучение, но серверлес-развёртывания Mini там нет — это подтверждает проверка eesel. Пока остаётся запускать веса Hugging Face локально или ждать появления модели у провайдеров.
Как остановить зацикливание рассуждений?
Сначала попробуйте низкую интенсивность (0.2), ограничьте число выходных токенов и ходов агента, а инструменты запускайте в песочнице — именно это рекомендует карточка модели.
Читайте также: обзор Inkling 2 Small и цены API — для сравнения с 594B-собратом Mini; лучшие LLM для кодинговых агентов в 2026 году — чтобы сравнить Mini с другими вариантами для агентов; руководство по llama.cpp v1.0 — рантайму, от которого зависит локальный запуск Mini.