В режиме high Neon выглядит самым выгодным вариантом для агентов с длинным контекстом, если особенно важен низкий процент ошибочных ответов. При этом Astra и Sol обходятся дешевле на одну задачу. Это сводка на момент запуска, основанная на официальных характеристиках, рейтингах и независимых тестах. Лично Neon я не запускал.
Neon — более быстрая версия Carbon для агентов, но с одним заметным компромиссом
Gemini 4 Neon вышла 18 ноября 2026 года под именем gemini-4-neon. В линейке Gemini 4 она занимает промежуточное место между Hydrogen и Carbon — это подтверждают Google и 9to5Google. По данным Google, Neon завершает задачи быстрее Carbon и стоит дешевле в расчёте на задачу. То же отмечают сотрудники DeepMind, называя её более дешёвой и быстрой по сравнению с Carbon (@_mohansolo). В рейтинге Artificial Analysis модель занимает 3-е место с результатом 61 в режиме xhigh, а в Agent Arena — 2-е место с результатом 1336 по итогам более 4 200 сессий. В материалах запуска не были опубликованы результаты Opus 5.5 и Fable 5.2 в той же Arena, поэтому ниже прямое сравнение основано на позициях в индексах и тестах на одинаковых задачах.
Цена, контекст и доступные площадки
Стоимость Neon составляет $3 за миллион входных токенов, $15 за миллион выходных и $0.15 за миллион кэшированных входных токенов — согласно Google. Контекстное окно вмещает 1 048 576 токенов, а максимальный размер одного ответа — 65 536 токенов. Уровни рассуждений low / medium / high (по умолчанию) / xhigh тарифицируются как выходные данные: чем выше уровень, тем больше токенов может уйти на рассуждение и тем выше итоговый счёт. Режим high по умолчанию подтверждают разбор DataCamp и заметки SpringPrompt об API.
Модель доступна только на платных условиях, бесплатного тарифа нет — это подтверждает проверка API от eesel. Согласно Google и 9to5Google, Neon работает в платном API AI Studio, Gemini для бизнеса, Antigravity (Pro/Ultra), приложении Gemini (Pro/Ultra, заменяет Argon) и Android Studio. Кроме того, она доступна в Cursor, где показывает 63.7% в CursorBench при стандартном уровне усилий против 57.3% у Hydrogen, по данным Cursor.
| Модель | Вход / выход за 1 млн токенов | Уровень рассуждений по умолчанию |
|---|---|---|
| Gemini 4 Neon | $3 / $15, кэшированные $0.15 | high |
| Gemini 4 Hydrogen | $1.50 / $7.50 | high |
| Gemini 4 Carbon | $2 / $10 до 30 ноября, затем $4 / $20 | medium |
| Claude Opus 5.5 | $4 / $20, протестирован максимальный режим | максимальный режим |
| GPT-6.2 Sol | $2 / $10, протестирован максимальный режим | максимальный режим |
Цены конкурентов и обозначения оптимальных режимов собраны в сравнительной таблице eesel. С 1 декабря Neon будет на 25% дешевле Carbon в пересчёте на токен. Подробности — в материале о ценах Neon.
API позволяет вручную зафиксировать уровень рассуждений, а приложение или Antigravity подойдут для работы с управляемой квотой. Оценки расхода квоты — лишь ориентир из пользовательских наблюдений: примерно 1–3% квоты Pro на один чат против примерно 5% за десятиминутный запуск с тремя субагентами, согласно отчётам пользователей.
Бенчмарки: Opus 5.5, Fable 5.2 и Sol
Результаты предоставлены разработчиками через Google и собраны в материалах eesel и DataCamp.
| Тест | Neon | Конкурент | Вывод |
|---|---|---|---|
| Vals Index | 70.9%, 2-е место | Fable около 71.3% | Почти вершина рейтинга |
| AutomationBench | 56.3%, 1-е место | Opus 42.5%, Sol 41.3% | Лидер среди агентов |
| GraphWalks 256K–1M | 95.2% | Opus 66.8%, Sol 80.1% | Лидер на длинном контексте; сначала прогоните самый длинный файл, поскольку некоторые пользователи Argon жалуются на чрезмерное суммирование (обсуждение) |
| Terminal-Bench 4.1 | 65.2% | Opus 65.8% | Почти ничья, преимущество Opus — 0.6 |
| FrontierCode 2.0 | 46.2% | Opus 47.3% | Преимущество Opus — 1.1 |
| CursorBench 4.1 | 63.7–65.4% | Opus 58.1% | Neon лидирует в стандартном режиме усилий |
Если считать стоимость задачи, расстановка меняется — одна лишь цена токенов не даёт полной картины. Данные приводит Artificial Analysis через eesel:
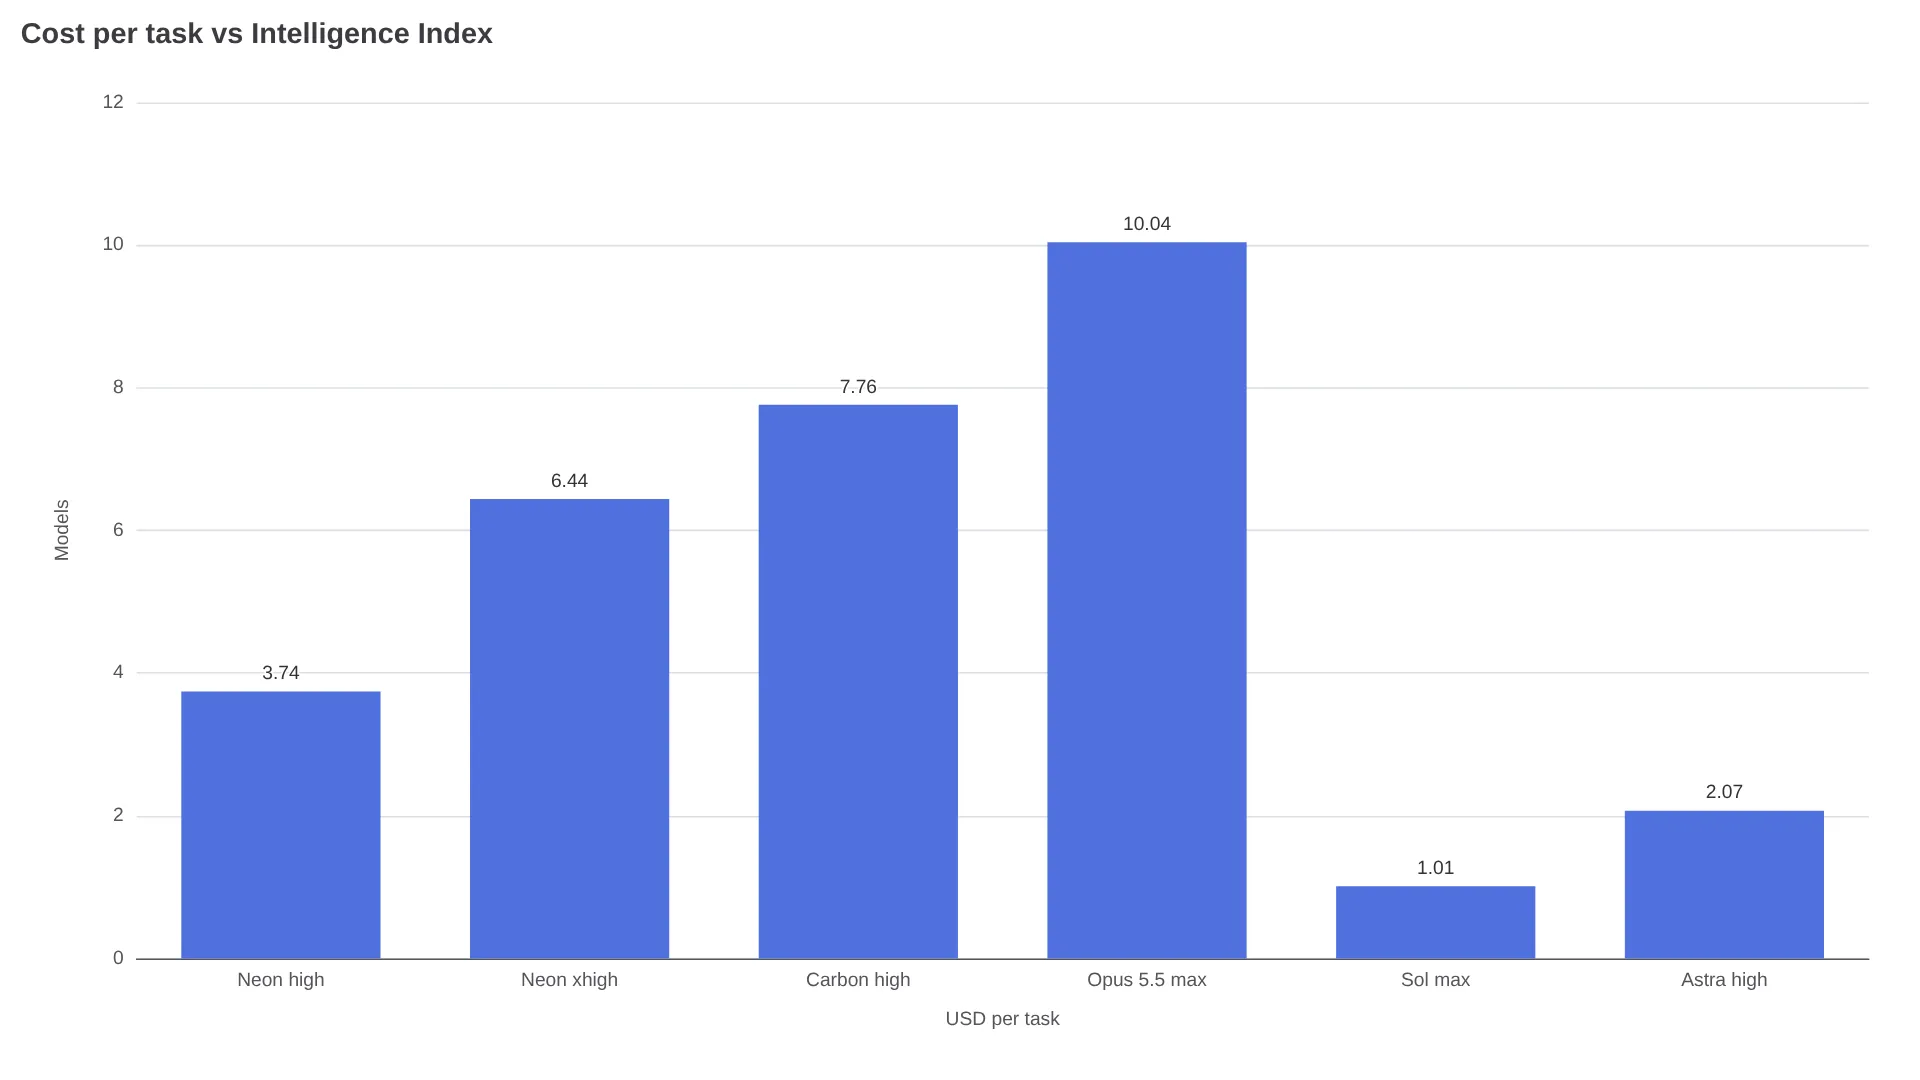
Neon в режиме high набирает 59.6 за $3.74 и справляется за 14.8 минуты; Carbon в high получает 60.0 за $7.76 за 37.2 минуты; Opus в максимальном режиме — 59.1 за $10.04; Astra в high — 60.1 за $2.07; Sol в максимальном режиме — 57.3 за $1.01. В режиме xhigh Neon достигает 61.4, стоимость составляет $6.44, а время — 21.5 минуты. Используйте high, если дополнительные 1.8 балла не стоят $2.70 и 6.7 минуты.
Neon против Fable 5.2: первые отчёты говорят в пользу связки из двух ролей
В SWE-sweep с провайдерским harness Antigravity Neon получила 39.0% против 10.1% у Opus и 8.3% у Sol. В общем mini-SWE harness результаты составили 12.8% у Neon, 11.6% у Sol и 3.6% у Opus, согласно DataCamp. Значительная часть разрыва в заголовочных цифрах объясняется harness, а не чистой разницей между моделями.
«Я использую Fable 5.2 как оркестратор и разработчика, а Neon — как набор агентов для написания кода. Это лучшая связка из всех, что я когда-либо запускал». — u/1969Stingray (обсуждение)
По отдельным отзывам, пользователи предпочитают Fable для оркестрации, а Neon — для реализации. На собственном репозитории такую связку всё равно нужно проверить. В AA-Omniscience Neon даёт 14% ответов, где модель ошибается вместо того, чтобы отказаться от ответа, против 50% у Opus, 55% у Sol, 58% у Astra и Fable. Но доля правильных ответов у Neon составляет 59–60%, тогда как у Astra — 66%, а у Fable — 77%, согласно eesel.
Практические тесты: шахматы, каталоги и 105 реальных багов
| Тест | Результат | Ограничение |
|---|---|---|
Шахматная страница, 3 запуска в режиме medium (DataCamp) | Neon — 3/3 при стоимости $0.83–$1.06; Carbon — 1/3, в двух запусках достигнут лимит 65K; 16 партий, ни одного нелегального хода | Одна задача; вероятно, Carbon завершил бы её в фоновом режиме |
| Фактическая точность в CatalogBench (SpringPrompt) | 78.6% готовых к публикации результатов в трёх запусках, 1-е место из 35; модель считывает характеристики с упаковки | Продажи — 32.1%, презентации — 24-е место, опросы — 22-е место при ограниченном бюджете |
| 105 искусственно внесённых багов (@PawelHuryn) | Neon xhigh — 63 против 62.7 у Astra, 58 у Fable и 57.3 у Carbon | Один тестировщик |
SpringPrompt использовал OpenRouter с режимом medium, тогда как API Google по умолчанию работает в high, поэтому объём ответов отличается. Есть отдельные сообщения об утечке данных в AI Studio (обсуждение). Для чатов замеры eesel дают Neon xhigh 56.5 секунды до появления первого токена, поэтому для интерактивных ответов лучше выбрать medium или Hydrogen.
Выбирайте модель под конкретную нагрузку
| Задача | Что выбрать | Почему |
|---|---|---|
| Сложные агенты, большие документы, рефакторинг | Neon high | 59.6 за $3.74, 2-е место в Agent Arena, 3/3 в шахматном тесте |
| Проекты с самым длинным горизонтом выполнения | Carbon, согласно позиционированию семейства Google | Google оставляет Carbon для самых сложных проектов; прямого теста на одинаковой задаче здесь нет |
| Оркестрация и написание кода | Fable в роли ведущей модели + Neon для кодинга | Гибридная схема выше подтверждена лишь отзывами; сначала проверьте её сами |
| Минимальная стоимость задачи | Sol в максимальном режиме за $1.01; Astra high за $2.07 даёт более высокий результат | У обеих моделей была более высокая доля ошибочных ответов в AA-Omniscience |
| Интерактивный чат | Hydrogen или Neon medium | Задержка первого токена в xhigh слишком велика для чатов |
| Регулируемые отрасли | Подождать публикации документации | Полный отчёт по безопасности всё ещё ожидался 19 ноября; одобрять модель стоит только после проверки нужных вам документов |
Как проверить модель за один рабочий день
Возьмите один и тот же запрос, те же файлы и одинаковый бюджет рассуждений. Сравните Neon high, текущую модель по умолчанию и одну недорогую альтернативу. Зафиксируйте успешность, стоимость, время и количество ошибочных ответов. Для вашей очереди задач такой тест будет полезнее любого общего рейтинга. Расчёты для Opus — в обзорах Opus 5.5 и Fable 5.2.