Агенту не обязательно тащить в контексте полные JSON-схемы сотен инструментов. Tool Retrieval в Gemini API оставляет модели названия и описания, а параметры подгружает только для нужных в конкретной задаче инструментов. Но есть важная оговорка: каждый поиск запускает дополнительный проход модели. Если поиск нужен почти на каждом ходу, итоговая стоимость может вырасти, а не снизиться.
Google представила функцию в preview 19 ноября 2026 года. Она доступна только в Interactions API и добавляет инструмент tool_search вместе с флагом defer_loading: true. У отложенных инструментов модель видит имя и описание, но JSON параметров не попадает в контекст заранее. Отдельной платы за функцию нет: действуют обычные тарифы на входные, кэшированные входные и выходные токены.
Как 200 инструментов съедали 164 000 токенов ещё до первого вызова
Стоимость промпта определяется не только числом инструментов, а прежде всего объёмом их схем. Поэтому большой каталог легко становится самой тяжёлой частью контекста.
В независимом техническом разборе документации Google приведён показательный разрыв: для библиотеки из 200 инструментов, когда в каждом запросе задействованы лишь несколько, получается примерно 164 000 входных токенов без отложенной загрузки и около 23 650 с Tool Retrieval. Это округлённая иллюстрация из разбора, а не бенчмарк. Суть в другом: не приходится постоянно оплачивать схемы, к которым задача не обращается.
Есть и вопрос точности. Когда в контексте одновременно лежат десятки похожих схем, у модели становится больше возможностей выбрать не тот инструмент. Google позиционирует Tool Retrieval как способ снизить токенную нагрузку и повысить точность выбора. Численных данных о точности компания не публикует, поэтому эту часть стоит проверять на собственных задачах.
Как устроен Gemini Tool Retrieval: tool_search и defer_loading
Для настройки нужны две сокращённые декларации: запись tool_search вида {"type": "tool_search"} и "defer_loading": true у каждого отложенного инструмента. Полная структура запроса показана в разборе документации. Имя и описание каждого такого инструмента всё равно остаются доступны модели. Как поясняется в материале о defer_loading, при заданном short_description модель получает именно его; иначе она видит первое предложение полного описания.
В серверном режиме весь сценарий укладывается в один запрос:
- Модель отправляет
tool_search_call— например, с запросом инструментаissue_refund. - API возвращает
tool_search_resultс полной схемой. - Модель делает настоящий
function_call(в примере Google для возврата используютсяorder_id: "A-1042"иamount: 40с модельюgemini-4-hydrogen). - Ваш код выполняет вызов и возвращает
function_result.
Логируйте всё в interaction.steps. Если загружается неверный инструмент, первым делом посмотрите трассировку: часто проблема в слишком расплывчатом названии или описании.
Серверный и клиентский поиск: один запрос или отдельный round trip
| Режим | Кто выполняет поиск | Какой индекс нужен | Дополнительные round trip | Лучший сценарий |
|---|---|---|---|---|
| Серверный (по умолчанию) | Gemini | Не нужен — "There's no index to build or host." | Нет, всё в рамках одного запроса | Большие преимущественно статичные библиотеки; целые MCP-серверы |
Клиентский ("execution": "client") | Ваше приложение | Ваш реестр или embedding-индекс | Один на каждый поиск | Права доступа на пользователя, закрытые реестры, инструменты, появляющиеся в середине диалога |
Для серверного поиска не нужен хостируемый индекс, а результат приходит в том же ответе. Согласно разбору документации, если задать defer_loading: true для инструмента mcp_server, загрузка откладывается для всех инструментов, которые предоставляет этот сервер.
В клиентском режиме используется tool_search с "execution": "client": в примере это search_tools с обязательной строкой query. Приложение возвращает совпадения в function_result, после чего вызывает client.interactions.create, передавая previous_interaction_id. По данным того же разбора, на запрос допускается только один tool_search, а смешивать два режима нельзя.
Клиентский вариант выбирайте, если доступ зависит от пользователя или интеграции могут появляться уже во время диалога. Как отмечает цитируемый анализ, серверный поиск по общему каталогу сам по себе не фильтрует инструменты по правам конкретного пользователя. Этот же режим позволяет добавлять инструменты в середине разговора, не объявляя весь набор заранее.
Экономика Gemini Tool Retrieval: 26 токенов сейчас и ещё один полный проход потом
Как говорится в анонсе Google, у Tool Retrieval нет отдельной платы: "Tool Retrieval has no separate charge." Однако, согласно разбору экономики токенов, остаются четыре тарифицируемых составляющих:
tool_searchдобавляет к каждому запросу небольшой фиксированный блок входных токенов.- Цитируемый анализ оценивает строку с именем и описанием отложенного инструмента примерно в 26 токенов.
- Каждый серверный поиск запускает ещё один проход модели по текущему контексту. По данным анализа, он учитывается в
total_tool_use_tokensпримерно как объём входного промпта за вычетом попаданий в кэш. - После загрузки схема инструмента продолжает тарифицироваться как входной контекст до конца диалога; выгрузить её нельзя.
| Нагрузка (иллюстративные оценки из цитируемого анализа) | Без retrieval | С retrieval | Итог |
|---|---|---|---|
| 200 инструментов, для задачи нужны лишь несколько | ~164 000 токенов | ~23 650 токенов | Экономия |
| 10 инструментов, контекст 30k, поиск почти на каждом ходу | ~68 000 токенов | ~92 830 токенов | Дороже |
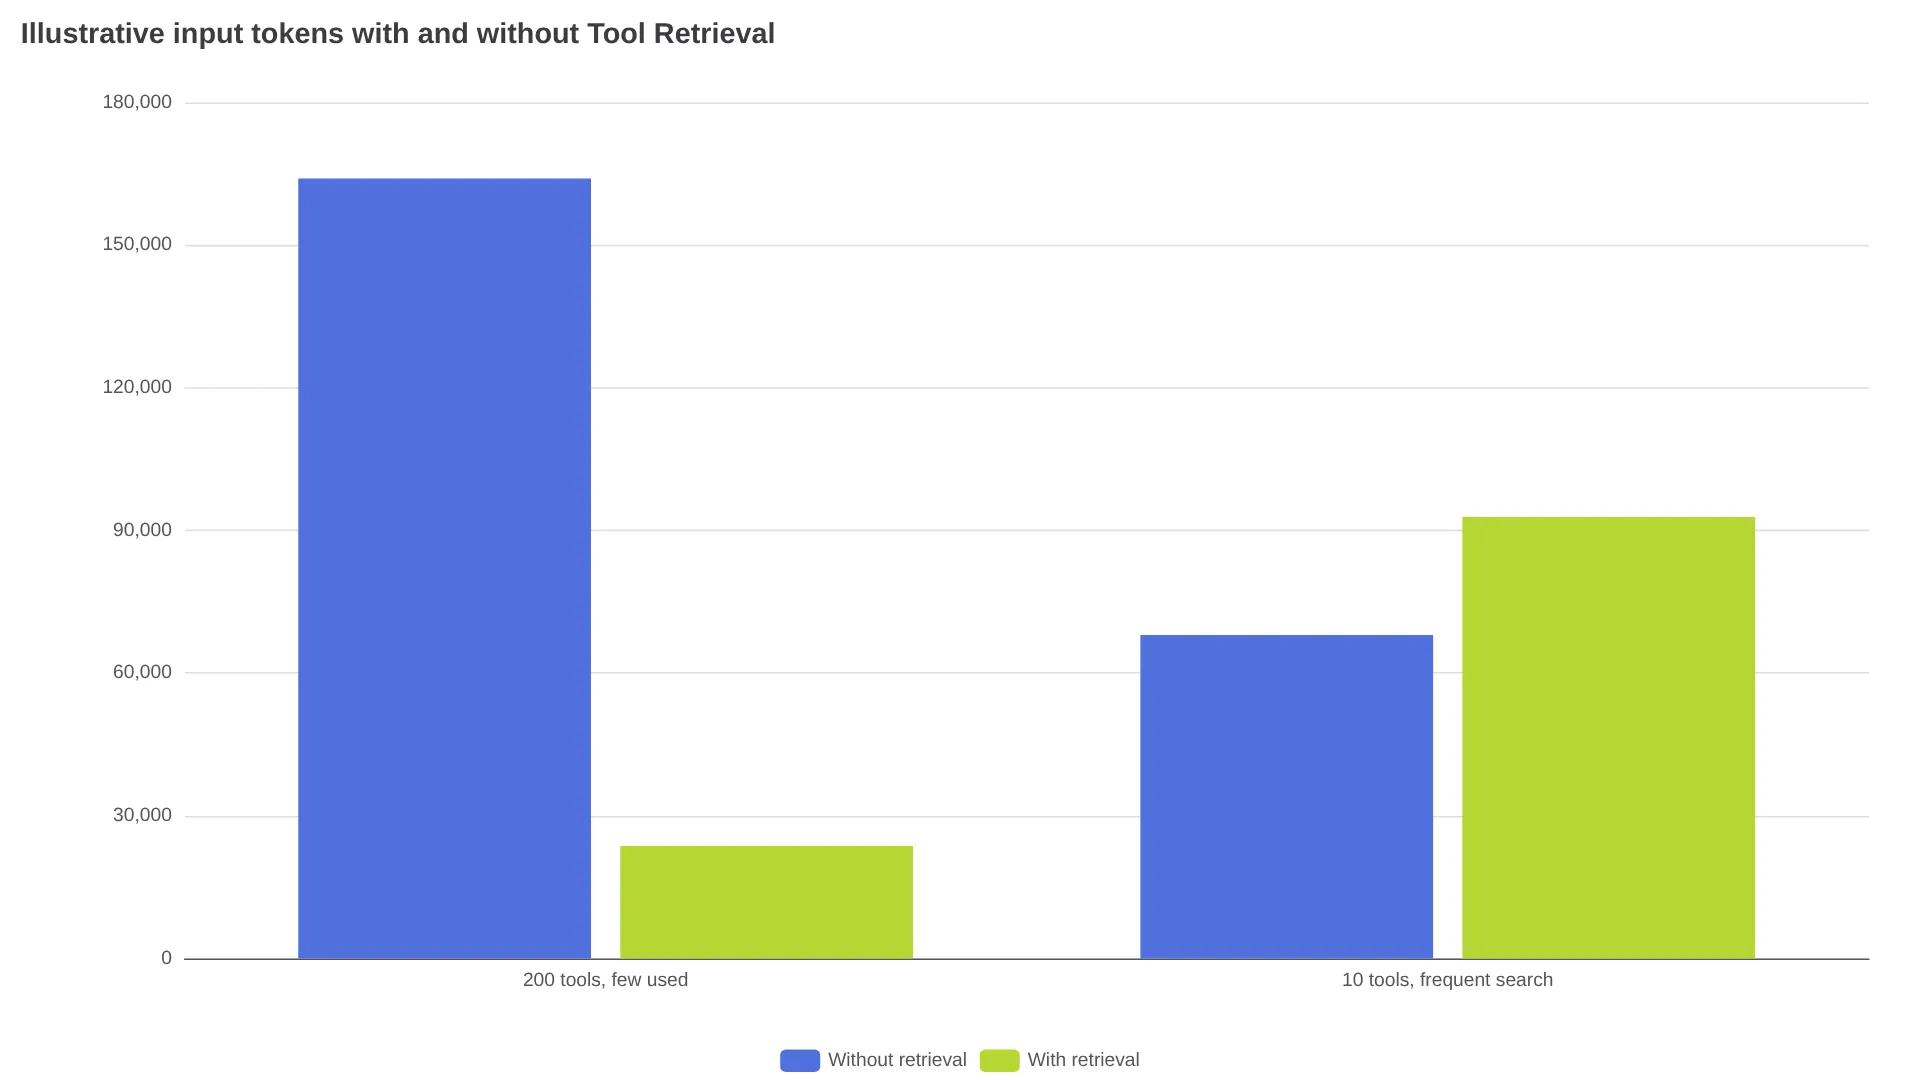
Рекомендация Google из того же анонса проста: "Measure it against your own traffic."
"In server-side mode... every server-side search adds another model pass over the current context... So a big library where each task uses a few tools can benefit. A small library with a long conversation and frequent searches can cost more." — @tekroch
Отложенная загрузка может сделать кэшируемый префикс стабильнее, но способна и опустить промпт ниже порога размера для кэширования. Поэтому, как советует цитируемый анализ, отслеживайте cache-hit rate вместе с входными токенами.
Когда откладывать загрузку, а когда держать схемы в контексте
Для небольших библиотек сначала сравните со статической загрузкой: важнее частота поиска и размер схем, а не произвольный порог по числу инструментов. В большом каталоге, где на задачу приходится 1–3 инструмента, отложите серверную загрузку длинного хвоста, а часто используемые инструменты — те, что нужны в большинстве запросов, — оставьте загруженными. Если инструменты зависят от пользователя или появляются посреди чата, используйте клиентский режим и закладывайте один round trip на поиск.
В цитируемых заметках по реализации перечислены три проблемы, которые нужно предусмотреть:
- Не откладывайте инструмент, упомянутый в системных инструкциях или выводе другого инструмента: модель может попытаться вызвать его без поиска, и следующий ход завершится ошибкой.
- Даже для отложенных функций в запросе нужны полные
parameters; вариант только с именем и описанием может вернуть пустую схему, которую нельзя вызвать. - В stateless-приложениях на каждом ходу без изменений передавайте
tool_search_call,tool_search_result, сигнатуры и полный массивtools.
Качество описания определяет результат поиска: до загрузки схемы модель выбирает по именам и описаниям. "Search customer invoices by date range" находится однозначно, а "Invoice helper" легко спутать с другим инструментом. Отложенная загрузка — не граница безопасности: имена и описания отложенных MCP-инструментов по-прежнему видны во входном промпте, а загруженные инструменты работают с выданными вами правами, как отмечается в разборе безопасности.
Чего нет в preview-версии
Это preview-функция только для Interactions API и поверхности v1beta. Поддержки generateContent нет; согласно разбору документации, defer_loading на неподдерживаемой модели вернёт HTTP 400.
Поддержка моделей пока уже, чем звучит в анонсе: там заявлены Gemini 3.6 и новее, включая все модели Gemini 4, тогда как цитируемый разбор указывает, что в актуальной документации перечислены gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash и gemini-3.6-flash. Прежде чем рассчитывать на поддержку соседней модели, проверьте документацию именно для неё. Дата GA не объявлена. По данным материала о запуске, Anthropic выпустила похожую идею defer_loading в beta ещё в ноябре 2025 года; отличия Google — серверная отложенная загрузка MCP и клиентский режим.
| Характер библиотеки | Какой режим выбрать | Первое действие |
|---|---|---|
| Небольшая и стабильная | Статическая загрузка | Измерьте токены схем, прежде чем усложнять архитектуру |
| 50–200 инструментов, на задачу нужны лишь несколько | Серверная отложенная загрузка | Отложите длинный хвост, а горячие инструменты оставьте загруженными |
| Инструменты зависят от пользователя или появляются посреди чата | Клиентский поиск | Создайте поиск с учётом прав доступа |
| Каждый инструмент нужен на каждом ходу | Статическая загрузка | Накладные расходы на поиск, вероятно, превысят экономию |
Сначала внедрите один сегмент длинного хвоста, затем на одинаковых задачах сравните входные токены, total_tool_use_tokens, задержку и успешность выполнения задач с отложенной загрузкой и без неё.
FAQ
Работает ли Tool Retrieval с generateContent?
Нет. Только Interactions API на v1beta.
Какие модели его поддерживают?
В анонсе заявлены Gemini 3.6 и новее, включая Gemini 4; однако цитируемый разбор сообщает, что актуальная документация ограничивает список моделями, среди которых gemini-4-hydrogen и gemini-3.6-flash. Проверьте документацию для конкретной модели.
Может ли это увеличить счёт?
Да. В приведённом анализе иллюстративный сценарий с 10 инструментами вырастает с ~68 000 до ~92 830 токенов, когда поиск выполняется почти на каждом ходу.