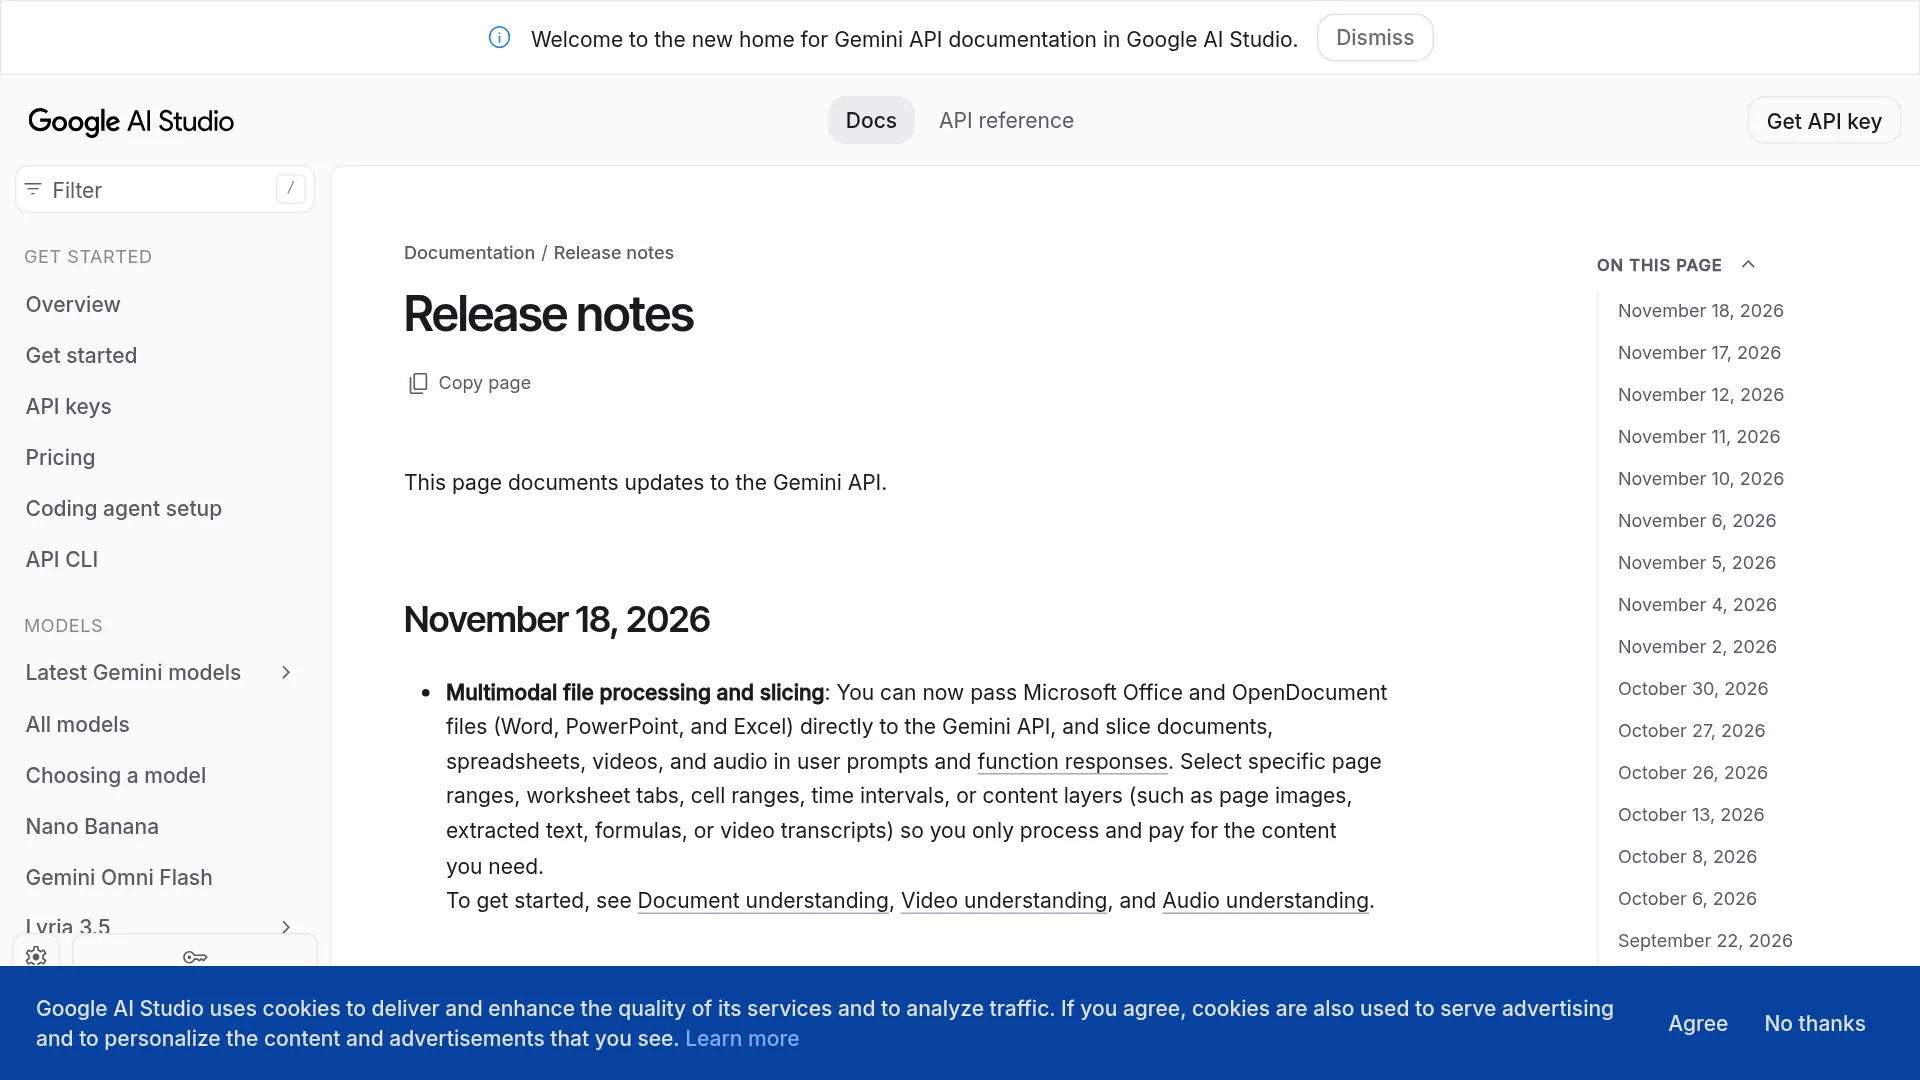
Если перед каждым вызовом Gemini API вы превращаете рабочие книги в CSV, от этой лишней операции теперь можно отказаться. С 18 ноября 2026 года Gemini API принимает файлы Word, Excel и PowerPoint напрямую, а Google обещает обрабатывать и тарифицировать только выбранный фрагмент (журнал изменений Google AI Studio).
Но экономия появляется только при явной настройке селекторов: без них API всё ещё может обработать файл целиком, отмечает читатель @zg0820.
Почему прежний способ работы с Excel был неудобным
Раньше в документации было указано, что из XLSX читается только первый лист — в виде CSV. Поэтому листы приходилось переставлять или разбивать рабочую книгу на части:
«В документации до сих пор сказано, что из XLSX читается только первый лист — как CSV». — @aitrackerbot
Запись от 18 ноября заменяет этот обходной путь прямой загрузкой файлов Office и OpenDocument, а также выборочным чтением содержимого в промптах и ответах функций (анализ DocsWatch).
Что именно изменилось 18 ноября
Нововведение дополняет расширение поддержки PPT, ODP и ODS от 5 ноября двумя возможностями:
- Прямая загрузка файлов Office и OpenDocument. Документы Word, презентации PowerPoint и таблицы Excel можно отправлять без предварительного преобразования в PDF или текст.
- Выборочная обработка содержимого. Можно указать диапазон страниц, вкладки рабочих листов, диапазон ячеек A1, временные интервалы или отдельные слои — изображения страниц, извлечённый текст, формулы и расшифровки.
Селекторы работают и в промптах, и в частях FunctionResponse. Поэтому инструмент может вернуть не всю рабочую книгу, а, например, конкретный диапазон одного листа (обзор AI Index).
Какие файлы теперь можно отправлять и какие модели их поддерживают
На странице требований к входным данным Firebase, обновлённой 18 ноября 2026 года по UTC, поддержка Office привязана к моделям Gemini 4.x (документация Firebase AI Logic):
| Семейство | Расширения | MIME-тип |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| Базовые форматы | .pdf, .txt | application/pdf, text/plain |
Официальные ограничения, которые выборочная обработка не увеличивает:
- 50 МБ на файл, 1 000 страниц на файл и 3 000 документных файлов в одном запросе.
- 20 МБ на весь запрос при передаче данных в виде inline base64; для более крупных файлов нужны URL Cloud Storage.
Неподтверждённое замечание сообщества приводим отдельно: один из читателей журнала изменений сообщает об отдельном ограничении для Office — около 2 000 страниц или слайдов (@lawson_ste3476). Google его не документировала, поэтому проектировать систему с расчётом на этот предел не стоит.
Word и PowerPoint: диапазоны страниц и выбор слоя
DocumentMetadata обнаружен в опубликованных Discovery-документах v1beta/v1alpha, но отсутствует в стабильной версии v1 (отчёт ORIENS о схеме):
startPage: первая страница, нумерация начинается с 1, граница включается.endPage: последняя страница, нумерация начинается с 1, граница включается.contentLayers:PAGE_IMAGE— отрендеренное изображение; по сообщениям, это значение используется по умолчанию, если метаданные переданы, но слой не указан; илиPAGE_TEXT— извлечённый текст.
PAGE_IMAGE пригодится для анализа вёрстки, слайдов и сканов, а PAGE_TEXT — для поиска по тексту, например в договорах. Firebase описывает базовую модель так: PDF обрабатываются как изображения, одна страница считается одним изображением, а изображения размером не более 384 пикселей по каждой из сторон стоят 258 токенов (документация Firebase AI Logic).
Excel: листы, диапазоны ячеек и три режима слоёв
SpreadsheetMetadata добавляется к части файла, переданной через inline_data или file_data, внутри входного Part или FunctionResponsePart — это следует из Discovery-схемы (отчёт ORIENS о схеме):
sheetIndex: порядок листа в рабочей книге, нумерация начинается с 1. В тексте Discovery дляv1betaсказано, что при пропуске выбираются все листы, тогда как тексты SDK для Python и JavaScript говорят о первом листе. Указывайте параметр всегда.visibleCells: диапазон в формате A1, напримерA1:G35; если параметр не задан, выбирается занятая область указанного листа.contentLayers:DATA— значения, объединения и форматирование;FORMULAS— выражения вместе с вычисленными результатами;VISUAL— отрендеренное изображение. Указанное по умолчанию значение —[DATA, FORMULAS].
Для аудита используйте DATA вместе с FORMULAS. Если важны вёрстка и контекст объединённых ячеек, добавьте VISUAL. Для единичного поиска задавайте максимально узкий диапазон visibleCells.
Отправляем только нужный фрагмент: пример на Python и REST
Имена полей ниже соответствуют ревизии Discovery 20261116. Формат пока относится к beta и отсутствует в стабильной v1, поэтому перед использованием в продакшене сверьте его с установленным SDK.
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Для Word вместо этого укажите "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]} и MIME-тип .docx. PowerPoint использует ту же структуру documentMetadata, MIME-тип .pptx и номера страниц слайдов.
Расчёт стоимости: когда выборка действительно экономит деньги
Отдельного SKU для выборочной обработки в журнале изменений или заметках о ценах Firebase нет: экономия складывается из неиспользованных входных токенов по стандартным тарифам. В журнале изменений для gemini-4-hydrogen указана цена $1.50 за 1 млн входных токенов.
Условный пример для отчёта на 200 страниц, из которого нужны только страницы 12–18. Значение 800 токенов на текстовую страницу — допущение для этого расчёта, а не документированный тариф:
- До: 200 страниц как изображения × минимум 258 токенов на изображение страницы = 51 600 входных токенов. Стоимость: 51 600 / 1 000 000 × $1.50 = $0.0774.
- После: 7 страниц извлечённого текста × условные 800 токенов = 5 600 входных токенов. Стоимость: 5 600 / 1 000 000 × $1.50 = $0.0084.
- Экономия: около 89% входных токенов для этого запроса, без учёта токенов ответа. Подставьте фактическую плотность текста в своих документах.
Проверьте размер диапазонов на собственной рабочей книге: множество крошечных запросов с выборкой может в сумме оказаться дороже одного грамотно выбранного диапазона (@zg0820).
Как внедрить без сюрпризов: проверка и план миграции
Успешная загрузка ещё не означает, что файл корректно разобран. Для каждого конвейера выполните следующие проверки:
- Убедитесь, что файл разобран. Попросите вернуть количество строк, название листа или число страниц и сравните результат с исходником.
- Задавайте каждый селектор. Указывайте
sheetIndex,visibleCellsили диапазон страниц, а такжеcontentLayers. - Подбирайте слой под задачу. Для графиков и вёрстки нужны
VISUALилиPAGE_IMAGE; для аудита —DATAиFORMULAS; для поиска —PAGE_TEXT. - Проверьте выход за границы в staging. Схема не объясняет, приведёт ли неверная страница или диапазон к ошибке, будет ли значение ограничено допустимыми границами или API просто вернёт пустой результат.
- Учитывайте лимиты загрузки. Файл размером 60 МБ всё равно превысит предел в 50 МБ. Для файлов крупнее 20 МБ используйте URL Cloud Storage вместо inline-передачи.
- Переносите системы в таком порядке. Excel-сплиттеры заменяйте на связку
sheetIndexиvisibleCells; растеризаторы отчётов — на диапазоны страниц сPAGE_TEXT, оставляяPAGE_IMAGEдля задач вёрстки; возврат целых файлов из инструментов — на выборочные ответы функций.
Что остаётся неясным по указанным источникам: в анонсе выборочной обработки и на приведённой выше странице требований Firebase ничего не сказано о скрытых строках, объединённых ячейках, графиках, встроенных изображениях, а также защищённых паролем, макросодержащих или повреждённых файлах. Проверьте эти сценарии на собственных шаблонах.
FAQ
Можно ли выбирать фрагменты и внутри ответов функций?
Да. Инструменты могут вернуть URI файла вместе с SpreadsheetMetadata или DocumentMetadata, чтобы модель увидела только нужный фрагмент. Это особенно удобно для агентских сценариев работы с документами.
Какая версия API поддерживает выборочную обработку?
Возможность обнаружена в Discovery-ревизии 20261116 для v1beta и v1alpha, но не в стабильной v1. Зафиксируйте версии и протестируйте целевую модель до выхода в продакшен.
Почему Gemini сообщает, что не видит загруженный файл?
Проверьте MIME-тип и размер файла, а также явные селекторы по таблице и ограничениям выше. Затем попросите модель вывести названия листов или количество страниц — так можно убедиться, что файл действительно разобран.
По теме: руководство по Gemini 4 Carbon и Hydrogen API поможет выбрать модель для конвейера обработки офисных файлов.