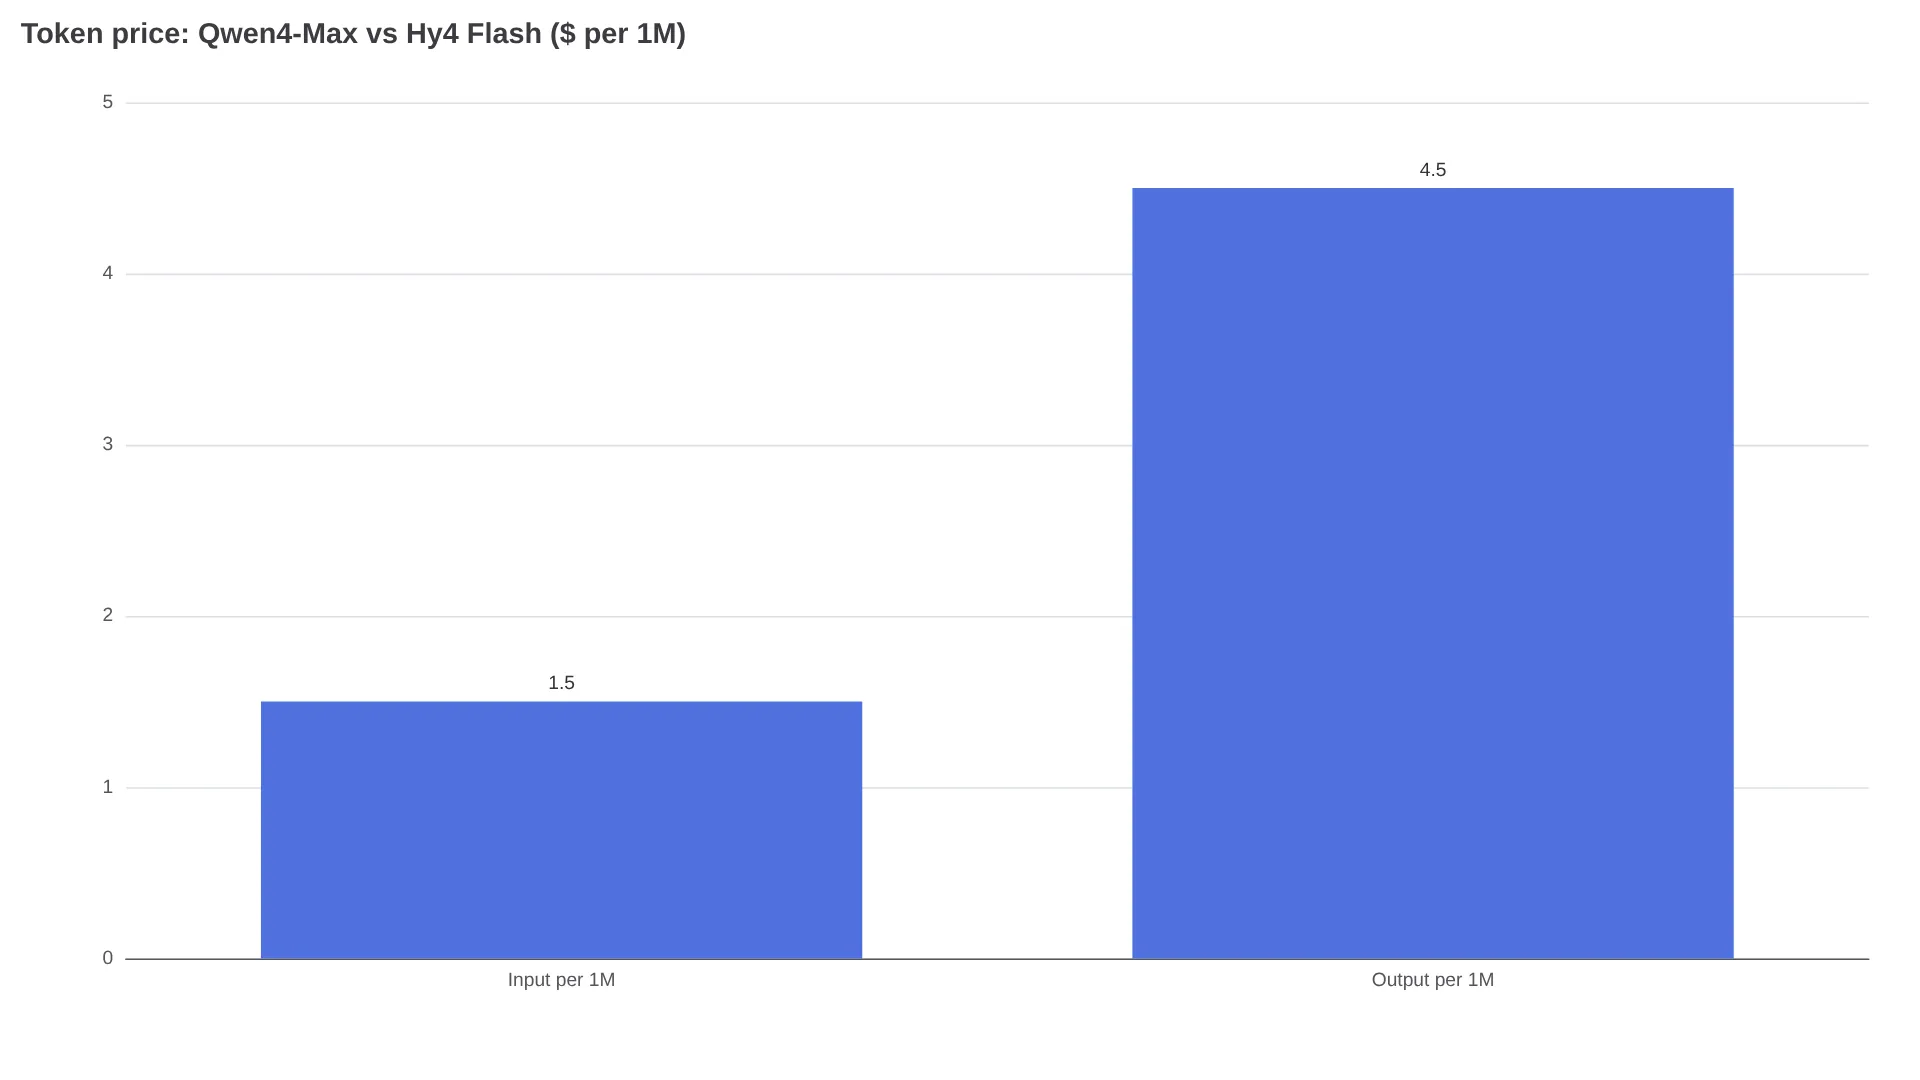
По приведённым результатам бенчмарков Qwen4-Max опережает Hy4 Flash в сложном программировании и рабочих процессах, тогда как Hy4 Flash обходится намного дешевле за одну попытку. QwenCloud указывает для Qwen4-Max цену $1.50/$4.50 за миллион токенов, а Tencent — $0.070/$0.281 для Hy4 Flash: примерно в 21 раз больше за входные и в 16 раз больше за выходные токены. Но итоговый счёт агентной системы определяют не только тарифы, указанные в прайс-листе: важны токены рассуждений, повторные запуски и повторное использование кэша. В этом обзоре цен Qwen4 Max API мы сопоставим контекст 1M, модели с 2.4T и 224B параметров и заявленную поставщиками стоимость задач, а затем разберём, какую модель выбирать под разные нагрузки.
Тарифы — в одной таблице
| Позиция | Qwen4-Max (Сингапур / международный регион) | Hy4 Flash (TokenHub Intl) |
|---|---|---|
| Вход, за 1M | $1.50 | $0.070 |
| Выход, за 1M (включая рассуждения) | $4.50 | $0.281 |
| Чтение кэшированного входа, за 1M | $0.075 | $0.003 |
| Явное создание кэша, за 1M | $1.875 (5 минут) / $3.00 (1 час) | Отдельная цена не указана |
| Смешанный сценарий: 0.5M входа + 0.5M выхода | $3.00 | ~$0.176 |
| ID модели | qwen4-max через QwenCloud | Hy4 Flash через Tencent |
Разница особенно заметна на агентной сессии программирования с 60 000 входных и 4 000 выходных токенов. У Qwen4-Max вход обойдётся в $0.09, выход — в $0.018, то есть около $0.108 за попытку. У Hy4 Flash это $0.0042 и $0.0011 соответственно — примерно $0.0053 за попытку, почти в 20 раз дешевле до учёта повторных запусков. При полностью кэшированном входе те же 60 000 токенов стоят $0.0045 у Qwen4-Max и $0.00018 у Hy4 Flash — ещё до оплаты выхода. QwenCloud считает рассуждения выходными токенами; у Hy4 Flash выход тарифицируется по $0.281 за миллион, поэтому более короткий ответ напрямую уменьшает счёт.
Что говорят архитектуры о будущих счетах
Qwen4-Max — MoE-модель на 2.4T параметров, из которых на каждый токен активны 71B (Offloop, DataCamp). Hy4 Flash — LatentMoE-модель на 224B параметров с 12B активных, инференсом в формате 4-bit и заявленной скоростью более 150 токенов в секунду (Tencent). Для бюджета важнее фактический объём выхода: в тестах Qwen4-Max достиг 127M выходных токенов против медианных 78.6M у сопоставимых моделей (DataCamp), тогда как постобучение Hy4 Flash сократило среднюю длину ответа на 50% (Tencent).
Какой тариф применяется на практике
Для Сингапура QwenCloud указывает $1.50 за вход, $4.50 за выход и $0.075 за чтение из кэша. Максимальный вход составляет 991,808 токенов без режима thinking и 983,616 с thinking; выход — 131,072 токена без thinking и 262,144 суммарно (QwenCloud). В других регионах (Вирджиния, Франкфурт, Токио, Гонконг) указаны $1.413 / $4.24 / $0.071 (региональная таблица через Offloop).
Для новых аккаунтов с оплатой по факту в Сингапуре заявлен бесплатный лимит в 1 миллион токенов (действуют условия, через Xenospectrum). Маршрут Token Plan для qwen4-max-preview закрывается 25 ноября 2026 года и никогда не охватывал production-бэкенды (примечания по миграции).
Для Hy4 Flash указаны $0.070 / $0.281 / $0.003, тогда как полноценный флагман Hy4 стоит $0.834 / $2.501 / $0.042 (Tencent). До 30 ноября 2026 года TokenHub продавал доступ за половину обычной цены — примерно $0.035 за входной миллион (Tencent). Доступность можно проверить в OpenRouter. Подробнее: цены Hy4 Flash.
Три множителя, которые формируют реальный счёт
Во-первых, рассуждения входят в общий бюджет выхода и оплачиваются как выходные токены. По умолчанию Qwen4-Max работает с уровнем high и бюджетом 131,072 токена на thinking; альтернативы — xhigh и low. В SVG-тесте Simon Willison через OpenRouter, пересказанном в Offloop, одна и та же задача потребовала 6,362 токена на high и 26,295 на xhigh — в 4.1 раза больше оплачиваемых токенов. Если в режиме thinking задать max_completion_tokens равным 10,000, это общий лимит на рассуждения и ответ.
Во-вторых, многословность и повторные попытки быстро увеличивают расходы. По данным, собранным Alibaba и опубликованным через Offloop, на одну бенчмарк-задачу Qwen4-Max выдаёт примерно 105,000 токенов против 171,000 у Qwen3.8-Max. Это сокращение на 39%, но показатель всё равно заметно выше медианы среди сопоставимых моделей. В песочном бенчмарке Reddit (56 задач, по две попытки, всего 112 запусков, обсуждение) Qwen4-Max Preview завершил успешно 64 попытки против 61 у DeepSeek V4.1 Flash; тайм-аутов было 16 против 4, а среднее время задачи — примерно 13 минут против 7. Повторный запуск после тайм-аута — это ещё один оплачиваемый запрос.
«16 тайм-аутов у qwen во многом и обеспечивают результат 64 против 61». — u/the_crooked_badger, обсуждение в r/DeepSeek
В-третьих, повторное использование кэша особенно выгодно агентам с длинным контекстом. Чтение кэша Qwen4-Max стоит $0.075 — на 95% дешевле обычного входа. Один из участников обсуждения в r/Qwen_AI сообщил о 112M кэшированных и 14M некэшированных входных токенов. У Hy4 Flash чтение кэша ещё в 25 раз дешевле — $0.003, но это преимущество становится менее значимым, если основную часть счёта формируют дополнительные циклы рассуждений. Как выразился @MarcosRGjr, «не смотрите на цену токена. Агентские системы тарифицируются за задачу» (публикация).
Заявленная стоимость задачи: данные поставщиков и внешние проверки
Заявления поставщиков сопоставлены с внешними ориентирами, но это не верифицированное прямое сравнение моделей.
| Заявление | Показатель | Основание |
|---|---|---|
| Alibaba Work360, Qwen4-Max против Qwen3.8-Max (внутренние данные поставщика, через DataCamp) | $1.67 против $4.43 за попытку выполнить задачу | Набор из 721 поля, примерно на 35% меньше токенов при high |
| График Alibaba с учётом строк AA, Qwen4-Max против Qwen3.8-Max (данные, собранные поставщиком, через Offloop) | $3.27 против $10.02 за бенчмарк-задачу | xhigh, 105K против 171K выходных токенов |
| Tencent WorkIndex, Hy4 Flash против полноценного Hy4 (внутренние данные поставщика, через Tencent и разбор) | ¥0.2 против ¥5.7 за задачу | Офисный набор из 8 задач |
| Слепой тест Tencent, Hy4 Flash против Claude Haiku 5.5 (тест поставщика, через Tencent) | ¥0.26, 2.79/4 против ¥4.73, 2.81/4 | 85 пользователей, 259 задач, 6.7 против 6.8 минуты |
В Work360 Qwen4-Max набрал 52.69 против 47.74 у Qwen3.8-Max; Intelligence Index вырос с 34 до 43, но всё ещё уступает Kimi K3.1 Pro с результатом 46 и Opus 5.5 с 59 (Offloop, LLM Leaderboard).
Внешние результаты, воспроизведённые на графиках поставщика, позволяют оценить эти заявления. Тестирование, связанное с Vals, через гайд LLM Leaderboard показало для Qwen4-Max 63.20% при цене $9.33 за тест, а для GPT-6.1 Sol — 63.94% при $3.61. В Terminal-Bench 4.0 Qwen4-Max набрал 48.5%, а Hy4 Flash — 19.2% на графике Tencent (полноценный Hy4 — 44.4%); в ProgramBench результаты составили 31.5 против 16.0 (Offloop). В AutomationBench-AA Qwen4-Max получил 72.5% (DataCamp), а автоматизация у Hy4 Flash — 52.2 (Tokenstrom).
Ожидаемая стоимость успешного результата равна стоимости попытки, делённой на вероятность успеха. Для иллюстрации: $0.108 / 0.485 ≈ $0.22 у Qwen4-Max против $0.0053 / 0.192 ≈ $0.028 у Hy4 Flash — разница примерно восьмикратная. Бенчмарк-показатели не отражают реальную частоту повторных запусков в production. При таких объёмах токенов Qwen4-Max должен обеспечивать примерно в 20 раз более высокую вероятность успеха либо компенсировать цену инструментами, меньшей задержкой и экономией на исправлениях, чтобы выиграть только по стоимости.
Выбирайте модель под нагрузку и проверьте решение на 30 задачах
| Профиль агента | Рекомендуемый выбор по умолчанию | Почему |
|---|---|---|
| Сложное программирование с длинной цепочкой действий и работа в терминале | Qwen4-Max на high | Более высокая успешность (48.5 против 19.2, 31.5 против 16.0) может оправдать переплату, если ошибка или исправление обходятся дорого |
| Массовые офисные циклы: презентации, документы, исправление таблиц, computer-use | Hy4 Flash | ¥0.2 против ¥5.7 в WorkIndex, сопоставимый результат с Claude Haiku 5.5 (2.79 против 2.81) при стоимости примерно в одну восемнадцатую |
| Кэшируемые конвейеры и пакетное извлечение данных | Hy4 Flash по умолчанию; Qwen4-Max — если повторная проверка покажет выигрыш в качестве | Сравните $0.003 и $0.075 за чтение из кэша, а также стоимость исправлений на собственных документах |
Перед тем как принимать решение, прогоните 30 своих задач на обеих моделях. Для каждого успешного результата учитывайте токены рассуждений и ответа, записывайте вызовы инструментов, тайм-ауты и исправления, а затем сопоставьте стоимость с медианным временем выполнения.
FAQ
Сколько стоит Qwen4 Max API за миллион токенов?
QwenCloud Singapore указывает $1.50 за вход, $4.50 за выход и $0.075 за чтение кэша. В других регионах указаны $1.413 / $4.24 / $0.071. Для Hy4 Flash тариф составляет $0.070 за вход, $0.281 за выход и $0.003 за чтение кэша.
Токены рассуждений оплачиваются как выходные?
Qwen4-Max тарифицирует thinking по $4.50 в рамках общего бюджета 262,144 токена. Выход Hy4 Flash стоит $0.281, поэтому более короткий ответ уменьшает число оплачиваемых токенов.
Каков реальный лимит контекста, а не заявленный 1M?
QwenCloud документирует 991,808 входных токенов без thinking и 983,616 с thinking; выход составляет 131,072 токена без thinking и 262,144 суммарно. Для Hy4 Flash Tencent указывает контекст 1M. На практике стоит оставлять запас.
Что дешевле за выполненную агентом задачу: Qwen4-Max или Hy4 Flash?
За одну попытку Hy4 Flash примерно в 20 раз дешевле. Tencent заявляет, что стоимость задачи составляет одну двадцатую от полной версии Hy4 и одну восьмую от DeepSeek-V4.1-Flash-1017 по максимальному тарифу (Tencent). В приведённом выше иллюстративном расчёте он остаётся примерно в 8 раз дешевле за ожидаемый успешный результат. Однако Qwen4-Max может оказаться выгоднее, если сокращение числа ошибок и затрат на исправления перевесит разницу в цене токенов.