 AIREITER
На ценнике у обоих API указано $0.10 за 1 млн входных токенов, но один и тот же повторяющийся документ с политиками может обойтись в $520 у одного сервиса и в $70 у другого. OpenAI Decisions API лучше подходит для транскриптов агентов с повторяющимся контекстом, а Gemini Decisions API — для аудио, видео и чек-листов на 1 000 правил.
Одинаковые $0.10, но разные счета
OpenAI Decisions API и Gemini Decisions API берут по $0.10 за 1 млн некэшированных входных токенов, а выходные токены не тарифицируются. OpenAI Decisions API стал общедоступным 22 октября 2026 года на модели gpt-6-luna, тогда как Gemini Decisions API запустили 11 ноября 2026 года в v1beta на модели gemini-decision-1. Поэтому выбор более дешёвого варианта определяется не логотипом, а повторяемостью входных данных и их типом.
| Параметр | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| Модель | gpt-6-luna | gemini-decision-1 |
| Статус | GA с 22 октября 2026 года (документация OpenAI) | Предварительная версия v1beta с 11 ноября 2026 года (анонс Google) |
| Вопросов в одном запросе | 1–400 (документация OpenAI) | 1–1 000 (анонс Google) |
| Контекстное окно | Множитель 2x для длинного контекста свыше 272K токенов | 262 144 токена |
| Входные данные | Текст, изображения, input_json, диалоги и вызовы инструментов | Текст, изображения, аудио, видео, PDF |
| Плата за вывод | $0 | $0 |
| Кэширование входных данных | $0.01 за 1 млн токенов, префикс ≥1 024 токенов | Не поддерживается |
| Бесплатный тариф | Отдельный бесплатный тариф не заявлен | Да, в AI Studio: 200 RPM / 50K TPM / 10K RPD |
| Опубликованная задержка | Примерно в 10 раз быстрее Responses API | 50–100 мс на вычисления модели, 150–250 мс от начала до конца для 16K токенов |
| Для бизнеса | ZDR, HIPAA, региональная обработка в США и ЕС (+10%) | Поддержка Cloud появится позже |
Как выглядит запрос на практике
OpenAI Decisions API использует POST /v1/decisions с упорядоченным массивом вопросов, у каждого из которых может быть необязательное поле name. В Gemini Decisions API используется client.decisions.create() с объектом, ключами которого служат выбранные разработчиком идентификаторы. Типов вопросов у обоих сервисов три, но названия и ограничения различаются.
В OpenAI это predicate (вероятность от 0 до 1), choice (неупорядоченные категории) и score (от 2 до 10 упорядоченных уровней со средним, взвешенным по вероятности), как указано в руководстве OpenAI. В Gemini используются noul (да/нет, вероятность от 0.01 до 0.99), choice (от 2 до 255 вариантов) и score (от 2 до 255 уровней, рекомендованный диапазон — 2–10), согласно анонсу Google. Вопросы внутри одного запроса независимы в обоих API: цепочную логику придётся реализовать в коде приложения или вынести во второй вызов.
Три нюанса, из-за которых миграция может сломаться
Gemini сортирует ключи choice по алфавиту перед оценкой. Поэтому вариант «ничего из перечисленного» с именем none_of_the_above может оказаться раньше shipping (задокументированное поведение). OpenAI возвращает name вопроса в массиве ответов, а Gemini — объект с ключами-идентификаторами вопросов. Тип noul в Gemini никогда не возвращает значение выше 0.99, поэтому порог >0.99 не сработает.
Отказы тоже обрабатываются по-разному. OpenAI может вернуть refusal для одного вопроса и при этом ответить на остальные, как указано в руководстве OpenAI. Gemini отклоняет весь запрос с HTTP 400 при срабатывании фильтров безопасности или запрета контента; среди кодов — safety и prohibited_content.
«Похоже, у Decisions и обычной генерации текста отдельные пути кэширования и инференса». — u/Balance- на r/OpenAI
Если нужно поддерживать оба API, заранее заложите тонкий адаптер. Нормализуйте идентификаторы вопросов, переименуйте ключи Gemini, чтобы избежать неожиданных алфавитных развязок, и ограничьте пороги для Gemini значениями ≤0.99.
Что принимает каждый API и что придётся строить самостоятельно
Gemini Decisions API нативно принимает в одном общем входе текст, изображения, аудио, видео и PDF. OpenAI Decisions API работает с текстом, изображениями, input_json, историей диалога, вызовами функций и результатами инструментов, но не принимает файлы и аудио. От этого зависит, исчезнут ли этапы предварительной обработки или, наоборот, появятся в архитектуре.
Запись звонка вместе с метаданными аккаунта можно напрямую отправить в Gemini — транскрипция не нужна. То же касается отсканированного PDF с заявлением и фотографий повреждений: OCR не потребуется. Транскрипт агента с вызовами инструментов OpenAI принимает нативно, включая сопоставление по call_id, тогда как для Gemini тот же транскрипт придётся преобразовать в обычный текст. OpenAI также позволяет добавлять изображения в instructions вопроса для проверок «кандидат против эталона».
Подсчёт токенов для изображений у провайдеров различается. В одном независимом практическом тесте (System Design Academy) фотография яйца размером 224×224 дала 523 входных токена в OpenAI при трёх вопросах против оценочных 390 токенов в Gemini Low (257 токенов изображения), 663 в Medium и 1 223 в High. Это соответствует $0.039, $0.066 и $0.122 за 1 000 фотографий.
Заявления о задержке принадлежат самим провайдерам. Google сообщает о 150–250 мс от начала до конца и почти постоянном времени при росте числа вопросов с 1 до 100 в пределах 16K токенов. OpenAI заявляет о скорости примерно в 10 раз выше Responses API, но абсолютное значение не приводит. Отзывы реальных пользователей неоднозначны:
«Скорость и цена. Ответы приходят почти мгновенно и стоят сущие копейки». — u/zyeus-guy на r/OpenAI
Тестировал Gemini Decision 1 на бесплатном тарифе: маршрутизация 30/30 при медиане около 0.24 с, повторные результаты детерминированы. Но модель уверенно выбрала неправильную категорию, когда вариант «другое» отсутствовал. — практический тест на r/GeminiAI
Воспринимайте показатели провайдеров как ориентир, который нужно проверять собственными тестами, а не как SLA для продакшена.
Сколько на самом деле стоят 1 млн запросов
Общие входные данные в обоих API оплачиваются один раз за запрос. Дополнительные вопросы добавляют только токены инструкций. Разница в счетах становится заметной при повторной отправке одного и того же контекста: OpenAI кэширует его, а Gemini каждый раз считает полностью.
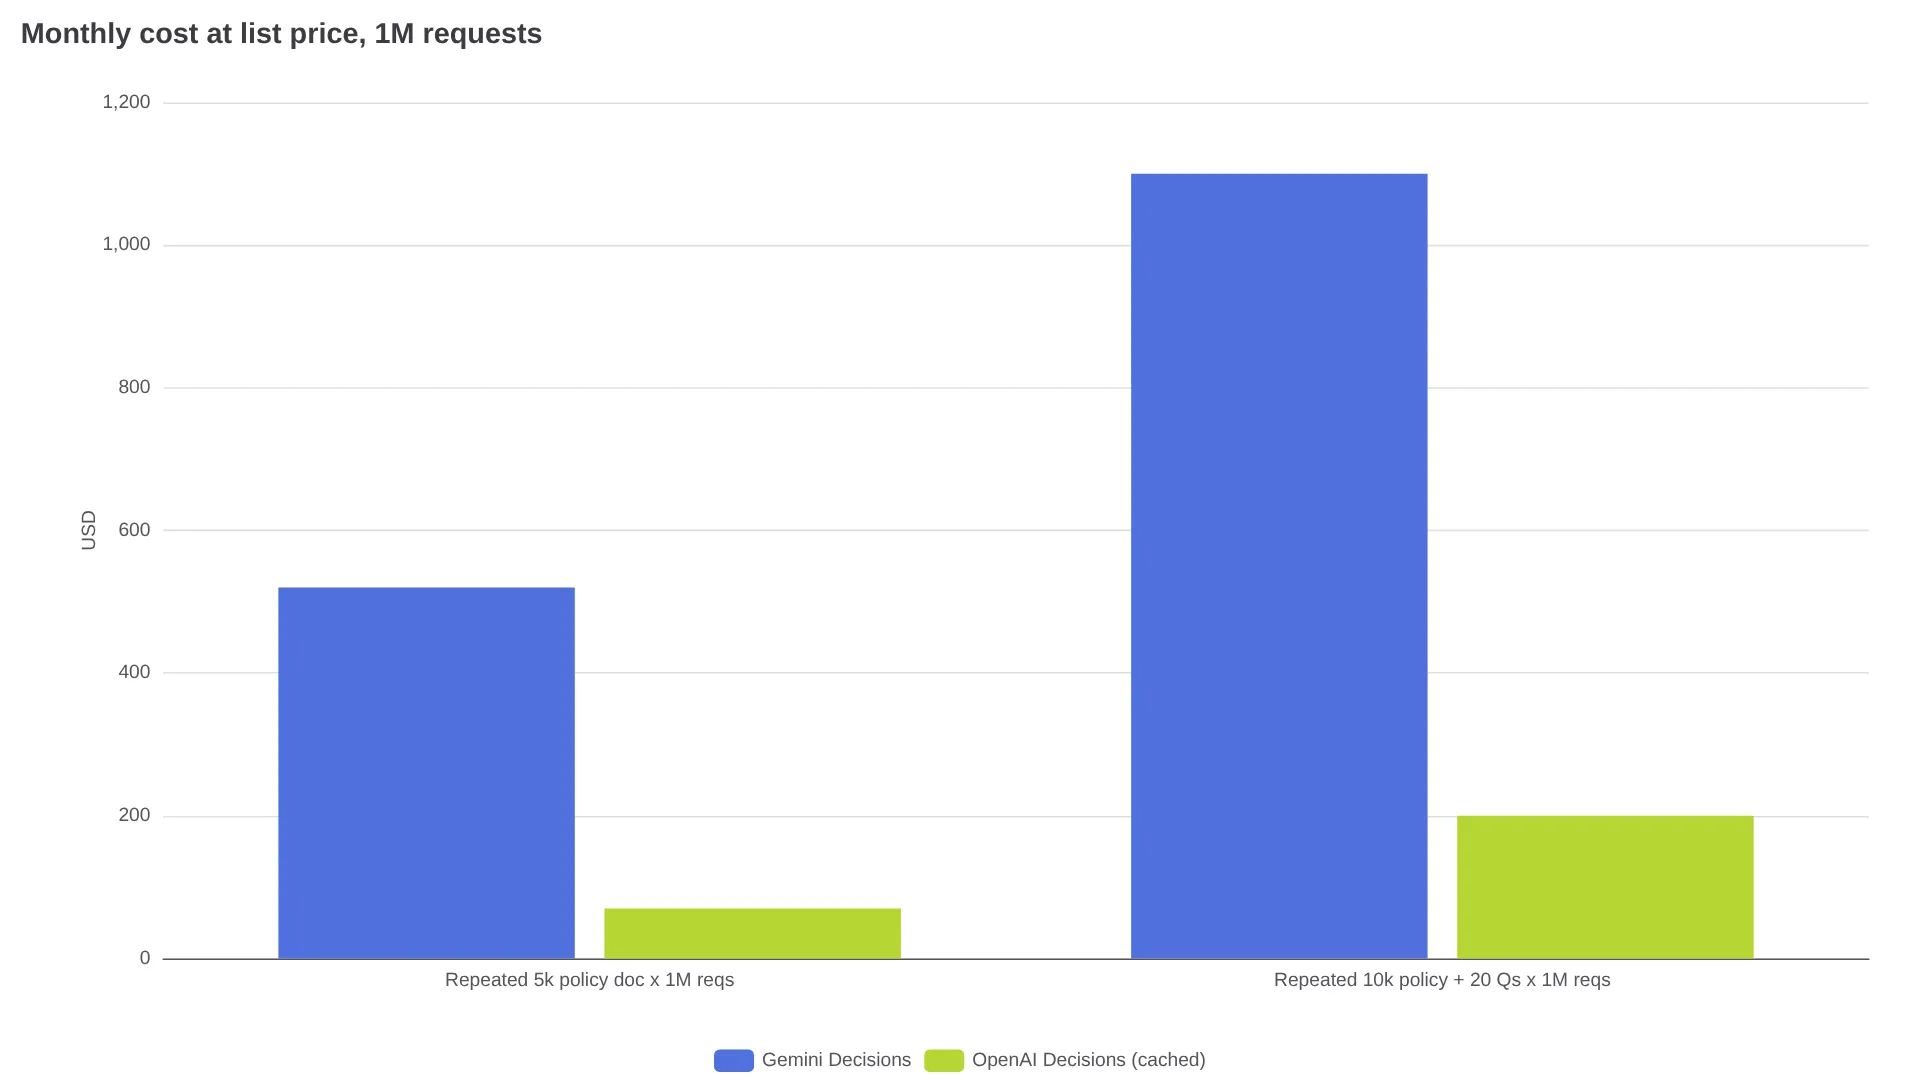
Ниже — иллюстративный расчёт по опубликованным ценам, выполненный по схеме из материалов Apidog и BaristaLabs. Для OpenAI предполагается, что попадания в кэш происходят до начисления платы за запись в кэш:
- 1 млн тикетов с одной и той же политикой на 5 000 токенов плюс 200 новых токенов: около $520 в Gemini и около $70 в OpenAI с кэшированием.
- 1 млн запросов с одной и той же политикой на 10 000 токенов плюс 20 вопросов примерно по 50 токенов: около $1 100 в Gemini и около $200 в OpenAI с кэшированием, не считая записи.
Для свежих уникальных данных разрыв исчезает: сообщение на 400 токенов без повторно используемого префикса стоит одинаковые $0.10 за 1 млн токенов в обоих API. Пакетная обработка влияет на счёт сильнее, чем выбор модели: один запрос с 20 проверками записи на 4 000 токенов стоит около $0.50 на 1 000 записей, а 20 отдельных запросов — около $8.10.
Для длинных диалогов, где контекст перечитывается на каждом ходу, кэширование особенно выгодно. Смоделированный маршрутизатор на 30 ходов, читающий 124 680 токенов, обходится примерно в $12.47 на 1 000 диалогов в Gemini Decision 1 без кэширования против примерно $6.31 в модели с кэшированием.
Можно ли доверять возвращаемому числу?
В таблице Google, пересказанной AIToolsReview, Decision 1 опережает Luna во всех общих тестах: top-1 ECE составляет 0.0250 против 0.0721 у Luna и 0.0494 у Jev 1.14. В публичной части JevBench показатели составили 92.2% у Decision 1, 90.9% у Luna и 90.0% у Jev 1.14. Общая стоимость набора тестов — $0.88 для Decision 1, $0.68 для Jev и $0.93 для Luna.
В независимом обзоре Artificial Analysis, на который ссылается та же публикация, Decision 1 получил Decision Index 66 — столько же, сколько Jev 1.14. Это 9-е место из 18, примерно на 7 пунктов ниже Drex Max v1.1. В тесте When2Call результаты такие: 75.2% у Decision 1, 80.8% у Jev и 94.6% у Drex Max; стоимость и задержка для Decision 1 составили $345 за 1 млн задач и 211 мс против $156 и 92 мс у Jev.
Для автоматизации по порогам калибровка важнее красивого показателя точности. Если система уверена на 0.90, на данных продакшена она должна быть права примерно в 9 случаях из 10. Проверяйте пороги на 200–500 размеченных примерах и измеряйте точность отдельно для каждого диапазона уверенности.
«Калиброванные вероятности в стиле Jev есть далеко не у каждого совместимого с OpenAI API». — u/xapep на r/LLMDevs
На практике регулярно встречаются две проблемы. Ранние тесты пользователей сообщают о склонности OpenAI выбирать первый вариант (@NatashaTheRobot), а в приведённом выше тесте Gemini отсутствие универсального варианта заставило модель выбрать наименее неподходящую категорию вместо отказа от ответа. Обе ситуации исправляются вариантом other, отдельным предикатом проверки области применимости, короткими непохожими описаниями и передачей результатов ниже порога на ручную проверку.
Что проверить перед запуском в продакшен
OpenAI имеет статус GA, поддерживает кэширование, отчёты об использовании через GET /v1/organization/usage/decisions, ZDR и HIPAA для подходящих клиентов, а также региональную обработку в США и ЕС с надбавкой 10%. Gemini пока работает в v1beta, а поддержка Cloud ещё ожидается. Оба провайдера указывают интеграции с такими фреймворками, как OpenRouter, LangChain, Vercel и LiteLLM.
Правила кэширования напрямую влияют на архитектуру. OpenAI повторно использует префикс общих входных данных длиной не менее 1 024 токенов; содержимое вопросов в этот минимум не входит. У Gemini нет контекстного кэширования, тарифов Batch, Flex или Priority. Для прототипирования бесплатный тариф Gemini удобнее, но данные бесплатного тарифа могут использоваться для улучшения продуктов Google, поэтому реальные клиентские данные следует отправлять через платные ключи. Прежде чем автоматизировать критичные действия, в течение недели собирайте распределение значений уверенности.
Выбирайте по нагрузке, а не по логотипу
Если у вас цикл маршрутизации агента с вызовами инструментов и повторяющимися инструкциями, выбирайте OpenAI Decisions API. Те же рекомендации действуют при требованиях к ZDR, HIPAA или размещению данных в ЕС.
Запись звонка, видеоклип или отсканированный PDF с сотнями проверок — сценарий для Gemini Decisions API. Нативная обработка аудио, видео и PDF убирает этапы транскрипции и OCR, а 1 000 вопросов в одном запросе покрывает списки правил, которые не помещаются в лимит 400. Ограничения по объёму: 100 MB для встроенных данных в запросе, 50 MB для PDF и 15 MB для внешнего URL.
Для короткого уникального текста и менее чем 400 вопросов цены одинаковы. Начните прототипирование в бесплатном Gemini AI Studio на синтетических данных, затем прогоните те же 200–500 размеченных примеров через оба API и сравните точность по диапазонам, задержку p50/p95, число токенов на запрос и месячную стоимость.
| Рабочая нагрузка | Выбор |
|---|---|
| Повторяющийся документ с политиками на 5K–10K токенов, высокий QPS | OpenAI Decisions API: кэширование экономит 80%+ |
| Маршрутизация агента с историей вызовов инструментов, голосовой GPT-Live | OpenAI Decisions API |
| Решения по аудио / видео / PDF, более 400 правил | Gemini Decisions API |
| Короткий уникальный текст, <400 вопросов | Ничья — выбирайте привычный стек |
| Бесплатное прототипирование | Gemini AI Studio, затем повторная оценка на платном тарифе |
Gemini дешевле OpenAI?
По базовой цене — ничья: $0.10 за 1 млн токенов без платы за вывод. OpenAI выгоднее при повторяющемся кэшируемом контексте, а Gemini — для бесплатного прототипирования.
Может ли OpenAI читать аудио, видео или PDF?
Нет. Он работает только с текстом, изображениями, JSON и диалогами с вызовами инструментов; Gemini нативно обрабатывает аудио, видео и PDF.
Сколько вопросов можно задать в одном запросе?
В Gemini — от 1 до 1 000 в пределах 262 144 токенов; в OpenAI — от 1 до 400.
Готов ли Gemini к продакшену?
Gemini работает в v1beta, а поддержка Cloud ещё не запущена. OpenAI имеет статус GA, поддерживает ZDR, HIPAA и региональную обработку.
Нужны ли по-прежнему Jev или локальный классификатор?
Jev указывает цену $0.042 за 1 млн токенов и лидирует в некоторых тестах выбора инструментов. Добавьте его в сравнительный бенчмарк, если главным фактором становится стоимость задачи.
Что делать с низкой уверенностью?
Определите пороги на размеченных данных: выше порога выполняйте действие автоматически, промежуточный диапазон отправляйте более крупной модели, а всё ниже — на ручную проверку. Вариант other должен быть всегда.
Читайте также: