 AIREITER
Один цикл coding-агента — прочитать файлы, запустить тесты, внести правки и повторить попытку — расходует от 50 000 до 200 000 токенов на закрытую задачу. При цене GPT-5.6 Sol в $30 за миллион выходных токенов только генерация обойдётся в $1,50–6 на одну задачу. DeepSeek V4 Pro заявлен по $0,87 за миллион выходных токенов — примерно в 34 раза дешевле. Однако его надёжность в многошаговых сценариях пока не проходила столь же глубокую независимую проверку, как Claude или GPT. Ниже сравниваем шесть моделей по опубликованным бенчмаркам для программирования, подтверждённым ценам API, размеру контекста и подходящим агентным сценариям.
Шесть LLM для coding-агентов в 2026 году
Для каждой модели приведены результаты из официальных источников или таблиц лидеров, а цены API проверены в августе 2026 года. Если для конкретной версии из рейтинга нет опубликованного результата, указан ближайший доступный вариант — с явной пометкой, что это ориентир.
1. Claude Opus 5 — максимум качества
Claude Opus 5 сохраняет лидерство семейства Claude в официальной таблице SWE-bench Verified. Предшественник, Claude 4.5 Opus, набрал 76,8% с harness mini-SWE-agent. Это полезный ориентир для ожидаемого уровня Opus 5, хотя отдельные результаты SWE-bench Verified именно для Opus 5 пока не опубликованы. Модель предлагает контекстное окно в 1 миллион токенов и до 128K токенов в ответе. При стоимости $5 за миллион входных и $25 за миллион выходных токенов это самый дорогой массовый вариант в подборке. Opus 5 стоит выбирать для агентных задач, где неудачный рефакторинг нескольких файлов обойдётся в человеческих часах дороже токенов. Для потока рутинных правок он избыточен.
2. GPT-5.6 Sol — специалист по задачам в терминале
GPT-5.6 Sol (ID модели — gpt-5.6-sol) стоит $5 за миллион входных и $30 за миллион выходных токенов, а его контекстное окно составляет 1,05 миллиона токенов. В опубликованном xAI сравнении бенчмарков GPT-5.6 Sol Max лидирует на Terminal-Bench v3.0 с результатом 34,6% против 26% у Grok 4.6, а на DeepSWE v1.1 набирает 73%. Именно эти тесты наиболее близки к агентным циклам, завязанным на терминал. Компромисс очевиден: при $30 за миллион выходных токенов Sol — самая дорогая модель этой подборки. OpenAI также указывает 64,6% на SWE-bench Pro для Sol и 63,4% для Terra, версии среднего уровня. Terra может быть более доступным выбором OpenAI для менее требовательных задач.
3. Grok 4.6 — выгодный вариант для долгих агентных запусков
Grok 4.6, выпущенный 12 августа 2026 года, рассчитан на длительные агентные сценарии. Согласно анонсу xAI, он делит с GPT-5.6 Sol Max результат 61 в Artificial Analysis Intelligence Index и опережает его в CursorBench v3.2 — 69,9% против 67,2%, FrontierCode v1.1 — 61,3% против 60,6%, а также APEX-Agents — 57,5% против 56,7%. При цене $2 за миллион входных и $6 за миллион выходных токенов модель даёт сопоставимый с GPT-5.6 Sol Max уровень в бенчмарках примерно за одну пятую стоимости генерации. Слабое место — непосредственное выполнение задач в терминале: 26% на Terminal-Bench v3.0 заметно уступают 34,6% у Sol Max. Если ваш процесс сосредоточен вокруг IDE, например Cursor или Grok Build, а не построен прежде всего вокруг терминала, Grok 4.6 — лучший выбор в этом списке по соотношению качества и цены. Вариант «fast» стоит вдвое дороже — $4/$12 — зато снижает задержку. Контекстное окно составляет 500K токенов.
4. DeepSeek V4 Pro — рабочая лошадка для экономного бюджета
DeepSeek V4 Pro — самая дешёвая модель уровня frontier, доступная по API: $0,435 за миллион входных и $0,87 за миллион выходных токенов. При использовании кешированного ввода цена снижается до $0,003625 за миллион. Контекст в 1 миллион токенов и максимальный ответ в 384K токенов позволяют работать с задачами масштаба репозитория. Публичного многошагового агентного бенчмарка, который сравнивал бы DeepSeek V4 Pro с Claude или GPT при одинаковой глубине harness, нет. Поэтому перед тем как доверять модели сложный рефакторинг, проверьте надёжность tool calls в длинных сессиях на собственной конфигурации. Для команд с ограниченным бюджетом или в роли модели первого прохода в routed-схеме экономика выглядит очень убедительно. Но на самых сложных рефакторингах нескольких файлов, где надёжность важнее цены токенов, стоит быть готовым к эскалации.
5. Gemini 3.1 Pro — когда нужно прочитать огромный контекст
Preview-версия Gemini 3.1 Pro от Google стоит $2 за миллион входных и $12 за миллион выходных токенов для промптов до 200K токенов. Выше этого порога цена увеличивается до $4/$18. Главное преимущество модели — вместимость контекста: окно в 2 миллиона токенов является самым большим среди представленных здесь моделей. Поэтому Gemini подходит для чтения целого репозитория за один проход. В качестве ориентира для ожидаемого уровня 3.1 Pro можно взять Gemini 3 Flash: в срезе Tembo за июнь 2026 года он получил 75,8% на SWE-bench Verified, уступив только Claude 4.5 Opus. Стабильность tool calling Gemini в продолжительных агентных циклах не тестировалась так же глубоко, как у Claude или GPT, поэтому перед запуском многошаговых процессов проверьте модель в своём harness.
6. Kimi K3 — агентный вариант с открытыми весами
Kimi K3 от Moonshot AI набрала 70,8% на SWE-bench Verified в том же срезе за июнь 2026 года. Среди моделей с открытыми весами она уступила GLM-5 с 72,8% и MiniMax M2.5 с 75,8%. Открытые веса позволяют развернуть модель самостоятельно — важный аргумент для команд, чей код не может покидать внутреннюю сеть. K3 доступна и через hosted API Moonshot, но конкретная стоимость зависит от конфигурации развёртывания. Для локальных агентных систем с достаточным GPU-ресурсом K3 в паре с лёгким harness вроде OpenCode даёт полноценного coding-агента без платы за токены API.
Цены API и стоимость закрытой задачи
Цена токена показывает лишь половину картины. Практически важнее стоимость закрытой задачи: сколько агентный цикл потратит, чтобы решить одну реальную issue в GitHub.
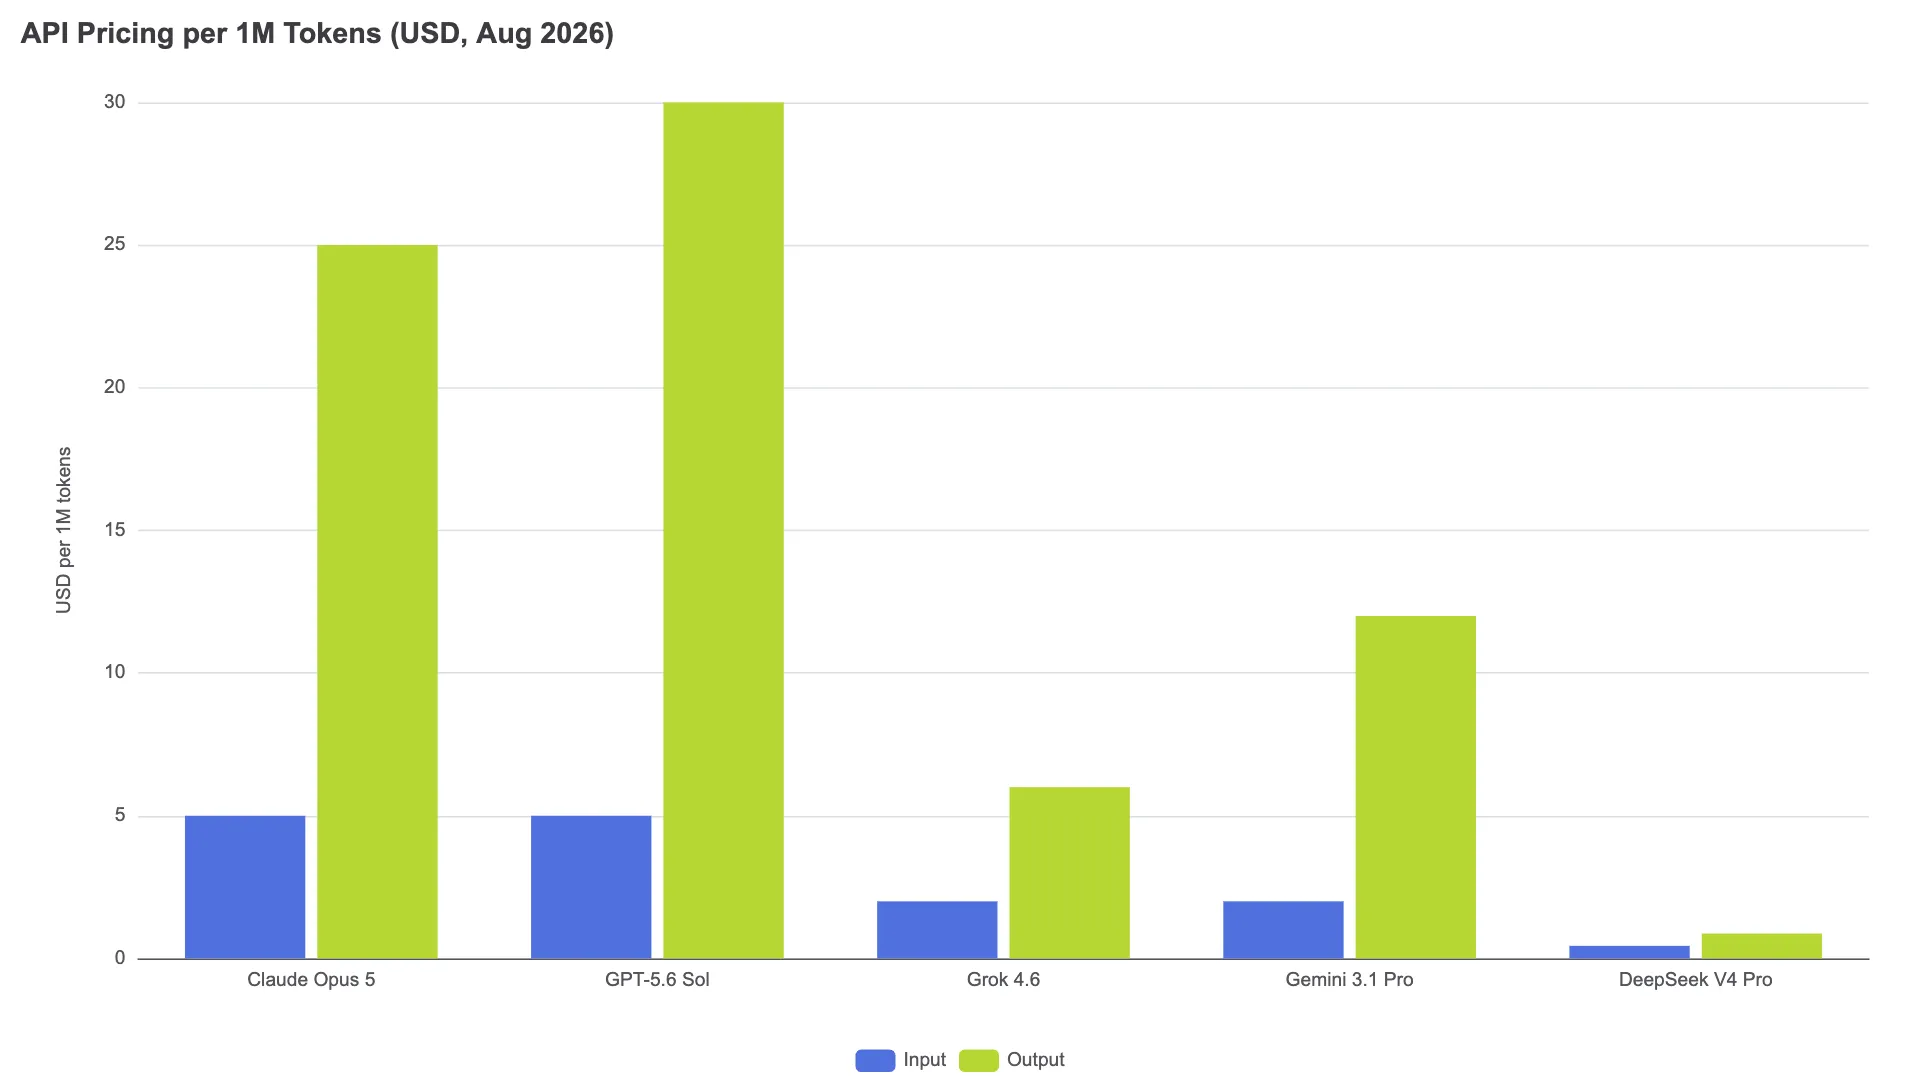
Типичный агентный цикл — чтение файлов, планирование, правки, запуск тестов и исправление ошибок — потребляет примерно 50K–200K токенов на одну решённую issue; на выход приходится 30–50% общего объёма. Это отраслевые оценки из анализа агентных циклов Tembo и других источников. Фактический расход зависит от размера репозитория, длительности тестового набора и эффективности harness. Возьмём среднее значение в 125K токенов: 75K входных и 50K выходных. Вот во сколько тогда обойдётся одна закрытая задача для каждой модели:
| Модель | Стоимость ввода | Стоимость вывода | Итого на задачу |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3 не включена в таблицу: её стоимость полностью зависит от того, используете ли вы hosted API Moonshot или запускаете модель на собственных GPU. Единой публичной цены для сравнения нет. Grok 4.6 занимает удачную позицию при $0,45 за задачу: она повторяет результат GPT-5.6 Sol Max в Artificial Analysis Intelligence Index, но обходится примерно в четверть стоимости одной задачи у Sol.
В этих расчётах не учтены повторные попытки, скидки на кешированные токены, накладные расходы на tool calls и инфраструктуру. Модель, которой для одной задачи требуется больше повторов или ручных исправлений, на практике будет стоить дороже, чем предполагает её цена токенов. Поэтому маршрутизация задач — рутинные отправлять в DeepSeek или Grok, а сложный рефакторинг эскалировать в Opus — может быть эффективнее ставки на единственную модель.
Какую модель выбрать под разные задачи coding-агента
Универсальной модели для всех процессов нет. Вот какие варианты стоит подключать к конкретным типам агентной работы.
Быстрые циклы и типовые правки. Для частых и не слишком рискованных задач — объяснения ошибок, небольшие функции, заготовки тестов, обновление документации — используйте Gemini 3.5 Flash ($1.50/$9 за миллион токенов) или Claude Sonnet 5.
Глубокий рефакторинг и архитектура. Claude Opus 5 — выбор для изменений в нескольких файлах, зависимостей между модулями и архитектурных решений, когда неверное предположение оборачивается часами отладки. Его ключевое преимущество — точное следование инструкциям и способность сохранять связность контекста в долгих сессиях.
Долгие автономные агенты. Grok 4.6 создавался именно для такого сценария. Как сказано в анонсе xAI, при разработке фокус был на продолжительных траекториях агента и поведении с самопроверкой. При $0,45 за задачу ему можно позволить работать дольше без ценового давления, которое создаёт ставка GPT-5.6 Sol в $1,88 на задачу. В процессах с интенсивной работой в терминале более безопасным выбором будет GPT-5.6 Sol благодаря лидерству на Terminal-Bench — 34,6%.
Минимальный бюджет и self-hosting. Для команд, чувствительных к стоимости, базовым вариантом через API станет DeepSeek V4 Pro — $0,077 на задачу. Если код нельзя отправлять во внешние API, разверните модель с открытыми весами, например Kimi K3 (70,8% SWE-bench Verified) или MiniMax M2.5 (75,8%). Модели с открытыми весами сократили отставание от лидеров с закрытыми весами до нескольких процентных пунктов на SWE-bench Verified.
Проблема harness: инструмент агента может ограничить модель
Harness, на котором работает агент — Claude Code, Codex CLI, Cursor или open-source инструмент вроде OpenCode, — определяет четыре вещи, неподконтрольные самой модели: управление контекстом, включая момент сжатия и то, что нужно сохранить; определения и маршрутизацию инструментов; паттерны восстановления после ошибок; а также процессы ревью и подтверждения действий. Как отмечает анализ Tembo, результат модели в контролируемом harness, таком как mini-SWE-agent, может не отражать её реальную долю успешно решённых задач в иначе настроенной системе. Поэтому для сравнения моделей полезнее бенчмарки с одинаковым harness, чем результаты от вендоров, где смешаны улучшения и модели, и самого harness.
Прежде чем менять модель, проведите аудит harness. Проверьте, эффективно ли агент сжимает контекст, чисто ли определены инструменты и разумно ли он повторяет действия после ошибок вместо бесконечного цикла.
FAQ
Какая LLM дешевле всего для coding-агентов?
DeepSeek V4 Pro при цене $0,435 за миллион входных и $0,87 за миллион выходных токенов — самый дешёвый вариант уровня frontier. Одна решённая агентная задача обходится примерно в $0,08.
Как протестировать модели для coding-агентов на собственном репозитории?
Выберите 20–30 характерных задач из реального бэклога: добавьте исправления багов, новые функции и рефакторинг. Запустите каждую модель через выбранный harness на одном и том же наборе задач. Отслеживайте три метрики: долю решённых задач — прошёл ли патч агента ваши тесты, расход токенов на задачу и время до завершения. Такая оценка на конкретном репозитории предсказывает реальную пользу лучше любого публичного бенчмарка.