 AIREITER
Если нужен быстрый старт, хостинговый API d1 остаётся самым беспроблемным вариантом: $0,04 за миллион входных токенов. Однако новые чекпойнты с открытыми весами делают локальный инференс вполне реалистичным — с важной оговоркой: по качеству между моделями на 3B и 600M параметров лежит заметная пропасть.
Три версии Liquid d1 — это разные продукты
Сейчас у Liquid AI есть три релевантных варианта: проприетарный хостинговый сервис d1, модель с открытыми весами d1-3B и экспериментальная open-weight-модель d1-omni-600M. Liquid AI не заявляла, что хостинговая модель идентична какому-либо из доступных для скачивания чекпойнтов. Поэтому результаты бенчмарков и данные о задержках нельзя переносить с одной модели на другую.
| Вариант | Доступ и цена | Входные данные | Заявленный контекст | Для чего подходит |
|---|---|---|---|---|
Хостинговый d1 | Liquid API; $0,04 за 1 млн входных токенов, выходные токены не тарифицируются | Текст и изображения напрямую через Liquid | 66K, согласно данным Vercel | Быстрая интеграция, почти нулевые расходы на инференс, без эксплуатации модели |
d1-3B | Весовые файлы доступны для скачивания; поминутной платы за токены нет | Текст, JSON и изображения | 32 768 токенов | Лучшее локальное качество, компьютерное зрение, оценка для production |
d1-omni-600M | Экспериментальные веса доступны для скачивания; поминутной платы за токены нет | Текст с изображением либо текст с аудио | 16 384 токена | Компактное развёртывание, эксперименты с голосовыми командами, ограниченные edge-устройства |
Все три модели отвечают на типизированные вопросы, а не генерируют текст. noul возвращает вероятность ответа «да», choice — вероятности для именованных вариантов, а score — позицию на упорядоченной шкале с учётом вероятностей. Это модели для маршрутизации, модерации, проверки, защитных ограничений и скоринга; чат- или coding-модель они не заменят.
Рекомендация проста: для пилота используйте хостинговый d1; выбирайте d1-3B, если данные должны оставаться локально или задержка не должна включать сетевой переход; а d1-omni-600M стоит считать экспериментальным вариантом, если только аудио или минимальный размер модели не являются решающими требованиями.
Что дешевле: API или локальный запуск
Liquid AI берёт за d1 API $0,04 за миллион входных токенов. Платы за выходные токены нет, поскольку сервис возвращает решения, а не сгенерированный текст. Обработка 100 миллионов входных токенов обойдётся в $4 до учёта возможных комиссий шлюза; миллиард токенов — в $40.
При цене $0,04 за миллион токенов самостоятельный хостинг редко выигрывает только по стоимости инференса. Локальный запуск имеет смысл ради приватности, офлайн-работы, задержки на устройстве, кастомизации или стабильно высокой загрузки.
У двух открытых чекпойнтов нет официальной цены хостинга за токены. На момент обзора их страницы Hugging Face не предлагали inference-провайдера, поэтому цену хостингового d1 нельзя выдавать за цену d1-3B или d1-omni-600M.
Изображения в хостинговом сервисе тоже считаются входными данными. Liquid AI указывает 1,5 токена на патч размером 32×32 пикселя: изображение 1024×1024 займёт 1 536 токенов ещё до текста вопроса. При ставке $0,04 за миллион токенов доля изображения стоит около $0,00006144; каждый вопрос тарифицируется как отдельный промпт и включает связанное с ним изображение.
Открытые веса не означают полной свободы и нулевой стоимости
Оба репозитория распространяются по лицензии Liquid AI lfm1.0, а не Apache 2.0 или MIT. В общих условиях ценообразования Liquid AI сказано, что её скачиваемые модели можно бесплатно использовать коммерчески, пока годовая выручка компании не превышает $10 миллионов. Крупным организациям стоит проверить актуальные коммерческие условия, а не делать выводы о разрешённом использовании только по формулировке «open-weight».
В бюджет локального запуска нужно заложить покупку GPU или устройства, простаивающие мощности, мониторинг, обновления и рабочее время команды. Счёт за хостинговый сервис переменный и очень небольшой; локальные расходы в основном фиксированы.
d1-3B выбирают за качество, omni — за компактность
В официальном анонсе Open d1 приведены результаты Decision Index v0.2.1: 48,57 у d1-3B и 15,95 у d1-omni-600M. Liquid AI прогнала обе модели через официальный оценщик, однако эти результаты не были официальными заявками в таблицу лидеров.
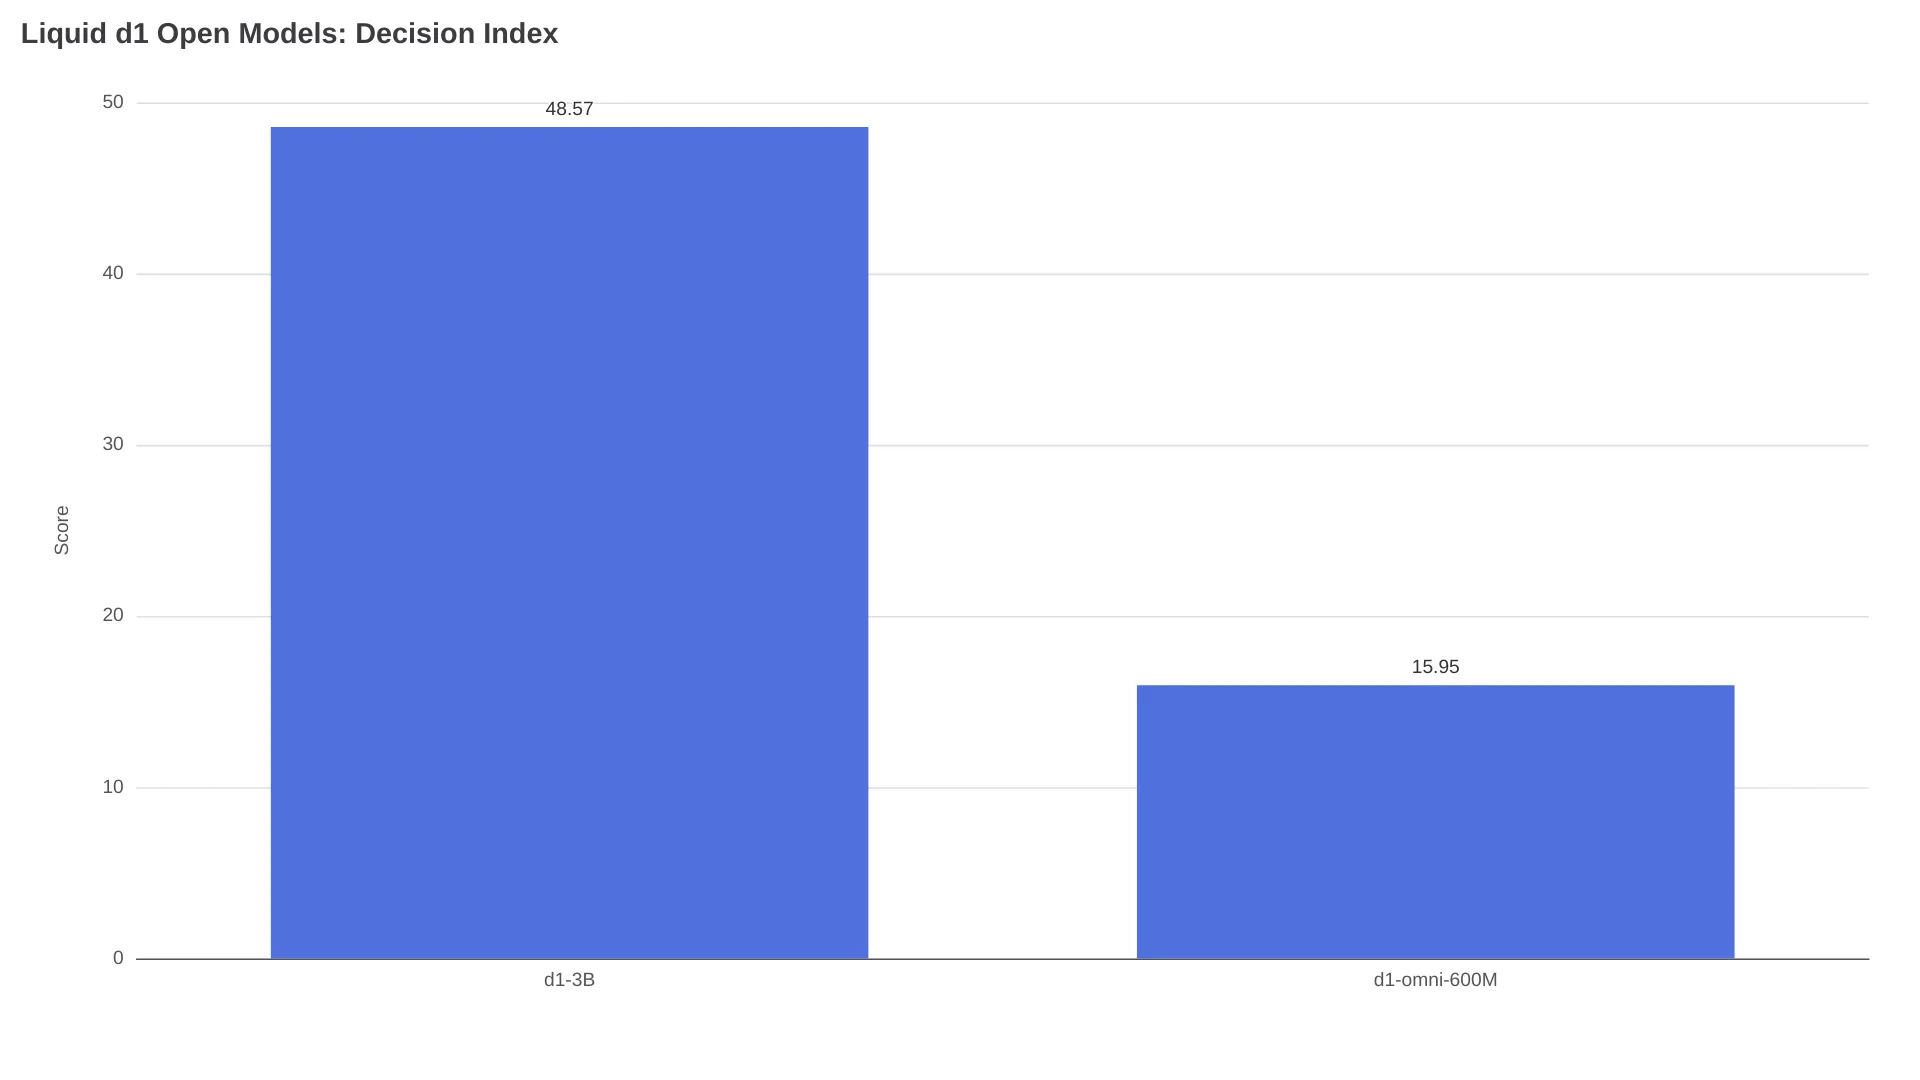
При этом меньшая модель не проваливается во всём. На семи публичных текстовых бенчмарках Liquid AI сообщает средние результаты 82,9 для d1-3B и 78,4 для d1-omni-600M. Omni оказалась впереди на Civil Comments — 95,8 против 93,0 — и PAWS-X — 79,5 против 76,9; на остальных пяти задачах из списка лидировала 3B. Но гораздо более широкий разрыв в Decision Index показывает: нескольких сильных классификационных сценариев недостаточно, чтобы считать чекпойнт 600M универсальной заменой 3B.
| Характеристика | d1-3B | d1-omni-600M |
|---|---|---|
| Точное число параметров | 3,12B | 587M |
| Размер репозитория/весов в полной точности | Репозиторий 6,27 ГБ; веса 6,25 ГБ | Модель F32, около 0,6B параметров |
| Контекст | 32 768 | 16 384, общий для всех модальностей |
| Лимит текста при работе с изображением | В пределах контекста модели | Текст состояния и вопроса сокращается до 896 токенов при наличии изображений |
| Аудио | Нет | Один монофонический клип 16 кГц длительностью до 30 секунд |
| Изображение и аудио одновременно | Неприменимо | Не поддерживается; вызывает ValueError |
| Официальная таблица скорости | Есть | Нет; ранний исследовательский релиз |
В карточке модели d1-omni-600M указано, что она обучалась в float32. Float16 сохранил лучший ответ в 243 текстовых, 214 визуальных и 416 аудиостроках, тогда как при bfloat16 лучший ответ менялся в 0,8% текстовых строк и в 1,7% аудиострок. Иными словами, dtype здесь нужно валидировать: это не просто переключатель оптимизации.
Локально модель запускается быстро, но валидация займёт время
В обеих карточках моделей доступны методы system_one для одного состояния и system_one_batch для упакованных запросов. Самый короткий путь к запуску d1-3B требует Transformers 5.14 или новее, PyTorch, TorchVision, Pillow и пользовательский код из репозитория.
- Установите указанные зависимости:
pip install "transformers>=5.14" torch torchvision pillow- Загрузите модель, разрешив выполнение кода из удалённого репозитория:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- Передавайте именованные решения, а не чат-промпт:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
Параметр trust_remote_code=True означает, что Python-код из репозитория выполняется в процессе сервинга. Перед production лучше закрепить проверенный коммит, а не загружать постоянно меняющуюся ветку. Репозиторий d1-3B также ссылается на квантизованные версии для совместимых рантаймов llama.cpp, Ollama и LM Studio; сторонний квантизованный артефакт — это отдельный вопрос цепочки поставки и точности по сравнению с официальными весами BF16.
В карточке d1-3B указано время прогретого вызова с одним вопросом: 8 мс на RTX 4090, 30 мс на Apple M5 Pro и 50 мс на Jetson Orin Nano. Обработка состояния на 3,4K токена заняла 102 мс, 640 мс и 1 640 мс на тех же устройствах. Значения для GPU — медианы 20 запусков; результат в 8 мс на 4090 получен с compiled CUDA graphs, а новая форма входа потребует накладных расходов на компиляцию или выбор ядра.
Для d1-omni-600M официальной таблицы скорости нет. В браузерном порте сообщалось примерно о 180 мс на комментарий при обработке четырёх решений:
«Я пока не тестировал её на других машинах, только на своём MBP M4 Pro». — u/FinancialAd1961 на Reddit
Этот результат на одном устройстве подтверждает работоспособность в браузере, но ничего не говорит о производительности в других браузерах, на других GPU, с иными квантизациями или размерами батча.
С API проще, но идентичность модели всё равно важна
Для прямого доступа к хостинговой модели используется идентификатор d1 и endpoint https://api.liquid.ai/decisions/v1/systemone. В Vercel модель называется liquid/d1; на её странице указаны контекст 66K и та же ставка $0,04 за миллион входных токенов. В октябрьском анонсе Liquid от 5 числа говорилось, что Vercel и OpenRouter на тот момент поддерживали только текст, тогда как прямой Liquid API принимал изображения.
Открытые чекпойнты используют локальные Python-методы с теми же концепциями решений, но схожесть интерфейсов не доказывает эквивалентность поведения. Их вероятности могут различаться достаточно сильно, чтобы конкретный случай пересёк порог автоматизации. Для каждой оценённой ветки фиксируйте точный ID модели, ревизию, dtype, вероятность и порог.
Поэтому миграцию стоит проводить в четыре этапа:
- Соберите размеченный набор из реального production-распределения, включая неоднозначные случаи и дорогостоящие ошибки.
- Пропустите через каждого кандидата одинаковые состояния, схему вопросов и критерии.
- Подбирайте пороги по стоимости ложноположительных и ложноотрицательных срабатываний, а не по общему баллу бенчмарка.
- Протестируйте победителя в теневом режиме, прежде чем разрешать разрушительные, финансовые, связанные с контролем доступа или безопасностью действия.
Какой Liquid d1 выбрать
Для большинства команд хостинговый API — рекомендация по умолчанию. Цена токенов слишком мала, чтобы небольшой пилот оправдывал отдельный проект по локальному сервингу, а вместе с API исчезают заботы о драйверах, квантизации, прогреве и планировании мощностей.
| Требование | Выбор | Причина |
|---|---|---|
| Самый быстрый выход в production | Хостинговый d1 | Управляемый endpoint и прозрачная тарификация входных данных |
| Данные не должны покидать устройство или сеть | d1-3B | Самый сильный открытый чекпойнт и локальное выполнение |
| Лучшее опубликованное качество решений среди открытых моделей | d1-3B | 48,57 по Decision Index против 15,95 |
| Классификация голосовых команд | d1-omni-600M | Единственный вариант здесь с аудио, ограниченным 30 секундами |
| Самый компактный экспериментальный вариант | d1-omni-600M | 587M параметров, но без официальной таблицы задержек |
| Открытые объяснения или генерация действий | Ни один из вариантов | После этапа принятия решения добавьте генеративную модель |
Выбирайте d1-3B вместо omni, если только размер модели 600M или аудиотракт не являются критически необходимыми. Пятикратное сокращение числа параметров выглядит привлекательно, но оно не отменяет разрыв в 32,62 пункта по Decision Index и экспериментальный статус omni.
FAQ по Liquid AI d1
Liquid AI d1 бесплатна?
Хостинговый сервис d1 стоит $0,04 за миллион входных токенов; плата за выходные токены не взимается. Открытые чекпойнты можно скачать без поминутной платы за токены, но на них по-прежнему распространяются коммерческие условия LFM 1.0 и расходы на локальные вычисления.
d1-3B и d1-omni-600M — это та же модель, что и в хостинговом d1 API?
Liquid AI не документировала идентичность ни одного из чекпойнтов хостинговому d1. Считайте их связанными, но отдельными продуктами: у них разные ID моделей, контексты, бенчмарки и способы развёртывания.
Можно ли запускать Liquid d1 через Ollama?
На странице d1-3B есть ссылки на квантизованные версии, рассчитанные на llama.cpp, Ollama, LM Studio и совместимые приложения. Прежде чем заменять официальный путь через Transformers, проверьте квантизатор, ревизию источника, поддержку decision API и точность.
Поддерживает ли d1-3B аудио?
Нет. d1-3B принимает текст, JSON и изображения. d1-omni-600M принимает текст с изображениями либо текст с одним аудиоклипом длительностью до 30 секунд, но не может принимать изображения и аудио в одном запросе.
Сколько VRAM нужно для локального d1?
Liquid публикует файл весов BF16 размером 6,25 ГБ для d1-3B, но не приводит единого требования к VRAM. На итоговый объём влияют накладные расходы рантайма, состояние image encoder, длина контекста, размер батча, точность и квантизация; измеряйте нужную конфигурацию, а не приравнивайте размер файла к пиковому потреблению VRAM.
Какой бы вариант вы ни выбрали, проверьте пороги вероятностей на размеченных production-данных до автоматизации решений с серьёзными последствиями.
Читайте также: обзор хостингового Liquid AI d1 API подробнее разбирает прямой endpoint, тарификацию изображений и типизированный контракт запросов.