Qwen4 Max API를 이제 Token Plan 미리보기만이 아니라 종량제로 사용할 수 있다. 입력은 100만 토큰당 $1.50, 출력은 $4.50이며 컨텍스트 윈도우는 1M 토큰이다. 지금부터는 qwen4-max를 사용하자. qwen4-max-preview는 2026년 11월 25일 종료되기 때문이다.
Qwen4-Max API 한눈에 보기: 2026년 11월 16일 정식 출시
Alibaba는 11월 11일부터 Token Plan 전용으로 제공하던 미리보기 버전을 거쳐, 2026년 11월 16일 Alibaba Cloud Model Studio에 Qwen4-Max를 qwen4-max라는 이름으로 정식 출시했다. @Alibaba_Qwen은 이를 새로운 MoE 아키텍처와 네이티브 비전, 1M 토큰 컨텍스트 윈도우를 갖춘 모델이라고 소개했으며, API는 QwenCloud에서 바로 사용할 수 있다. 해외 사용자를 위한 QwenCloud 문서는 Model Studio 내용을 그대로 반영한다. 지역에 맞는 Model Studio 엔드포인트를 선택하면 된다(QwenCloud 문서).
| 항목 | Qwen4-Max (qwen4-max) |
|---|---|
| 상태 | 2026년 11월 16일 정식 출시. 미리보기 qwen4-max-preview는 2026년 11월 11일부터 11월 25일까지 제공된 뒤 종료 |
| 입력 / 출력 | 싱가포르 국제 리전 기준 100만 토큰당 $1.50 / $4.50 |
| 캐시 읽기 | 100만 토큰당 $0.075 |
| 기타 리전 | 미국(버지니아), 프랑크푸르트, 도쿄, 홍콩에서는 100만 토큰당 $1.413 / $4.24 |
| 컨텍스트 | 1M 토큰. 최대 입력은 991K 토큰으로 안내됨 |
| 최대 출력 | 사고 기능을 끄면 131,072토큰, 사고 기능과 답변을 함께 사용하면 262,144토큰 |
| 입력 형식 | 텍스트, 이미지, 동영상 |
| API 방식 | OpenAI 호환 및 Anthropic 호환. 툴 호출, 구조화된 JSON 출력, 웹 검색, 캐싱, 배치, 파인튜닝 지원 |
| 리전 | 싱가포르, 미국(버지니아), 프랑크푸르트, 도쿄, 홍콩, 베이징. 배치 작업은 베이징만 지원 |
| 체험 혜택 | 싱가포르 신규 계정은 90일 동안 100만 무료 토큰 제공 |
위 가격과 한도는 2026년 11월 16일 기준 Alibaba Cloud Model Studio 문서에서 확인한 내용이다(가격표, QwenCloud 문서). 예를 들어 싱가포르에서 입력 10만 토큰과 출력 1만 토큰을 사용하면 비용은 약 $0.15 + $0.045, 총 $0.195다.
Qwen3.8-Max에서 실제로 달라진 점
Qwen이 Artificial Analysis 수치를 인용해 공개한 자료에 따르면 Qwen4-Max의 Intelligence Index는 43이다. Qwen3.8-Max(xhigh)보다 9점 높고 Kimi K3.1 Pro보다는 3점 낮은 수치다. 작업당 평균 비용은 $3.27로 Qwen3.8-Max의 약 3분의 1이며, 출력 토큰도 39% 적다.
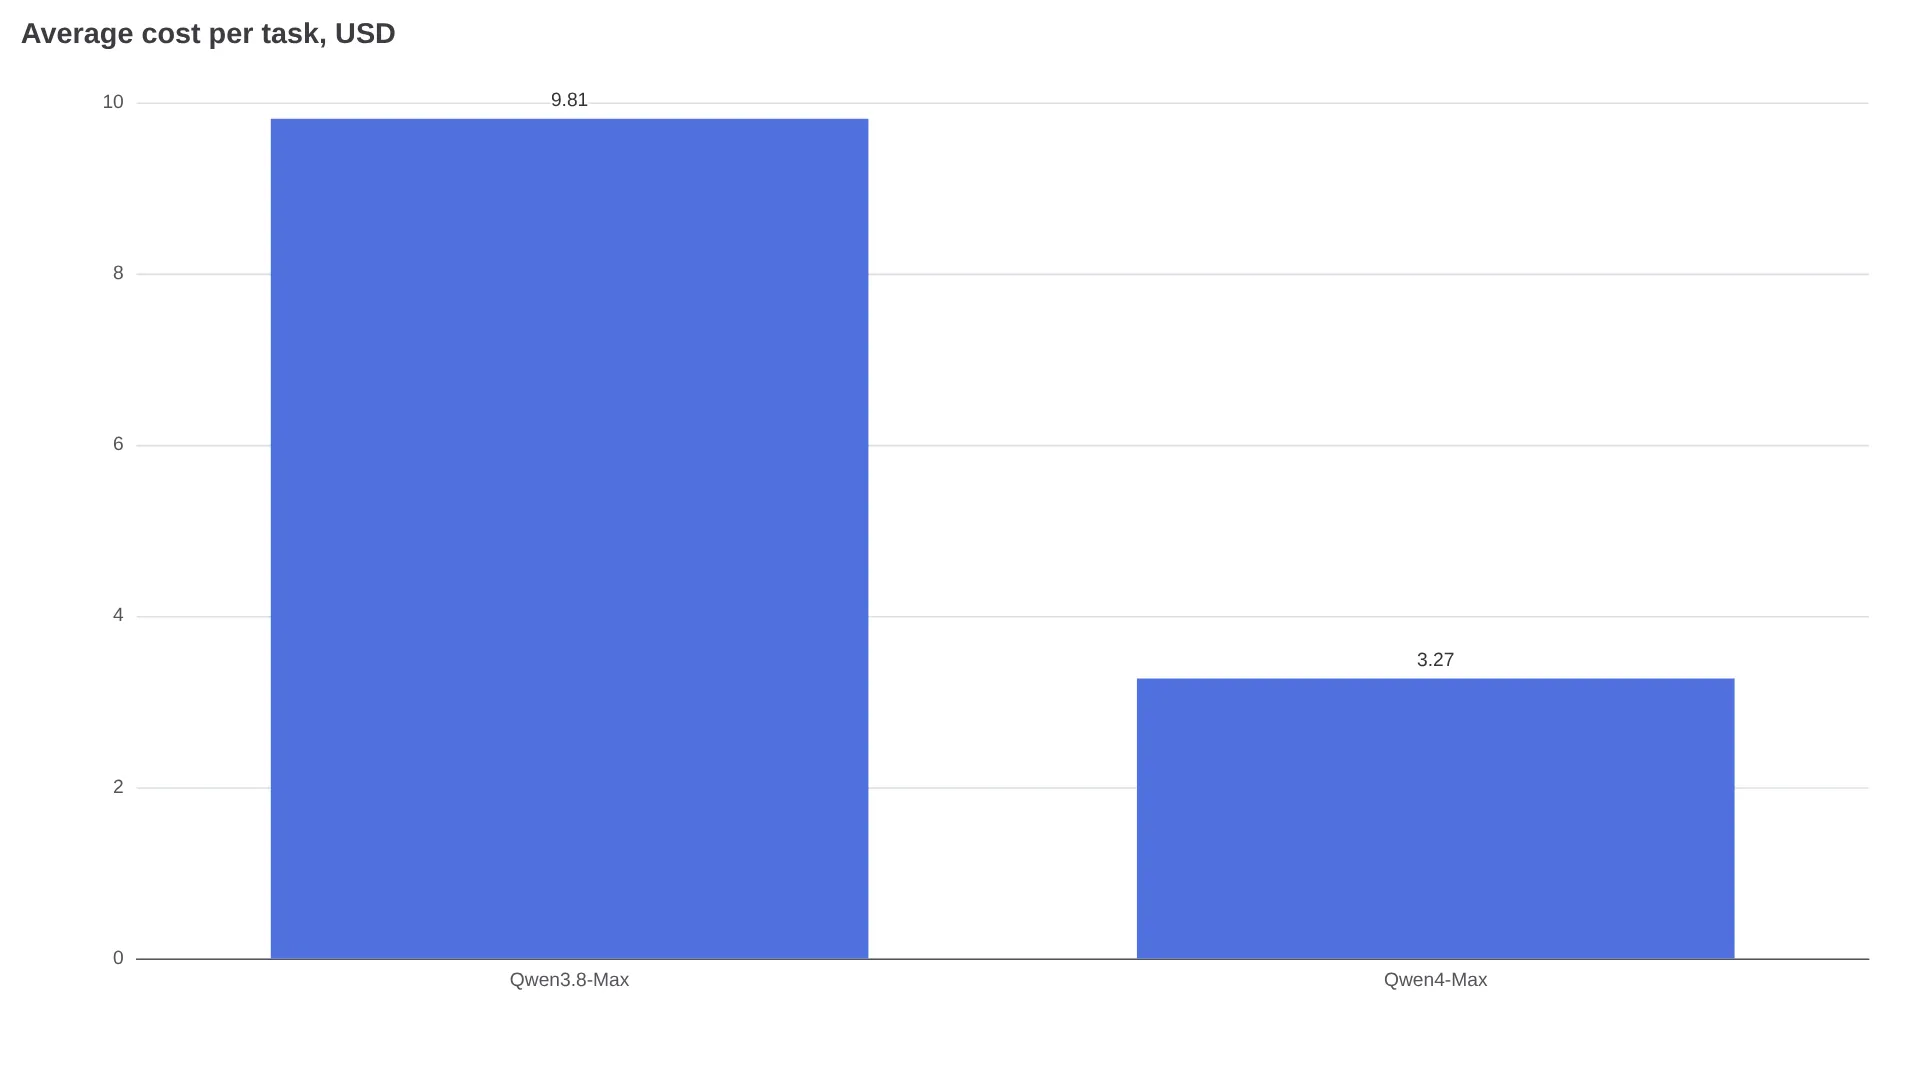
비용 절감 효과는 두 가지에서 나온다. 표에 나온 토큰 단가가 낮고, 작업 하나를 처리하는 데 필요한 토큰 수도 줄었다. Qwen의 내부 평가에서는 최대 약 50%까지 감소했다. 특히 캐시를 재사용하는 1M 토큰 규모의 작업에서 차이가 크다. 암묵적 캐시 읽기 비용이 100만 토큰당 $0.075로, Qwen3.8-Max 캐시보다 70% 저렴하다고 안내되기 때문이다.
Qwen4-Max는 네이티브 비전 MoE 백본을 사용한다. 전체 파라미터는 2.4T, 활성 파라미터는 71B, N-gram 임베딩은 328B다. 다만 Qwen 블로그가 Artificial Analysis 점수를 인용한 것과 달리, AI First Look과 AICoder는 11월 16일 기준 전체 벤치마크 표와 공개 AA 리더보드 등재 정보가 아직 나오지 않았다고 지적했다.
이전 모델이 궁금하다면 다음 글도 함께 볼 만하다. Qwen3.8-Max API 가격, Qwen3.8-Max와 Kimi K3 비교.
요금에 직접 영향을 주는 사양과 제한
1M이라는 숫자보다 실제 사용량과 비용에 더 큰 영향을 주는 제한은 세 가지다.
전체 컨텍스트와 실제 입력 한도는 다르다. 컨텍스트 윈도우는 1M 토큰이지만 QwenCloud가 안내하는 최대 입력은 991K 토큰이다. 여유분을 남겨두고, 검색·검색증강 작업처럼 중간 영역의 컨텍스트를 많이 참조하는 용도라면 회수 성능을 직접 테스트하는 편이 안전하다.
출력과 사고 과정이 같은 예산을 나눠 쓴다. 사고 기능을 끄면 최대 출력은 131,072토큰이다. 사고 기능을 켜면 사고 과정과 최종 답변이 262,144토큰 예산을 공유하므로, 추론이 길어질수록 답변에 쓸 공간이 줄어든다. XenoSpectrum의 미리보기 사양 정리에 따르면 미리보기 버전은 사고 과정과 답변을 합쳐 393,216토큰까지 허용했다. 따라서 미리보기 한도를 운영 환경에 그대로 하드코딩하면 안 된다.
기본 사고 설정도 바뀌었다. 사고 기능은 기본적으로 켜져 있다. 정식 버전의 기본값은 high이며 low와 xhigh도 선택할 수 있다. 반면 AI First Look의 사양표에 따르면 미리보기 버전의 기본값은 xhigh였다. 응답 속도가 느리다면 우선 reasoning_effort를 low로 낮춰보자.
멀티모달 입력은 텍스트, 이미지, 동영상을 지원한다. XenoSpectrum의 미리보기 사양 정리에 따르면 미리보기 동영상 제출 한도는 요청당 2시간, 2GB, 64개였다. 이는 제출 제한일 뿐, 긴 동영상을 제대로 이해한다는 보장은 아니다. 장시간 동영상은 자신의 파일로 직접 회수 성능을 확인해야 한다.
비용을 관리하려면 구조화된 JSON 출력을 요청해 불필요하게 긴 답변을 줄이고, 긴 컨텍스트는 캐시 읽기로 재사용하자. 싱가포르 기준 캐시 읽기 비용은 100만 토큰당 $0.075다. 또한 AICoder의 출시 정리에는 지원되는 환경에서 5분간 유지되는 명시적 캐시 생성 비용이 100만 토큰당 $1.875로 기재돼 있다.
OpenAI SDK로 qwen4-max 호출하기
Alibaba Cloud 모델 문서에 따르면 Model Studio는 OpenAI Chat Completions, Responses, Anthropic Messages API 형식을 지원한다. 종량제 백엔드에는 qwen4-max를 사용하고, qwen4-max-preview는 Token Plan 전용이라는 점을 기억하자.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
API 키와 엔드포인트는 반드시 같은 Model Studio 리전에 맞춰야 한다. 지원되는 환경에서는 response_format={"type": "json_object"} 또는 JSON Schema를 요청하고, 규모가 큰 구조화 출력은 별도로 검증하자.
종량제, Token Plan, 채팅 앱 중 어떤 경로를 고를까
| 경로 | 적합한 용도 | 주요 제약 |
|---|---|---|
Model Studio 종량제 (qwen4-max) | 앱, 백엔드, 배치 작업 | 토큰 단위 과금. 리전 엔드포인트와 API 키를 확인해야 함 |
Token Plan (qwen4-max-preview) | Claude Code, Cline, Cursor, OpenCode에서의 대화형 코딩 | 대화형 사용만 지원. 운영 자동화, 배치 스크립트, 백엔드 삽입은 불가. 싱가포르 리전만 지원하며 2026년 11월 25일 24:00 UTC+8에 종료 |
| Qwen Chat, QwenWork, QwenStudio, Qoder | 키를 연결하지 않고 프롬프트, 문서 작업, 에이전트형 IDE를 시험할 때 | 사용 가능 여부와 크레딧 요율은 앱 안에 표시되며 API 계약이 아님 |
Token Plan은 대화형 개발을 위한 월간 크레딧 풀이다. Apidog의 Token Plan 정리에 따르면 개별 요금제는 20,000크레딧을 제공하는 Lite가 이벤트 가격 $3 / 정가 $8부터 시작하며, 200,000크레딧을 제공하는 Pro는 이벤트 가격 $43 / 정가 $51이다. 발급 키는 sb-sp-로 시작한다. 키 공유, 백그라운드 작업 실행, 배포한 백엔드에 키 삽입은 약관 위반이다. 프롬프트를 가볍게 시험할 목적이라면 Apidog과 XenoSpectrum이 Qwen Chat, QwenWork, QwenStudio, Qoder를 평가 경로로 소개하고 있다. 사용 가능 여부는 계정마다 다르며 앱 안에서 확인해야 한다.
2026년 11월 25일 전에 다음 순서로 이전하자.
qwen4-max-preview에서qwen4-max로 모델 문자열을 변경한다.- Token Plan의 기본 URL과 키 대신 Model Studio 종량제 키와 지역별 엔드포인트로 전환한다.
- 사고 기본값이
xhigh에서high로 바뀐 점을 반영해 다시 테스트한다. - 출력 예산을 재측정한다. 미리보기의 393K 공유 한도와 정식 버전의 131K/262K 한도는 다르다.
초기 사용자 평가: 새 프로젝트는 빠르지만 에이전트 성능은 엇갈려
AI First Look이 취합한 소규모 테스트에서는 한 번의 프롬프트만으로 프로젝트를 완성한 사례가 보고됐다. 숨겨진 테스트 20개 중 20개를 약 2.5분 만에 통과했으며, Qwen3.8-Max는 17분이 걸렸다. 다만 같은 정리에서는 게임 테스트에서 Qwen4-Max가 더 빨리 완료했지만 종합 평가는 2위에 그쳤다는 결과도 함께 언급한다.
코드 생성을 시도할 때 이런 오류가 계속 발생합니다.
— @bijanbowen, 게시물 (2026년 11월 16일 실제 사용자 첫인상. 반복되는 코드 생성 오류 스크린샷 포함)
초기 중국어 사용자 테스트 모음(@weconomypistis)에서는 가격과 작업당 비용을 가장 큰 장점으로 꼽았다. 반면 터미널과 에이전트 조작은 Kimi보다 한 단계 뒤처졌고 응답도 더 느렸다는 평가가 나왔다.
FAQ
Qwen4-Max는 오픈 웨이트 모델인가?
아니다. AI First Look의 추적 자료에 따르면 11월 16일 기준 Qwen4-Max는 가중치가 공개되지 않은 호스팅 전용 모델이다. Qwen4-Max 발표문은 더 작은 Qwen4 모델의 오픈 웨이트가 추후 제공될 예정이라고 밝혔지만, 날짜와 모델 크기, 라이선스는 아직 공개하지 않았다.