 AIREITER
컨텍스트 윈도우는 100만 토큰, 기본 추론 강도는 최대로 설정된 중국계 MoE 플래그십 두 모델이 불과 3주 간격으로 나왔다. 하지만 API 비용 구조는 전혀 다르다. Kimi K3는 코딩 성능이 더 뛰어나지만 출력 100만 토큰당 $15를 받는다. 이는 Qwen 3.8 Max의 $6보다 2.5배 높다. 반대로 Qwen 3.8 Max는 차트 해석과 컴퓨터 사용에서 앞서며, 2026년 8월 3일 GA된 더 저렴하고 최신인 선택지다. 다만 두 모델 모두 기본적으로 최대 수준의 추론을 수행하므로, Kimi K3의 높은 출력 단가는 요청을 거듭할수록 부담이 커진다. Qwen의 공개 가중치도 8월 11일경까지는 기다려야 한다.
사양은 비슷하지만 선택 기준은 분명하다
Qwen 3.8 Max와 Kimi K3는 모두 총 파라미터 수가 조 단위인 MoE 모델이며, 100만 토큰 컨텍스트와 네이티브 비전을 지원한다. 2026년 중반에 3주 차이로 출시돼 스펙만 놓고 보면 같은 급으로 분류하기 쉽고, 그래서 비교가 벤치마크 점수 싸움으로 흐르기 쉽다. 실제로 따져야 할 것은 더 좁다. 코딩 품질 우위를 위해 어느 정도의 출력 비용을 감수할지, 그리고 지금 당장 공개 가중치나 강한 멀티모달 성능이 필요한지다.
| 사양 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| 총 파라미터 | 2.4T | 2.8T |
| 토큰당 활성 파라미터 | ~95B | 104B |
| 아키텍처 | MoE (~4% 활성화) | MoE (896개 전문가 중 16개) |
| 컨텍스트 윈도우 | ~1M (최대 입력 991K) | 1,048,576 |
| 비전 | 지원(텍스트 + 이미지 입력) | 지원(네이티브) |
| 기본 추론 설정 | xhigh, thinking 활성화 | 최대 강도, reasoning 활성화 |
| 공개 가중치 | 아니요(~8월 11일 공개 예정) | 예(HF, 7월 27일, 1.56TB MXFP4) |
| API 상태 | GA, 2026년 8월 3일 | GA |
출처: yottalabs 직접 비교, AIReiter를 통한 Alibaba QwenCloud, Moonshot platform.kimi.ai. 2026년 8월 6일 확인.
API 가격과 실제 워크로드 비용
두 회사 모두 토큰 단위 가격을 공개한다. 파라미터 수만 보면 예상하기 어렵지만, 가격 차이는 출력 토큰에서 크게 벌어진다. 추론 모델은 이 구간에서 비용의 대부분을 쓴다. Kimi K3는 출력 100만 토큰당 $15, Qwen 3.8 Max는 $6이며, 두 모델 모두 기본적으로 추론 과정을 출력하므로 이 요금은 최종 답변뿐 아니라 추론 트레이스에도 적용된다.
| 100만 토큰당 가격 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| 입력(캐시 미스) | $2.00 | $3.00 |
| 입력(캐시 히트) | $0.25 | $0.30 |
| 출력(추론 포함) | $6.00 | $15.00 |
| 컨텍스트 | ~1M | 1,048,576 |
출처: Alibaba QwenCloud 모델 페이지(2026년 8월 2일 업데이트), Moonshot platform.kimi.ai/docs/pricing/chat-k3. 2026년 8월 6일 확인.
입력 2,000만 토큰, 캐시 히트율 60%, 출력 500만 토큰의 일반적인 코딩 워크로드를 가정해 보자. Kimi K3는 입력 $27.60과 출력 $75를 합쳐 약 $103이 든다. Qwen 3.8 Max는 입력 $19와 출력 $30으로 약 $49다. 약 2배 차이의 대부분은 출력 비용에서 나온다. 캐싱은 입력 가격 격차를 줄이지만 출력 가격 차이는 줄여 주지 않는다. 게다가 두 모델 모두 기본값이 최대 추론 강도라 출력 비중이 커진다.
접근 방식도 다르다. Qwen 3.8 Max는 2026년 8월 3일 Alibaba API에서 정식 출시됐지만 가중치는 아직 공개되지 않았다. 모델 페이지에는 여전히 Open Source: No로 표시되며, 가중치는 8월 11일이 포함된 주에 Hugging Face와 ModelScope로 공개될 예정이다(Qwen 3.8 Max 가격 페이지를 통한 Alibaba). 공개 가중치가 필요한 쪽은 Kimi K3다. Moonshot은 7월 27일 1.56TB MXFP4 체크포인트를 올렸고 API도 이용할 수 있다.
Kimi K3는 AIReiter의 Kimi K3 API endpoint를 통해서도 Moonshot 공식 요금 그대로, 추가 마진 없이 이용할 수 있다. 한 청구서에서 다른 모델과 함께 K3를 테스트하려는 경우 유용하다. Qwen 3.8 Max는 아직 이 서비스에 통합되지 않았다.
에이전틱 코딩은 Kimi K3가 앞선다
여러 단계를 거치는 코딩 작업이라면 Kimi K3가 더 적합하다. 에이전트 루프, 저장소 리팩터링, 도구 호출과 막다른 상황의 복구가 필요한 SWE 유형 작업이 여기에 해당한다. 공개된 에이전틱 벤치마크 전반에서 Kimi K3는 꾸준히 Qwen 3.8 Max보다 높은 점수를 냈고, 실제 엔지니어링 업무와 가까운 과제일수록 격차가 더 크다.
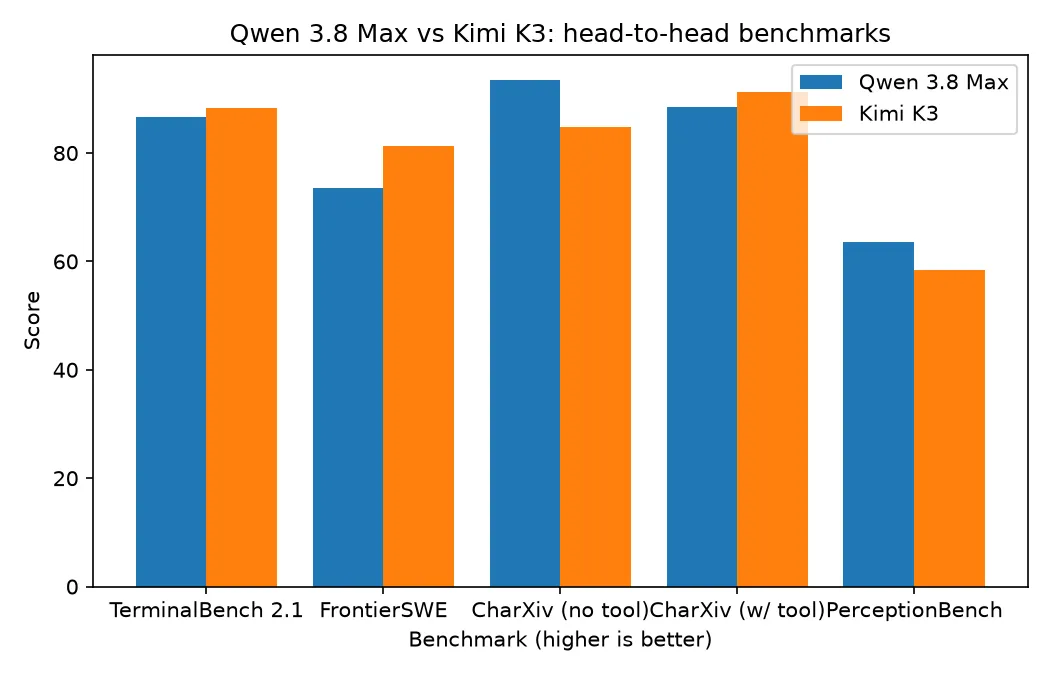
| 벤치마크 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| FrontierSWE | 73.5 | 81.2 |
| TerminalBench 2.1 | 86.6 | 88.3 |
| CharXiv(도구 사용) | 88.4 | 91.3 |
출처: yottalabs 직접 비교. 2026년 8월 6일 확인.
커뮤니티 평가도 수치와 대체로 일치한다. 다만 이 비교의 핵심인 비용 문제가 함께 따라온다.
"K3는 최상급이다. Qwen 3.8도 거의 비슷하다. 하지만 두 모델 모두 구독이나 API 비용을 정당화하기는 어렵다…" — r/Qwen_AI
"이 작업에서 K3는 Qwen 3.8을 크게 앞선다. 다만 이 랜딩 페이지 생성은 Qwen이 Kimi보다 3배 빨랐다." — X의 @filicroval
Kimi K3는 순수 지능 점수도 더 높다. Artificial Analysis Intelligence Index는 57이다. 대신 속도는 느린 편으로, 초당 출력 토큰은 약 39개, 첫 토큰까지 걸리는 시간은 3.1초 수준이다(Artificial Analysis). 품질과 개방성을 얻는 대신 지연 시간과 비용을 감수하는 선택이다.
멀티모달과 비용 효율은 Qwen 3.8 Max
차트나 스크린샷을 읽고, 브라우저를 조작하거나 컴퓨터 사용 작업을 수행하는 비중이 높다면 Qwen 3.8 Max가 맞는다. 코딩 벤치마크에서 마지막 몇 점을 더 얻는 것보다 출력 비용이 중요할 때도 마찬가지다. 문서·인식 벤치마크에서 Kimi K3를 앞서며, 컴퓨터 사용 벤치마크 하나에서는 검증된 SOTA도 기록했다. 출력 요금은 Kimi K3의 40% 수준이다.
| 벤치마크 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| CharXiv(도구 미사용) | 93.5 | 84.8 |
| PerceptionBench | 63.5 | 58.5 |
| OSWorld-Verified | 86.1% (SOTA) | 공개 점수 없음 |
출처: yottalabs 직접 비교. 2026년 8월 6일 확인.
Qwen 3.8 Max의 약점은 Kimi K3가 가장 강하고 프런티어 비공개 모델들과도 경쟁하는 영역이다. SWE-bench Pro 점수는 67.7로 Claude Fable 5의 80보다 크게 낮다(Alibaba가 공개한 표, 벤더 자체 실행). 따라서 가장 어려운 소프트웨어 엔지니어링 평가용 모델은 아니다. 이 글 작성 시점에 API도 정식 출시된 지 3일밖에 되지 않았고(2026년 8월 3일 GA), 가중치 역시 아직 비공개다. 지금 자체 호스팅이 필요하다면 기다리거나 Kimi K3를 선택해야 한다.
워크로드별 추천
어느 모델이 객관적으로 더 낫냐보다, 어떤 작업에 호출할지가 선택을 좌우한다. 아래 표는 일반적인 워크로드별로 권장 모델과 확인된 근거를 정리한 것이다.
| 워크로드 | 추천 모델 | 이유 |
|---|---|---|
| 에이전트 루프, 저장소 리팩터링, SWE 작업(비용이 제약이 아닐 때) | Kimi K3 | FrontierSWE 81.2 대 73.5, TerminalBench 88.3 대 86.6 |
| 문서·차트 파싱, 브라우저 또는 컴퓨터 사용, 비용 민감 워크로드 | Qwen 3.8 Max | CharXiv 93.5, OSWorld 86.1% SOTA, 출력 $6 대 $15 |
| 지금 바로 자체 호스팅 | Kimi K3 | 7월 27일부터 HF에서 가중치 제공, Qwen은 ~8월 11일 공개 예정 |
FAQ
코딩에는 Qwen 3.8 Max가 Kimi K3보다 좋은가?
아니다. 중요한 에이전틱 코딩 벤치마크에서 Kimi K3가 앞선다(FrontierSWE 81.2 대 73.5, TerminalBench 2.1 88.3 대 86.6). 여러 단계를 거치는 엔지니어링 작업이라면 Kimi K3가 더 강한 선택이다.
Qwen 3.8 Max와 Kimi K3 중 어느 쪽이 더 저렴한가?
Qwen 3.8 Max다. 출력 100만 토큰당 $6로 Kimi K3의 $15보다 낮고, 입력도 $2 대 $3이다. 캐시 히트 가격은 비슷하며, 일반적인 코딩 워크로드에서는 비용이 약 2배 차이 난다.
최대 추론 강도에서 에이전틱 코딩 비용이 더 낮은 모델은?
여전히 Qwen 3.8 Max다. 두 모델 모두 최대 강도 추론 토큰을 출력으로 과금한다. 따라서 Kimi K3가 성능 우위를 보이는 바로 그 코딩 워크로드에서 $15/M 요금이 비용 격차를 더 벌린다.
두 모델 모두 100만 토큰 컨텍스트를 지원하는가?
그렇다. Qwen 3.8 Max는 약 991K 입력 토큰을 받으며 thinking이 켜지면 이보다 줄어든다. Kimi K3는 1,048,576토큰을 지원한다. 둘 다 명목상 100만 토큰 컨텍스트 윈도우다.
가중치는 공개됐는가?
Kimi K3는 공개됐다. Moonshot은 2026년 7월 27일 1.56TB MXFP4 체크포인트를 배포했다. Qwen 3.8 Max는 아직 아니다. Alibaba는 비공개로 표기하고 있으며, 8월 11일이 포함된 주에 Hugging Face와 ModelScope 공개를 예고했다.
함께 읽기
- Kimi K3 model page: Kimi K3 단일 모델 상세 분석
- Qwen 3.8 Max API pricing: Qwen 3.8 Max의 전체 가격 및 기술 분석
- Qwen3.8-27B: 자체 호스팅용 소형 공개 가중치 Qwen 3.8 릴리스
- Kimi K2.7 Code vs GLM 5.2: 같은 코딩 모델군에서 살펴볼 수 있는 인접 비교