 AIREITER
17GB짜리 모델 파일을 내려받았다고 해서 곧바로 쾌적한 로컬 에이전트 환경이 갖춰지는 것은 아니다. Qwen3.8-27B는 Apache-2.0 라이선스의 강력한 오픈 웨이트 모델이지만, 기본값인 초고강도 추론은 양자화, 컨텍스트 예산, 서빙 스택이 장비와 맞지 않을 경우 간단한 작업도 한참 기다리게 만들 수 있다.
Qwen3.8-27B, 로컬에서 돌릴 만한가
GPU 메모리 또는 통합 메모리를 약 24GB 이상 확보할 수 있고, 데이터의 로컬 처리를 중요하게 여기며, 빠른 호스팅 API보다 다소 느린 대화형 응답을 감수할 수 있는 개발자라면 Qwen3.8-27B를 로컬에서 실행할 가치가 있다. 이 모델의 장점은 단일 벤치마크 점수에 있지 않다. 이미지와 비디오 입력, 262,144토큰의 네이티브 컨텍스트, 조절 가능한 추론 기능을 갖춘 Apache-2.0 기반의 dense 모델을 배포 가능한 규모로 제공한다는 점이 핵심이다. Qwen 공식 모델 카드에는 2026년 8월 14일 출시된 것으로 표기돼 있다.
다만 모든 API 모델을 자동으로 대체할 제품으로 보기는 어렵다. 공식 성능 수치는 벤더가 보고한 결과이고, 강한 양자화는 품질과 속도를 모두 바꾼다. 무엇보다 기본 xhigh 추론은 많은 로컬 대화형 작업에서 첫 설정으로 적합하지 않다.
벤치마크보다 먼저 봐야 할 것은 메모리다
Qwen3.8-27B는 dense 모델이라 생성되는 모든 토큰에서 전체 모델이 활성화된다. 따라서 가중치 파일 크기만으로는 알기 어려운 메모리 대역폭, KV 캐시, 양자화 방식, 요청 컨텍스트 길이가 실제 사용성에 결정적인 영향을 준다. Qwen 모델 카드는 262K 네이티브 컨텍스트를 지원한다고 명시하지만, 로컬 세션에서는 메모리와 속도를 확보하기 위해 이보다 훨씬 낮은 값으로 설정할 수 있다. Qwen의 서빙 예제에는 최대 262,144토큰이 나오지만, 이는 모든 소비자용 장비에 권할 만한 기본 설정이 아니라 모델의 한계치다.
| 가용 메모리 | 현실적인 시작 구성 | 예상되는 사용 경험 | 권장 사항 |
|---|---|---|---|
| 12GB | 강한 Q3급 양자화와 CPU/RAM 오프로딩 | 짧은 컨텍스트와 큰 지연 시간 손실 | 로컬 실험이 목적이 아니라면 더 작은 모델 권장 |
| 16GB | 강한 Q3 또는 신중하게 고른 Q4 스타일 양자화 | 짧고 관리되는 작업에는 가능하지만 컨텍스트와 속도가 제한됨 | 에이전트 워크플로에 도입하기 전 반드시 테스트 |
| 24GB | Q4급 양자화 | 코딩, 도구 사용, 적당한 컨텍스트를 위한 실질적 진입점 | 대부분의 로컬 Qwen3.8-27B 사용자에게 가장 잘 맞는 구성 |
| 32GB+ | 더 높은 품질의 양자화 또는 더 넉넉한 컨텍스트 여유 | KV 캐시와 긴 세션에서 감수해야 할 타협이 줄어듦 | 지속적인 에이전트 작업에는 이 등급 권장 |
위 내용은 벤더가 제시한 최소 사양이 아니라 운용 관점의 권장안이다. 독립 사용자 사례를 보면 12GB RTX 3060에서도 로컬 빌드를 실행하고 도구 호출까지 처리할 수 있다는 보고가 있는 반면, 해당 VRAM에서 dense 에이전트를 쓰면 성능이 좋지 않다는 경고도 있다. 바로 이 차이 때문에 ‘불러올 수 있다’와 ‘잘 쓸 수 있다’를 같은 의미로 봐서는 안 된다. 실제 사용자 논의는 r/LLM에서 확인할 수 있다.
24GB 카드는 편안한 4비트 워크플로의 하한선이지, 긴 컨텍스트까지 쾌적하다는 보장은 아니다. 배포 관점의 한 분석은 4비트 구성의 총 메모리를 17~19GB로 추정하면서도, 긴 에이전트 세션에서는 KV 캐시가 빠르게 커진다고 경고한다. Neoteric의 로컬 배포 분석은 공식 하드웨어 사양이 아니라 배포 계획에 참고할 만한 자료다.
기본 설정 그대로면 답답하게 느껴지는 이유
Qwen3.8-27B는 기본적으로 thinking을 활성화한다. 공식 모델 카드에서는 xhigh, medium, low 등의 reasoning_effort 값을 제공하며, 비추론 요청에는 enable_thinking=False를 쓸 수 있다. preserve_thinking도 기본적으로 켜져 있다. Qwen의 모범 사례 섹션은 추론 강도를 낮춘다고 해서 전체 작업 시간이 항상 줄어드는 것은 아니라고 설명한다. 그래도 사소한 작업에 높은 설정을 기본값으로 두는 것은 비용이 큰 선택이다.
Simon Willison의 로컬 테스트는 그 차이를 잘 보여 준다. 그는 LM Studio에서 Q4_K_M 빌드를 실행했으며, 기본 설정의 첫 SVG 작업에 추론 토큰 22,276개가 사용됐고 완료까지 21분이 걸렸다고 전했다. 추론을 끄자 결과물은 달라졌지만 137초 만에 끝났다. 그의 측정 환경이 보편적인 벤치마크는 아니지만, 설정에 따른 위험을 구체적으로 보여 주는 사례다. 전체 테스트와 기록 보기.
“3.6 35b와 비슷한 수준이지만 강한 양자화 때문에 더 느릴 것이라 예상했는데, 결과적으로는 모든 면에서 압도했다.” u/AltruisticList6000, r/LocalLLaMA, 16GB RTX 4060 Ti에서 Q3 실험을 진행한 사용자.
이 긍정적인 결과가 트레이드오프를 없애 주는 것은 아니다. 다른 실제 사용자 보고에서는 32K 컨텍스트가 제한적이었고 에이전트 세션의 신뢰성이 떨어졌다고 한다. 또 다른 사용자는 로컬 프로그래밍 작업에서는 명확하고 원자적인 지시가 필요하다고 권한다. 워크플로 논의는 여기서 볼 수 있다.
Qwen3.8-27B의 공식 사양
Qwen3.8-27B는 MoE가 아닌 dense 방식의 네이티브 비전-언어 모델이다. 공식 모델 카드는 텍스트, 이미지, 비디오 입력과 64개 레이어, 5,120 히든 차원, 262,144 네이티브 컨텍스트 토큰, Apache-2.0 라이선스를 설명한다. YaRN 기반 확장을 통해 최대 1M 토큰까지 지원한다고도 밝히지만, 정적 YaRN은 짧은 텍스트 성능을 해칠 수 있다고 명시적으로 경고한다. 공식 사양 및 컨텍스트 안내는 서드파티 출시 요약보다 우선해서 참고해야 한다.
공식 저장소에는 Transformers, vLLM, SGLang, TokenSpeed와 함께 llama.cpp, Ollama, LM Studio 같은 양자화 로컬 경로도 언급된다. 이 모델은 하이브리드 Gated DeltaNet 및 Gated Attention 구조를 사용하므로 실행기 지원 여부가 중요하다. 모델 오류를 진단하기 전에 먼저 실행기를 업데이트해야 한다. Qwen의 퀵스타트 저장소에는 OpenAI 호환 서빙 예제도 포함돼 있다.
공식 벤치마크가 말해 주는 것과 말해 주지 않는 것
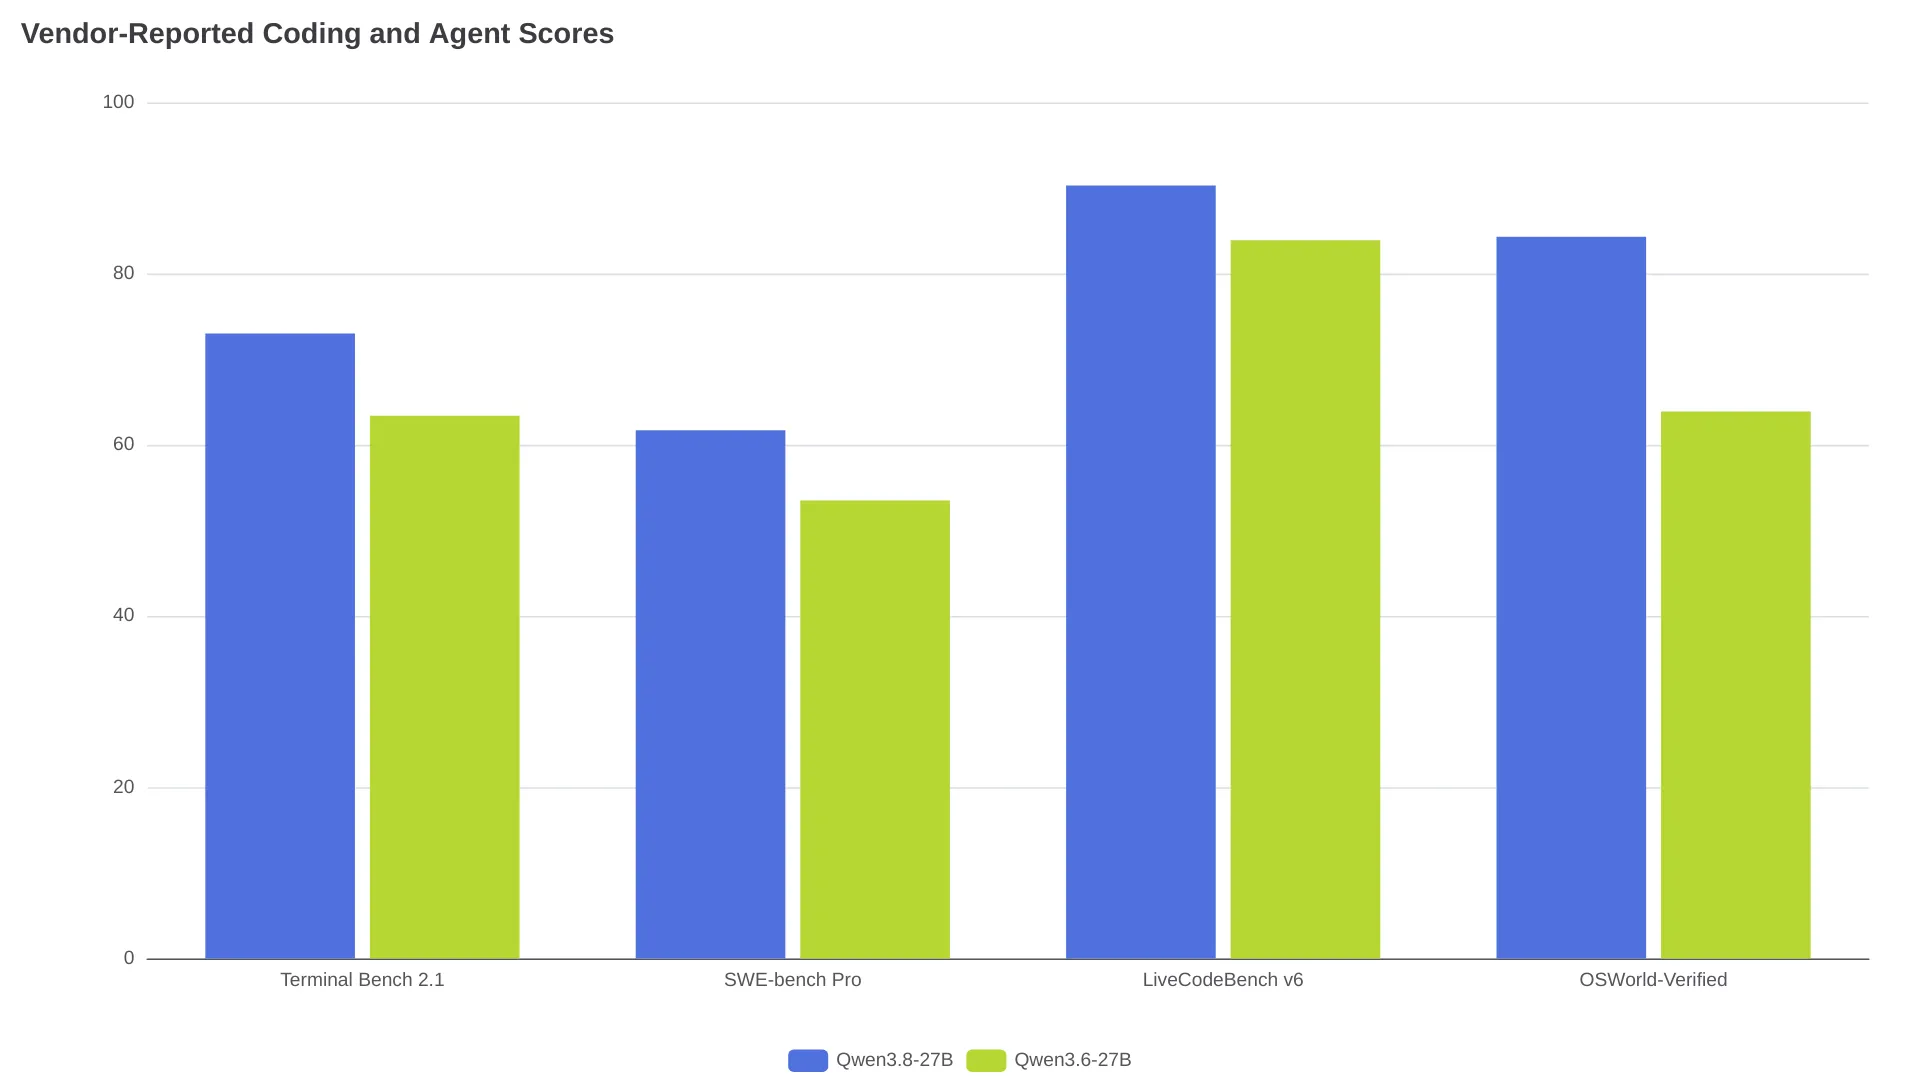
Qwen은 코딩과 컴퓨터 사용 평가에서 Qwen3.6-27B 대비 의미 있는 향상이 있었다고 보고한다. 아래 차트의 네 점수는 공식 모델 카드에 공개된 벤더 보고 수치이며, 독립적으로 재현된 결과는 아니다.
| 공식 벤치마크 | Qwen3.8-27B | Qwen3.6-27B | 해석 포인트 |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | 에이전트형 터미널 코딩 성능 신호 |
| SWE-bench Pro | 61.7 | 53.5 | 저장소 이슈 해결 성능 신호 |
| LiveCodeBench v6 | 90.3 | 83.9 | 코딩 평가 성능 신호 |
| OSWorld-Verified | 84.3 | 63.9 | 컴퓨터 사용 성능 신호 |
모델 카드에는 전체 비교 결과와 방법론이 공개돼 있다. SWE-bench Pro와 DeepSWE 1.1에서 Qwen은 Claude Code 하네스를 사용했고, temperature=1.0, top_p=0.95, 256K 컨텍스트로 평가했다고 밝힌다. QwenSWEBench 같은 자체 벤치마크도 포함한다. 모델 간 비교 전에 방법론을 확인하자. 이 수치가 뒷받침하는 결론은 ‘Qwen3.6-27B 대비 공식적으로 큰 폭의 업그레이드’까지다. ‘프론티어 API를 보편적으로 대체하는 모델’이라고 입증하는 수치는 아니다.
처음 로컬로 돌릴 때 추천하는 구성
첫 로컬 배포에서는 최대 추론 성능보다 예측 가능한 동작을 우선하는 편이 좋다. 최신 실행기를 사용하고, 24GB급 하드웨어에서는 Q4급 양자화부터 시작하자. 컨텍스트 한도는 의도적으로 낮게 잡고, 긴 자율 루프를 허용하기 전에 짧은 에이전트 작업부터 검증해야 한다.
- vLLM 또는 SGLang처럼 지원되는 엔진으로 OpenAI 호환 서버를 시작한다. Qwen은
Qwen/Qwen3.8-27B,--reasoning-parser qwen3,--tool-call-parser qwen3_coder를 사용하는 예제를 공개했다. 공식 명령어는 저장소에서 확인할 수 있다. - 일상적인 분류, 추출, 빠른 코드 수정에는
enable_thinking=False를 설정한다. Qwen은 비추론 모드의 샘플링 값으로temperature=0.7,top_p=0.80,presence_penalty=1.5를 권장한다. 공식 API 예제 보기. - 추론 비중이 높은 디버깅에서는 바로
xhigh로 가지 말고low또는medium부터 시도한 뒤, 실제 작업에서 총 완료 시간과 도구 호출 품질을 비교한다. - 작업이 각각 독립적이라면 보존된 thinking을 끈다. 여러 턴의 추론 문맥이 추가 KV 캐시 부담을 감수할 만큼 가치 있을 때만 보존한다.
- 무인 실행 전에 도구 호출, 출력 스키마 준수, 컨텍스트 롤오버를 테스트한다. 하나의 프롬프트에서 좋은 코드를 작성하는 모델이라도 장시간 에이전트 루프에서는 실패할 수 있다.
Qwen3.8-27B를 고르면 안 되는 경우
12GB 이하가 절대적인 한계이거나, 로컬 제어보다 응답 지연 시간이 중요하거나, 엄격한 형식 준수를 전제로 에이전트를 무인 실행해야 한다면 Qwen3.8-27B는 첫 선택으로 적합하지 않다. 제한된 환경에서도 실행은 가능하지만, 안정적인 대화형 처리량이나 저장소 작업에 필요한 충분한 컨텍스트를 제공한다는 뜻은 아니다.
독립 테스트에서는 긴 출력 경향, 높은 테일 레이턴시, 완벽하지 않은 엄격한 지시 준수도 확인됐다. 한 구조화 평가에서는 49개 테스트 중 4건의 타임아웃과 워크스테이션 구성 기준 143.32초의 P95 응답 시간을 기록했다. 이 수치를 다른 환경에 그대로 적용할 수 있는 성능 보장으로 볼 수는 없지만, 로컬 27B 모델을 검토 없는 자동화 구성 요소로 취급해서는 안 된다는 유용한 경고다. CrucibleMark의 테스트 보고서에는 구성과 한계가 정리돼 있다.
Qwen3.8-27B FAQ
Qwen3.8-27B는 공식 출시됐나?
그렇다. Qwen 공식 저장소는 Hugging Face Hub와 ModelScope의 Qwen3.8-27B 출시일을 2026년 8월 14일로 안내한다. Qwen의 출시 타임라인이 가장 우선적인 출처다.
Qwen3.8-27B를 16GB GPU에서 실행할 수 있나?
강한 양자화와 짧은 컨텍스트를 적용하면 실행할 수 있지만, 제약이 큰 배포 방식이다. 실제 사용자 보고는 16GB RTX 4060 Ti에서 유망한 Q3 결과를 얻었다는 사례부터, 낮은 VRAM에서 dense 에이전트를 사용할 때 속도와 품질의 손실이 크다는 경고까지 다양하다. LocalLLaMA 논의.
Qwen3.8-27B의 컨텍스트 윈도는 1M 토큰인가?
네이티브 컨텍스트는 262,144토큰이다. 모델 카드는 YaRN/RoPE 스케일링을 통해 1M 컨텍스트를 지원한다고 설명하며, 정적 YaRN이 짧은 텍스트 성능을 낮출 수 있다고 경고한다. 공식 컨텍스트 문서.
Qwen3.8-27B의 thinking은 어떻게 끄나?
Qwen 모델 카드의 예제처럼 API 요청에서 enable_thinking=False를 설정하면 된다. 추론이 필요한 작업이라면 처음부터 xhigh를 가정하지 말고 low 또는 medium부터 시작하는 편이 낫다. 공식 비추론 예제.
Qwen3.6-27B 사용자는 업그레이드해야 하나?
현재 하드웨어에서 동일한 배포 등급을 이미 실행할 수 있고, 코딩·컴퓨터 사용·멀티모달 개선이 워크로드에 도움이 된다면 업그레이드할 만하다. 현재 스택이 안정적이고, 새 실행기·양자화·추론 동작을 실제 워크플로에서 아직 검증하지 않았다면 Qwen3.6-27B를 유지하는 편이 낫다.
바꿀 수 없는 제약 조건부터 선택하자
| 제약 조건 | 다음 선택 |
|---|---|
| 로컬 데이터 처리와 24GB 메모리 확보 | Qwen3.8-27B를 Q4로 실행하고 low 또는 thinking 비활성화부터 시작 |
| 12GB~16GB만 사용 가능 | 관리되는 짧은 작업에 Q3 스타일 빌드를 테스트하거나 더 작은 모델 선택 |
| 긴 저장소 에이전트 세션 | 32GB+ 여유를 확보하고 도입 전 KV 캐시 동작 검증 |
| 빠른 대화형 응답 | 호스팅 API 또는 더 작은 로컬 모델 사용 |
| 엄격한 무인 포맷팅 또는 게시 작업 | 검증 계층과 사람의 검토를 유지하고, 모델의 형식 준수만 믿지 않기 |
Qwen3.8-27B는 로컬 배포 가능한 27B 모델이 시도할 수 있는 범위를 넓힌다. 하지만 시스템 측면의 작업까지 없애 주지는 않는다. 하드웨어에 맞는 양자화를 고르고, 추론을 의도적으로 제어하며, 다운로드 크기가 아니라 대표적인 실제 워크플로로 모델을 판단해야 한다.