 AIREITER
MuseTalk는 4GB 노트북 GPU에서도 실행됩니다. 공식 README에 따르면 RTX 3050 Ti Laptop에서 FP16으로 8초짜리 영상을 처리하는 데 대략 5분이 걸립니다. 결국 MuseTalk 립싱크에서 중요한 건 ‘실행되느냐’가 아니라 ‘충분히 빠르게 실행되느냐’입니다. 이 차이는 해상도, 설치 과정, 그리고 아래 비용표에서도 반복해서 드러납니다.
MuseTalk가 영상에서 바꾸는 것과 그대로 두는 것
MuseTalk는 기존 영상 속 입과 얼굴 하단을 다시 그려 입력한 오디오에 맞춰 립싱크를 적용합니다. 머리 위치, 눈 움직임, 표정, 배경, 카메라 움직임은 새로 생성하지 않고 원본을 그대로 사용합니다. 즉, 토킹헤드 영상을 처음부터 만드는 도구가 아니라 기존 영상에 국소적인 편집을 가하는 모델입니다. 얼굴이 선명하게 보이는 소스 영상이 먼저 필요합니다.
속도가 빠른 이유는 구조에 있습니다. Tencent Music의 Lyra Lab이 공개한 저장소는 고정된 sd-vae-ft-mse VAE로 마스크된 얼굴을 인코딩하고, 고정된 Whisper-tiny 모델로 오디오 특징을 추출합니다. 그런 다음 Stable Diffusion v1.4에서 가져온 UNet 안에서 크로스 어텐션으로 두 정보를 결합합니다. 반복적인 디노이징 루프 대신 잠재 공간에서 한 번에 인페인팅하기 때문에, 제작진은 NVIDIA Tesla V100에서 30fps 이상의 처리 속도를 달성했다고 설명합니다.
1080p 원본 영상에서 256x256 얼굴 영역이 의미하는 것
256x256은 최종 출력 해상도가 아니라 편집되는 얼굴 영역의 크기입니다. 1080p 영상은 원래 해상도와 프레임레이트를 유지한 채 출력되고, 입 주변에는 256x256 크기의 패치가 다시 생성되어 합성됩니다. 따라서 화면 안에서 얼굴이 작을수록 결과가 안정적입니다. 얼굴을 꽉 채운 클로즈업에서는 주변 얼굴은 선명한데 입 주변만 부드럽게 보이는 현상이 두드러질 수 있습니다.
이를 완화하는 방법은 두 가지지만 각각 대가가 따릅니다. --use_float16을 빼면 품질은 좋아지지만 더 많은 VRAM과 긴 처리 시간이 필요합니다. 완성된 영상에 GFPGAN 또는 CodeFormer 얼굴 복원을 적용하면 입 주변이 선명해지지만, 별도의 처리 과정이 추가되고 인물의 외모가 미묘하게 달라질 수 있습니다.
수치로 보는 품질: MuseTalk가 앞서는 지점과 Wav2Lip이 여전히 강한 지점
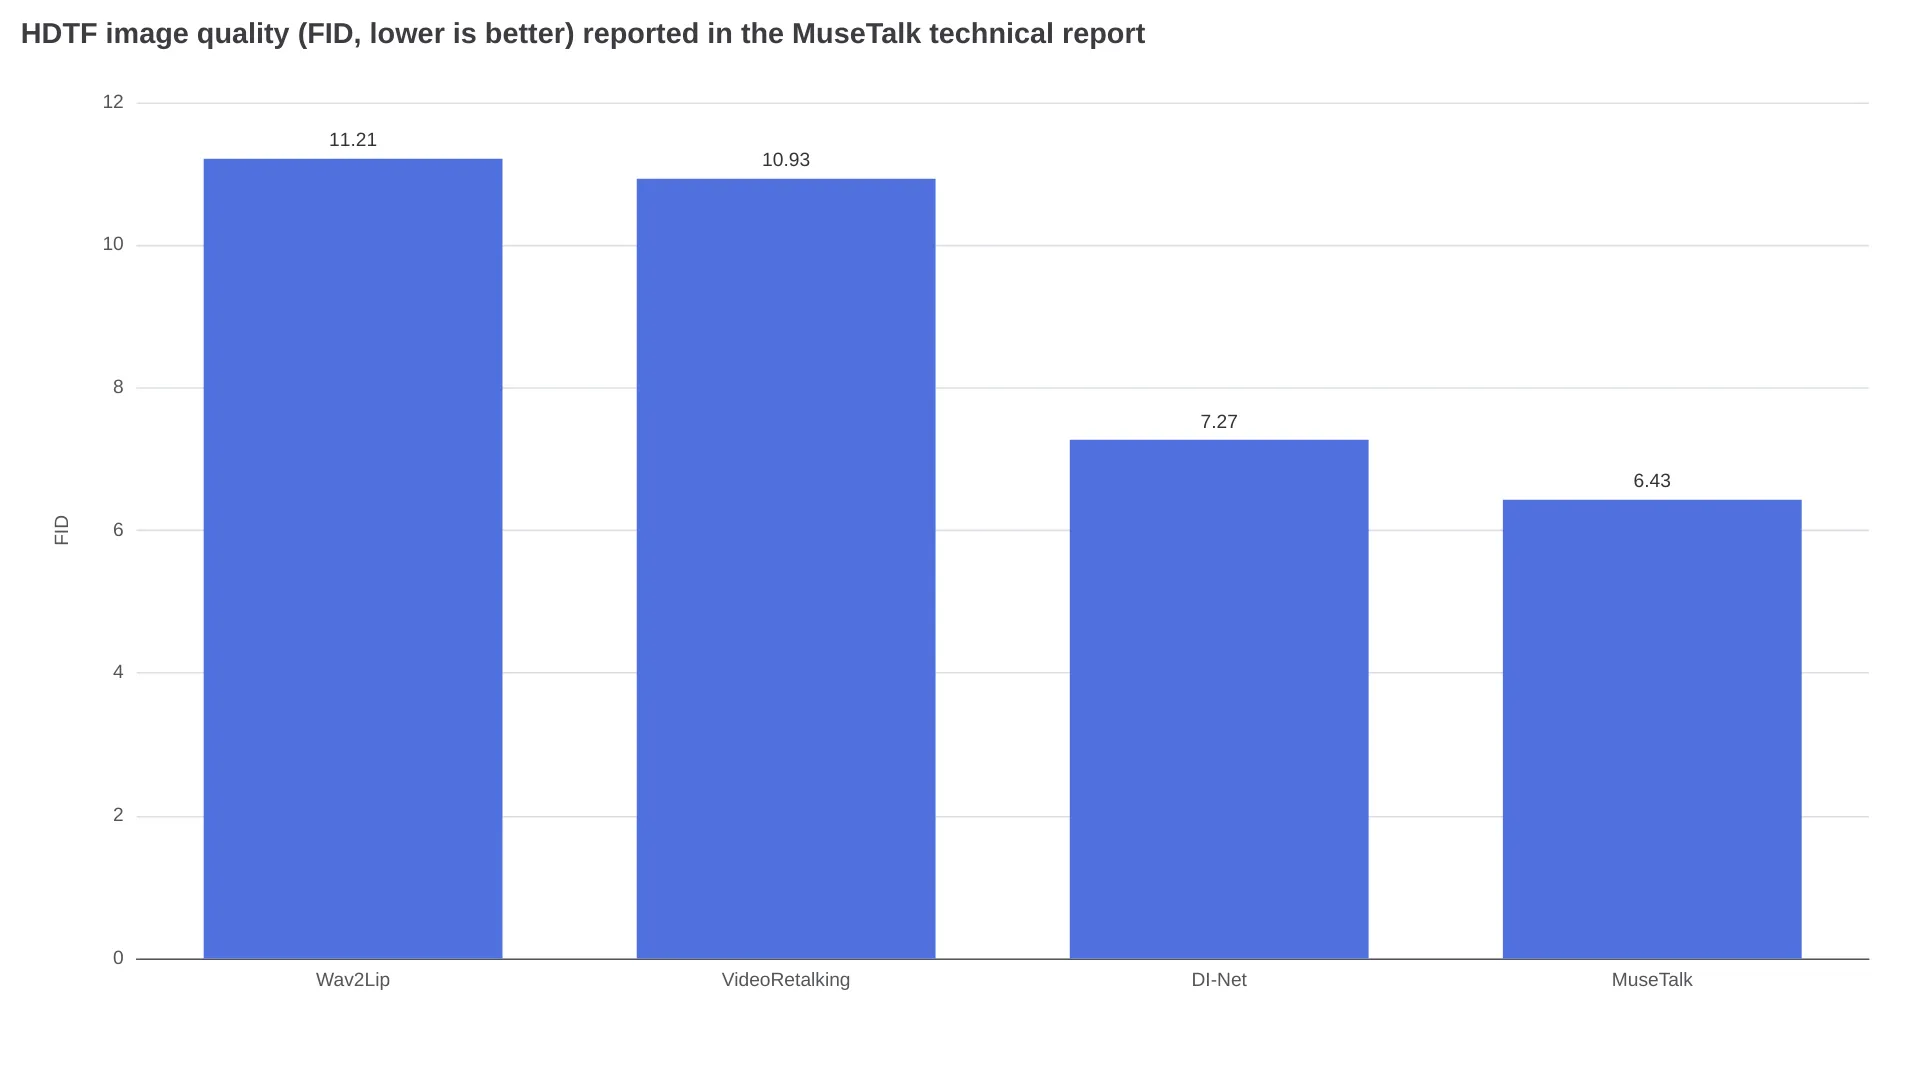
MuseTalk가 내세우는 강점은 순수한 싱크 정확도보다 이미지 품질에 있습니다. HDTF 데이터셋에서 MuseTalk 기술 보고서는 MuseTalk의 FID를 6.43으로 제시합니다. DI-Net은 7.27, VideoRetalking은 10.93, Wav2Lip은 11.21입니다.
하지만 싱크 지표로 넘어가면 순위가 바뀝니다. 같은 보고서에서 Wav2Lip의 LSE-C는 7.46, MuseTalk는 6.53입니다. 반면 인물 동일성은 MuseTalk가 CSIM 0.8225로 Wav2Lip의 0.8184를 근소하게 앞섭니다. 오래된 GAN 모델인 Wav2Lip은 입 모양 추적에서, MuseTalk는 이미지 충실도에서 더 나은 결과를 보인다는 뜻입니다. 보고서의 사용자 평가도 전반적으로 중간 수준에 머뭅니다. 시각 품질은 5점 만점에 3.62, 동일성은 3.55, 립싱크는 3.41입니다.
256x256이라는 한계를 함께 놓고 보면, 이 수치는 MuseTalk가 설득력 있는 미디엄 샷에는 적합하지만 4K 클로즈업까지 견디는 모델은 아니라는 점을 보여줍니다.
1분 립싱크에 드는 비용
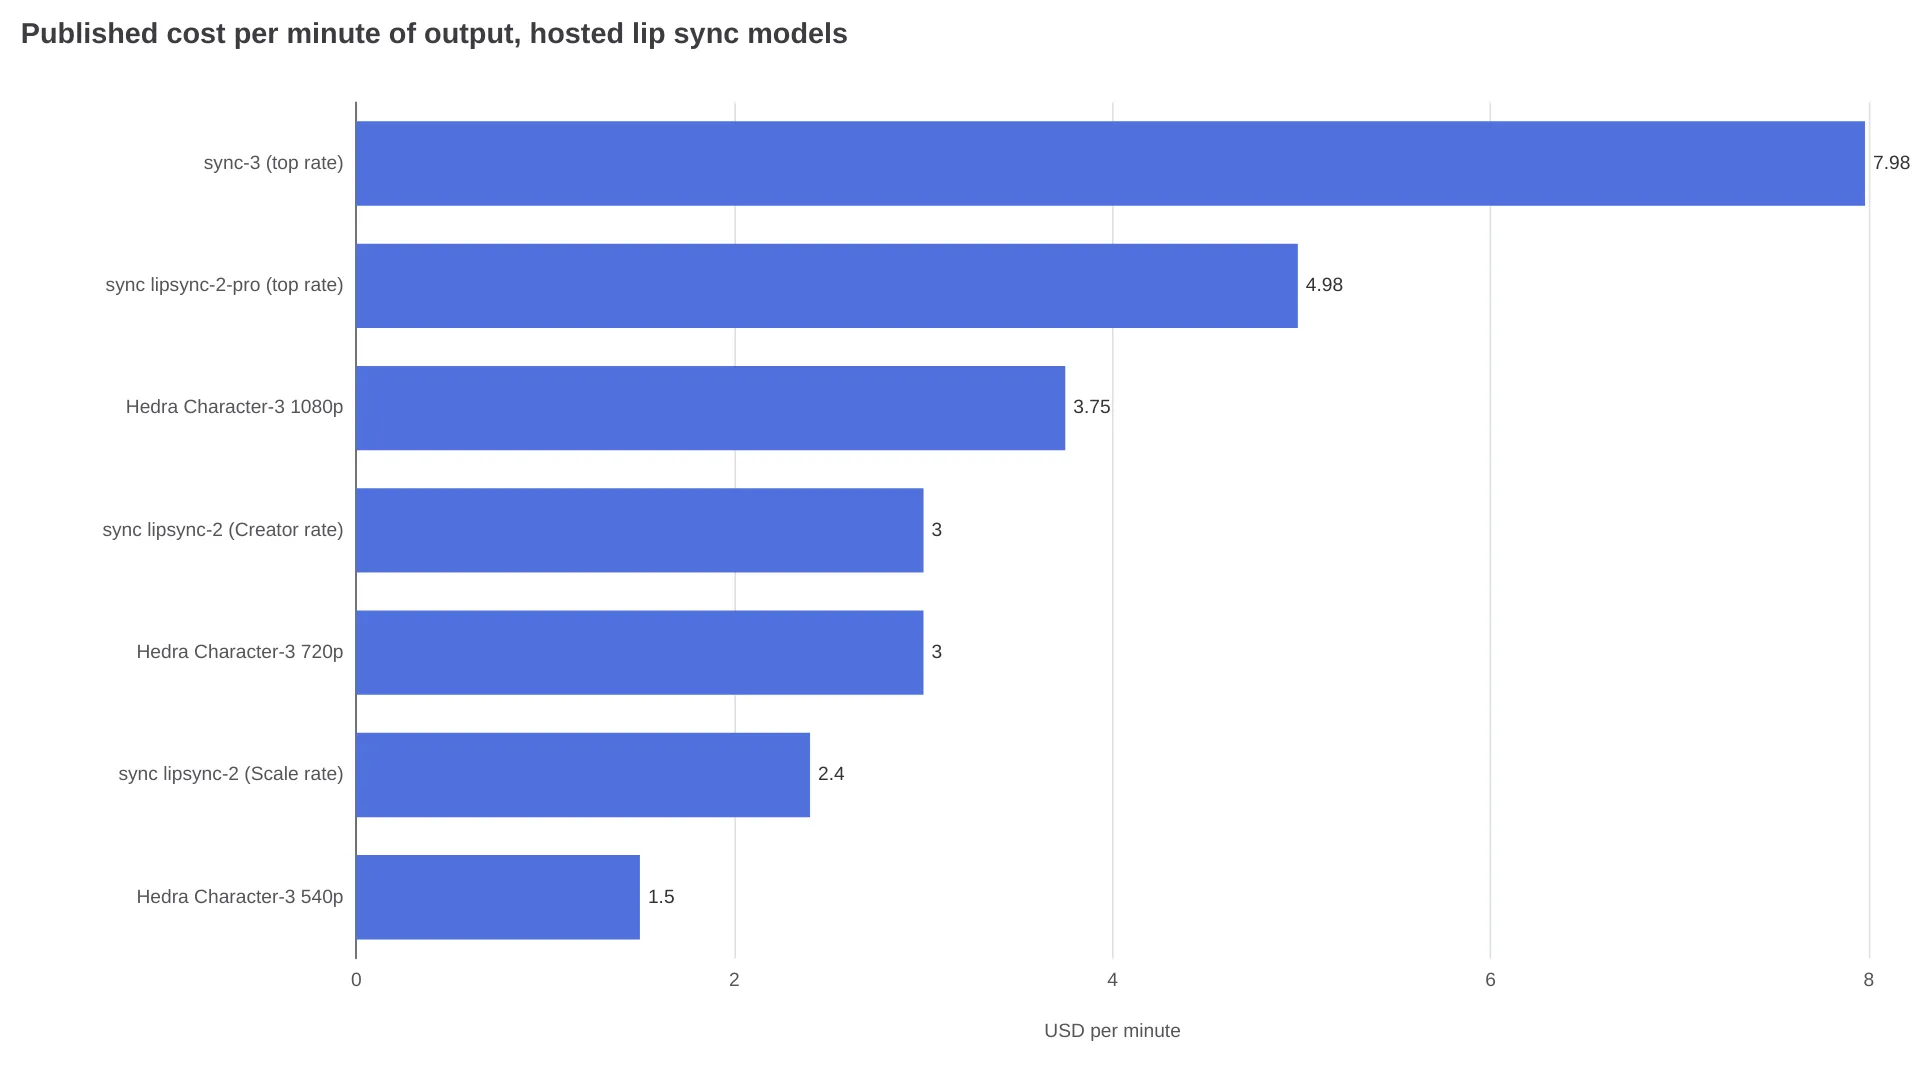
오픈소스 방식의 장점이 가장 분명해지는 부분입니다. 호스팅 립싱크 모델의 공개 요금은 출력 1분당 $1.50에서 거의 $8.00 사이에 형성되어 있습니다.
| 방식 | 공개 요금 (청구 단위는 서로 다름) | 출력 1분당 비용 | 얼굴 해상도 |
|---|---|---|---|
| MuseTalk 셀프 호스팅, Tesla V100 대여 | $0.188 / GPU-hour | 클립 1분당 GPU 2분 기준 약 $0.006 | 256x256 |
| Replicate의 MuseTalk | 실행당 약 $0.052, 모델 페이지 기준 일반적인 실행 시간 54초 | 분당이 아니라 실행 단위로 청구 | 256x256 |
| fal.ai의 MuseTalk | 컴퓨팅 초 단위로 청구 | 모델 페이지에 공개되지 않음 | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — 기존 영상에 바로 적용하는 방식이 아닌 image-to-video | 초당 2.5¢ / 5¢ / 6.25¢ | $1.50 / $3.00 / $3.75 | 해당 없음 |
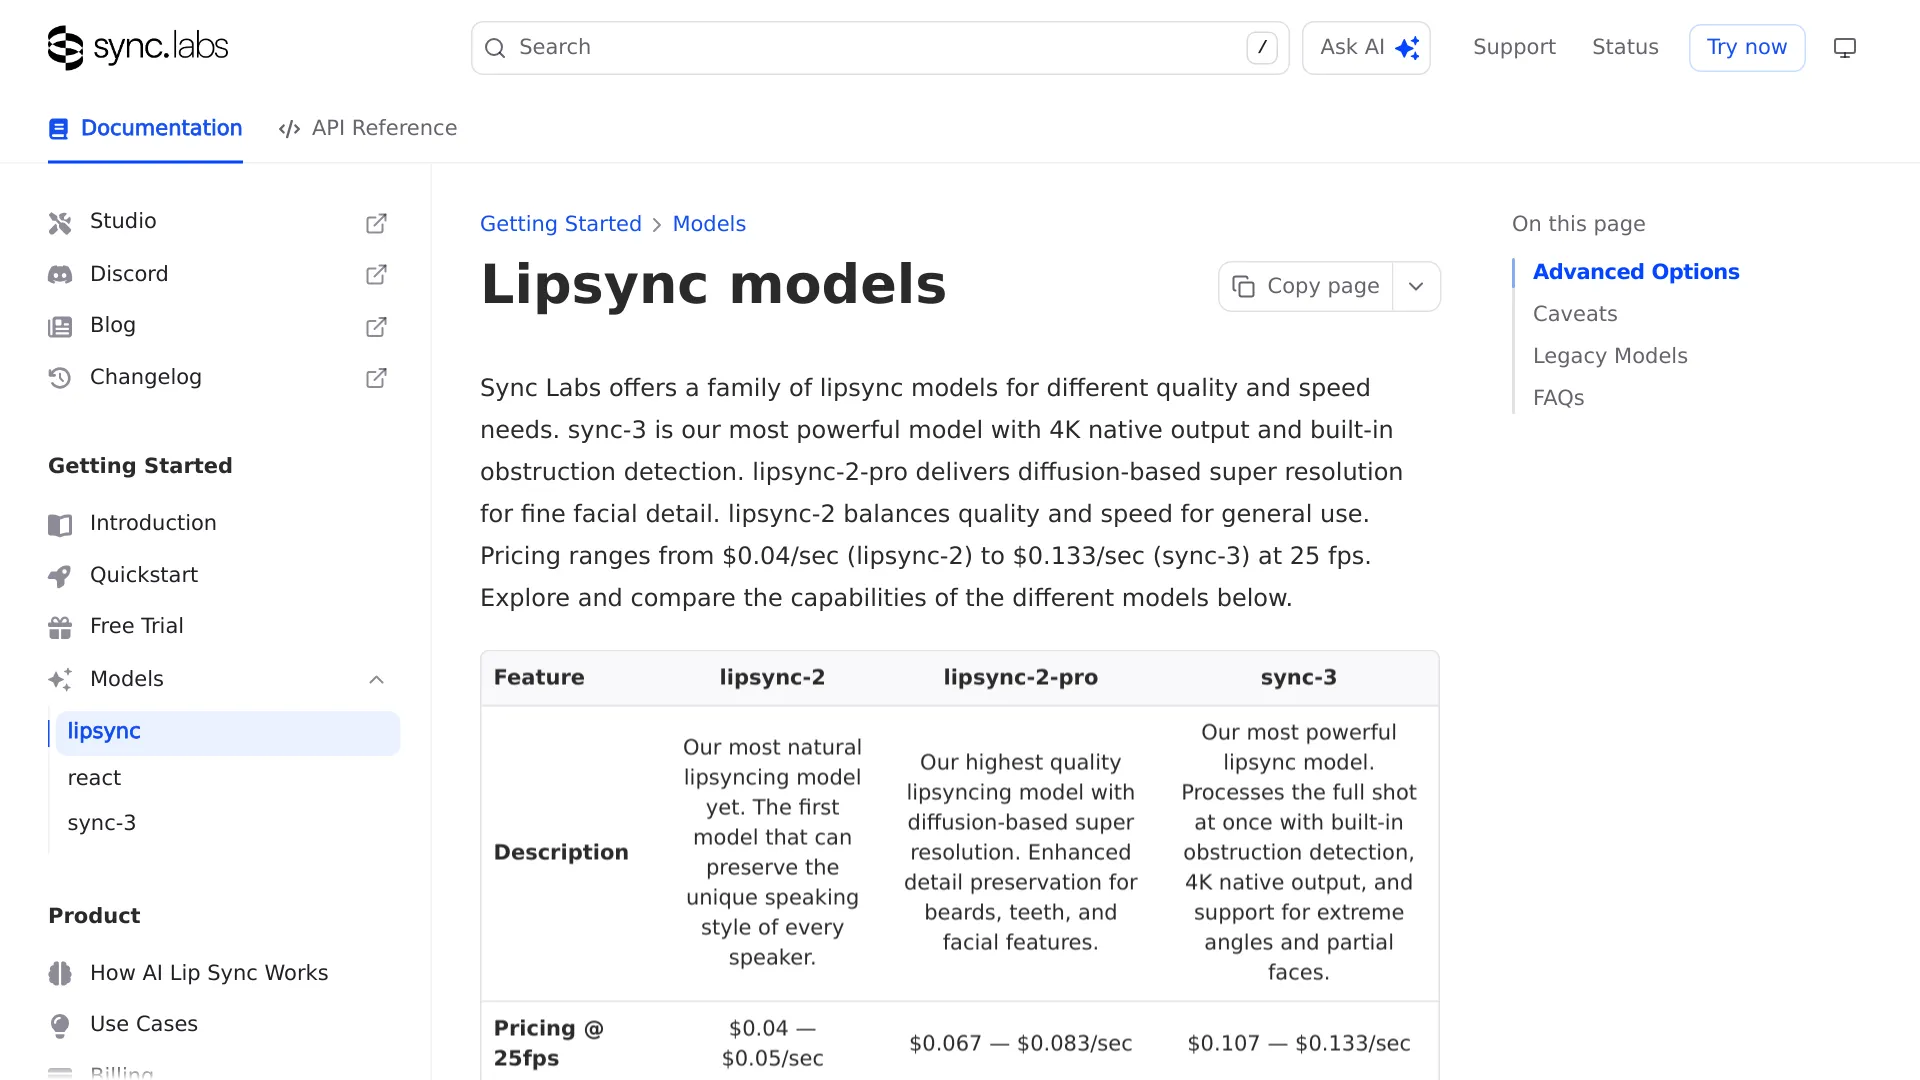
| sync lipsync-2 | 25fps 기준 초당 $0.04–0.05 | $2.40–$3.00 | 512x512 |
| sync lipsync-2-pro | 초당 $0.067–0.083 | $4.02–$4.98 | 512x512 + 디테일 패스 |
| sync-3 | 초당 $0.107–0.133 | $6.42–$7.98 | 네이티브 4K |
셀프 호스팅 비용은 NexGPU의 비용 분석에서 가져왔습니다. 이 계산은 1분짜리 영상 하나에 추론, DWPose 검출, VAE 인코딩·디코딩, FFmpeg 먹싱을 포함해 GPU를 총 2분 사용하는 경우를 기준으로 합니다. 1분짜리 영상 100개를 V100에서 시간당 $0.188로 처리하면 컴퓨팅 비용은 약 $0.63이고, 여기에 설정 시간 비용 약 $0.09가 추가됩니다. 이는 GPU 대여 비용만 계산한 수치이며 엔지니어링 시간, 저장 공간, 운영 오버헤드는 포함하지 않습니다.
현지화 작업처럼 물량이 커지면 차이는 빠르게 벌어집니다. 더빙 영상 500분을 처리할 때 셀프 호스팅 MuseTalk는 V100 GPU 대여료가 대략 $3인 반면, Creator 요금 기준 sync lipsync-2는 $1,200입니다.
무료 방식이 더 이상 무료가 아닌 순간
분당 요금을 지불하면 구체적으로 다음을 얻을 수 있습니다.
- 얼굴 생성 해상도. sync 모델 문서에 따르면 lipsync-2와 lipsync-2-pro는 MuseTalk의 얼굴 영역보다 두 배 큰 512x512 해상도로 얼굴을 생성합니다. sync-3는 슈퍼 해상도 기능을 내장하고 네이티브 4K로 출력합니다.
- 까다로운 촬영 구도. 같은 문서에 따르면 sync-3는 옆얼굴, 어깨 너머 구도, 얼굴 일부만 보이는 장면을 기본 지원하고 가림 요소도 자동으로 감지합니다. 반면 MuseTalk는 프레임마다 얼굴을 검출하기 때문에 얼굴이 돌아가 있거나 손이 입을 가리는 장면이 문서상 실패 지점이 됩니다.
- 여러 사람이 등장하는 영상. sync의 현재 세 모델은 모두 활성 화자 검출 옵션을 제공합니다. MuseTalk에는 이에 해당하는 플래그가 없습니다.
- 설정 시간. 셀프 호스팅에서는 이 비용을 한 번 부담하지만, 결코 작지 않습니다.
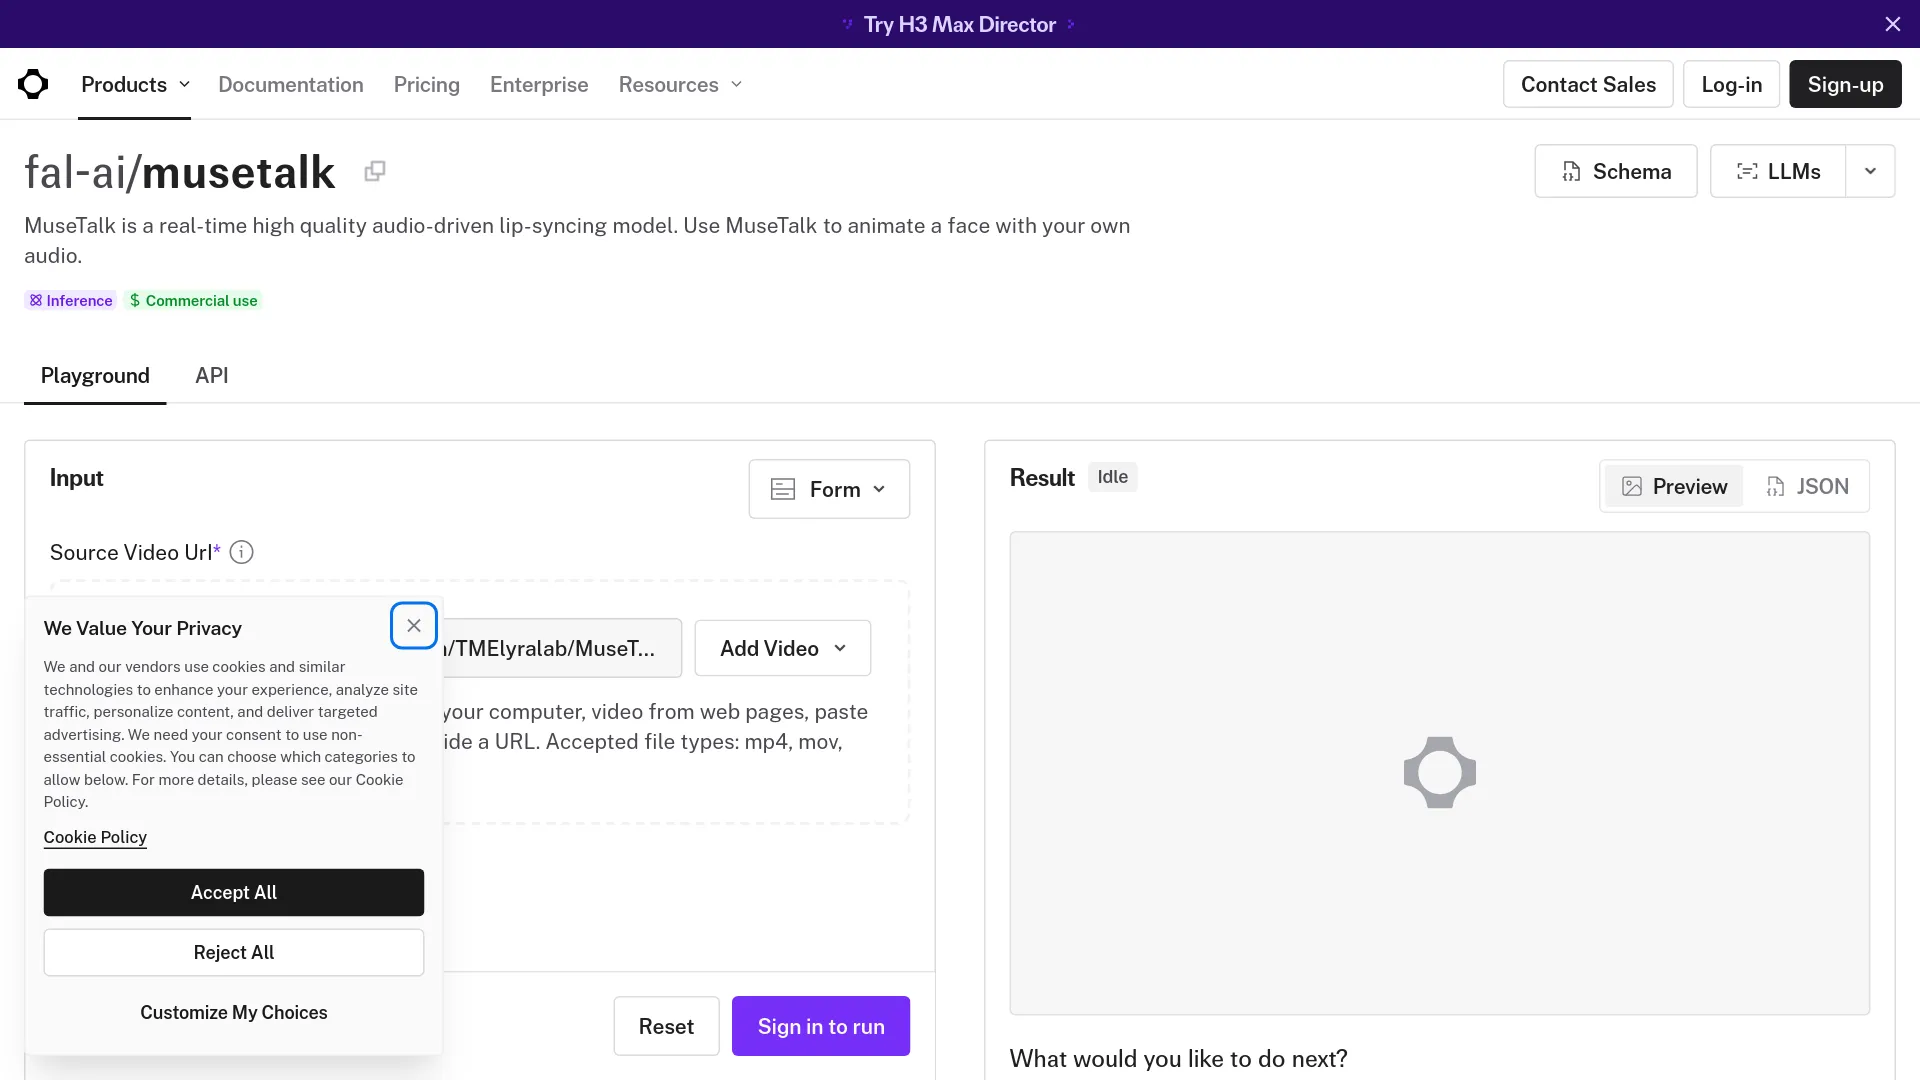
마지막 항목에 비용을 지불하면 무엇을 얻는지는 fal.ai MuseTalk 페이지에서 잘 드러납니다. 소스 영상 URL과 오디오 URL만 입력하면 됩니다. conda 환경도, CUDA 버전 고정도, 가중치 디렉터리 구성도 필요하지 않습니다.
의존성 문제에 발목 잡히지 않고 MuseTalk 실행하기
이 모델을 직접 실행해본 사용자들이 반복해서 지적하는 문제는 출력 품질이 아닙니다. OpenMMLab 스택입니다. r/StableDiffusion에서 MuseTalk와 LatentSync를 비교한 한 사용자는 두 모델을 모두 테스트한 뒤 이렇게 정리했습니다.
"LatentSync and Musetalk work and have similar performance... Musetalk is a hassle to set up since it depends on OpenMMLab libraries." — u/Traditional_Tap1708, r/StableDiffusion
README에 고정된 버전은 일반 pip가 아니라 mim으로 설치해야 합니다.
- 새 conda 환경에서 Python 3.10을 사용하고, PyTorch 2.0.1, torchvision 0.15.2, torchaudio 2.0.2를 설치합니다.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0"을 실행합니다. 최신 mmcv는 mmdet import 오류를 일으키는 가장 흔한 원인입니다.PATH에서 FFmpeg를 사용할 수 있는지ffmpeg -version으로 확인합니다. Windows에서는--ffmpeg_path를 사용해 경로를 직접 지정할 수 있습니다.- 전체 가중치 트리는
sh download_weights.sh로 내려받습니다. UNet만으로는 충분하지 않습니다. 이 스크립트는 sd-vae-ft-mse, Whisper, DWPose의dw-ll_ucoco_384.pth, BiSeNet 얼굴 파싱 가중치까지 함께 받습니다. 파일 하나가 빠지면 명확한 오류 대신 얼굴 검출 또는 블렌딩 실패로 나타나는 경우가 많습니다. ffmpeg -i input.mp4 -r 25 output.mp4으로 소스를 25fps로 변환합니다. 저장소는 모델이 25fps 입력으로 학습되었기 때문에 25fps를 권장하며, 프레임레이트가 맞지 않으면 타이밍이 어긋나는 경우가 많습니다.configs/inference/test.yaml에서 영상과 오디오 경로를 지정한 뒤python -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15를 실행합니다.
같은 얼굴로 반복 생성하려면 configs/inference/realtime.yaml에서 preparation: true를 한 번 설정합니다. results/v15/avatars/ 아래에 coords.pkl, latents.pt, 마스크 세트가 캐시되면 다시 false로 돌립니다. --skip_save_images 옵션도 생각보다 중요합니다. PNG를 디스크에 저장하는 작업이 모델 자체보다 큰 병목이 될 수 있기 때문입니다.
MuseTalk 1.5와 1.0 중 어떤 가중치를 받을까
1.5를 사용하면 됩니다. 저장소는 2025년 3월 28일 공개된 1.5를 최신 릴리스로 표시하고 있으며, 지각 손실·GAN 손실·싱크 손실과 2단계 학습을 통해 선명도, 인물 동일성, 입 모양과 음성의 정렬이 개선됐다고 설명합니다.
1.0을 남겨둘 이유는 bbox_shift 하나입니다. 이 옵션은 해당 버전에서만 사용할 수 있으며 마스크 경계를 위아래로 이동합니다. 양수는 입을 더 크게 벌리고, 음수는 입을 다물게 합니다.
먼저 기본값으로 한 번 실행하면 스크립트가 영상에 적용할 수 있는 조정 범위를 출력합니다. README의 예시에서는 [-9, 9] 범위가 나왔고 -7을 선택했습니다. 결과가 과하게 벌어져 보이면 음수 방향으로, 거의 벌어지지 않으면 양수 방향으로 범위 안에서 다시 렌더링하면 됩니다.
직접 겪게 될 오류와 튜닝으로 해결할 수 있는 문제
| 증상 | 원인 | 해결 가능 여부 |
|---|---|---|
| 실행 중단, 얼굴 검출 실패 | 얼굴이 돌아갔거나 가려졌거나 사라지는 프레임이 하나라도 있음 | 가능. 문제가 되는 구간을 자르거나 제거 |
| 입이 거의 움직이지 않음 | 음악에 음성이 묻혔거나 마스크 경계가 너무 높음 | 가능. 보컬을 분리하고 v1.0에서 bbox_shift를 양수로 조정 |
| 중간부터 립싱크가 어긋남 | 소스가 25fps가 아님 | 가능. 처리 전에 변환 |
| 선명한 얼굴에 비해 입 주변이 흐림 | 256x256 영역에 비해 화면 속 얼굴이 너무 작음 | 부분적으로 가능. 더 타이트하게 크롭하고 fp16을 끄거나 얼굴 복원을 추가 |
| 경계선이 보이고 콧수염이 보존되지 않음 | 얼굴 하단 생성 과정에서 인물의 세부 정체성이 대체됨 | 불가. 모델의 한계로 명시됨 |
| 프레임 간 떨림 | 프레임을 개별적으로 생성함 | 부분적으로 가능. 저장소는 v1.5의 2단계 학습이 일관성을 개선했다고 설명 |
| 카툰 또는 스타일라이즈된 얼굴에서 실패 | 학습 데이터가 실제 얼굴 중심임 | 불가 |
| 정적인 화자 위에 역동적인 오디오를 적용 | MuseTalk는 머리 움직임이나 표정을 수정하지 않음 | 불가. 소스 영상을 다시 촬영하거나 교체해야 함 |
낮은 VRAM 환경에서 테스트한 한 사용자는 MuseTalk가 “171s for 7 seconds of audio”가 걸렸고 “only works with realistic images”라고 덧붙였습니다(u/Bartholomheow, r/StableDiffusion). 한편 ‘실시간’이라는 표현은 엔드투엔드 지연 시간이 아니라 아바타 준비가 끝난 뒤의 지속 처리량을 가리킵니다. r/LocalLLaMA에서 토킹헤드를 개발하던 한 개발자도 MuseTalk에 대해 “the preparation time is too long”이라며 인터랙티브 용도에는 맞지 않는다고 말했습니다(u/lonyPorgrammer).
용도에 맞는 립싱크 방식 고르기
| 방식 | 이럴 때 선택 | 주요 단점 |
|---|---|---|
| 셀프 호스팅 MuseTalk | 현지화 초안, 하나의 얼굴을 수천 개 오디오 클립에 재사용하는 인터랙티브 아바타, 사내 교육 영상처럼 물량이 많고 소스 영상이 안정적인 경우 | 설정에 몇 분이 아니라 몇 시간이 걸릴 수 있으며 처리량은 대여한 GPU 성능에 좌우됨 |
| 호스팅 MuseTalk (Replicate, fal.ai) | 클립 몇 개만 처리하거나 배포 전에 자신의 영상으로 품질을 확인할 때 | 동일한 256x256 한계, 두 엔드포인트 스키마 모두 아바타 캐시 플래그가 없고 실행 단위로 청구 |
| 유료 립싱크 모델 (sync-3, lipsync-2-pro) | 고객에게 보여줄 결과물, 큰 클로즈업, 옆얼굴, 가림 요소, 여러 화자, 4K 납품 | 분당 $4–$8이며 영상이 자체 인프라 밖으로 나감 |
공식 처리량을 재현하려면 V100을 대여하고, 실시간 스트리밍이라면 4090을 고려하면 됩니다. 호스팅 엔드포인트 방식은 Replicate 리뷰와 fal.ai 리뷰에서 더 자세히 다뤘습니다.
MuseTalk 립싱크 FAQ
6GB 또는 8GB GPU에서 MuseTalk를 실행할 수 있나요?
가능합니다. README에는 4GB RTX 3050 Ti 노트북 GPU에서 FP16으로 테스트한 기록이 있으므로, 기본 추론은 제한된 VRAM에서도 실행됩니다. 실질적으로 더 큰 제약은 처리 속도입니다.
256x256이 최종 출력 해상도인가요?
아닙니다. 편집되는 얼굴 영역의 크기입니다. 최종 영상은 소스의 해상도와 프레임레이트를 유지하며, 해당 영역만 다시 생성해 합성합니다.
카툰이나 애니메이션 얼굴에도 MuseTalk를 사용할 수 있나요?
안정적으로 작동한다고 보기 어렵습니다. 모델은 실제 토킹헤드 영상으로 학습됐으며, 스타일라이즈된 입력을 테스트한 사용자들도 결과가 일관되지 않다고 보고합니다.
‘30fps 실시간’ 수치에 전처리 시간이 포함되나요?
아닙니다. 아바타 준비가 끝난 뒤 Tesla V100에서 생성되는 처리량을 의미합니다. 얼굴 검출, 잠재 표현 인코딩, 최초 캐싱 과정은 그 전에 진행됩니다.
MuseTalk와 LatentSync 중 무엇을 선택해야 하나요?
프로젝트에서 지연 시간과 처리량이 중요하다면 MuseTalk를 선택할 만합니다. 한 번에 추론하고 아바타를 캐시할 수 있어 클립마다 반복되는 비용을 줄일 수 있기 때문입니다. 두 모델을 모두 실행한 위 r/StableDiffusion 사용자는 성능이 비슷하다고 평가했으므로, 결국 결정 기준은 화질보다 처리량에 가깝습니다.
MuseTalk를 상업적으로 사용할 수 있나요?
저장소의 코드는 MIT 라이선스로 배포되지만 의존성 전체의 라이선스가 동일한 것은 아닙니다. Whisper, VAE, DWPose, BiSeNet 얼굴 파싱, SyncNet은 각각 별도의 조건으로 배포되며, 저장소는 샘플 데이터에도 별도 제한이 있다고 안내합니다. 실제 서비스에 적용하기 전에 각각의 조건을 확인해야 합니다.
이 가격대에서도 해결되지 않은 트레이드오프
MuseTalk는 사실상 거의 비용을 들이지 않고 필요한 작업의 대부분을 처리해줍니다. 다만 인물의 정체성이 강하게 드러나는 상황에서는 한계가 분명합니다. 콧수염, 정확한 입술 모양, 화면을 가득 채운 얼굴, 문장 중간에 고개를 돌리는 화자 같은 요소는 제대로 보존하기 어렵습니다.
대부분의 팀에 필요한 답은 하나의 도구가 아닙니다. 물량이 많은 작업에는 MuseTalk를 사용하고, 화면 전체에 크게 노출되는 장면에는 유료 모델을 쓰는 조합이 현실적입니다.
관련 글
- Higgsfield AI 리뷰 및 API 액세스 대비 요금
- MuseTalk가 사용하는 오디오 트랙을 생성하는 Kokoro 82M TTS 로컬 설정 가이드
- Wan 2.2 Animate 가이드