 AIREITER
Qwen3.8-Max가 정식 출시됐다. 가격은 입력 100만 토큰당 $2, 출력 100만 토큰당 $6이다. 출력 가격만 보면 Claude Opus 4.8, Claude Fable 5, GPT-5.6 Sol보다 최소 4배 저렴하다. 다만 기본 reasoning_effort 값이 xhigh로 설정돼 있어, 표시된 단가와 실제 청구 금액은 첫 요청부터 차이가 날 수 있다.
Qwen3.8-Max 토큰당 API 요금
Qwen3.8-Max는 총 2.4조 파라미터의 MoE 모델이며, 토큰당 활성화되는 파라미터는 950억 개다. Alibaba의 플래그십 모델도 Qwen3.7-Max에서 이 모델로 넘어갔다. 아래는 자체적으로 "Updated: Aug 2, 2026" 표기가 붙은 Alibaba 모델 페이지의 공개 요금이다.
| 항목 | 100만 토큰당 가격 |
|---|---|
| 입력 | $2.00 |
| 출력 | $6.00 |
| 입력(암시적 캐시) | $0.25 |
| 명시적 캐시 생성 | $2.50 |
| 명시적 캐시 읽기 | $0.17 |
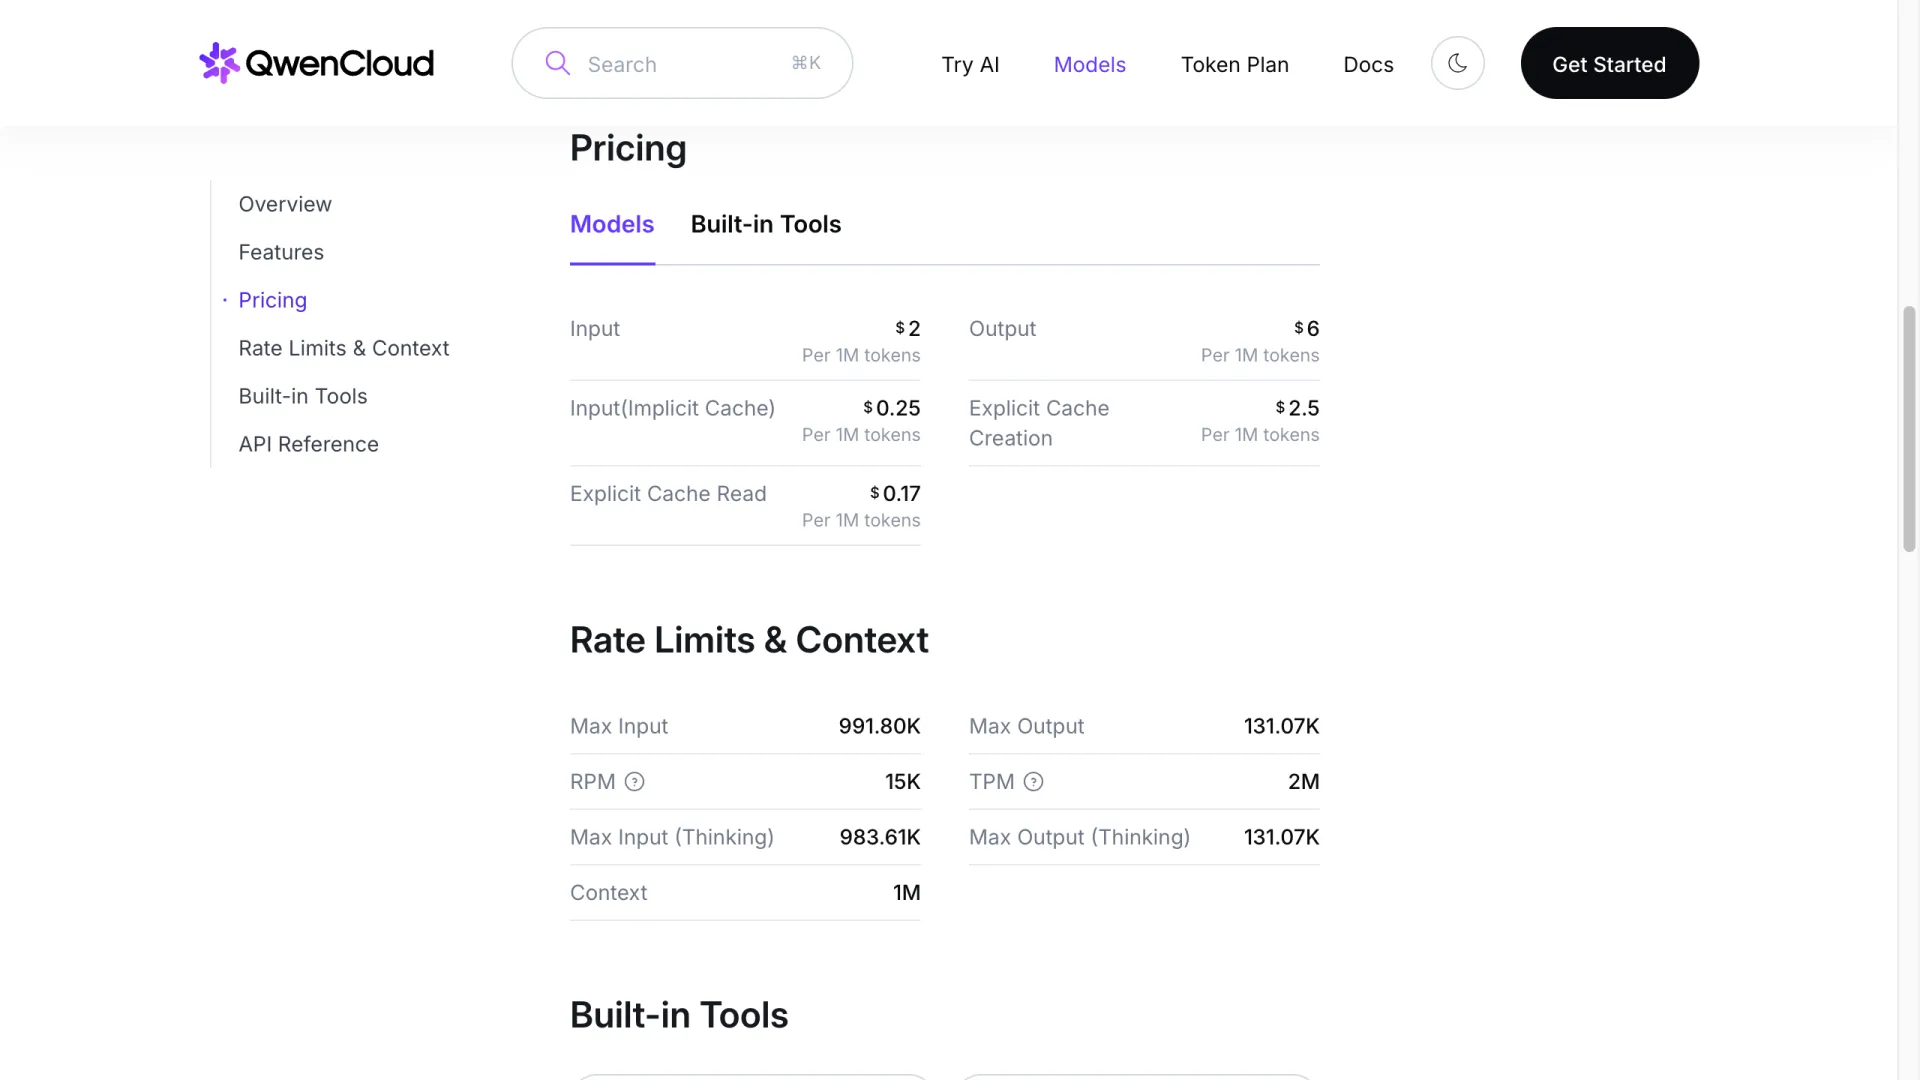
암시적 캐시는 별도 코드 작업이 필요 없다. 반복되는 프리픽스에는 자동으로 $0.25가 적용되며, 일반 입력 요금의 8분의 1이다. 선택이 필요한 쪽은 명시적 캐시다. 생성은 $2.50, 읽기는 $0.17이므로 같은 프리픽스를 두 번째 읽는 시점부터 비캐시 입력보다 유리하다. 하지만 $0.25의 암시적 캐시보다 저렴해지려면 같은 프리픽스를 대략 30회 읽어야 한다. 대부분의 애플리케이션에서는 명시적 캐시를 굳이 건드리지 않는 편이 낫다.
여기에는 한 가지 제한이 있다. API는 열려 있지만 가중치는 아직 공개되지 않았다. Alibaba 출시 글에 따르면 Qwen3.8-Max 가중치는 다음 주 Hugging Face와 ModelScope에 배포된다. 수주간 이어진 날짜 없는 "coming soon" 안내 이후 처음으로 제시된 일정이다. 8월 3일 기준 모델 페이지 사이드바에도 Open Source: No라고 표시돼 있다.
$6 출력 단가만 보고 예산을 잡으면 안 되는 이유
Alibaba의 출시 문서는 reasoning_effort에 세 가지 설정을 제공하며, 그중 가장 깊은 추론 단계인 xhigh를 기본값으로 지정한다. medium은 "정확도와 속도의 균형", low는 "속도와 비용 최적화"를 목표로 한다. 모든 시나리오에서 preserve_thinking도 기본 활성화 상태다. 사고 토큰은 출력 토큰으로 과금되므로, 프롬프트를 쓰기도 전에 두 기본 설정이 지출을 $6 요금 구간으로 밀어 넣는다.
즉, 실질 비용을 좌우하는 두 설정이 처음부터 비용이 커지는 방향으로 잡혀 있다. 둘 다 요청 파라미터 하나로 바꿀 수 있다. 모든 작업에 깊은 숙고가 필요한 것은 아니다. 그런 경우 medium이나 low로 낮추면, 필요하지 않은 깊은 추론에 100만 토큰당 $6를 지불하는 대신 그 비용을 정말 필요한 작업에만 쓰게 된다.
초기 테스트 참여자 한 명은 r/LocalLLaMA 스레드 제목에서 이렇게 직설적으로 평가했다.
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
이를 벤치마크 결과로 받아들일 일은 아니다. 다만 기본값을 표준으로 정하기 전, 자신의 워크로드에서 각 추론 수준을 테스트해야 한다는 근거로는 충분하다.
1M 컨텍스트에도 할증 없는 구조
Qwen3.8-Max 모델 페이지에는 입력과 출력에 각각 하나의 요금만 있으며, 컨텍스트 길이별 구간은 따로 없다. 반면 Gemini 3.1 Pro와 GPT-5.6 Sol은 일정 컨텍스트 길이를 넘으면 더 비싼 요금대로 전환된다.
| 모델 | 입력(짧은 컨텍스트) | 출력(짧은 컨텍스트) | 입력(긴 컨텍스트) | 출력(긴 컨텍스트) |
|---|---|---|---|---|
| Qwen3.8-Max | $2.00 | $6.00 | $2.00(최대 1M) | $6.00(최대 1M) |
| Gemini 3.1 Pro | $2.00(≤200K) | $12.00 | $4.00(>200K) | $18.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $10.00 | $45.00 |
Gemini 3.1 Pro는 200K 토큰까지 Qwen3.8-Max와 입력 가격이 정확히 같지만, 그 구간을 넘으면 두 배가 된다. GPT-5.6 Sol은 이미 개편된 가격표 기준으로도 비싼 편인데, 장문 컨텍스트 구간에서는 입력 가격이 두 배가 되고 출력 가격도 50% 더 오른다.
따라서 컨텍스트가 길어질수록 가격 차이는 유지되는 것이 아니라 더 벌어진다. 400K 토큰 프롬프트의 입력 비용은 Qwen3.8-Max에서 $0.80, Gemini 3.1 Pro에서 $1.60, GPT-5.6 Sol에서 $4.00이다. 문서 파이프라인, 장시간 에이전트 세션, 리포지터리 전체를 대상으로 하는 작업에서 이 차이는 누적된다. 짧은 채팅 턴에서는 거의 체감되지 않는다.
Alibaba가 비교 대상으로 내세운 모델들과의 비용 차이
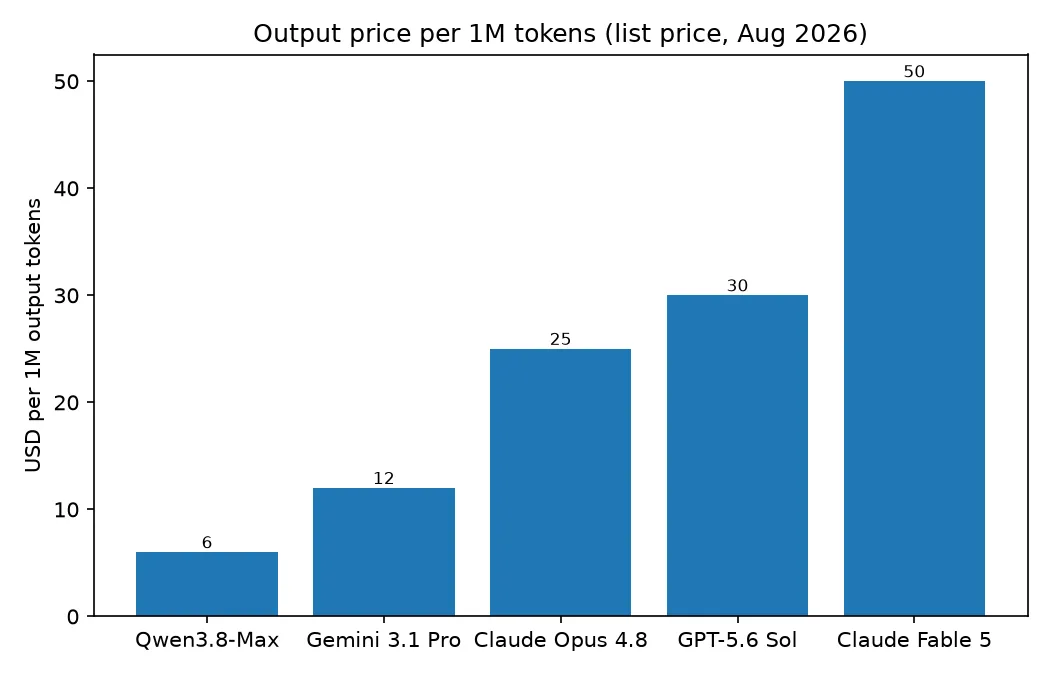
출력 100만 토큰당 $6는 Claude Opus 4.8의 $25의 4분의 1에도 못 미치며, GPT-5.6 Sol의 $30와 비교하면 5분의 1이다. $50인 Claude Fable 5는 8배를 넘는다. 물론 이 가격 차이가 감수할 만한지 여부는 성능에 달려 있다. Alibaba는 그렇다고 주장하기 위해 28개 행의 벤치마크 표를 공개했다.
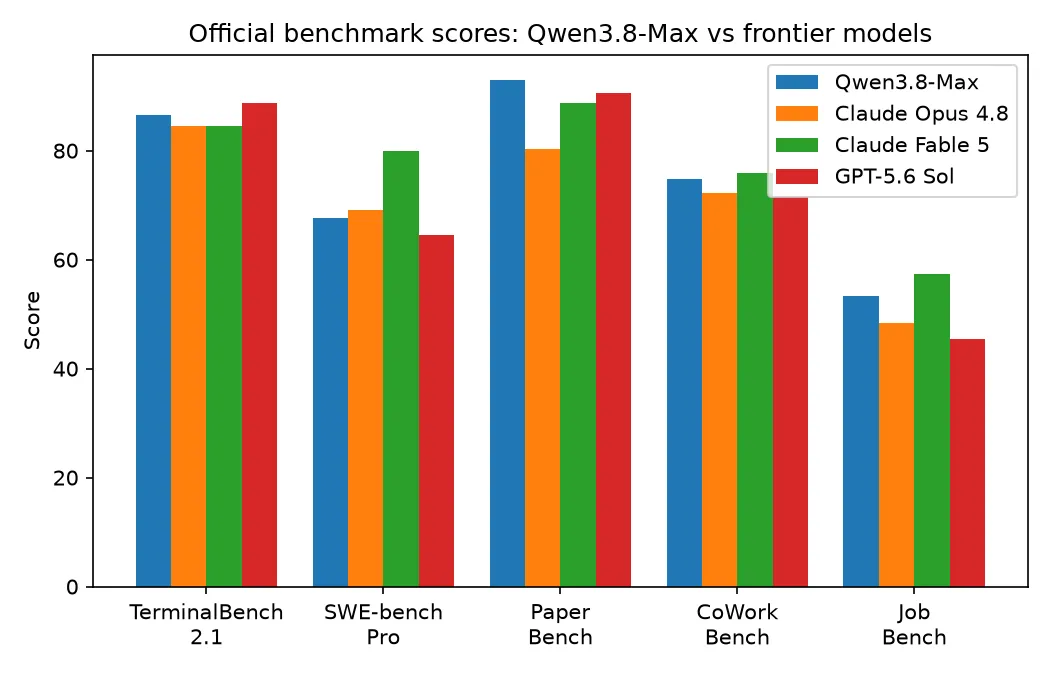
PaperBench에서는 93.0으로 GPT-5.6 Sol의 90.5, Fable 5의 88.8을 앞섰다. JobBench도 53.4로 Opus 4.8의 48.4보다 높다. Terminal Bench 2.1에서는 86.6으로 두 Claude 모델을 근소하게 앞선다. 반면 SWE-bench Pro에서는 크게 밀린다. Fable 5의 80.0은 Qwen3.8-Max의 67.7보다 12점 이상 높다. 이 수치는 모두 같은 페이지에서 벤더가 직접 실행하고 공개한 결과다.
선택 기준은 비교적 명확하다. 긴 툴 호출 루프, 문서 생성, PaperBench가 측정하는 연구 재현 형태처럼 출력 비중이 큰 에이전트 작업에서는 출력 비용이 4~8배 낮다는 점이 서비스 자체의 단위 경제성을 바꾼다. 반면 SWE-bench Pro가 살피는 리포지터리 규모 소프트웨어 엔지니어링에서는 할인만큼 실제 성능도 떨어진다. 이 경우에는 Fable 5 수준의 요금을 지불하는 선택이 여전히 타당하다.
자체 워크로드에서 이를 검증하는 일은 어렵지 않다. Alibaba의 출시 글에는 OpenAI 호환 chat-completions 및 responses 호출, 그리고 Anthropic 호환 인터페이스가 문서화돼 있다. 이는 Claude Opus 4.8과 GPT-5.6 Sol이 받는 두 가지 요청 형식과 같다.
지금 코드에서 바꿀 부분
모델 ID는 qwen3.8-max다. 8월 3일 기준 Alibaba 모델 카탈로그에서 유일한 3.8 항목이며, 프리뷰 식별자인 qwen3.8-max-preview는 사라졌다. 정식 출시 후에도 프리뷰 할인 가격이 남아 있을 것이라 가정하기 전에, 사용 중인 릴레이 제공업체를 확인해야 한다.
두 인터페이스 모두 베이징, 싱가포르, 미국 버지니아의 세 지역 기본 URL에서 제공된다. 먼저 부딪히게 될 한도는 다음과 같다.
| 제한 | 값 |
|---|---|
| 컨텍스트 윈도우 | 1M |
| 최대 입력 | 991.80K |
| 최대 입력(사고 모드) | 983.61K |
| 최대 출력 | 131.07K |
| 분당 요청 수 | 15K |
| 분당 토큰 수 | 2M |
두 입력 한도 사이에는 약 8K 토큰 차이가 있다. 사고 모드를 켜면 출력 토큰 비용뿐 아니라 입력 여유 공간도 줄어든다는 뜻이다. 그리고 다음 주 가중치가 실제로 공개된다면, 950억 활성 파라미터라는 수치가 $2/$6 API 요금과 셀프 호스팅을 비교하는 출발점이 될 것이다.
FAQ
Qwen API는 무료인가요?
아니다. Qwen3.8-Max는 100만 토큰당 입력 $2, 출력 $6으로 토큰 단위 과금된다. Alibaba API 플랫폼에서 판매하는 Token Plan 구독은 토큰당 API 과금과는 별개의 크레딧 기반 상품이다.
Qwen Max 가격은 얼마인가요?
현 세대 기준으로 입력 100만 토큰당 $2, 출력 100만 토큰당 $6이며, 암시적 프리픽스 캐시는 $0.25다. Alibaba Cloud 문서에 있는 이전 qwen-max 항목은 과거 세대를 가리키며 요금도 다르다.
Qwen3.8-Max는 1M 컨텍스트 윈도우에 추가 요금을 부과하나요?
아니다. 입력과 출력 가격은 5K 토큰일 때나 900K 토큰일 때나 같다. 이는 GPT-5.6 Sol 및 Gemini 3.1 Pro와 비교할 때 가장 분명한 구조적 차이다.
Qwen3.8-Max는 Qwen3.7-Max보다 저렴한가요?
공식 페이지 기준으로는 답할 수 없다. Qwen3.7-Max 모델 페이지는 토큰당 가격을 표시하는 대신 50% 할인 표기 뒤에 --만 렌더링한다. 따라서 비교할 수 있는 공개 가격이 없다.
함께 읽기
- Claude Fable 5 가격: 이 글에서 비교한 $10/$50 요금제
- Claude Fable 5 토큰 비용 줄이기: 다른 벤더에서 쓰는 동일한 추론 수준·캐시 절감 전략