오답률을 낮춰야 하는 장문 컨텍스트 에이전트라면 high 설정의 Neon이 여기서 가장 균형 잡힌 선택입니다. 다만 작업당 비용만 보면 Astra와 Sol이 더 저렴합니다. 이 글은 출시 당일 공개된 공식 사양과 순위표, 독립 테스트를 종합한 결과이며, Neon을 직접 실행해 본 리뷰는 아닙니다.
에이전트용으로 더 빠르고 저렴해진 Carbon, 대신 분명한 타협점이 있다
Gemini 4 Neon은 2026년 11월 18일 gemini-4-neon이라는 이름으로 출시됐습니다. Google과 9to5Google에 따르면 Gemini 4 제품군에서 Hydrogen과 Carbon 사이에 위치한 중간급 모델입니다. Google은 Carbon보다 엔드투엔드 작업 완료 속도가 빠르고 작업당 비용은 낮다고 설명했으며, DeepMind 관계자도 Carbon보다 저렴하고 빠르다고 밝혔습니다(@_mohansolo). Artificial Analysis Index에서는 xhigh 기준 61점으로 3위, Agent Arena에서는 4,200회 이상의 세션을 바탕으로 1336점, 2위를 기록했습니다. 이번에 확인한 출시 자료에는 Opus 5.5와 Fable 5.2의 동일 보드 Arena 점수가 공개되지 않았기 때문에, 아래 비교는 지수 순위와 동일 작업 테스트를 함께 사용했습니다.
가격과 컨텍스트 한도, 사용할 수 있는 곳
Neon의 가격은 입력 100만 토큰당 $3, 출력 100만 토큰당 $15, 캐시 입력은 $0.15입니다(Google). 컨텍스트 윈도우는 1,048,576토큰이며, 한 번의 응답은 최대 65,536토큰까지 생성할 수 있습니다. 사고 수준은 low / medium / high(기본값) / xhigh로 나뉩니다. 수준을 높이면 더 많은 추론 토큰을 사용할 수 있어 요금도 올라갑니다. 기본값이 high라는 내용은 DataCamp의 단계별 설명과 SpringPrompt의 API 안내에 정리돼 있습니다.
eesel의 API 확인 결과, Neon은 무료 티어 없이 유료로만 제공됩니다. Google과 9to5Google이 소개한 사용처는 AI Studio의 유료 API, Gemini for business, Antigravity(Pro/Ultra), Gemini 앱(Pro/Ultra, Argon 대체), Android Studio입니다. 여기에 Cursor도 포함됩니다. Cursor의 기본 노력 수준에서 Neon은 CursorBench 63.7%를 기록해 Hydrogen의 57.3%보다 높았습니다(Cursor).
| 모델 | 입력 / 출력 100만 토큰당 | 기본 사고 수준 |
|---|---|---|
| Gemini 4 Neon | $3 / $15, 캐시 입력 $0.15 | high |
| Gemini 4 Hydrogen | $1.50 / $7.50 | high |
| Gemini 4 Carbon | 11월 30일까지 $2 / $10, 이후 $4 / $20 | medium |
| Claude Opus 5.5 | $4 / $20, 테스트는 max 설정 | 테스트는 max |
| GPT-6.2 Sol | $2 / $10, 테스트는 max 설정 | 테스트는 max |
경쟁 모델의 가격과 최적 설정 표기는 eesel의 비교표를 기준으로 정리했습니다. 12월 1일부터 Neon은 Carbon보다 토큰당 25% 저렴해집니다. 자세한 내용은 Neon 가격 분석에서 확인할 수 있습니다.
사고 수준을 직접 고정하려면 API를 사용하고, 할당량 관리를 맡기려면 앱이나 Antigravity를 이용하면 됩니다. 다만 할당량 관련 수치는 어디까지나 경험적 계획 자료입니다. 사용자 보고에 따르면 채팅 한 번은 Pro 할당량의 약 1–3%, 3개 서브에이전트를 10분간 실행하는 작업은 약 5%를 소모합니다.
Opus 5.5, Fable 5.2, Sol과 벤치마크 비교
점수는 Google이 보고한 수치를 eesel과 DataCamp가 취합한 자료입니다.
| 테스트 | Neon | 경쟁 모델 | 해석 |
|---|---|---|---|
| Vals Index | 70.9%, 2위 | Fable 약 71.3% | 최상위권 |
| AutomationBench | 56.3%, 1위 | Opus 42.5%, Sol 41.3% | 에이전트 작업에서 앞섬 |
| GraphWalks 256K–1M | 95.2% | Opus 66.8%, Sol 80.1% | 장문 컨텍스트 우세. 일부 Argon 사용자가 과도한 요약을 보고했으므로 가장 긴 파일부터 다시 실행해 보는 편이 좋습니다(관련 스레드) |
| Terminal-Bench 4.1 | 65.2% | Opus 65.8% | 거의 동률, Opus가 +0.6 |
| FrontierCode 2.0 | 46.2% | Opus 47.3% | Opus가 +1.1 |
| CursorBench 4.1 | 63.7–65.4% | Opus 58.1% | 기본 노력 수준에서 Neon 우세 |
토큰 단가만으로는 알 수 없는 작업당 비용을 보면 결과가 달라집니다(eesel이 정리한 Artificial Analysis 자료):
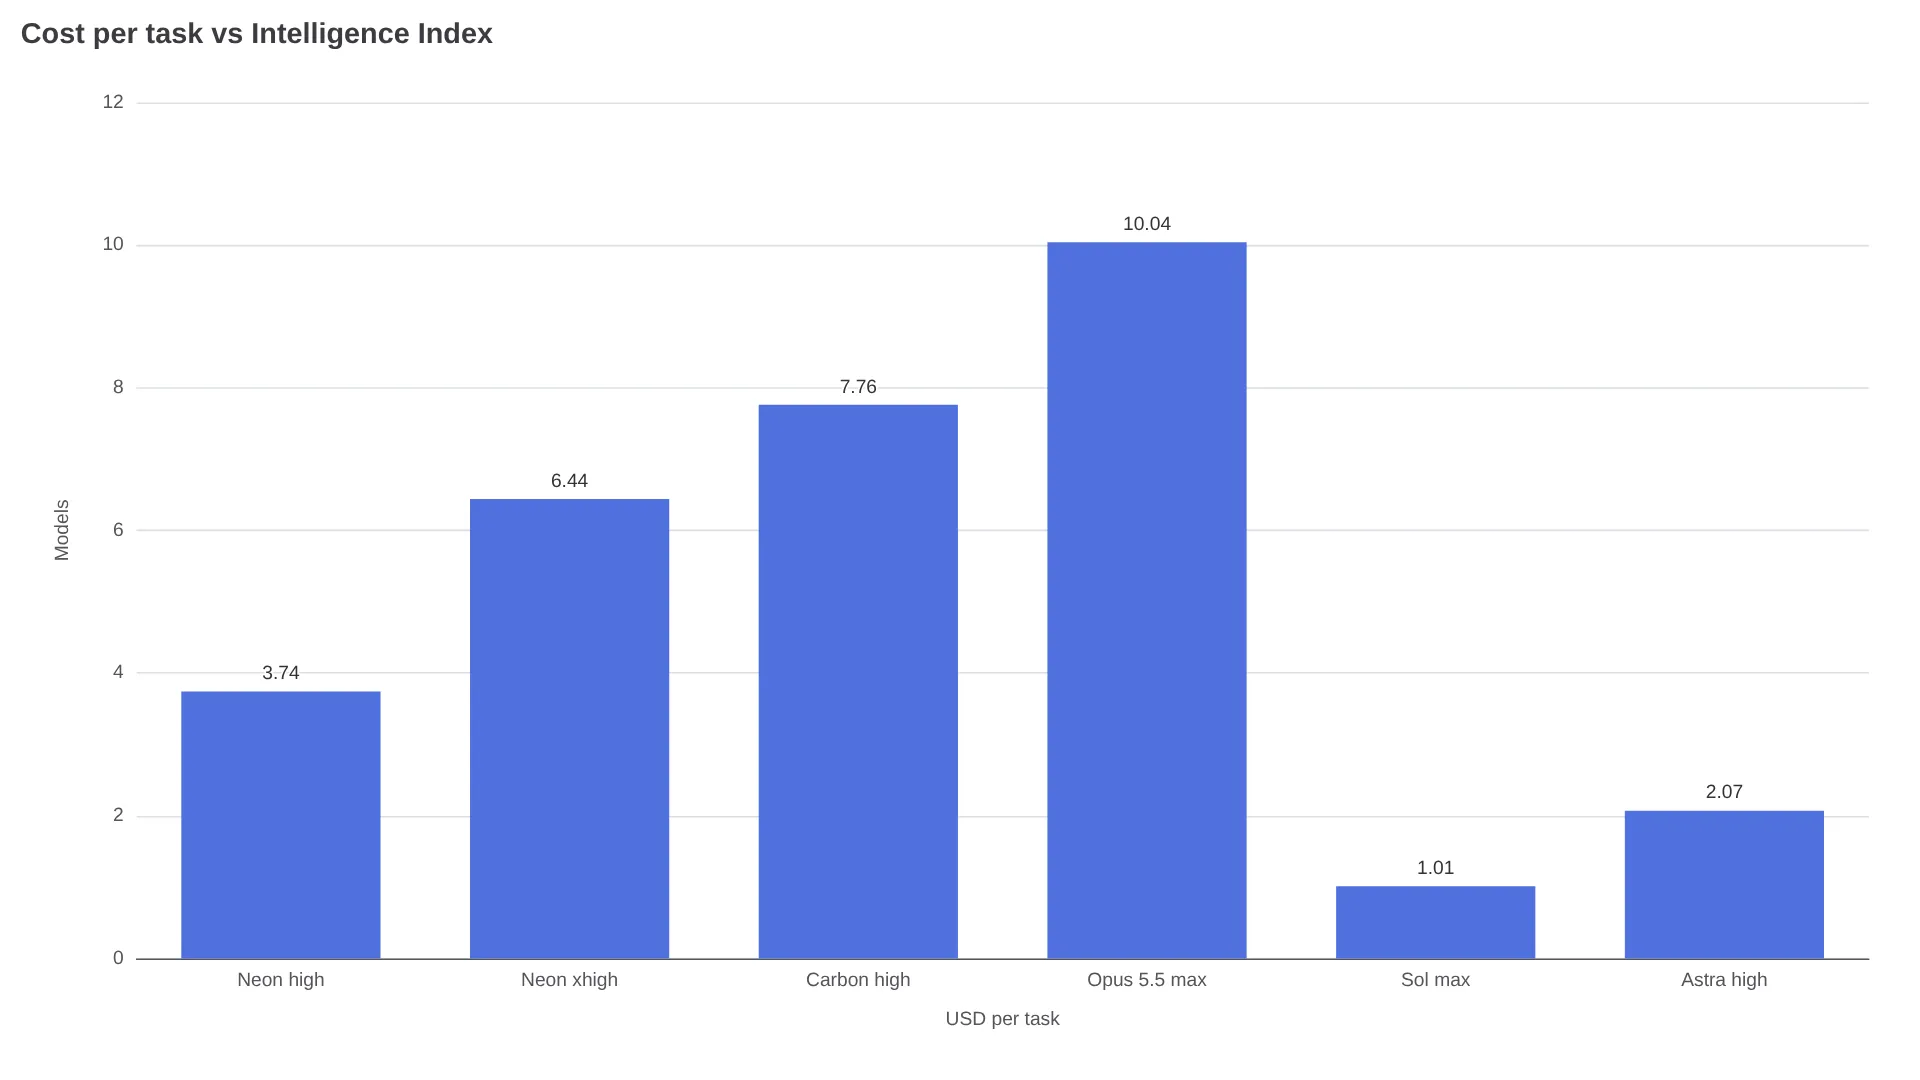
Neon high는 14.8분 동안 $3.74를 사용해 59.6점을 기록했습니다. Carbon high는 37.2분에 $7.76을 써서 60.0점, Opus max는 $10.04에 59.1점이었습니다. Astra high는 $2.07에 60.1점, Sol max는 $1.01에 57.3점입니다. Neon xhigh는 21.5분 동안 $6.44를 사용해 61.4점까지 올라갑니다. 1.8점 향상을 위해 $2.70과 6.7분을 더 쓸 가치가 없다면 high를 선택하면 됩니다.
Neon과 Fable 5.2: 초기 결과는 역할을 나누라고 말한다
Provider-harness SWE-sweep(Antigravity 하네스)에서는 Neon이 39.0%로 Opus 10.1%, Sol 8.3%를 앞섰습니다. 반면 공유 mini-SWE 하네스에서는 Neon 12.8%, Sol 11.6%, Opus 3.6%였습니다(DataCamp). 눈에 띄는 격차의 상당 부분은 순수한 모델 성능보다 하네스의 영향으로 보입니다.
"Fable 5.2를 오케스트레이터와 개발자로, Neon을 코딩 에이전트로 사용하고 있는데 지금까지 써 본 스택 중 최고입니다." — u/1969Stingray (관련 스레드)
사용자들의 경험담을 종합하면 오케스트레이션은 Fable, 구현은 Neon을 선호하는 경우가 많습니다. 다만 실제 저장소에서 직접 검증해야 합니다. AA-Omniscience에서 Neon은 틀린 답을 내놓는 대신 거절한 비율이 14%로, Opus 50%, Sol 55%, Astra와 Fable 58%보다 낮았습니다. 그러나 정답률은 Neon이 59–60%로 Astra 66%, Fable 77%보다 낮았습니다(eesel).
실사용 테스트: 체스, 상품 목록, 실제 버그 105개
| 테스트 | 결과 | 한계 |
|---|---|---|
체스 페이지, medium 3회 실행(DataCamp) | Neon 3/3, $0.83–$1.06. Carbon 1/3, 두 번은 65K 한도에 도달. 16게임에서 불법 수는 0회 | 단일 작업. Carbon도 백그라운드 모드라면 완료할 가능성이 있음 |
| CatalogBench 사실성(SpringPrompt) | 게시 가능한 수준 78.6%, 3회 모두 1위, 35개 중 1위. 패키지에서 사양을 읽어냄 | 판매 문구 32.1%, 덱은 24위, 설문은 예산 기준 22위 |
| 재현한 버그 105개(@PawelHuryn) | Neon xhigh 63, Astra 62.7, Fable 58, Carbon 57.3 | 단일 테스터 |
SpringPrompt는 OpenRouter의 medium을 사용했지만 Google API의 기본값은 high이므로 응답의 장황한 정도가 다릅니다. AI Studio에서 문맥이 유출된다는 단독 보고도 있습니다(관련 스레드). 채팅에서는 eesel의 측정 기준 Neon xhigh의 첫 토큰까지 56.5초가 걸렸습니다. 대화형 응답에는 medium이나 Hydrogen이 더 적합합니다.
작업별 추천
| 작업 | 추천 | 이유 |
|---|---|---|
| 고난도 에이전트, 장문 문서, 리팩터링 | Neon high | $3.74에 59.6점, Agent Arena 2위, 체스 3/3 |
| 가장 긴 실행 시간이 필요한 빌드 | Google의 제품군 포지셔닝에 따르면 Carbon | Google은 가장 어려운 프로젝트에 Carbon을 배정하고 있음. 이 글에는 동일 작업 검증 결과가 없음 |
| 오케스트레이션 + 코딩 | Fable 리드 + Neon 코더 | 앞서 소개한 경험적 하이브리드 구성. 먼저 검증할 것 |
| 가장 낮은 작업 비용 | Sol max $1.01. 더 높은 점수를 원하면 Astra high $2.07 | 두 모델 모두 AA-Omniscience에서 오답률이 더 높았음 |
| 대화형 채팅 | Hydrogen 또는 Neon medium | xhigh는 첫 토큰 지연이 채팅에 너무 김 |
| 규제 산업용 | 문서가 나올 때까지 보류 | 11월 19일 기준 전체 안전성 보고서가 아직 공개되지 않음. 필요한 문서를 기준으로 승인할 것 |
반나절이면 직접 검증할 수 있다
Neon high, 현재 사용 중인 기본 모델, 저렴한 대안 하나에 동일한 프롬프트와 파일, 사고 예산을 적용해 보세요. 성공 여부와 비용, 시간, 오답을 기록하면 됩니다. 여러분의 작업 큐에는 어떤 순위표보다 이 한 번의 비교가 더 정확한 답을 줍니다. Opus 관련 계산은 Opus 5.5 리뷰, Fable 관련 계산은 Fable 5.2 리뷰를 참고하세요.