토큰 단위로 비용을 내는 환경이라면 Gemini 4 Neon API의 선택 기준은 성능보다 날짜에 가깝다. 앞으로 11일간은 Carbon이 더 저렴하지만, 12월 1일부터는 Neon이 25% 낮은 가격이 된다. Google은 Gemini 4 Neon을 2026년 11월 18일 출시했으며, 가격은 입력 100만 토큰당 $3, 출력 100만 토큰당 $15다. 컨텍스트 윈도우는 100만 토큰이고 무료 티어는 없다.
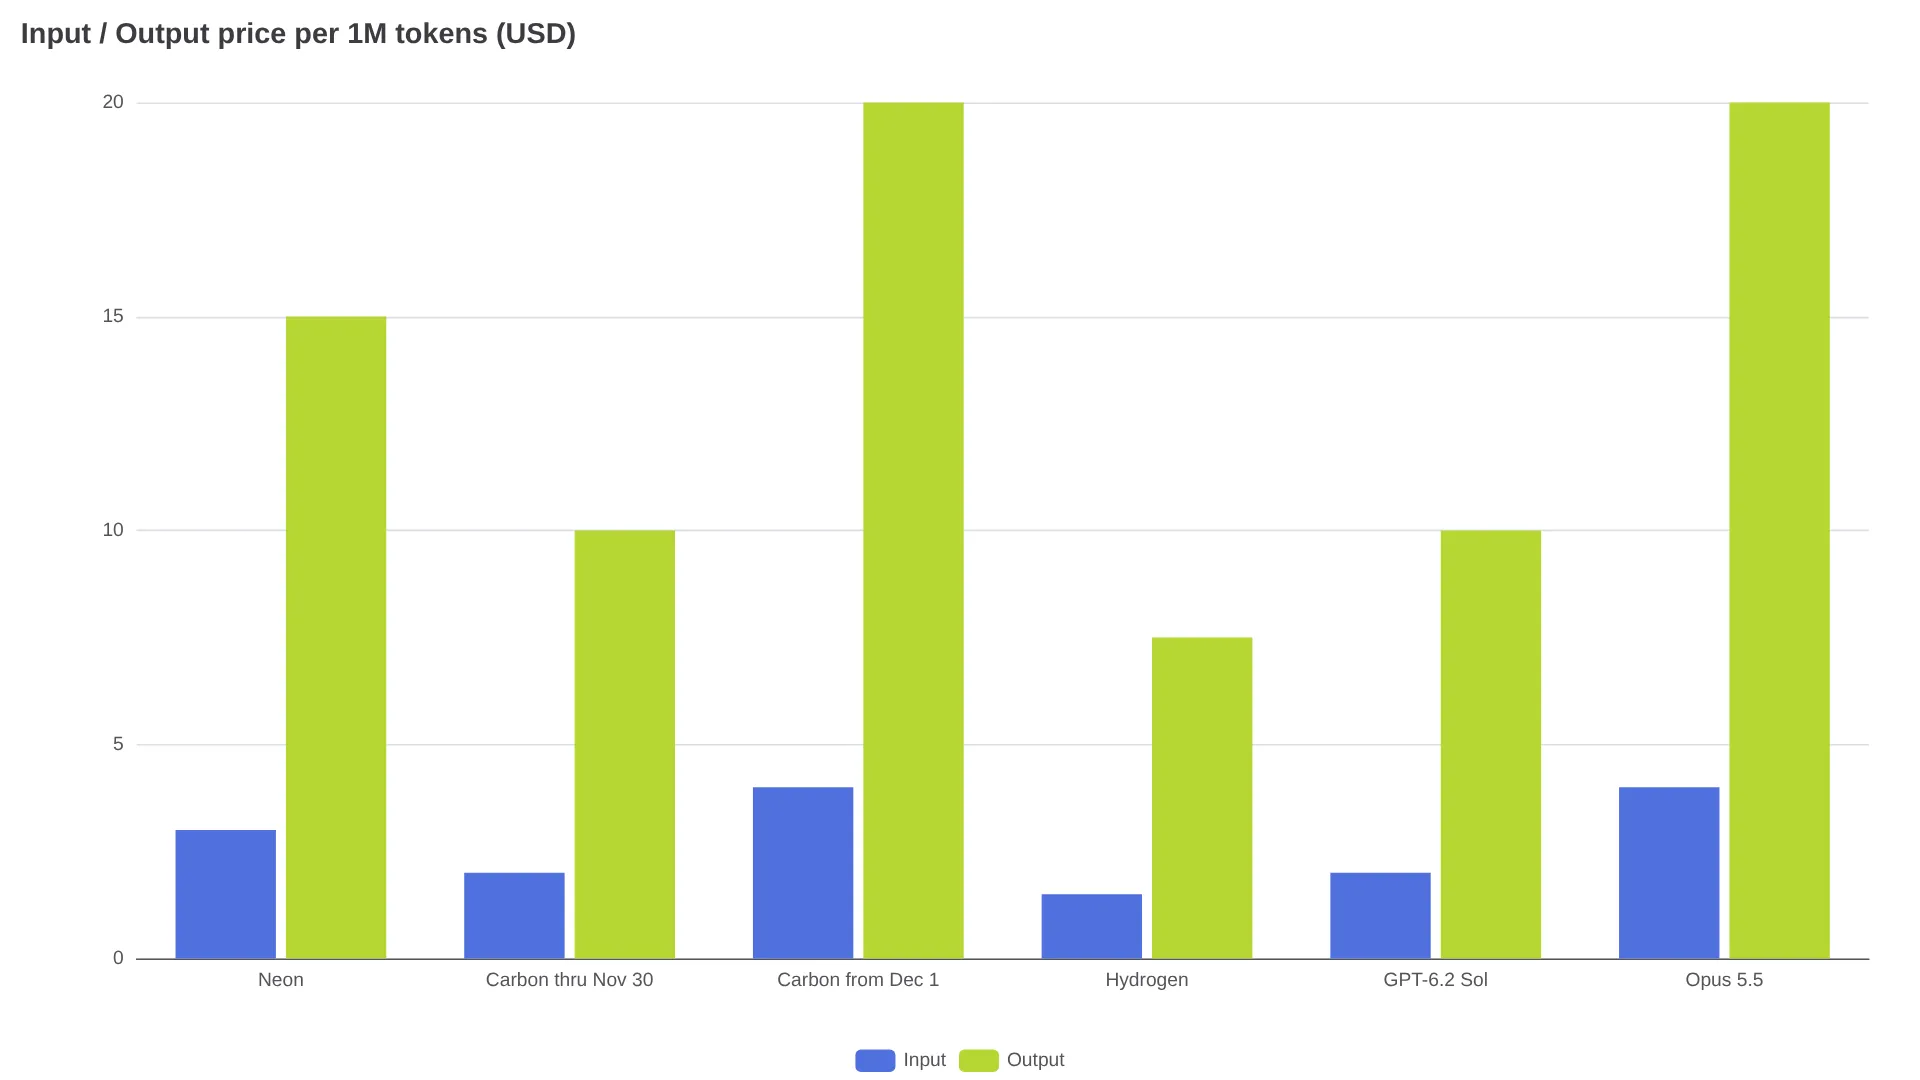
11월 30일이 지나면 가격 구도가 뒤집힌다
Gemini 4 Neon API 가격은 달력과 함께 봐야 한다. 2026년 11월 30일까지 Gemini 4 Carbon은 출시 프로모션으로 입력 100만 토큰당 $2, 출력 $10이다. 그러나 12월 1일부터 Carbon과 Argon은 $4/$20으로 오른다. 이 시점부터 $3/$15인 Neon은 토큰당 정확히 25% 저렴해진다(가격 비교). 반대로 11월 30일까지 Neon은 프로모션 중인 Carbon보다 50% 비싸다.
Google은 높은 thinking 설정에서 Carbon 대비 작업당 비용이 32% 낮고, xhigh에서는 이름을 밝히지 않은 경쟁 모델보다 최소 36%를 절감한다고 설명한다(출시 분석). 다만 예산은 공개된 $3/$15 토큰 단가로 잡는 편이 낫다. 작업당 비용 수치는 Google이 제시한 것이며 비교 기준 모델도 공개되지 않았다.
Gemini 4 제품군에서 Neon의 위치
Gemini 4 Neon은 중간급 선택지다. OpenRouter의 모델 포지셔닝에 따르면 Hydrogen보다 깊은 추론을 제공하면서, Carbon에 가까운 품질을 더 빠르게 낸다. Carbon은 프런티어 코딩의 기본 선택지였고, Argon은 수학·과학 작업을 위한 플래그십 추론 모델, Hydrogen은 $1.50/$7.50의 대량 처리용 모델이다(가격 인덱스). Neon은 low, medium, high, xhigh의 네 가지 추론 레벨을 지원하며 기본값은 high다(제공사 사양).
Google 발표와 출시 분석 기준 출시 시점의 제공 범위는 다음과 같다.
| 제공 환경 | Neon 이용 방식 |
|---|---|
| Gemini API | 유료 개발자 대상, 모델 ID gemini-4-neon (카탈로그 목록) |
| AI Studio / Gemini app / Antigravity | 유료 티어 및 Google AI Pro, Ultra |
Antigravity에서 보이는 Neon 라벨은 주의해서 해석해야 한다. Antigravity 스레드의 사용자들은 일부 세션에서 오케스트레이터 항목이 여전히 Carbon 시스템 프롬프트로 연결될 수 있다고 보고했다. 한 댓글은 이를 두고 "그건 그냥 오케스트레이터일 뿐, Neon이 아니다"라고 요약했다(스레드). Google이 빌드 ID 매핑을 공개하기 전까지는 UI 라벨이 아니라 API 모델 ID를 기준으로 비용을 계산하는 편이 안전하다.
$3/$15에 포함되는 것과 실제 과금 방식
기본 요금은 입력 $3.00, 출력 $15.00, 캐시 입력 $0.15로 모두 100만 토큰 기준이다(공식 발표). 이 가격은 전체 1,048,576토큰 컨텍스트에서 동일하게 적용된다(가격 확인). 서드파티 인덱스에는 Batch $1.50/$7.50, Flex $1.50/$7.50, Priority $5.40/$27.00이 올라와 있다(사양 및 제공사 표). 하지만 출시 시점에 Google의 일반 가격 페이지에는 Neon Batch/Flex/Priority가 게시되지 않았다. 해당 페이지가 갱신되기 전까지 Neon은 Standard 전용으로 보는 것이 좋다(출시 분석).
재사용할 수 있는 계산식은 다음과 같다. 비용 = 신규 입력 / 1M × $3 + 캐시 입력 / 1M × $0.15 + thinking을 포함한 출력 / 1M × $15.
표면상의 단가를 실제 청구액으로 바꾸는 규칙은 세 가지다(출시 분석 및 가격 참고).
- Thinking 토큰은 출력으로 과금된다. $15인 출력 비용이 전체 청구액을 좌우한다.
- 캐싱은 암시적으로만 적용된다. 프롬프트가 최소 4,096토큰이어야 하며, 조건을 충족한 캐시 입력에는 95% 할인이 적용된다. 명시적인
cachedContents캐시는 없고 캐시 쓰기 비용도 없다. - 동기식 출력은 최대 65,536토큰이다(사양). 더 긴 출력에는 백그라운드 실행이 필요하다.
4,096토큰 미만의 짧은 프롬프트에는 캐시 혜택이 전혀 없다(가격 참고). 예를 들어 입력 1,200토큰을 쓰는 고객 지원 봇은 $0.15 요율을 적용받을 수 없다.
가정한 두 워크로드의 비용
아래 계산은 토큰 수를 고정한 모델링 결과이며, 재시도와 가변적인 추론 길이는 제외했다. 핵심은 출력 비중이다. 모든 행은 출시 가격표의 모델별 정가를 적용하고 동일한 캐시 비율을 사용했다.
코딩 세션: 호출 50회, 호출당 입력 80,000토큰 중 90%가 캐시에서 제공되고, thinking을 포함한 출력은 호출당 2,500토큰이다. 합계는 신규 입력 400,000토큰, 캐시 입력 360만 토큰, 출력 125,000토큰이다.
| 모델 | 세션 비용 |
|---|---|
| Gemini 4 Neon $3/$15 | $3.62 (신규 $1.20 + 캐시 $0.54 + 출력 $1.88 = $3.615) |
| 11월 30일까지 Carbon $2/$10 | $2.41 |
| 12월 1일부터 Carbon $4/$20 | $4.82 |
| Hydrogen $1.50/$7.50 | $1.81 |
| GPT-6.2 Sol $2/$10 | $2.41 |
대규모 고객 지원: 하루 10,000건의 대화를 30일간 처리하고, 각 대화는 입력 6,000토큰 중 75%가 캐시 적용 대상이며 출력은 500토큰이다. 합계는 신규 입력 4억5,000만 토큰, 캐시 입력 13억5,000만 토큰, 출력 1억5,000만 토큰이다.
| 모델 | 월간 비용 |
|---|---|
| Gemini 4 Neon $3/$15 | $3,802.50 (이 중 출력 비용은 $2,250) |
| 11월 30일까지 Carbon $2/$10 | $2,535.00 |
| 12월 1일부터 Carbon $4/$20 | $5,070.00 |
| Hydrogen $1.50/$7.50 | $1,901.25 |
| GPT-6.2 Sol $2/$10 | $2,535.00 |
Neon은 토큰당 Hydrogen의 2배, $2/$10인 Sol보다 50% 비싸다. 작업당 가격에서 이기려면 더 적은 토큰 또는 더 적은 재시도로 작업을 끝내야 한다. 인용된 벤치마크 수치(Intelligence Index 61점, 3위 / Coding Agent Index 1위)는 공급업체가 보고한 결과일 뿐이며, 실제 작업 비용이 낮다는 근거는 아니다(벤치마크 정리).
토큰 가격과 사용 쿼터는 별개다
앱에 표시되는 사용률 퍼센트는 API 비용으로 환산되지 않는다. 한 Pro 사용자는 긴 컨텍스트의 Neon 세션에서 메시지당 사용량이 1~2%라고 보고했다.
긴 컨텍스트가 있는 기존 대화를 Neon으로 바꿔 보니 메시지당 사용량이 1~2%였습니다. 이 모델은 Pro 요금제에서 실제로 쓸 만할지도 모르겠네요. — u/biblecrumble (스레드)
앱 쿼터는 5시간 단위 창, thinking 레벨, 도구 호출을 반영한다. API 청구는 thinking을 포함한 모든 처리 토큰을 계산하고, Search grounding은 쿼리마다 별도로 과금된다(출시 분석). API 작업 예산은 위 표의 달러 비용으로, 구독 요금제의 여유분은 직접 실행한 high와 xhigh 결과를 바탕으로 판단해야 한다.
모델 ID를 바꾼 뒤 확인할 세 가지
Carbon, Argon, Hydrogen 호출은 모델 ID를 gemini-4-neon으로 바꾸면 이전할 수 있다(출시 분석). 다만 다음 세 가지는 여전히 호출 실패를 일으킬 수 있다(출시 분석).
thinking_level을 명시적으로 설정한다. Neon의 기본값은 high다.cached_content필드를 제거한다. 명시적 캐싱은 지원하지 않는다.temperature,top_p,top_k를 제거한다. 범위를 벗어난 값은 HTTP 400을 반환하고, 그 밖의 값은 무시된다.
긴 출력을 다룬다면 max_output_tokens를 65,536에 가깝게 높이거나 백그라운드 실행을 사용해야 한다.
지금 전환할지, Carbon 프로모션을 더 쓸지
| 상황 | 선택 |
|---|---|
| 11월 30일 이전 출시, 최고 수준의 추론 필요 | Carbon $2/$10을 유지하고 Neon은 병렬 테스트 |
| 12월 운영 에이전트, 긴 컨텍스트 | Neon $3/$15는 정가 기준 후보 — 전환 전 작업 성공률과 재시도 횟수 검증 |
| 대량의 단순 채팅 | Hydrogen $1.50/$7.50 유지, 이 목록에서 유일한 무료 티어 옵션(가격 인덱스) |
| 현재 가장 저렴한 프런티어 정가 | 스택에서 OpenAI를 쓸 수 있다면 GPT-6.2 Sol $2/$10 |
| Batch 가격 근거 문서 필요 | 대기 — Neon Batch는 미공개 |
FAQ
Gemini 4 Neon API 가격은 얼마인가?
Google 기준 입력 100만 토큰당 $3, 출력 $15, 캐시 입력 $0.15다.
컨텍스트와 출력 한도는?
입력 1,048,576토큰, 동기식 출력 65,536토큰이다.
무료 티어가 있는가?
없다. Neon은 유료 전용이며 Hydrogen은 무료 티어를 유지한다.
Batch, Flex, Priority를 사용할 수 있는가?
출시 시점에 Google은 이를 공개하지 않았다. 서드파티 목록에는 Batch/Flex $1.50/$7.50, Priority $5.40/$27로 표시되지만 예산에 반영하기 전에 확인해야 한다.
캐싱은 어떻게 작동하는가?
암시적 캐싱만 지원하며 최소 4,096토큰이 필요하고, 조건을 충족한 캐시 입력에는 95% 할인이 적용된다.
모델 ID는 무엇인가?
gemini-4-neon.
Neon, Hydrogen, Carbon 중 무엇을 써야 하나?
저렴한 대량 처리에는 Hydrogen, 가장 저렴한 프런티어 토큰 가격이 필요한 경우 11월 30일까지는 Carbon, 12월 1일부터 Carbon의 $4/$20보다 25% 낮은 비용으로 고급 추론을 쓰려면 Neon이 적합하다.
입력 2,000토큰과 출력 500토큰 요청의 비용은?
캐싱 전 정가 기준 $0.0135다. Thinking은 출력으로 과금된다.