100만 토큰당 입력·출력 가격만 보면 Astra는 $8/$40, Sol은 $2/$10으로 정확히 4배 차이입니다. 다만 실제 청구서의 결론은 조금 더 좁혀집니다. 아래 FrontierCode 작업당 비용에서는 Sol이 일반적인 코딩을 약 5분의 1 비용으로 처리했습니다($1.29 vs $5.97). 반면 한 번의 정확한 실행이 반복 시도를 대체할 수 있는 강한 도메인 특화 테스트에서는 Astra가 약 4~10포인트 앞섰습니다.
OpenAI의 실제 요금과 사용할 수 있는 곳
OpenAI는 Astra를 가장 까다로운 프로젝트용, Sol을 일상적인 작업용으로 포지셔닝합니다(출시 발표). ChatGPT/Codex 플랜 사용량과 API 비용은 별도로 봐야 합니다. 플랜 사용량이 API 호출 비용을 내주지 않으며, API 호출도 플랜 한도를 차감하지 않습니다. 두 모델 모두 컨텍스트 윈도우는 1,050,000토큰이며, 요청당 최대 입력은 922,000토큰, 출력은 128,000토큰입니다. 텍스트와 이미지를 입력으로 받고 텍스트를 출력하며, Responses 및 Chat Completions API에서의 모델 ID는 gpt-6.2-astra와 gpt-6.2-sol입니다.
표준 API 가격은 100만 토큰 기준입니다.
| 모델 | 입력 | 캐시된 입력 | 캐시 쓰기(30분) | 출력 |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $10.00 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra (이전 모델) | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol (이전 모델) | $2.00 | $0.10 | $2.50 | $10.00 |
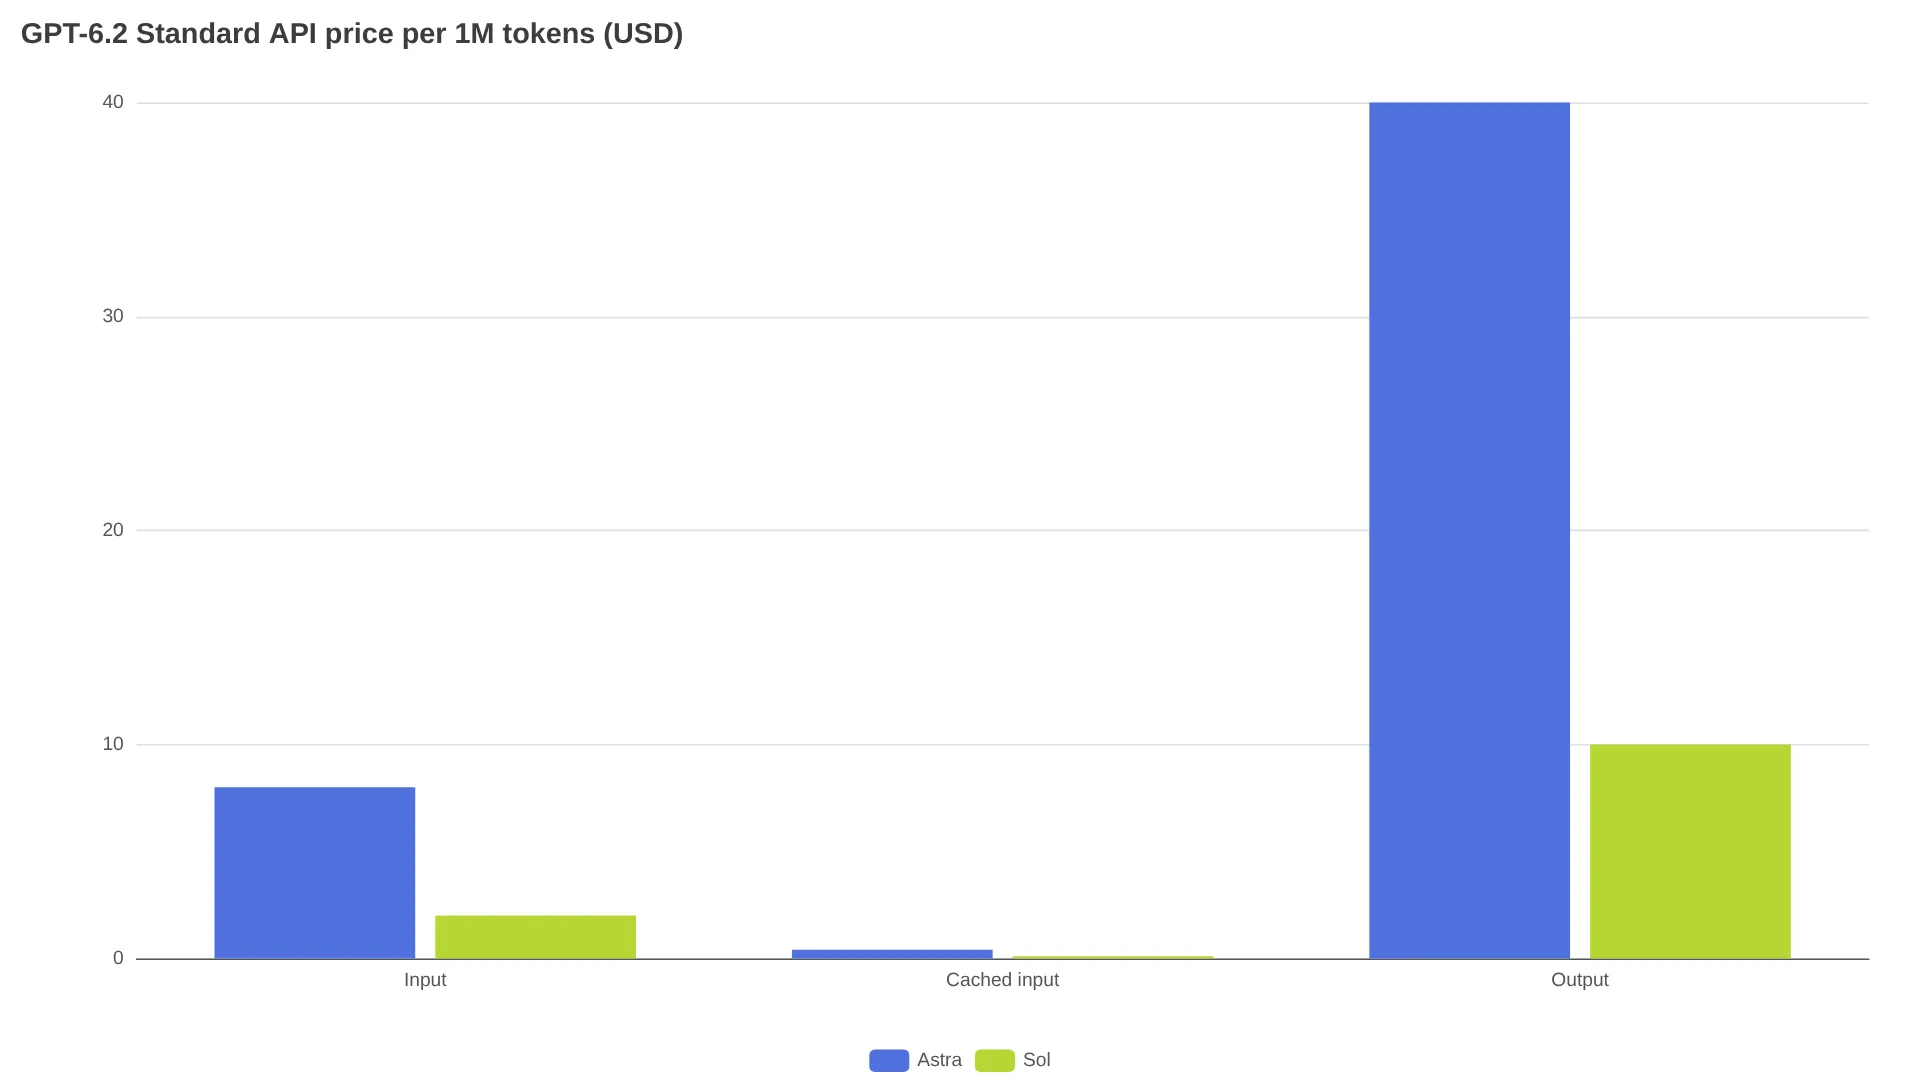
Astra는 GPT-6 Astra보다 입력과 출력이 20% 저렴하고, 캐시된 입력은 60% 저렴합니다. Sol은 GPT-6.1 Sol과 같은 가격을 유지합니다. 2026년 11월 17일 출시 시점부터 두 모델은 API에서 일반 제공되며, Batch는 Standard보다 50% 저렴하고 백그라운드 윈도우는 30~40% 저렴합니다(GenAI Brief의 티어별 분석).
청구 금액을 바꾸는 세 가지 변수
1. 캐시 쓰기에도 비용이 붙습니다. 캐시 읽기 비용은 입력 가격의 5%입니다(Astra $0.40, Sol $0.10). GenAI Brief의 요금표에 따르면, 30분 TTL 캐시 쓰기는 입력 가격의 1.25배(Astra $10.00, Sol $2.50)이며 12시간 보관은 2.5배입니다. 예를 들어 캐시 미스로 108,000토큰의 히스토리를 다시 써야 한다면 출력 전 기준으로 Astra는 108,000 × $10/M = $1.08, Sol은 108,000 × $2.50/M = $0.27이 청구됩니다.
2. 272,000토큰을 넘으면 요청 전체의 단가가 바뀝니다. 입력이 272K토큰을 초과하면 입력 단가는 2배로 오릅니다(Astra $8→$16, Sol $2→$4). 출력은 1.5배가 됩니다(Astra $40→$60, Sol $10→$15). GenAI Brief의 계산 테스트에서는 히스토리 20K를 추가해 이 경계선을 넘기자 Astra 한 턴의 비용이 $0.344에서 $0.624로 상승했습니다. 입력은 7%만 늘었지만 비용은 81% 뛰었습니다. 272K 전에 히스토리를 요약하거나 잘라내는 편이 좋습니다. 단, 이로 인해 캐시 프리픽스가 바뀐다면 캐시 미스 비용도 고려해야 합니다.
3. 속도 티어는 모든 비용에 배수를 적용합니다. Fast는 Standard의 2배입니다. Ultrafast는 2027년 2월 28일까지 3배, 2027년 3월 1일부터는 6배이며 미국 리전 전용입니다. Standard/Fast/Batch는 미국과 EU를 지원합니다. 이는 GenAI Brief의 티어 규칙과 OpenAI의 처리 티어 문서에 따른 내용입니다. 3배 티어에서 Astra 출력은 100만 토큰당 $120, 6배에서는 $240입니다.
토큰 단가보다 중요한 작업당 비용
토큰 수가 같다면 Astra 비용은 Sol의 4배입니다. Astra가 이기려면 더 적은 토큰을 쓰거나, 시도 횟수를 줄이거나, 비싼 사람의 수정 작업을 피해야 합니다. 직접 API 비용 기준 손익분기점은 이렇습니다. 같은 토큰 규모에서 Astra 한 번의 시도가 Sol 네 번 초과의 시도를 대체하거나, 가중 토큰 수를 약 75% 줄여야 합니다.
보고된 작업당 비용은 벤치마크, 추론 강도, 비용 계산 방식이 서로 다르므로 방향성 참고용으로 보고 자체 리플레이로 확인해야 합니다.
| 출처 / 워크로드 | Astra | Sol | 의미 |
|---|---|---|---|
| Artificial Analysis Intelligence Index, 최대 강도 | 62점, 작업당 $4.00, 10.4분(GPT-6 Astra: 57점, $6.24) | 57점, 작업당 $1.01, 7.9분 | Sol은 GPT-6 Astra와 같은 57점을 약 6분의 1인 $6.24 수준의 작업 비용으로 달성 |
| DataCamp 경유 FrontierCode 2.0, 최대 강도 | 44.2%, 작업당 $5.97 | 43.8%, 작업당 $1.29 | 0.4포인트 차이에 작업 비용은 약 5배. 이 코딩 근거에서 Astra는 비용 장벽을 넘지 못함 |
| DataCamp 경유 Harvey LAB-AA / SecureSWE / Terminal-Bench-Science | 15.0% / 65.7% / 77.1% | 11.1% / 55.6% / 68.0% | 이 항목에서 Astra 격차가 가장 큼. 법률, 보안 코드, 과학 작업에는 Astra 테스트 권장 |
| DataCamp 경유 BenchCAD 2.1 Core | 82.5% | 73.1% | 약 9포인트의 CAD 격차는 CAD 작업에서 Astra 테스트를 뒷받침 |
| DataCamp의 슬라이드 재구성, 단일 실행 테스트 | $0.22, 출력 4,968토큰 | $0.07, 글꼴 크기 정확 | 이 템플릿 작업에서는 눈에 띄는 품질 차이가 없었고, 비용은 Sol이 우세 |
| OpenAI 수치를 DataCamp가 요약한 Agents' Last Exam, Sol High vs 기존 Astra Max | — | Sol High 72.0%, 작업당 $0.69 vs GPT-6 Astra Max 73.1%, $8.99 | 이 설정에서는 약 1포인트 낮은 점수로 비용은 약 13분의 1 |
계산이 맞는 예를 들어보겠습니다. Sol 한 번 시도가 $0.10이고 3번 중 2번 성공한다면, 승인된 결과 하나당 Sol 비용은 $0.15입니다. 시도당 $0.40인 Astra는 성공률만으로 이를 이길 수 없습니다. 반대로 Sol이 5번 중 1번만 성공해 승인 결과당 $0.50이 들고 Astra가 첫 시도에 성공한다면 Astra가 이깁니다($0.40). OpenAI는 GDPval v2에서 Astra의 출력 토큰이 22% 적었다고 보고하지만, 공급사 주장은 방향성 지표로 받아들이는 편이 좋습니다.
일반적인 코딩과 대량 에이전트 작업은 Sol부터 시작하세요. 법률, CAD, 긴 과학 작업에서는 Astra를 테스트할 만합니다. 재시도와 수정까지 포함한 total spend / accepted tasks가 더 낮을 때만 Astra로 라우팅하는 것이 좋습니다.
프리픽스를 고정하지 못하면 다시 쓰는 비용을 냅니다
대화 중간에 지침, 도구, 스키마 또는 이전 출력을 바꾸면 캐시가 무효화되고 GPT-6.2가 다시 추론할 수 있습니다.
프리픽스 캐싱을 유지하려면(GenAI Brief 통합 노트, OpenAI 모델 문서) 다음을 따르세요.
- 처음 메시지를 다시 쓰는 대신 새 developer 메시지나
configuration_update를 추가합니다. - 대화 도중 도구 목록을 교체하지 말고
additional_tools로 도구를 추가하거나tool_choice/allowed_tools로 사용을 제한합니다. - 첫 전송 전에 오래된 도구 출력을 줄이고 이미지 크기를 낮춥니다.
- 프로덕션 트래픽을 옮기기 전 Prompt Cache Diagnostics와 Responses
input_transformations(prefix_mismatch)로 원인을 진단합니다.
Astra와 Sol로 옮길 때 확인할 항목
EpiFive의 마이그레이션 가이드와 GenAI Brief의 통합 규칙을 바탕으로, OpenAI 모델 비교 문서와 대조한 체크리스트입니다.
model을gpt-6.2-astra또는gpt-6.2-sol로 변경합니다.- Responses에서는
reasoning.effort: medium, Chat Completions에서는reasoning_effort: medium으로 시작합니다.none은 거부되며, 짧은 지연 시간이 필요한 호출에는low를 사용합니다. - 요청에서
temperature,top_p,logprobs/top_logprobs를 제거합니다. 도구 호출은 Responses API로 옮깁니다. - GPT-5.5 또는 이전 버전에서 마이그레이션한다면
prompt_cache_retention을prompt_cache_options.ttl: "30m"로 교체하고 캐시 쓰기 비용을 예산에 반영합니다. - Zero Data Retention에서는
store가false로 처리됩니다. 암호화된 추론 항목을 포함해 이전 출력 항목을 순서대로 다시 전송해야 합니다. - 모델별로 짧은 작업 30개를 리플레이해 통과율, 재시도, 출력 토큰, 승인 결과당 비용을 측정합니다. 이어서 프리픽스가 안정적인 긴 에이전트 세션 하나와 프리픽스를 한 번 수정한 세션 하나를 비교해 캐시 적중률과 총 작업 비용을 확인합니다.