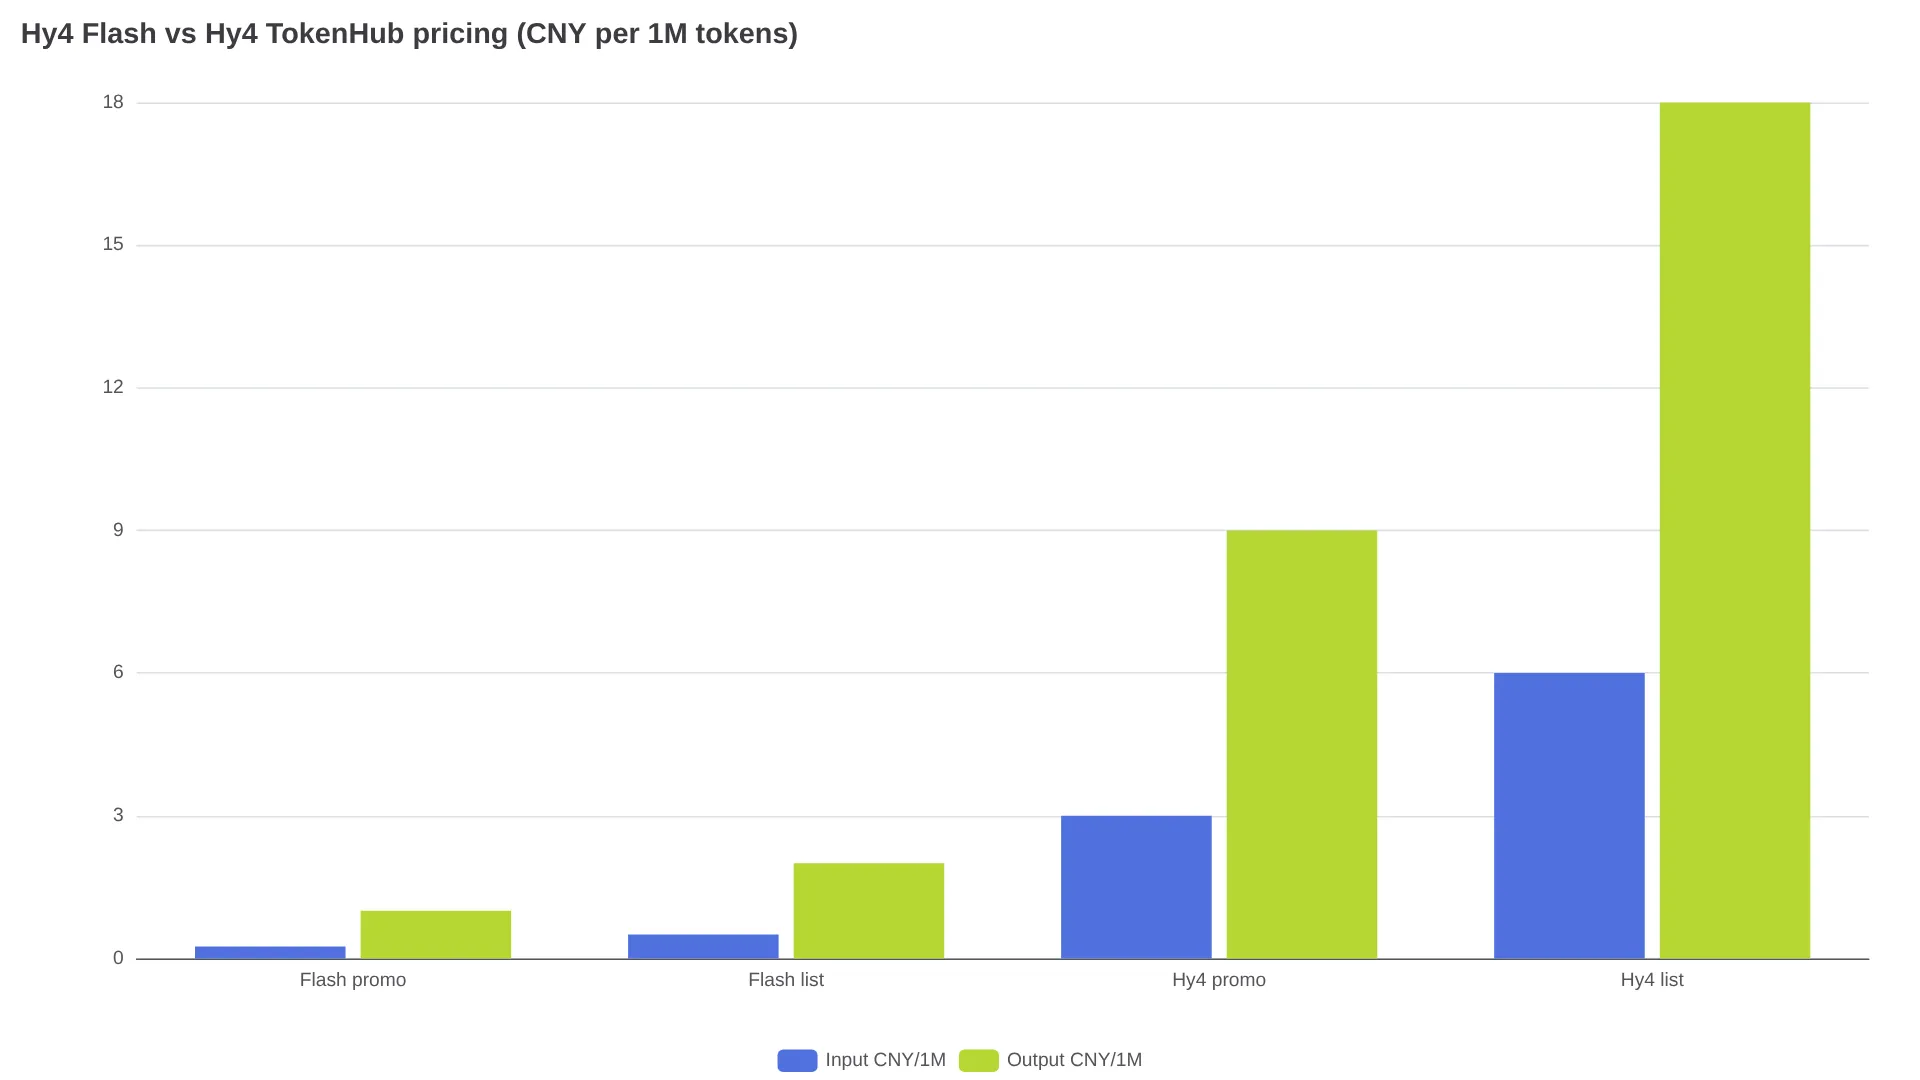
Tencent의 Hy4 Flash(총 224B / 활성 12B, 1M 컨텍스트)가 2026년 11월 16일 공개됐습니다. 정식 요금은 토큰 100만 개당 입력 CNY 0.50 / 출력 CNY 2.00($0.070 / $0.281)이며, 현재 TokenHub 출시 할인가는 베이징 시간 11월 30일 정오까지 CNY 0.25 / CNY 1.00입니다.
Flash는 Hy4와 같은 작업을 더 작은 규모로 처리하는 모델이 아닙니다. 과금은 요청에 넣은 모델 ID를 기준으로 이뤄집니다. hy4-flash는 저가형 티어, hy4는 플래그십, hy4-preview는 8월 체크포인트입니다.
Hy4 Flash 출시 — 11월 16일 공개된 내용
11월 4일 Hy4 발표에서는 Flash 요금이 공개되지 않았지만, 11월 16일 출시 게시물과 같은 날 등록된 TokenHub 상품을 통해 가격이 확정됐습니다(ITHome, Sina Finance, LLMLearner 사양).
- Tencent Cloud TokenHub, 모델 ID
hy4-flash— 현재 이용 가능. - WorkBuddy, Yuanbao 및 Tencent 앱 — WorkBuddy는 11월 30일까지 무료로 제공됩니다.
- OpenRouter — 출시 예정이며 아직 제공되지 않음. 11월 16일 기준 등록된 모델은
tencent/hy4뿐입니다. OpenRouter에 Flash가 추가되기 전까지는 TokenHub의 싱가포르 엔드포인트를 사용하면 됩니다.
Flash가 Hy4 요금의 10분의 1인 이유를 보여주는 사양
Hy4 Flash는 64B Engram 파라미터를 포함해 총 224B 파라미터를 갖고 있으며, 토큰당 활성 파라미터는 12B입니다. 구조는 혼합 전문가(MoE) 방식입니다(LLMLearner, Sina). 컨텍스트 윈도우는 1M 토큰(1,048,576)이고, 입력은 텍스트와 이미지, 출력은 텍스트를 지원합니다.
요금에 직접 영향을 주는 부분은 따로 있습니다. KV 캐시 크기가 Hy4의 1/6, Hy3의 1/24이며, 메가커널과 4비트 양자화, dflash 디코딩 가속을 적용해 초당 150토큰 이상의 처리 속도를 냅니다. 멀티모달 이미지 처리, 차트 분석, 시각적 수학 문제도 같은 엔드포인트에서 지원합니다.
가중치는 발표만 된 상태입니다: Apache 2.0 라이선스의 Hy4-preview와 달리, 11월 16일 기준 Flash의 공개 체크포인트·출시일·라이선스는 없습니다.
Hy4 Flash API 요금 한눈에 보기
TokenHub는 중국 본토용 CNY 카탈로그와 국제용 USD 카탈로그를 별도로 제공합니다. 서로 환산한 값이 아니라 지역별 요금표입니다. Flash 프로모션은 베이징 시간 11월 30일 12:00까지 진행되며(LLMLearner), 플래그십 프로모션은 베이징 시간 12월 31일 23:59까지 적용됩니다(CostMyTokens 검증, ChinaModelAPI).
| 티어 | 입력 / 1M | 출력 / 1M | 캐시 읽기 / 1M | 유효 기간 |
|---|---|---|---|---|
| Flash 정가(CNY) | ¥0.50 | ¥2.00 | ¥0.02 | 상시 |
| Flash 프로모션(CNY) | ¥0.25 | ¥1.00 | ¥0.01 | 11월 30일 베이징 시간 12:00까지 |
| Flash 정가(USD) | $0.070 | $0.281 | $0.003 | 상시 |
| Hy4 정가(CNY) | ¥6.00 | ¥18.00 | ¥0.30 | 상시 |
| Hy4 프로모션(CNY) | ¥3.00 | ¥9.00 | ¥0.15 | 12월 31일 베이징 시간 23:59까지 |
| Hy4 정가(USD) | $0.834 | $2.501 | $0.042 | 상시 |
| Hy4 프로모션(USD) | $0.417 | $1.2505 | $0.021 | 12월 31일까지 |
Flash 프로모션 요금으로 계산하면 다음과 같습니다. 신규 입력 100K + 캐시된 입력 500K + 출력 5K = 0.1 x ¥0.25 + 0.5 x ¥0.01 + 0.005 x ¥1.00 = ¥0.035입니다.
실제 차이는 작업 단위 비용에서 더 분명합니다. Tencent는 Hy4 대비 약 1/20, Hy4 preview 대비 1/13, DeepSeek-V4.1-Flash(max) 대비 1/8 수준이라고 설명합니다(Sina). Tencent가 내부 사용자 85명과 259개 작업을 대상으로 진행한 블라인드 테스트(LLMLearner)를 바탕으로 출시 스레드에서 커뮤니티가 계산한 비용은 작업당 ¥0.26입니다. Claude Haiku 5.5(high)는 ¥4.73, DeepSeek-V4.1-Flash는 ¥1.20이었고, 만족도는 각각 2.79 대 2.81로 집계됐습니다(@alphaw0ng 분석). 아직 독립적으로 검증된 비교표는 없으므로, 이 수치는 커뮤니티 계산이 포함된 벤더 테스트 결과로 보는 편이 안전합니다.
에이전트 비용을 좌우하는 건 캐시입니다. 캐시 읽기 요금은 신규 입력 요금의 4~5%에 불과합니다(¥0.02 대 ¥0.50, $0.003 대 $0.070).
"최첨단 모델인가? 전혀 그렇지 않다. 하지만 이 모델이 WorkBuddy를 업무용 에이전트 시장의 Doubao로 만드는 핵심이다. 200B 파라미터만으로도 비교적 단순한 작업을 처리할 만큼 저렴한 토큰을 대규모 시장에 쏟아낼 수 있다." — 출시 당일 반응, @LeroyLi311063
Flash·Hy4·Hy4 Preview 비교: 작업에 맞춰 고르기
| Hy4 Flash | Hy4 (GA, 11월 4일) | Hy4 Preview (8월 28일) | |
|---|---|---|---|
| 파라미터 | 총 224B / 활성 12B | 미공개(프리뷰 기준: 770B / 49B) | 770B / 49B |
| 컨텍스트 | 1M | 1M — 최대 입력 960K, 최대 출력 64K(설정 가이드) | 1M |
| 모달리티 | 텍스트 + 이미지 입력, 텍스트 출력 | 텍스트 + 이미지 입력, 텍스트 출력, 컴퓨터 사용 | 텍스트, 초기 체크포인트 |
| TokenHub ID | hy4-flash | hy4 | hy4-preview |
| 정가 입력/출력 | ¥0.5 / ¥2.0 | ¥6 / ¥18 ($0.834 / $2.501) | ¥6 / ¥18 |
| 추천 작업 | 검색, 문서, 슬라이드, 간단한 프런트엔드, 일상적인 컴퓨터 사용 | 장기 소프트웨어 작업, 복잡한 에이전트, 금융 리서치 | 오픈 웨이트 테스트(Apache 2.0) |
Flash를 선택할 때는 플래그십 Hy4와의 차이를 염두에 둬야 합니다. Tencent의 Hy4 벤치마크 부록에 따르면 Hy4는 Terminal-Bench 4.0에서 44.4점으로 최상위 상용 모델 실행 결과인 약 66점(Opus 5.5급)에 못 미쳤고, ProgramBench에서는 30.0점으로 56.5점 이상을 기록한 모델보다 낮았습니다. SWE-bench 계열 작업이나 수시간 동안 실행되는 터미널 에이전트라면, 입력 토큰당 ¥0.25라는 프로모션 요금만 보고 Flash를 고르는 것은 적절하지 않습니다. 플래그십 요금은 Hy4 Preview API 요금 가이드와 가장 저렴한 LLM API에서 확인할 수 있습니다.
10분 만에 hy4-flash 호출하기
TokenHub는 /v1/chat/completions, /v1/responses, Anthropic의 /v1/messages를 지원하는 OpenAI 호환 API입니다(엔드포인트 가이드). Yuanbao나 WorkBuddy 세션 토큰이 아니라 TokenHub 키를 사용해야 합니다. 광저우 엔드포인트 https://tokenhub.tencentmaas.com/v1 또는 싱가포르 엔드포인트 https://tokenhub-intl.tencentmaas.com/v1를 선택한 뒤 콘솔에서 모델 서비스를 활성화하세요. 같은 가이드에 따르면 서비스가 비활성화된 경우 402 오류가 반환됩니다. 이후 요청에 hy4-flash를 지정하면 됩니다.
curl https://tokenhub-intl.tencentmaas.com/v1/chat/completions \
  -H "Authorization: Bearer $TOKENHUB_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "hy4-flash",
    "messages": [{"role": "user", "content": "Summarize this 80-page PDF in 10 bullets"}]
}'from openai import OpenAI
client = OpenAI(api_key="YOUR_TOKENHUB_API_KEY",
base_url="https://tokenhub-intl.tencentmaas.com/v1")
resp = client.chat.completions.create(
model="hy4-flash",
messages=[{"role": "user", "content": "Hello"}],
)
print(resp.choices[0].message.content)Flash의 최대 출력 토큰 수는 공개되지 않았습니다. Hy4의 최대 출력은 64K로 문서화돼 있지만, Flash에도 같은 제한이 적용된다고 가정해서는 안 됩니다. 100K 이상 생성하는 작업을 계획한다면 먼저 콘솔의 모델 페이지를 확인하세요.
라우팅 원칙: 기본값은 Flash, 어려운 5%는 Hy4
| 작업 유형 | 사용할 모델 | 이유 |
|---|---|---|
| 문서, 슬라이드, 스프레드시트, 회의 준비, 심층 검색 | hy4-flash | Tencent 테스트에서 작업당 약 ¥0.26으로 Haiku에 가까운 만족도 |
| 긴 접두사가 안정적인 대규모 에이전트 작업 | hy4-flash | 4~5% 수준의 캐시 요금이 빠르게 누적 비용을 낮춤 |
| 간단한 프런트엔드, 일상적인 컴퓨터 사용 | hy4-flash | Tencent가 이 용도로 포지셔닝했으며, >150 tps가 반응성을 높임 |
| 장기 코딩, 터미널 에이전트, 프로그램 합성 | hy4 | Flash는 명시적으로 이 용도로 포지셔닝되지 않음 |
| 현재 직접 호스팅 | hy4-preview 가중치 | 다운로드 가능한 Apache 2.0 가중치를 제공하는 모델은 preview뿐임 |