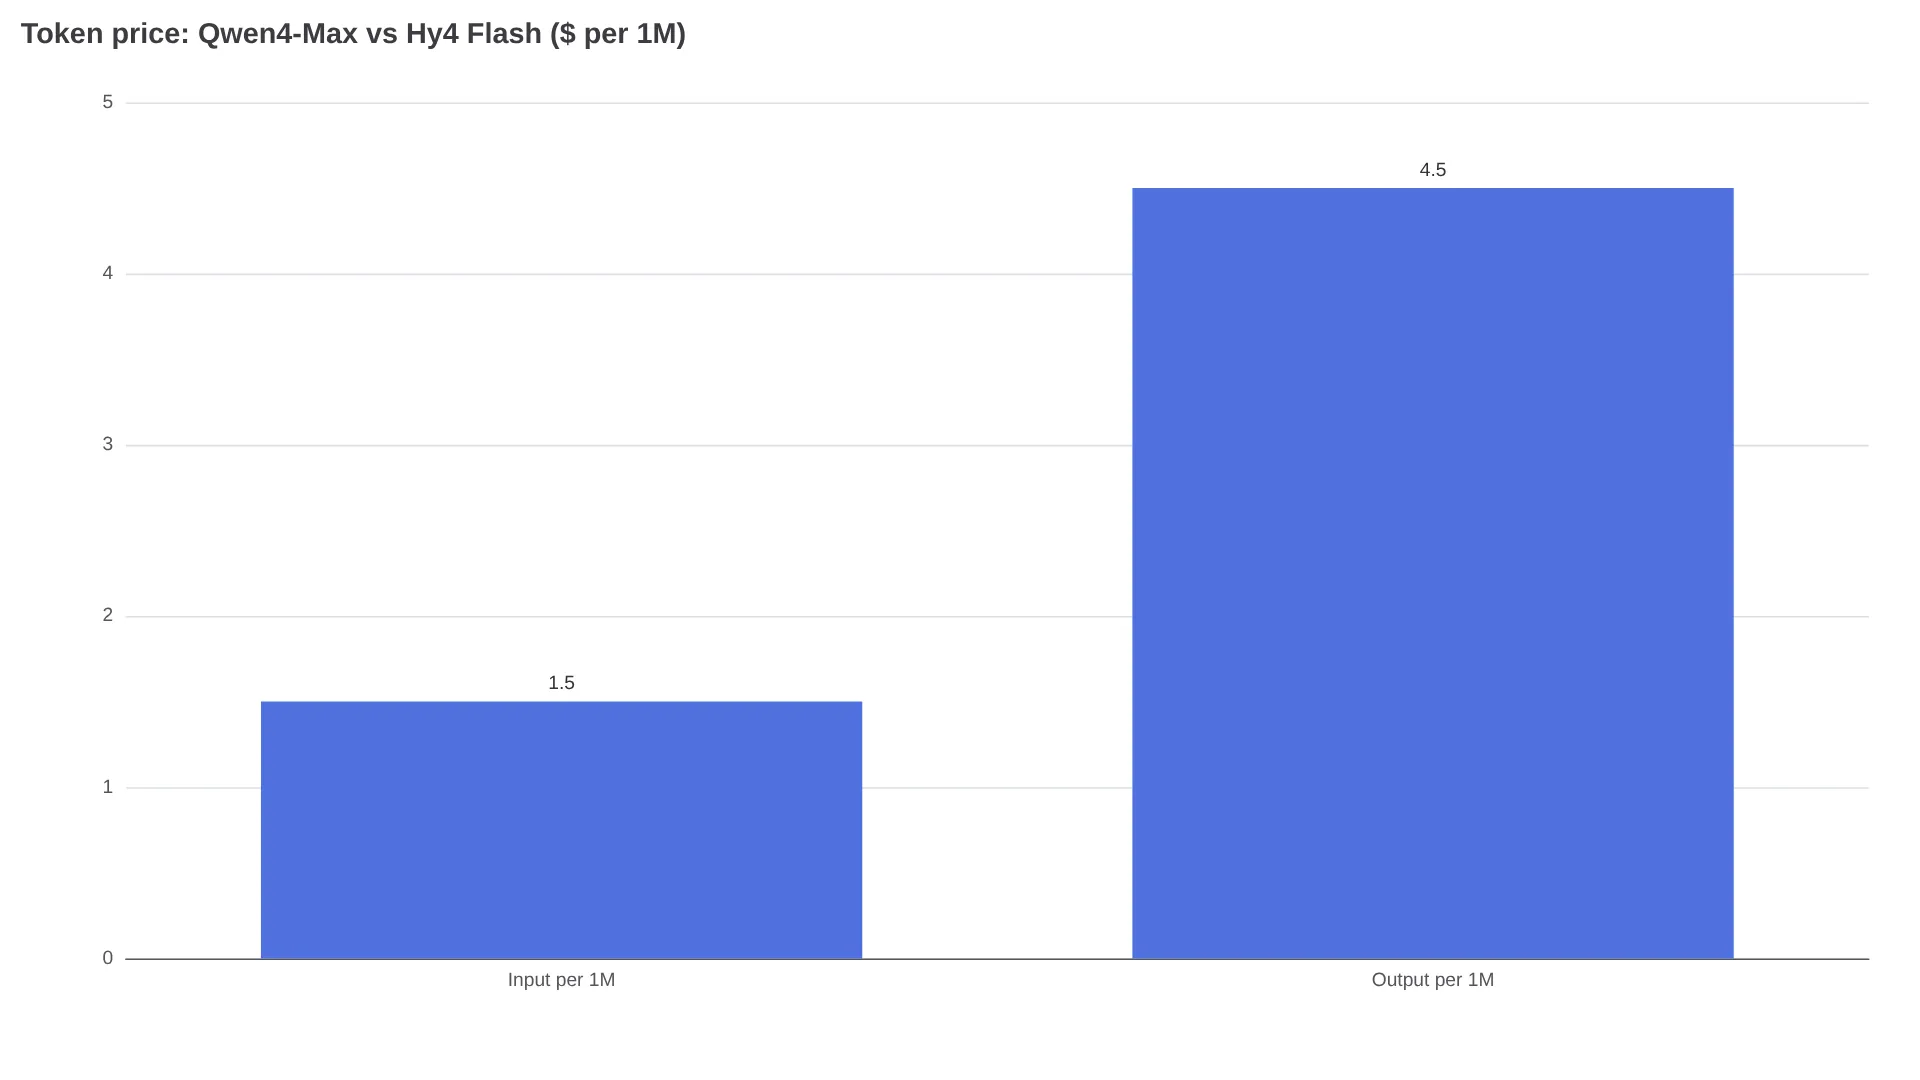
복잡한 코딩과 워크플로 작업에서 인용된 벤치마크 성적은 Qwen4-Max가 Hy4 Flash보다 앞선다. 반면 시도 1회당 비용은 Hy4 Flash가 압도적으로 낮다. QwenCloud의 Qwen4-Max 가격은 100만 토큰당 입력 $1.50, 출력 $4.50이고, Tencent의 Hy4 Flash는 $0.070, $0.281이다. 입력 기준 약 21배, 출력 기준 약 16배 차이다. 다만 에이전트 비용은 표면 가격만으로 결정되지 않는다. 추론 토큰, 재시도 횟수, 캐시 재사용률이 실제 청구액을 좌우한다. 여기서는 두 모델의 1M 컨텍스트, 2.4T 대 224B 백본, 벤더가 제시한 작업당 비용을 나란히 보고 워크로드별 선택 기준을 정리한다.
한눈에 보는 토큰 단가
| 항목 | Qwen4-Max (싱가포르 / 국제) | Hy4 Flash (TokenHub 국제) |
|---|---|---|
| 입력 100만 토큰당 | $1.50 | $0.070 |
| 출력 100만 토큰당 (추론 포함) | $4.50 | $0.281 |
| 캐시 입력 읽기 100만 토큰당 | $0.075 | $0.003 |
| 명시적 캐시 생성 100만 토큰당 | $1.875 (5분) / $3.00 (1시간) | 별도 공개 없음 |
| 입력 0.5M + 출력 0.5M 혼합 | $3.00 | ~$0.176 |
| 모델 ID | qwen4-max via QwenCloud | Hy4 Flash via Tencent |
입력 60,000토큰, 출력 4,000토큰을 쓰는 에이전트 코딩 세션으로 계산해 보면 격차가 선명하다. Qwen4-Max는 입력 $0.09와 출력 $0.018을 합쳐 시도당 약 $0.108이다. Hy4 Flash는 $0.0042와 $0.0011, 즉 시도당 약 $0.0053으로 재시도 전 기준 약 20배 저렴하다. 입력이 전부 캐시되어 있다면 동일한 60k 입력 비용은 출력 전 기준 Qwen4-Max가 $0.0045, Hy4 Flash가 $0.00018이다. QwenCloud는 추론 토큰을 출력으로 과금한다. Hy4 Flash도 출력은 100만 토큰당 $0.281이므로, 출력이 짧을수록 청구 토큰도 직접 줄어든다.
모델 구조가 비용에 미치는 의미
Qwen4-Max는 토큰당 활성 파라미터가 71B인 2.4T 파라미터 MoE 모델이다(Offloop, DataCamp). Hy4 Flash는 활성 파라미터 12B의 224B 파라미터 LatentMoE 모델로, 4비트 추론과 150+ tokens/second를 내세운다(Tencent). 청구액에서는 실제 출력량이 더 중요하다. Qwen4-Max의 테스트 사용량은 출력 127M 토큰으로, 동급 모델 중앙값인 78.6M보다 높았다(DataCamp). 반대로 Hy4 Flash는 후학습으로 평균 출력 길이를 50% 줄였다고 밝혔다(Tencent).
실제로 적용되는 가격 확인하기
QwenCloud 싱가포르 리전은 입력 $1.50, 출력 $4.50, 캐시 읽기 $0.075을 청구한다. 최대 입력은 thinking 비활성화 시 991,808토큰, thinking 활성화 시 983,616토큰이며, 출력은 thinking 비활성화 시 131,072토큰, 합산 기준 262,144토큰이다(QwenCloud). 버지니아, 프랑크푸르트, 도쿄, 홍콩 등 다른 배포 리전에는 $1.413 / $4.24 / $0.071이 표시된다(Offloop의 리전 표).
싱가포르의 신규 종량제 계정에는 100만 토큰 무료 할당량이 안내되어 있다. 조건이 적용된다(Xenospectrum). qwen4-max-preview Token Plan 경로는 2026년 11월 25일 종료되며, 애초에 프로덕션 백엔드는 지원하지 않았다(migration notes).
Hy4 Flash의 공개 가격은 입력 / 출력 / 캐시 읽기 기준 $0.070 / $0.281 / $0.003이다. 풀 플래그십 Hy4는 $0.834 / $2.501 / $0.042로 제시된다(Tencent). 2026년 11월 30일까지 TokenHub에서는 반값 프로모션이 적용되어 실효 입력 가격이 약 $0.035였다(Tencent). 이용 가능 여부는 OpenRouter에서 확인할 수 있다. 자세한 내용: Hy4 Flash pricing.
실제 청구액을 바꾸는 세 가지 변수
첫째는 추론 토큰이다. 추론은 출력 예산을 공유하며 출력으로 과금된다. Qwen4-Max의 기본값은 131,072토큰 thinking 예산을 쓰는 high이고, xhigh와 low도 선택할 수 있다. Offloop에 요약된 Simon Willison의 OpenRouter SVG 테스트에서는 같은 프롬프트에 high가 6,362토큰, xhigh가 26,295토큰을 사용했다. 청구 대상 토큰이 4.1배 차이 난다. thinking 모드에서 max_completion_tokens를 10,000으로 설정하면 추론과 답변을 합쳐 총 10,000토큰이다.
둘째는 장황한 출력과 재시도다. Offloop를 통해 소개된 Alibaba 집계 수치에 따르면 Qwen4-Max는 벤치마크 작업당 출력 토큰이 약 105,000개다. Qwen3.8-Max의 171,000개보다 39% 줄었지만, 여전히 동급 모델 중앙값을 크게 웃돈다. 샌드박스 환경의 Reddit 벤치마크는 56개 작업을 각각 두 번 시도해 총 112회를 실행했다(thread). 여기서 Qwen4-Max Preview는 64회, DeepSeek V4.1 Flash는 61회 성공했으나 타임아웃은 각각 16회와 4회였고, 작업당 시간은 약 13분과 7분이었다. 타임아웃 뒤 재시도하면 새 요청이 한 번 더 과금된다.
"qwen의 16건 타임아웃이 64 대 61이라는 차이에 크게 작용하고 있다." — u/the_crooked_badger, r/DeepSeek thread
셋째는 캐시 재사용이다. 긴 컨텍스트를 다루는 에이전트일수록 영향이 크다. Qwen4-Max의 캐시 읽기 가격 $0.075은 일반 입력보다 95% 낮다. r/Qwen_AI thread의 한 댓글 작성자는 캐시 입력 112M, 비캐시 입력 14M을 사용했다고 전했다. Hy4 Flash의 캐시 읽기 비용 $0.003은 여기서도 25배 더 낮지만, 추론 루프가 반복되어 비용 대부분을 차지한다면 영향은 작아진다. @MarcosRGjr의 표현처럼 "토큰당 가격은 무시하라. 에이전트는 작업 단위로 과금된다"(post).
벤더의 작업당 비용 주장과 외부 지표
아래는 검증된 정면 비교가 아니라, 벤더 주장과 외부 참고 지표를 함께 놓은 것이다.
| 주장 | 수치 | 기준 |
|---|---|---|
| Alibaba Work360, Qwen4-Max vs Qwen3.8-Max (벤더 내부 수치, DataCamp 경유) | 시도 작업당 $1.67 vs $4.43 | 721개 필드 스위트, high에서 토큰 약 35% 감소 |
| AA 행을 포함한 Alibaba 차트, Qwen4-Max vs Qwen3.8-Max (벤더 집계, Offloop 경유) | 벤치마크 작업당 $3.27 vs $10.02 | xhigh, 출력 토큰 105K vs 171K |
| Tencent WorkIndex, Hy4 Flash vs 풀 Hy4 (벤더 내부 수치, Tencent 및 breakdown 경유) | 작업당 ¥0.2 vs ¥5.7 | 8개 세트 오피스 스위트 |
| Tencent 블라인드 테스트, Hy4 Flash vs Claude Haiku 5.5 (벤더 진행, Tencent 경유) | ¥0.26, 2.79/4 vs ¥4.73, 2.81/4 | 사용자 85명, 작업 259개, 6.7분 vs 6.8분 |
Work360에서 Qwen4-Max는 52.69점으로 Qwen3.8-Max의 47.74점보다 높다. Intelligence Index는 34에서 43으로 올랐지만, Kimi K3.1 Pro의 46과 Opus 5.5의 59에는 아직 못 미친다(Offloop, LLM Leaderboard).
벤더 차트에 재현된 외부 결과도 이 주장에 범위를 부여한다. LLM Leaderboard guide를 통해 소개된 Vals 제휴 테스트에서 Qwen4-Max는 테스트당 $9.33에 63.20%를 기록했고, GPT-6.1 Sol은 $3.61에 63.94%를 기록했다. Tencent의 차트에서 Terminal-Bench 4.0은 Qwen4-Max 48.5%, Hy4 Flash 19.2%, 풀 Hy4 44.4%를 보여 준다. ProgramBench는 31.5 대 16.0이다(Offloop). AutomationBench-AA에서 Qwen4-Max는 72.5%(DataCamp), Hy4 Flash의 자동화 점수는 52.2다(Tokenstrom).
성공 1건당 기대 비용은 시도 비용을 성공 확률로 나누면 된다. 예시 계산일 뿐이지만, Qwen4-Max는 $0.108 / 0.485 ≈ $0.22이고 Hy4 Flash는 $0.0053 / 0.192 ≈ $0.028이다. 약 8배 차이다. 벤치마크 성공률은 실제 프로덕션의 재시도율과 같지 않다. 이 토큰 사용량에서 Qwen4-Max가 비용만으로 이기려면 성공 가능성이 약 20배 더 높거나, 그에 상응하는 도구 호출·지연 시간·수정 비용 절감이 필요하다.
워크로드별 기본 선택, 그리고 30개 작업 재실행
| 에이전트 유형 | 권장 기본값 | 이유 |
|---|---|---|
| 난도가 높고 긴 호라이즌의 코딩·터미널 작업 | high의 Qwen4-Max | 더 높은 성공률(48.5 vs 19.2, 31.5 vs 16.0)은 실패나 수정 비용이 클 때 프리미엄을 정당화할 수 있음 |
| 슬라이드, 문서, 시트 수정, 컴퓨터 사용 등 대량 오피스 루프 | Hy4 Flash | WorkIndex 기준 ¥0.2 vs ¥5.7, Claude Haiku 5.5와 유사한 수준(2.79 vs 2.81)을 약 18분의 1 비용으로 제시 |
| 캐시 기반 파이프라인과 배치 추출 | 기본은 Hy4 Flash, 재실행에서 품질 절감 효과가 입증되면 Qwen4-Max | 문서 기준으로 캐시 읽기 $0.003 vs $0.075에 수정 비용까지 비교 |
도입을 결정하기 전, 실제 작업 30개를 두 모델에서 모두 재실행해 보자. 성공 건당 추론 토큰과 출력 토큰을 합산하고, 비용과 함께 도구 호출, 타임아웃, 수정 횟수, 중앙 처리 시간을 기록하면 된다.
FAQ
Qwen4 Max API는 100만 토큰당 얼마인가요?
QwenCloud 싱가포르 기준 입력은 $1.50, 출력은 $4.50, 캐시 읽기는 $0.075이다. 다른 리전은 $1.413 / $4.24 / $0.071로 표시된다. Hy4 Flash는 입력 $0.070, 출력 $0.281, 캐시 $0.003이다.
추론 또는 thinking 토큰도 출력으로 과금되나요?
Qwen4-Max는 thinking을 262,144토큰 공유 예산 안에서 $4.50의 출력 요금으로 과금한다. Hy4 Flash의 출력은 $0.281이므로 출력이 짧으면 청구 토큰도 줄어든다.
헤드라인의 1M이 아닌 실제 사용 가능한 컨텍스트 한도는 얼마인가요?
QwenCloud 문서상 입력은 thinking 비활성화 시 991,808토큰, 활성화 시 983,616토큰이다. 출력은 thinking 비활성화 시 131,072토큰, 합산 기준 262,144토큰이다. Tencent는 Hy4 Flash에 1M 컨텍스트를 표기한다. 안전 여유분을 남겨 두는 편이 좋다.
완료된 에이전트 작업당 비용은 Qwen4-Max와 Hy4 Flash 중 어느 쪽이 더 저렴한가요?
시도당으로는 Hy4 Flash가 약 20배 저렴하다. Tencent는 작업당 비용이 풀 Hy4의 20분의 1이며, 피크 가격 기준 DeepSeek-V4.1-Flash-1017의 8분의 1이라고 주장한다(Tencent). 위 예시 계산에서는 성공 1건당 기대 비용도 Hy4 Flash가 약 8배 낮지만, Qwen4-Max는 실패와 수정이 줄어든 효과가 토큰 가격 차이를 넘어설 때 더 유리할 수 있다.