에이전트에 도구가 수백 개라면, 매 요청마다 모든 파라미터 스키마를 프롬프트에 넣는 비용부터 부담이 됩니다. Gemini API의 Tool Retrieval는 도구 이름은 모두 유지하되, 실제 작업에 필요한 도구의 전체 스키마만 불러오는 방식입니다. 다만 검색할 때마다 모델 패스가 한 번 더 실행되므로, 거의 매 턴 도구를 검색하는 워크로드라면 절감이 아니라 비용 증가로 이어질 수 있습니다.
Google은 2026년 11월 19일, Interactions API 전용 프리뷰 기능으로 이를 공개했습니다. tool_search 도구와 defer_loading: true 플래그를 추가하는 구조입니다. 지연 로드한 도구는 이름과 설명만 컨텍스트에 남고, 파라미터 JSON은 빠집니다. 별도 이용료는 없으며 일반 입력, 캐시된 입력, 출력 요금이 적용됩니다.
도구 200개가 호출 전부터 164,000토큰을 차지하는 이유
프롬프트 비용을 결정하는 것은 단순한 도구 개수가 아니라 스키마의 크기입니다. 카탈로그가 커질수록 스키마가 프롬프트 대부분을 차지할 수 있습니다.
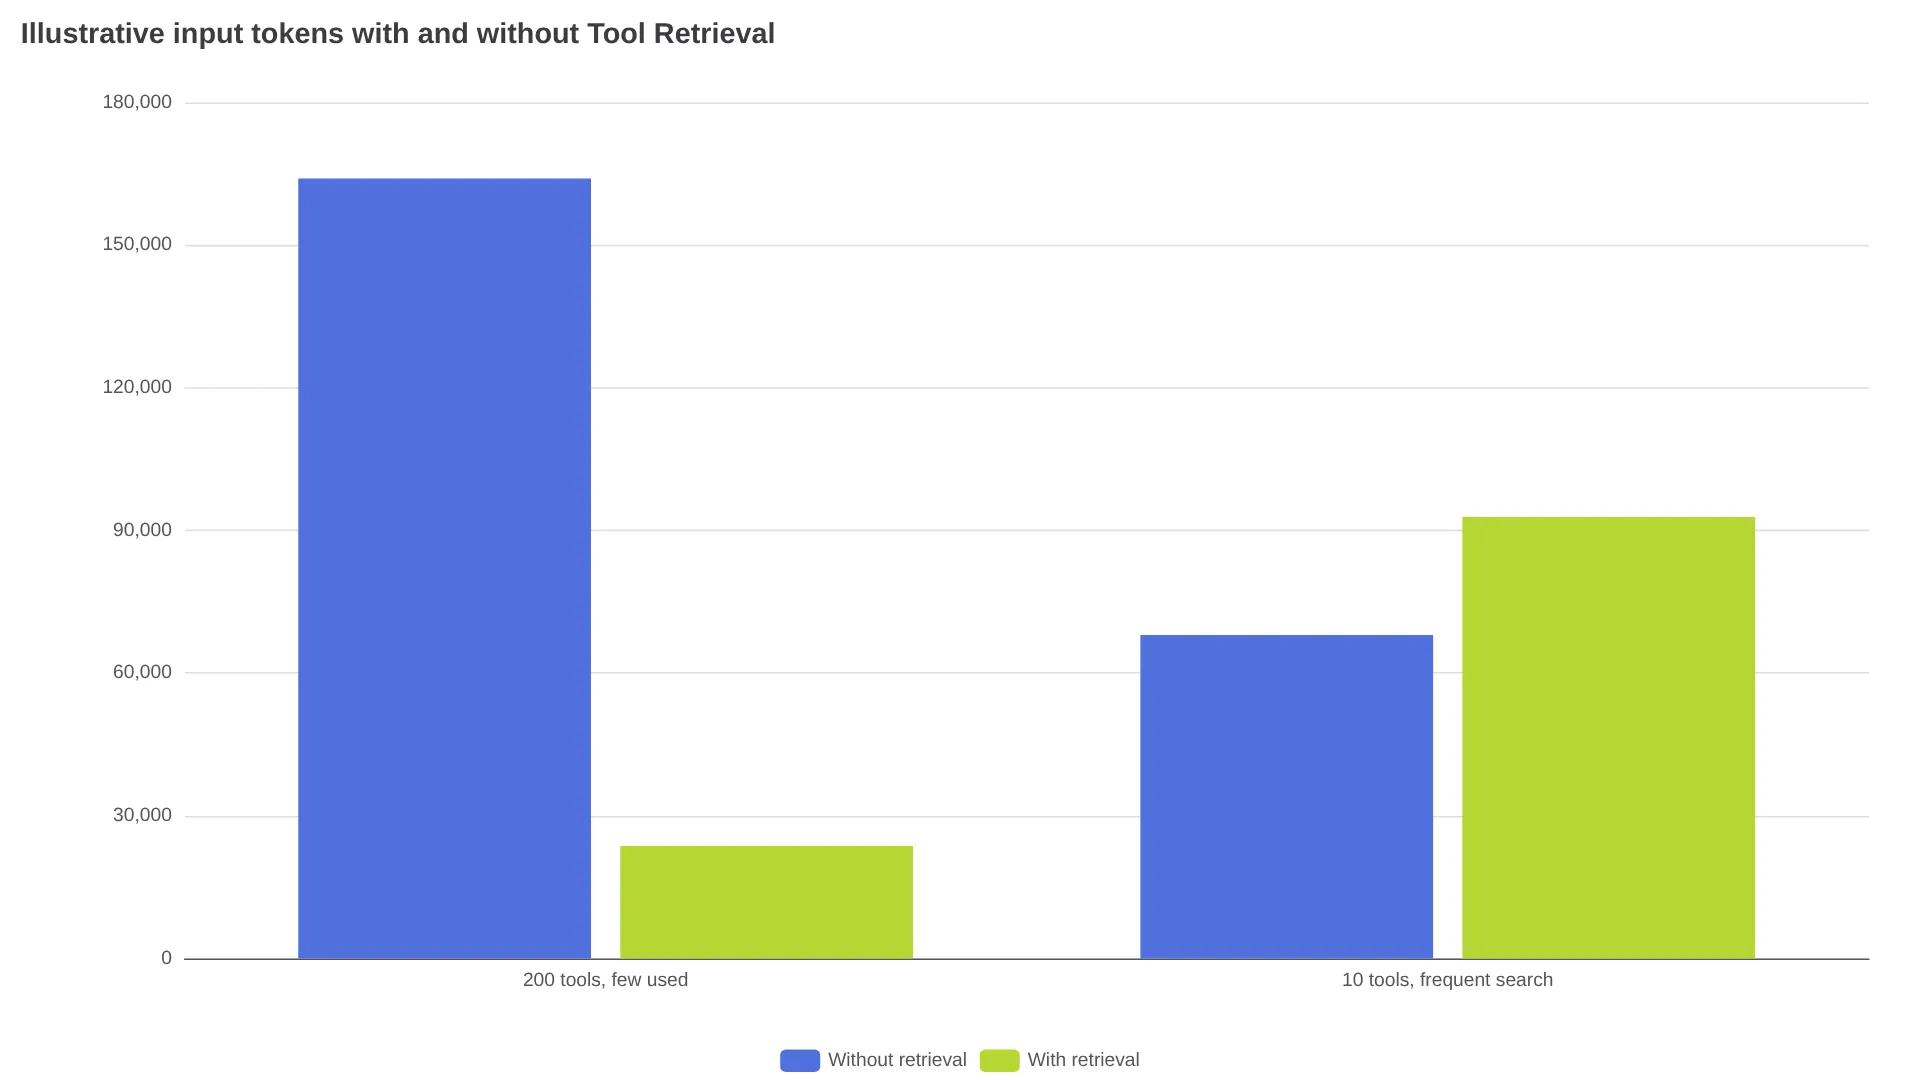
Google 문서를 분석한 독립 기술 분석은 예시로, 요청마다 몇 개 도구만 쓰는 200개 도구 라이브러리에서 지연 로드 미사용 시 약 164,000 입력 토큰, Tool Retrieval 사용 시 약 23,650토큰이라는 차이를 제시합니다. 이는 벤치마크가 아니라 해당 분석의 반올림된 설명용 수치입니다. 핵심은 쓰지 않는 스키마에 더는 비용을 내지 않아도 된다는 데 있습니다.
정확도도 문제입니다. 비슷한 스키마 수십 개가 컨텍스트 안에서 경쟁하면 모델이 잘못된 도구를 고를 여지가 늘어납니다. Google은 Tool Retrieval가 토큰 부담과 선택 정확도 모두에 도움이 된다고 설명합니다. 다만 정확도 수치는 공개되지 않았으므로, 정확도 개선은 각자의 작업에서 검증할 가설로 보는 편이 맞습니다.
Gemini Tool Retrieval의 동작 방식: tool_search와 defer_loading
설정 자체는 간단합니다. {"type": "tool_search"} 형태의 tool_search 선언을 넣고, 지연 로드할 각 도구에 "defer_loading": true를 지정합니다. 전체 요청 구조는 문서 분석에 나와 있습니다. 모델은 지연 로드 도구의 이름과 설명은 계속 볼 수 있습니다. defer_loading 해설에 따르면 short_description을 설정했다면 그것이 보이고, 그렇지 않으면 전체 설명의 첫 문장이 노출됩니다.
서버 측 흐름은 하나의 요청 안에서 끝납니다.
- 모델이 예를 들어
issue_refund를 요청하는tool_search_call을 생성합니다. - API가 전체 스키마를 담은
tool_search_result를 반환합니다. - 모델이 실제
function_call을 생성합니다. Google의 환불 예시는 모델gemini-4-hydrogen에서order_id: "A-1042",amount: 40을 사용합니다. - 애플리케이션 코드가 실행한 뒤
function_result를 반환합니다.
모든 과정은 interaction.steps에 기록하세요. 엉뚱한 도구가 로드됐다면, 먼저 트레이스에서 이름이나 설명이 지나치게 모호하지 않은지 확인하는 것이 좋습니다.
서버 측과 클라이언트 측의 차이: 요청 하나냐, 왕복 한 번이냐
| 모드 | 검색 주체 | 구축할 인덱스 | 추가 왕복 | 적합한 상황 |
|---|---|---|---|---|
| 서버 측(기본값) | Gemini | 없음 — "There's no index to build or host." | 없음, 동일 요청 내 처리 | 대부분 정적인 대규모 라이브러리, 전체 MCP 서버 |
클라이언트 측("execution": "client") | 애플리케이션 | 자체 레지스트리 또는 임베딩 인덱스 | 검색당 1회 | 사용자별 권한, 비공개 레지스트리, 대화 도중 추가되는 도구 |
서버 측 검색은 호스팅된 인덱스가 필요 없고 같은 응답 안에서 완료됩니다. 문서 분석에 따르면 mcp_server 도구에 defer_loading: true를 설정하면 그 서버가 노출하는 모든 도구가 지연 로드됩니다.
클라이언트 측에서는 "execution": "client"가 붙은 tool_search를 사용합니다. 예시에는 필수 query 문자열을 받는 search_tools라는 이름이 나옵니다. 앱이 function_result로 일치하는 도구를 반환한 다음, previous_interaction_id를 담은 client.interactions.create를 호출합니다. 같은 분석에 따르면 요청당 tool_search는 하나만 가능하며, 두 모드를 섞어 쓸 수는 없습니다.
권한이 사용자별이거나 대화 중간에 연동 도구가 나타날 수 있다면 클라이언트 측을 선택하세요. 인용한 분석에 따르면 하나의 공용 카탈로그를 대상으로 하는 서버 측 검색만으로는 사용자별 권한 필터링이 적용되지 않습니다. 또한 사전에 모든 도구를 선언하지 않고도 대화 중간에 도구를 추가할 수 있는 모드도 클라이언트 측입니다.
Gemini Tool Retrieval 비용 계산: 지금 26토큰, 나중에 전체 컨텍스트를 한 번 더
Google의 발표대로 Tool Retrieval 자체에는 별도 과금이 없습니다. "Tool Retrieval has no separate charge." 다만 토큰 비용 분석에 따르면 다음 네 가지 비용은 계속 측정됩니다.
tool_search는 매 요청에 소량의 고정 입력 토큰 블록을 더합니다.- 해당 분석은 지연 로드된 이름·설명 한 줄당 약 26토큰으로 추정합니다.
- 서버 측 검색은 현재 컨텍스트를 대상으로 모델 패스를 한 번 더 실행하며, 해당 분석에 따르면 캐시 적중분을 뺀 프롬프트 입력량에 가까운 비용이
total_tool_use_tokens로 청구됩니다. - 한 번 로드된 스키마는 이후 대화 내내 입력 토큰으로 과금되며, 다시 언로드할 수 없습니다.
| 워크로드(인용한 분석의 설명용 추정치) | 검색 미사용 | 검색 사용 | 판정 |
|---|---|---|---|
| 도구 200개, 작업당 소수만 사용 | ~164,000토큰 | ~23,650토큰 | 절감 |
| 도구 10개, 30k 컨텍스트, 거의 매 턴 검색 | ~68,000토큰 | ~92,830토큰 | 비용 증가 |
Google은 같은 발표에서 이렇게 권합니다. "Measure it against your own traffic."
"In server-side mode... every server-side search adds another model pass over the current context... So a big library where each task uses a few tools can benefit. A small library with a long conversation and frequent searches can cost more." — @tekroch
지연 로드는 캐시된 프리픽스를 안정화할 수 있지만, 반대로 프롬프트 크기를 캐시 임계값 아래로 낮출 수도 있습니다. 인용한 분석처럼 입력 토큰과 함께 캐시 적중률도 추적해야 합니다.
지연 로드가 맞는 경우와 그대로 로드할 경우
작은 라이브러리라면 우선 정적 로드를 기준으로 벤치마크하세요. 도구 개수보다 검색 빈도와 스키마 크기가 더 중요합니다. 대규모 카탈로그에서 작업당 1~3개 도구만 쓴다면, 롱테일 도구는 서버 측에서 지연 로드하고 대부분의 요청에서 쓰는 도구는 지연 로드 없이 유지하세요. 사용자별 도구나 대화 중간에 추가되는 도구에는 클라이언트 측을 사용하고, 조회당 왕복 1회를 비용과 지연 시간에 반영해야 합니다.
인용한 구현 노트는 대비해야 할 실패 사례 세 가지를 정리합니다.
- 시스템 지시문이나 다른 도구의 출력에서 이름을 언급한 도구는 지연 로드하지 마세요. 모델이 검색 없이 호출할 수 있고, 다음 턴에서 실패할 수 있습니다.
- 지연 로드 함수도 요청에 완전한
parameters가 필요합니다. 이름과 설명만 보내면 비어 있어 호출할 수 없는 스키마가 반환될 수 있습니다. - 상태를 저장하지 않는 앱이라면 매 턴
tool_search_call,tool_search_result, 서명, 전체tools배열을 변경 없이 다시 전달해야 합니다.
검색 성능은 설명의 품질이 결정합니다. 모델은 스키마를 보기 전에 이름과 설명만으로 도구를 고릅니다. "Search customer invoices by date range"는 잘 찾아내지만, "Invoice helper"는 다른 도구와 충돌하기 쉽습니다. 지연 로드는 보안 경계가 아닙니다. 보안 분석에 따르면 지연 로드된 MCP의 이름과 설명도 프롬프트 입력으로 보이며, 로드된 도구는 부여된 권한으로 실행됩니다.
프리뷰에서 아직 제공하지 않는 것
현재는 프리뷰이며 Interactions API의 v1beta 표면에서만 쓸 수 있습니다. generateContent는 지원하지 않습니다. 문서 분석에 따르면 지원하지 않는 모델에서 defer_loading을 사용하면 HTTP 400이 반환됩니다.
모델 지원 범위도 제목만 보고 넓게 해석하면 안 됩니다. 발표에서는 모든 Gemini 4 모델을 포함한 Gemini 3.6 이후를 지원한다고 했지만, 인용한 분석은 현재 라이브 문서에 gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash가 올라와 있다고 전합니다. 비슷한 이름의 모델도 당연히 지원된다고 가정하지 말고 문서에서 확인하세요. GA 일정은 발표되지 않았습니다. Anthropic은 같은 defer_loading 개념을 2025년 11월 베타로 출시했고, Google의 차별점은 서버 측 MCP 지연 로드와 클라이언트 측 모드라고 출시 보도는 설명합니다.
| 도구 라이브러리 형태 | 선택할 모드 | 첫 조치 |
|---|---|---|
| 작고 안정적 | 정적 로드 | 복잡성을 더하기 전에 스키마 토큰부터 측정 |
| 도구 50~200개, 작업당 소수만 사용 | 서버 측 지연 로드 | 롱테일은 지연 로드하고 자주 쓰는 도구는 로드 유지 |
| 사용자별 도구 또는 대화 중간 도구 | 클라이언트 측 검색 | 권한을 인식하는 검색 구축 |
| 매 턴 모든 도구 사용 | 정적 로드 | 검색 오버헤드가 절감분을 넘을 가능성이 큼 |
처음에는 롱테일의 일부만 적용하세요. 동일한 작업에서 지연 로드 적용 전후의 입력 토큰, total_tool_use_tokens, 지연 시간, 작업 성공률을 비교하면 됩니다.
FAQ
Tool Retrieval는 generateContent에서 작동하나요?
아니요. v1beta의 Interactions API에서만 사용할 수 있습니다.
어떤 모델이 지원하나요?
발표 기준으로는 Gemini 4를 포함한 Gemini 3.6 이후입니다. 다만 인용한 분석은 현재 라이브 문서의 범위가 gemini-4-hydrogen, gemini-3.6-flash 등을 포함하는 모델로 더 좁다고 전합니다. 정확한 모델은 문서에서 확인하세요.
비용이 오를 수도 있나요?
그렇습니다. 인용한 설명용 추정치에서는 검색이 거의 매 턴 발생하는 10개 도구 워크로드가 ~68,000토큰에서 ~92,830토큰으로 증가합니다.