 AIREITER
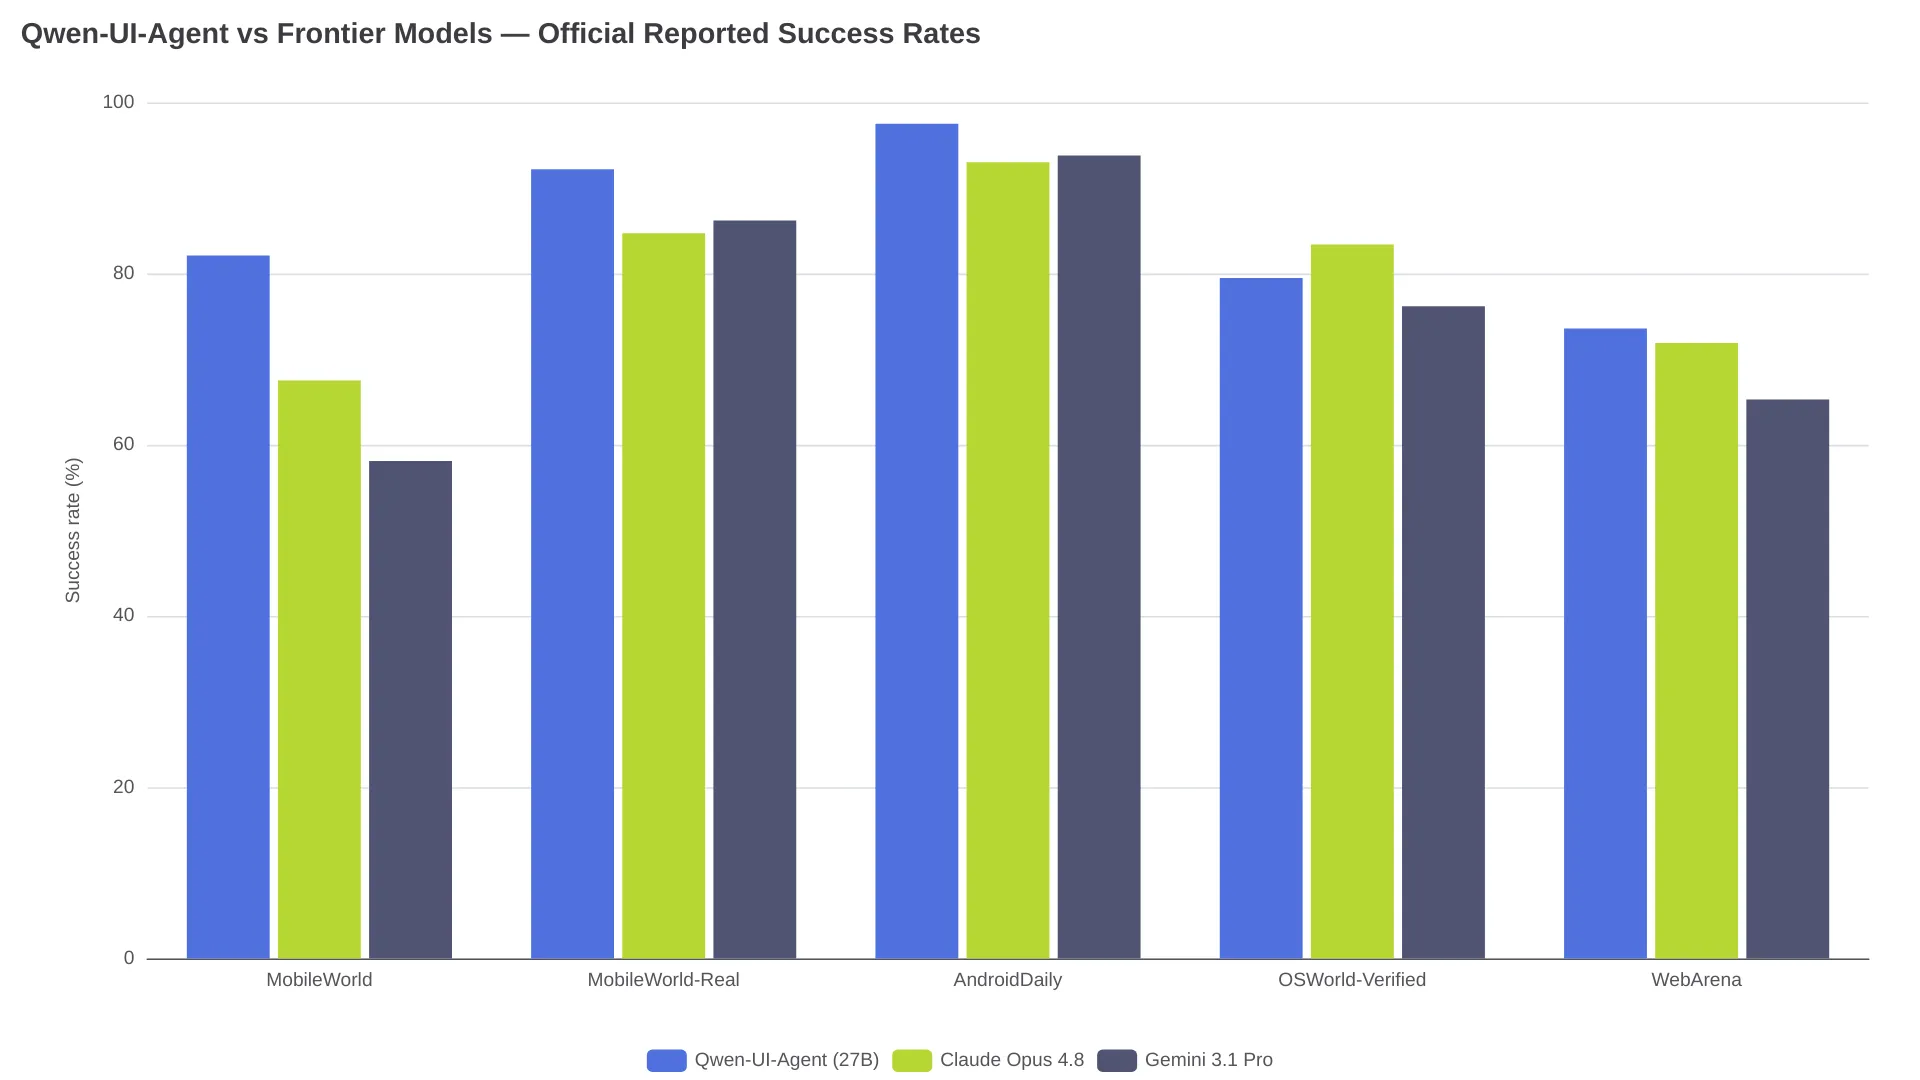
Nei confronti pubblicati da Alibaba, Qwen-UI-Agent firma i risultati più alti nell'uso da mobile: 92.2% sul test MobileWorld-Real eseguito su dispositivi fisici e 97.5% su AndroidDaily. Ma il modello 27B che ottiene questi numeri non dispone di pesi pubblici confermati né di un'API. Al momento si possono consultare il report tecnico, vedere le demo e scaricare soltanto i predecessori più piccoli della famiglia MAI-UI. È questa distanza fra risultati in classifica e disponibilità concreta a definire il rilascio: qui raccogliamo tutti i punteggi ufficiali e verifichiamo cosa sia davvero possibile usare.
Tutti i risultati ufficiali di Qwen-UI-Agent
Qwen-UI-Agent è un foundation agent per GUI pubblicato dal team Tongyi-MAI di Alibaba in un report tecnico del 30 luglio 2026 (arXiv 2607.28227). Un unico modello copre ambienti mobile, computer use, web e DeepSearch, con uno spazio d'azione unificato che comprende operazioni GUI, esecuzione CLI e sequenze di azioni in batch. Nella pagina ufficiale dei risultati, Qwen-UI-Agent guida tutti i benchmark mobile e di grounding mostrati, è secondo in OSWorld-Verified e terzo nel test a lungo orizzonte OSWorld-v2. Il report valuta varianti da 27B, 35B-A3B e 4B; i punteggi riportati sotto si riferiscono al flagship 27B.
Mobile: numeri da primato
È sul mobile che il report rivendica lo stato dell'arte, con un vantaggio tutt'altro che marginale. Nella divisione GUI-only di MobileWorld, l'82.1% di Qwen-UI-Agent supera di 8.9 punti il successivo modello generalista, Seed 2.1 Pro a 73.2%, e di 38.2 punti il miglior agent GUI specializzato, GUI-Owl-1.5-32B-Instruct a 43.9%.
| Modello | MobileWorld (solo GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
Nelle tabelle ufficiali, per le righe mobile viene usato GPT-5.6 Sol (70.1 / 85.4 / 92.6), mentre per quelle desktop compare GPT-5.5: un dettaglio da tenere presente prima di citare un singolo valore attribuito a “GPT”.
MobileWorld-Real è il benchmark di punta, nonché creato dagli stessi autori: 409 attività end-to-end su 104 app Android reali, appartenenti a sette ambiti d'uso quotidiano. I test vengono eseguiti su dispositivi fisici, con account reali e interruzioni del mondo reale; la valutazione è affidata al voto di maggioranza di cinque VLM.
Computer use: competitivo, ma non al primo posto
Sul desktop, la definizione “competitivo” usata nel report va letta con attenzione. Il 79.5% di Qwen-UI-Agent in OSWorld-Verified vale il secondo posto, a 3.9 punti da Claude Opus 4.8. Nel test a lungo orizzonte OSWorld-v2, il 40.0% misura il progresso parziale, mentre il completamento binario è 13.9%; Claude Opus 4.8, a 54.8, e GPT-5.5, a 49.5, restano entrambi nettamente sopra.
| Modello | OSWorld-Verified | OSWorld-v2 (parziale) | OSWorld-v2 (binario) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | non riportato |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | non riportato | non riportato |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | non riportato | 22.3 | non riportato |
L'aspetto dell'efficienza, però, è concreto: le azioni in batch portano la media a 135.8 passaggi per attività, contro 326.7 per MiniMax M3 e 173.5 per Qwen 3.7 Plus, superando al tempo stesso ogni modello open-weight di oltre 17 punti nel progresso parziale. In OSWorld-v2, i comandi CLI rappresentano più del 50% delle operazioni dell'agent: il design ibrido GUI+CLI produce quindi un effetto misurabile.
Browser e DeepSearch
In WebArena prevale Qwen-UI-Agent con 73.6%, davanti a Claude Opus 4.8 (71.9), GPT-5.5 (69.5) e Gemini 3.1 Pro (65.3). Sul fronte della ricerca, BrowseComp raggiunge 64.1 contro 61.0 del baseline Qwen3.5-27B, mentre BrowseComp-ZH arriva a 75.0 contro 62.1: il training DeepSearch non migliora soltanto la capacità di puntare e cliccare.
GUI grounding: primo ovunque
Nel grounding, cioè nell'individuare il pixel corretto su cui fare clic partendo da un'istruzione visiva, Qwen-UI-Agent fa tabula rasa: secondo la pagina ufficiale dei risultati, è primo in ogni benchmark di grounding mostrato.
| Benchmark | Qwen-UI-Agent | Miglior concorrente |
|---|---|---|
| ScreenSpot-Pro (senza zoom) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (zoom-in) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
Il prezzo della versatilità è contenuto
I modelli specializzati nelle GUI tendono spesso a perdere capacità da modello linguistico. Qwen-UI-Agent, in larga parte, evita questo compromesso: ottiene 86.5 in MMLU-Pro contro 86.0 di Qwen3.5-27B, e 90.2 in IFEval contro 90.4. Il distacco rispetto al campo dei modelli specializzati, invece, è enorme.
| Benchmark | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | non riportato | non riportato | non riportato |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
L'unica sconfitta visibile rispetto al proprio baseline è in QwenClawBench, 44.2 contro 48.5. Va inoltre notato che la pagina ufficiale indica questi punteggi sulle capacità più ampie come riprodotti nell'ambiente di valutazione degli autori.
Come è stato addestrato Qwen-UI-Agent
Secondo il report tecnico, i dati di training di Qwen-UI-Agent provengono da una flotta di dispositivi reali: oltre 100 telefoni fisici che coprono più di 150 app. Questi alimentano un data flywheel guidato dall'agent, capace di costruire e diagnosticare autonomamente le proprie attività. Dopo il supervised fine-tuning arriva un RL multi-stage su traiettorie che superano i 100 turni, con rollout in oltre 10.000 ambienti concorrenti.
Quanto sono affidabili questi risultati
La pagina ufficiale stessa impone tre cautele, che andrebbero riportate insieme a qualsiasi numero citato. Primo: MobileWorld-Real è un benchmark creato dagli autori. Secondo: i punteggi dei baseline segnati con un pugnale sono stati riprodotti dagli autori nel loro ambiente; harness, giudice, simulatore e sottoinsiemi delle attività possono differire dalle valutazioni ufficiali degli altri vendor. Terzo: il 40.0% di OSWorld-v2 rappresenta progresso parziale, non un tasso di successo. (Fonte: le note della pagina ufficiale dei risultati e il report tecnico.)
"Il nuovo agent GUI di Alibaba vince sugli smartphone e si blocca sul desktop." - @Daily_AI_Brief su X, che ha anche osservato: "Alibaba ha valutato ogni baseline nel proprio ambiente."
Anche letture indipendenti su X arrivano alla stessa conclusione. Un'analisi in lingua giapponese di @itarutomy evidenzia il primato mobile su dispositivi reali, sottolineando però che sul desktop i risultati restano da secondo posto. Il thread di annuncio ufficiale di Pengxiang Li del Tongyi Lab (@oliverlee1999) è la fonte primaria per il rilascio. In sintesi: MobileWorld-Real è un'affermazione forte in attesa di riproduzione indipendente, mentre OSWorld-Verified offre un confronto più trasferibile, perché non è un benchmark introdotto dagli autori.
Come accedere oggi a Qwen-UI-Agent
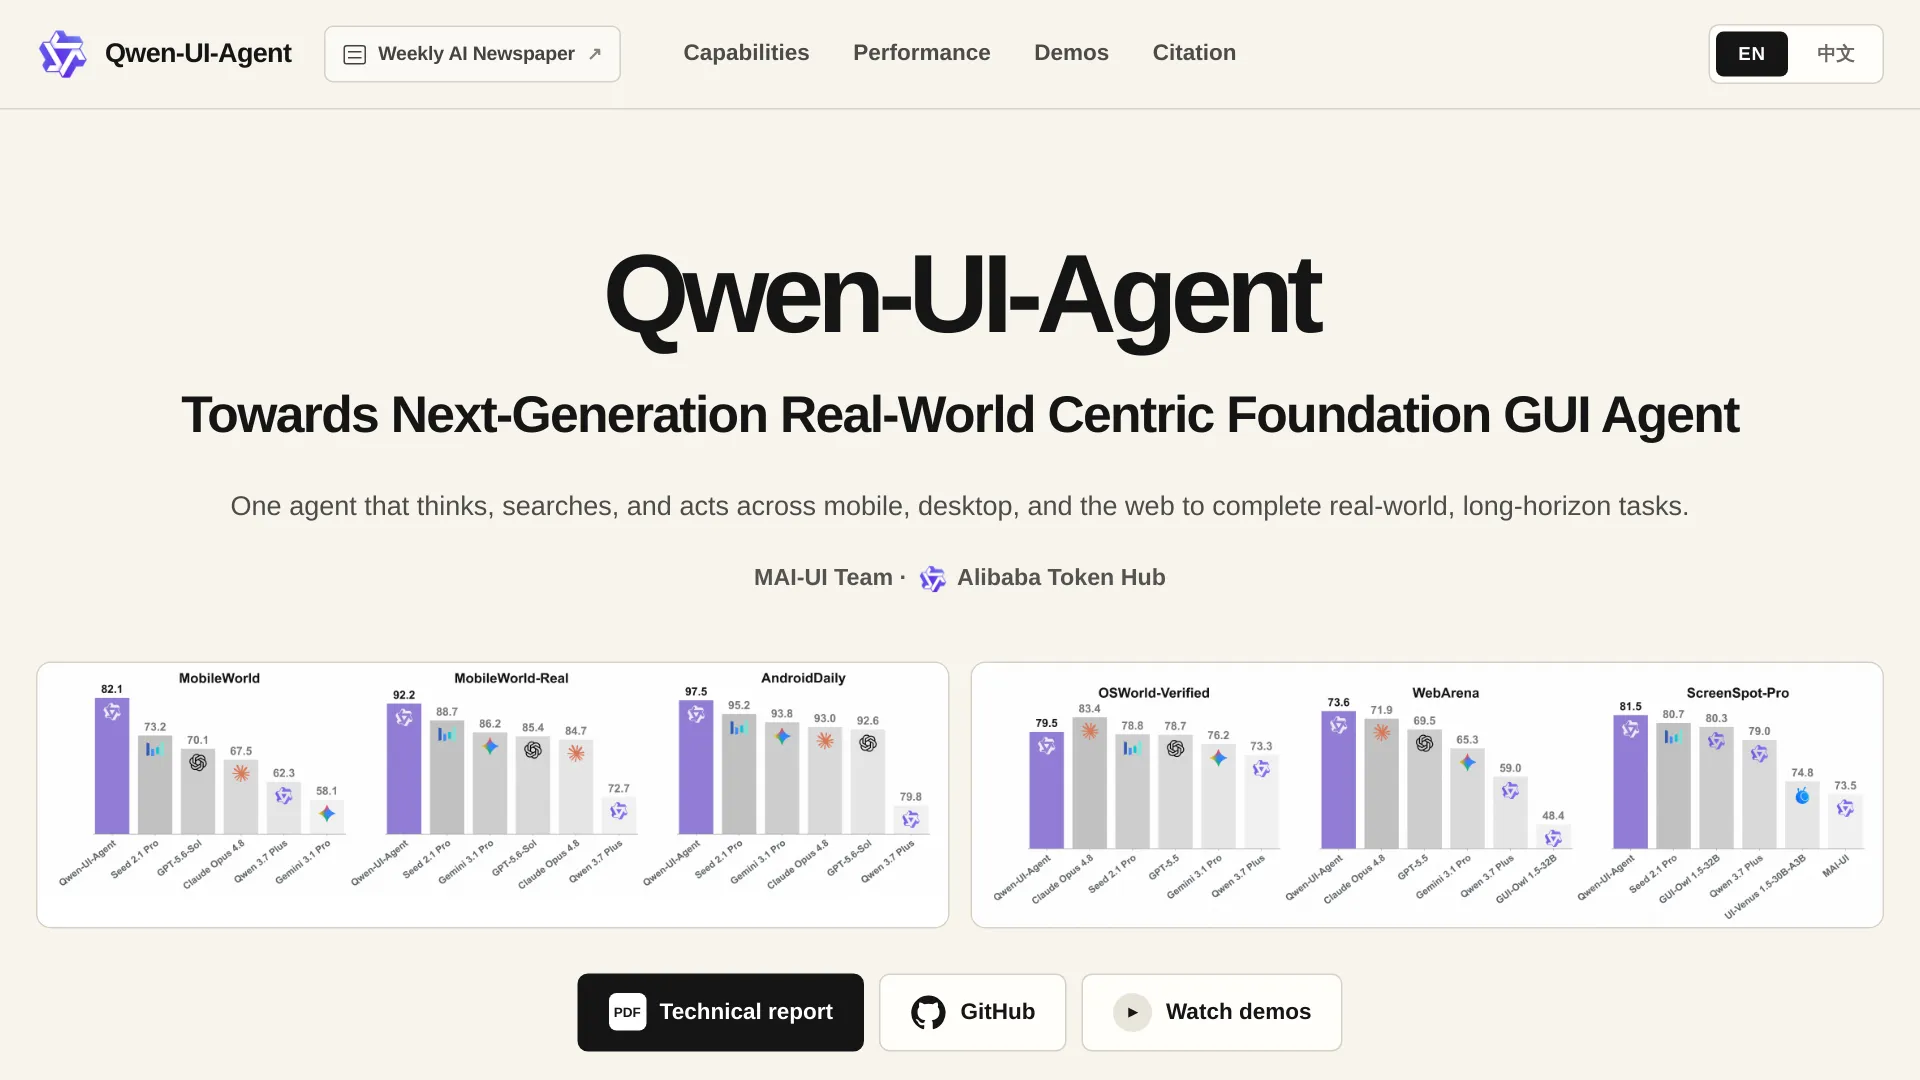
Qwen-UI-Agent è per ora un rilascio di ricerca: paper, pagina di progetto e repository di codice, ma nessun checkpoint pubblico confermato per il modello. Ecco cosa contiene ciascun artefatto pubblico.
Verifica degli artefatti disponibili
| Artefatto | Link | Cosa contiene |
|---|---|---|
| Report tecnico | arxiv.org/abs/2607.28227 | Paper completo, inviato il 30 luglio 2026; PDF, HTML e sorgente TeX |
| Pagina del progetto | tongyi-mai.github.io/Qwen-UI-Agent | Demo delle capacità, grafici completi dei benchmark, informazioni per la citazione |
| Repository MAI-UI | github.com/Tongyi-MAI/MAI-UI | Repository Apache-2.0, rinominato per Qwen-UI-Agent; collega i checkpoint Hugging Face MAI-UI-8B e MAI-UI-2B rilasciati a dicembre 2025 |
| Repository Qwen-UI-Agent | github.com/Tongyi-MAI/Qwen-UI-Agent | Solo sorgente del sito: il repository dichiara di non contenere modello, codice di training o implementazione dell'agent |
Il repository MAI-UI è la sede ufficiale che prosegue il progetto: ha annunciato Qwen-UI-Agent il 30 luglio 2026 e al momento collega gli unici checkpoint scaricabili di questa linea.
La situazione dei pesi
Gli unici checkpoint scaricabili sono MAI-UI-8B e MAI-UI-2B, predecessori del dicembre 2025, collegati nei riferimenti Hugging Face del repository MAI-UI. Non risulta pubblico alcun checkpoint Qwen-UI-Agent 27B, 35B-A3B o 4B confermato. Lo stato di disponibilità è stato verificato sulle pagine di progetto e nei repository ufficiali a fine agosto 2026, senza trovare alcun rilascio. I link ai checkpoint MAI-UI o al repository che ospita il sorgente del sito non vanno quindi scambiati per pesi del modello Qwen-UI-Agent.
Niente API né self-hosting, per ora
Nessun endpoint API pubblico, prodotto ospitato o pacchetto vLLM/Ollama di Qwen-UI-Agent compare nei canali ufficiali. Oggi le opzioni pratiche sono queste: per flussi desktop da portare in produzione, i risultati riportati in OSWorld favoriscono Claude Opus 4.8; per sperimentare con agent GUI open-weight, la strada disponibile è MAI-UI 2B/8B con un harness proprio, e si tratta di MAI-UI, non di Qwen-UI-Agent. Per gli annunci di rilascio, controllate i repository ufficiali Tongyi-MAI e i canali Qwen. Per la linea Qwen generalista, che invece ha disponibilità via API, il catalogo dei modelli Qwen di AIReiter tiene traccia di endpoint e prezzi correnti.
Dove si colloca Qwen-UI-Agent nella famiglia
Qwen-UI-Agent è la terza generazione della linea di agent GUI di Alibaba: UI-TARS ha aperto l'approccio Qwen alle GUI nel 2025; MAI-UI (arXiv 2512.22047, dicembre 2025) ha introdotto il data flywheel incentrato sul mondo reale e ha pubblicato i pesi 2B/8B; Qwen-UI-Agent porta la stessa ricetta a 27B con esecuzione ibrida GUI+CLI. Nelle tabelle sopra, Claude Opus 4.8 guida entrambe le metriche OSWorld.
FAQ su Qwen-UI-Agent
Qwen-UI-Agent è open source?
I repository di codice sono Apache-2.0 e il report è pubblico, ma per il modello non risultano pesi open-weight confermati. Sono scaricabili soltanto i checkpoint dei predecessori MAI-UI-8B e MAI-UI-2B, su Hugging Face dal dicembre 2025. Al momento della stesura, non era stato confermato alcun rilascio pubblico di checkpoint Qwen-UI-Agent 27B, 35B-A3B o 4B.
Si può eseguire Qwen-UI-Agent in locale oggi?
No: non esiste una configurazione locale verificata, né checkpoint, pacchetto GGUF o Ollama, né una procedura vLLM. Gli esperimenti locali sono limitati a MAI-UI 2B/8B con un harness proprio.
Esiste un'API per Qwen-UI-Agent?
Non è stato annunciato alcun endpoint pubblico né prodotto ospitato. Per gli annunci di rilascio, controllate i repository GitHub ufficiali di Tongyi-MAI e i canali del team Qwen.
Come si confronta Qwen-UI-Agent con Claude Opus 4.8 nel computer use?
Claude Opus 4.8 guida OSWorld-Verified per 83.4 a 79.5 e il progresso parziale OSWorld-v2 per 54.8 a 40.0. Qwen-UI-Agent è invece davanti in WebArena, 73.6 contro 71.9, e in tutti i benchmark mobile mostrati. Per il lavoro desktop a lungo orizzonte, i risultati attuali favoriscono Claude; il mobile-first è il terreno in cui i numeri riportati di Qwen-UI-Agent sono più forti.
Che cos'è MobileWorld-Real?
È un benchmark Android su dispositivi reali sviluppato dagli autori di Qwen-UI-Agent: 409 attività su 104 app attive in sette ambiti di uso quotidiano, valutate dal voto di maggioranza di cinque VLM. I risultati sono auto-riportati e attendono una riproduzione indipendente.
Cosa potrebbe cambiare la valutazione
Tre segnali modificherebbero in modo sostanziale questa analisi:
| Segnale | Perché conta |
|---|---|
| Un checkpoint Qwen-UI-Agent nella presenza Hugging Face di Tongyi-MAI | Trasformerebbe il rilascio di ricerca in un'opzione concretamente utilizzabile e attiverebbe valutazioni di terze parti |
| Una riproduzione di OSWorld-Verified al di fuori dell'harness Alibaba | Stabilirebbe se il 79.5% regge anche oltre l'ambiente degli autori |
| Qualsiasi superficie di prodotto: API, integrazione nell'app Qwen o anteprima | Sposterebbe il confronto dalle tabelle del paper ai compromessi di produzione |
Fino ad allora, il compromesso irrisolto resta questo: i primati mobile emersi dai confronti pubblicati finora sono auto-riportati e ottenuti su un benchmark costruito dallo stesso team.
Approfondimenti correlati: il nuovo flagship generalista di Alibaba e lo stato dei suoi pesi open sono trattati in Qwen3.8-Max open weights, mentre i costi degli endpoint sono disponibili nella guida ai prezzi API di Qwen3.8-Max.