 AIREITER
Dopo tre settimane di annunci "in arrivo", i pesi di Qwen3.8-2.4T-A95B sono finalmente comparsi su ModelScope il 12 agosto 2026. Il dato che colpisce è quello dei 2,4 trilioni di parametri complessivi, ma a ogni token ne vengono attivati soltanto 95 miliardi. Il problema è che, anche con quantizzazione a 4 bit, il modello occupa circa 1,2 TB di VRAM: al di fuori di un datacenter, eseguirlo in locale è un'ipotesi per pochissimi. Ecco cosa include il rilascio, quanto costa usarlo e quando l'API diventa l'unica scelta sensata.
I pesi di Qwen3.8-2.4T-A95B sono ora scaricabili
I pesi sono disponibili. Il team Qwen di Alibaba ha pubblicato il checkpoint di Qwen3.8-2.4T-A95B tramite il proprio account della community ModelScope nella tarda serata del 12 agosto, rendendolo il primo modello della fascia Qwen Max distribuito con pesi aperti. I tre precedenti modelli Qwen Max — Qwen3.5-Max, Qwen3.6-Max e Qwen3.7-Max — erano rimasti accessibili soltanto via API.
La prima distinzione da fare riguarda il nome. Con "Qwen3.8" si indicano due prodotti diversi:
| Nome | Che cos'è | Dove trovarlo |
|---|---|---|
| Qwen3.8-2.4T-A95B | Modello base con pesi aperti | ModelScope (checkpoint scaricabile) |
| Qwen3.8-Max | Versione ospitata nel cloud con funzionalità aggiuntive per la produzione | Alibaba Token Plan, Qoder, QoderWork |
Qwen3.8-Max nasce dal modello open-weight A95B, ma aggiunge una fase di post-training più avanzata. Alibaba parla di un sistema articolato in tre fasi, basato su scalabilità in ambienti reali, segnali di ricompensa unificati e bilanciamento online dei dati. I pesi aperti forniscono quindi il modello base, non l'intero stack produttivo di Max.
Le guide che definiscono i pesi "promessi ma non disponibili" sono ormai superate: il rilascio è arrivato nella finestra prevista da Alibaba, la "settimana del 10 agosto".
Specifiche confermate: 95B attivi e contesto nativo da 256K
Nelle settimane successive all'anteprima del 19 luglio, il numero di parametri attivi era la specifica mancante più richiesta. Diverse guide di terze parti lo indicavano esplicitamente come "non pubblicato". Ora il dato è ufficiale: 95 miliardi di parametri attivi per token, su 2,4 trilioni complessivi.
| Specifica | Valore confermato |
|---|---|
| Parametri totali | 2.4T |
| Parametri attivi per token | 95B |
| Architettura | MoE (evoluzione del design ibrido di Qwen3.5) |
| Esperti per livello MoE | 512 |
| Esperti instradati per token | 10 |
| Esperti condivisi per token | 1 |
| Finestra di contesto nativa | 262,144 token (256K) |
| Contesto espandibile | 1,010,000 token (1.01M) |
| Metodo di addestramento | Multi-Token Prediction (MTP) |
| Primo rilascio Qwen-Max con pesi aperti | Sì (12 agosto 2026) |
Ci sono due aspetti da tenere a mente. Il primo: la finestra di contesto nativa è di 256K, non di 1 milione di token come molti avevano ipotizzato. Il valore di 1.01M riguarda una modalità espandibile, sui cui compromessi in termini di qualità Alibaba non ha ancora fornito dettagli. Il secondo: l'instradamento MoE è estremamente sparso. A ogni token si attivano appena 11 dei 512 esperti, cioè 10 esperti instradati più 1 condiviso. È questo rapporto di attivazione di circa il 4% (95B su 2.4T) a rendere economicamente sostenibile il prezzo di $2/M in input, nonostante l'ingombro complessivo di 2.4T.
L'addestramento MTP (Multi-Token Prediction) permette agli engine di inferenza compatibili di prevedere più token con un solo forward pass, con un possibile aumento del throughput. Alibaba non ha però specificato quali engine supportino questa funzione.
Il costo reale del self-hosting di un modello da 2.4T
Le specifiche sono impressionanti finché non si prova a caricare il modello. Facciamo due conti.
Con la quantizzazione a 4 bit, 2,4 trilioni di parametri richiedono circa 1,2 TB di memoria, senza ancora considerare KV cache, memoria delle attivazioni e overhead del runtime. Una GPU NVIDIA H200 dispone di 141 GB. Otto H200 arrivano a 1.128 GB complessivi: non bastano per contenere i pesi e gestire contemporaneamente una finestra di contesto significativa.
| Scenario di distribuzione | VRAM necessaria (stima) | Hardware | È praticabile? |
|---|---|---|---|
| Precisione completa (16 bit) | ~4.8 TB | 34+ GPU H200 | Solo datacenter |
| Quantizzazione a 4 bit | ~1.2 TB | 9+ GPU H200 | Solo datacenter |
| Quantizzazione a 1.5 bit | ~450 GB | 4+ GPU H200 | Al limite; perdita di qualità incerta |
| Qwen3.8-27B (alternativa) | ~27 GB a 4 bit | 1 GPU consumer | Sì |
Il numero di parametri attivi, pari a 95B, aiuta il throughput di inferenza per token: a ogni forward pass il modello attraversa soltanto una parte dei suoi esperti. Non riduce però la memoria necessaria per conservare tutte le 512 reti di esperti. Come ha osservato GEO Toolbox: "L'attivazione sparsa rende il modello economico da eseguire su larga scala, non da possedere."
Per un'installazione locale o su un singolo server, la scelta realistica è la variante Qwen3.8-27B. Condivide la stessa linea di addestramento di Qwen3.8, ma con quantizzazione a 4 bit può funzionare su una sola GPU consumer. Il modello da 2.4T è invece pensato per la ricerca e i datacenter.
Quando conviene affidarsi all'API
Dato che il self-hosting di un modello MoE da 2.4T è fuori portata per quasi tutti i team, l'accesso pratico passa dall'API. Model Studio di Alibaba indica per Qwen3.8 Max un prezzo di $2 per milione di token in input e $6 per milione di token in output: meno del predecessore e del principale rivale cinese.
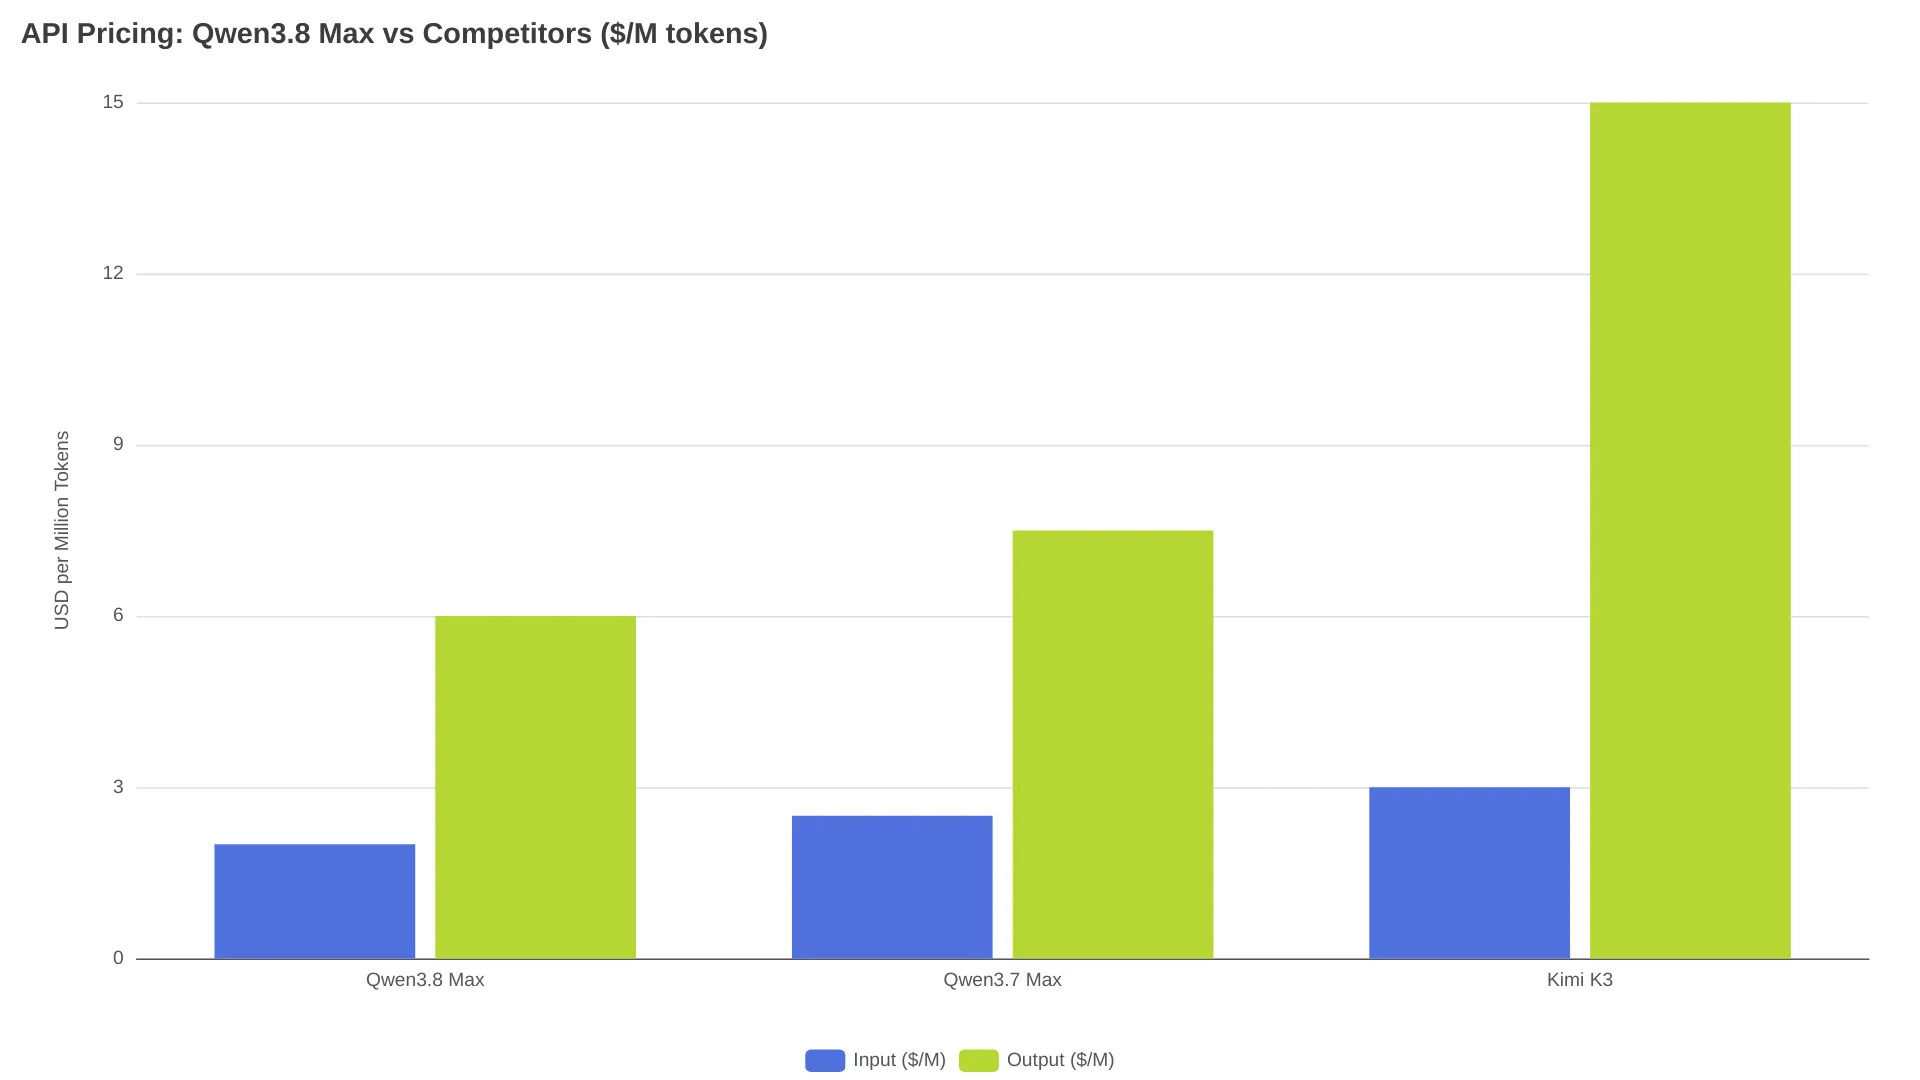
| Modello | Input ($/M) | Output ($/M) | Contesto |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K nativo (1.01M espandibile) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
Oltre all'API a consumo, Alibaba propone tre livelli di abbonamento:
- Lite: $6/mese (~10.000 crediti)
- Standard: $18/mese (~40.000 crediti)
- Pro: $68/mese (~160.000 crediti)
L'endpoint Token Plan supporta sia i formati API compatibili con OpenAI sia quelli compatibili con Anthropic. Strumenti come Claude Code, Cursor e OpenCode possono quindi funzionare senza modifiche lato client. Qoder, il prodotto di Alibaba dedicato al coding, offre durante le ore non di punta (14:00-00:00 UTC) crediti promozionali a partire da 0.01x rispetto alla tariffa standard. Si tratta però di sconti di lancio, non di prezzi destinati a durare.
Il modello in abbonamento nasconde una criticità: la modalità di ragionamento di Qwen3.8 Max è prolissa e le segnalazioni della community sul consumo rapido della quota sono numerose:
"Qwen tende a rimuginare DAVVERO TANTO." - u/darko, r/Qwen_AI
Nello stesso thread su Reddit, un abbonato Lite ha raccontato di aver esaurito la quota settimanale in meno di due giorni, usando circa 50 milioni di token. Un utente Pro ha invece consumato 500 milioni di token in un solo giorno, distribuendoli su sette agenti paralleli e con un cache hit rate del 94%. Il parametro reasoning_effort, impostabile su low, medium o xhigh, controlla direttamente la quantità di ragionamento generata dal modello e quindi la velocità con cui i crediti si esauriscono. In un test, il valore low ha ridotto il tempo di elaborazione a circa 10 secondi per richiesta.
Per un'analisi dettagliata dei costi, consulta la nostra guida ai prezzi dell'API Qwen3.8 Max.
Benchmark: dove Qwen3.8 Max convince e dove perde terreno
Alibaba ha pubblicato i benchmark di Qwen3.8 Max mettendolo a confronto con Fable 5 e GPT-5.6 Sol. Il quadro è misto e la differenza tra i risultati dichiarati dal produttore e quelli indipendenti è abbastanza ampia da essere significativa.
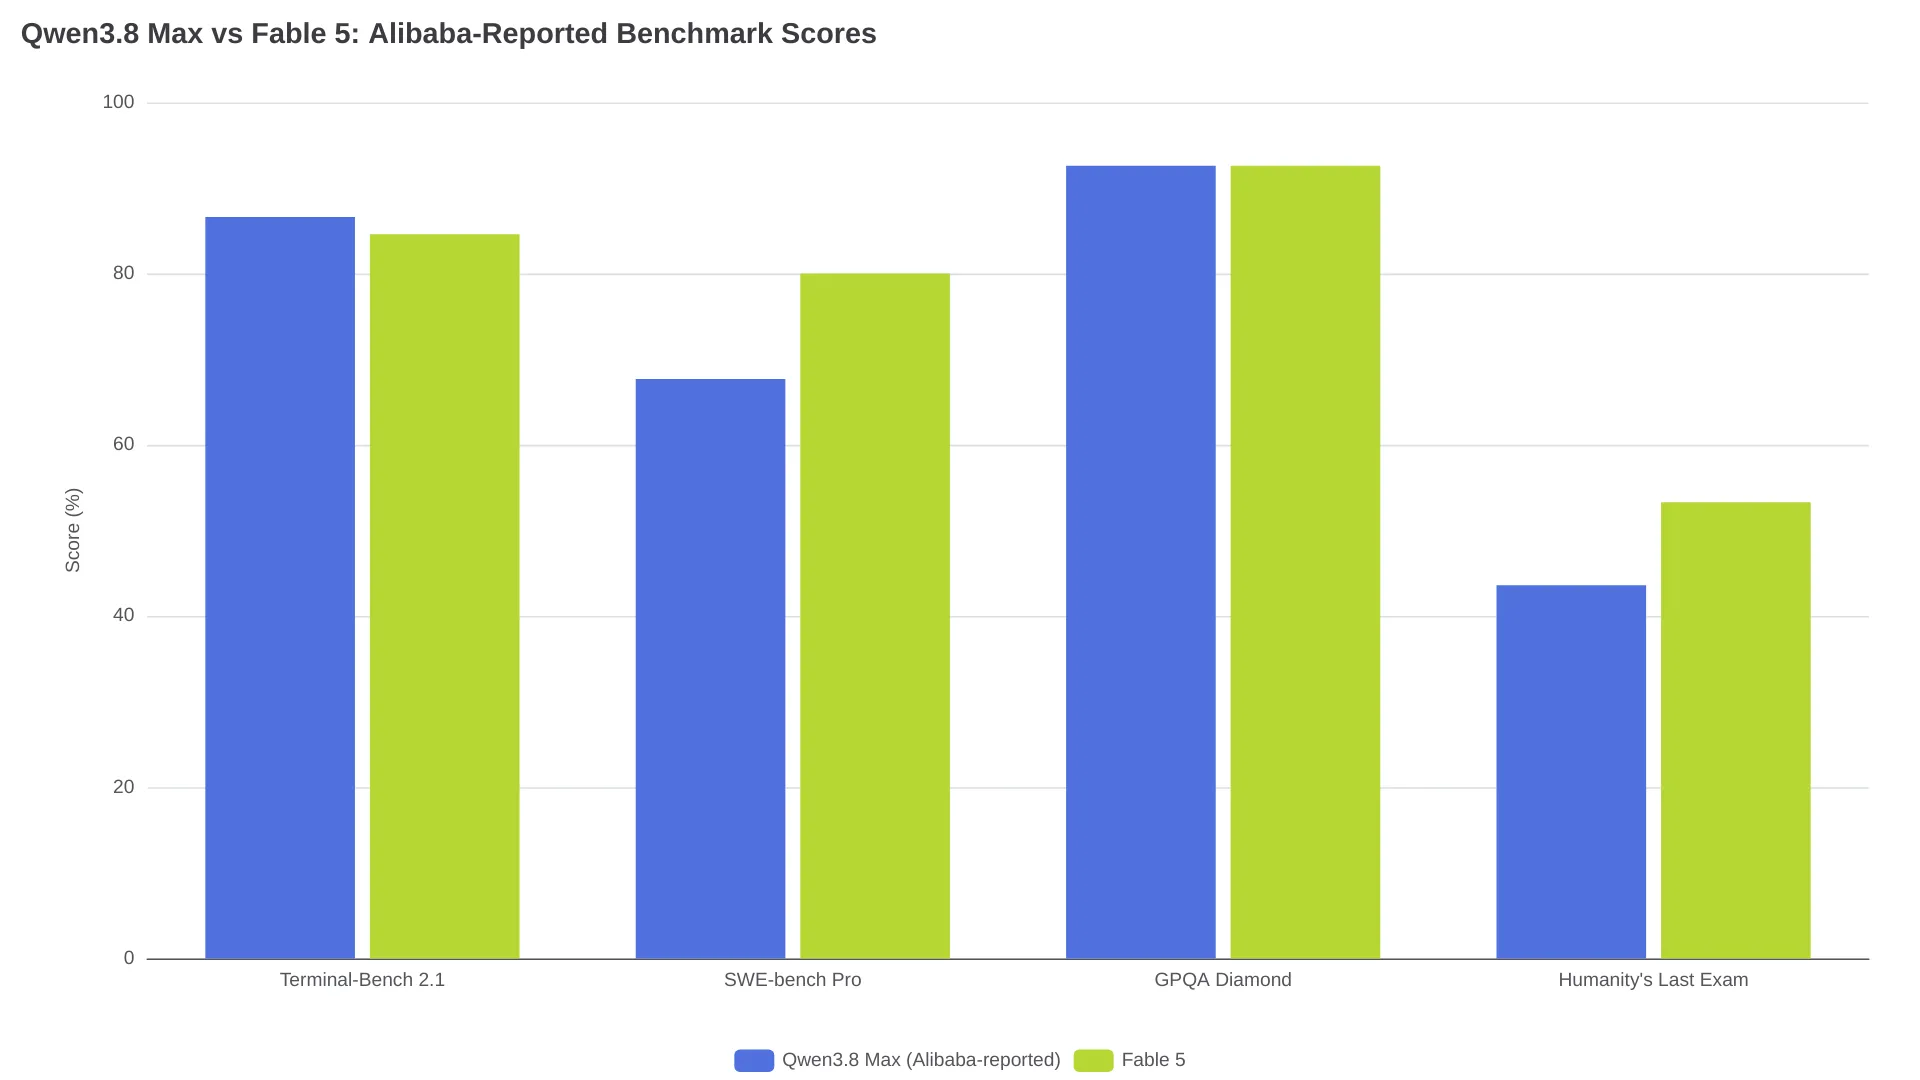
| Benchmark | Qwen3.8 Max (Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Più alto di Qwen (punteggio esatto non pubblicato) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Più alto di Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | Non pubblicato |
I test indipendenti raccontano una storia diversa. Artificial Analysis ha misurato Qwen3.8 Max all'81.3% su Terminal-Bench 2.1: 5,3 punti in meno rispetto all'86.6% dichiarato da Alibaba. Con questo risultato indipendente, Qwen si colloca all'incirca al decimo posto assoluto, dietro Fable 5 (84.6%) e Kimi K3 (85.0%).
Qwen3.8 Max mantiene invece un vantaggio su SWE-bench Pro: il 67.7% supera il 64.6% di GPT-5.6 Sol. Anche i risultati multimodali sono solidi: 95.2 contro 92.7 di Fable 5 su MathVision e 91.9 contro 85.7 su LogicVista. Inoltre, il modello è migliorato nettamente rispetto a Qwen3.7 Max su DeepSWE 1.1 (21.6 -> 56.6), un segnale di progressi concreti nei task degli agenti dedicati al software engineering.
La percezione della community riflette questa divisione. Nello stesso thread Reddit in cui si criticava la tendenza a ragionare troppo, si legge anche:
"L'output, però, era di livello divino." - u/TangerineLogical9779, r/Qwen_AI
A quanto riportato, anche la velocità è instabile: da 8 token/sec a 60 token/sec, in base al carico e all'ora del giorno. Per un confronto diretto con Kimi K3, consulta la nostra comparativa tra Qwen3.8 Max e Kimi K3.
FAQ
È possibile scaricare i pesi di Qwen3.8-Max?
Sì. Alibaba ha pubblicato il checkpoint Qwen3.8-2.4T-A95B su ModelScope il 12 agosto 2026. È il primo modello della fascia Qwen-Max distribuito con pesi aperti. La versione cloud Qwen3.8-Max include funzionalità aggiuntive per la produzione costruite sopra questo modello base.
Quale licenza usano i pesi aperti?
Al momento della pubblicazione, la licenza esatta non è stata confermata. I precedenti fanno pensare ad Apache 2.0 — Qwen3.6 era distribuito con questa licenza — ma Qwen3.7 Max è rimasto chiuso. Prima di avviare un progetto commerciale, conviene leggere il file della licenza direttamente nel repository ModelScope.
Che differenza c'è tra Qwen3.8-2.4T-A95B e Qwen3.8-Max?
Qwen3.8-2.4T-A95B è il modello base con pesi aperti: 2.4T parametri, 95B attivi, architettura MoE e contesto nativo da 256K. Qwen3.8-Max è la versione cloud di Alibaba, costruita su questo modello e arricchita da un post-training pensato per gli ambienti produttivi, con sistemi di ricompensa unificati e bilanciamento online dei dati. I pesi aperti danno accesso alla base; l'API alla versione potenziata.
Posso eseguire Qwen3.8-Max in locale?
Non in modo pratico. Con quantizzazione a 4 bit servono circa 1,2 TB di VRAM: almeno nove GPU H200 soltanto per i pesi, senza spazio per la cache del contesto. Anche scendendo a 1.5 bit restano necessarie centinaia di gigabyte. La variante Qwen3.8-27B è l'alternativa locale realistica e può funzionare su una singola GPU consumer.
Quanto costa l'API di Qwen3.8 Max?
L'API Model Studio costa $2 per milione di token in input e $6 per milione di token in output. Gli abbonamenti partono da $6/mese con il piano Lite e arrivano a $68/mese con il piano Pro. Durante le ore non di punta, Qoder offre sconti promozionali sui crediti fino al 98%, ma si tratta di prezzi di lancio che potrebbero cambiare.