 AIREITER
Dal 16 agosto 2026 alle 16:00 UTC, usare DeepSeek V4 Pro via API costerà sensibilmente di più nelle fasce di punta. Il nuovo modello GA, lanciato ufficialmente il 13 agosto 2026, porta benchmark completi, pesi aperti con licenza MIT e tre livelli di effort per il ragionamento. Per chi integra l'API, però, il punto cruciale è un altro: la pagina prezzi ufficiale conferma la tariffazione differenziata, con l'output V4 Pro che passa da $0.87 a $1.98/M fuori punta oppure $3.96/M in fascia di punta.
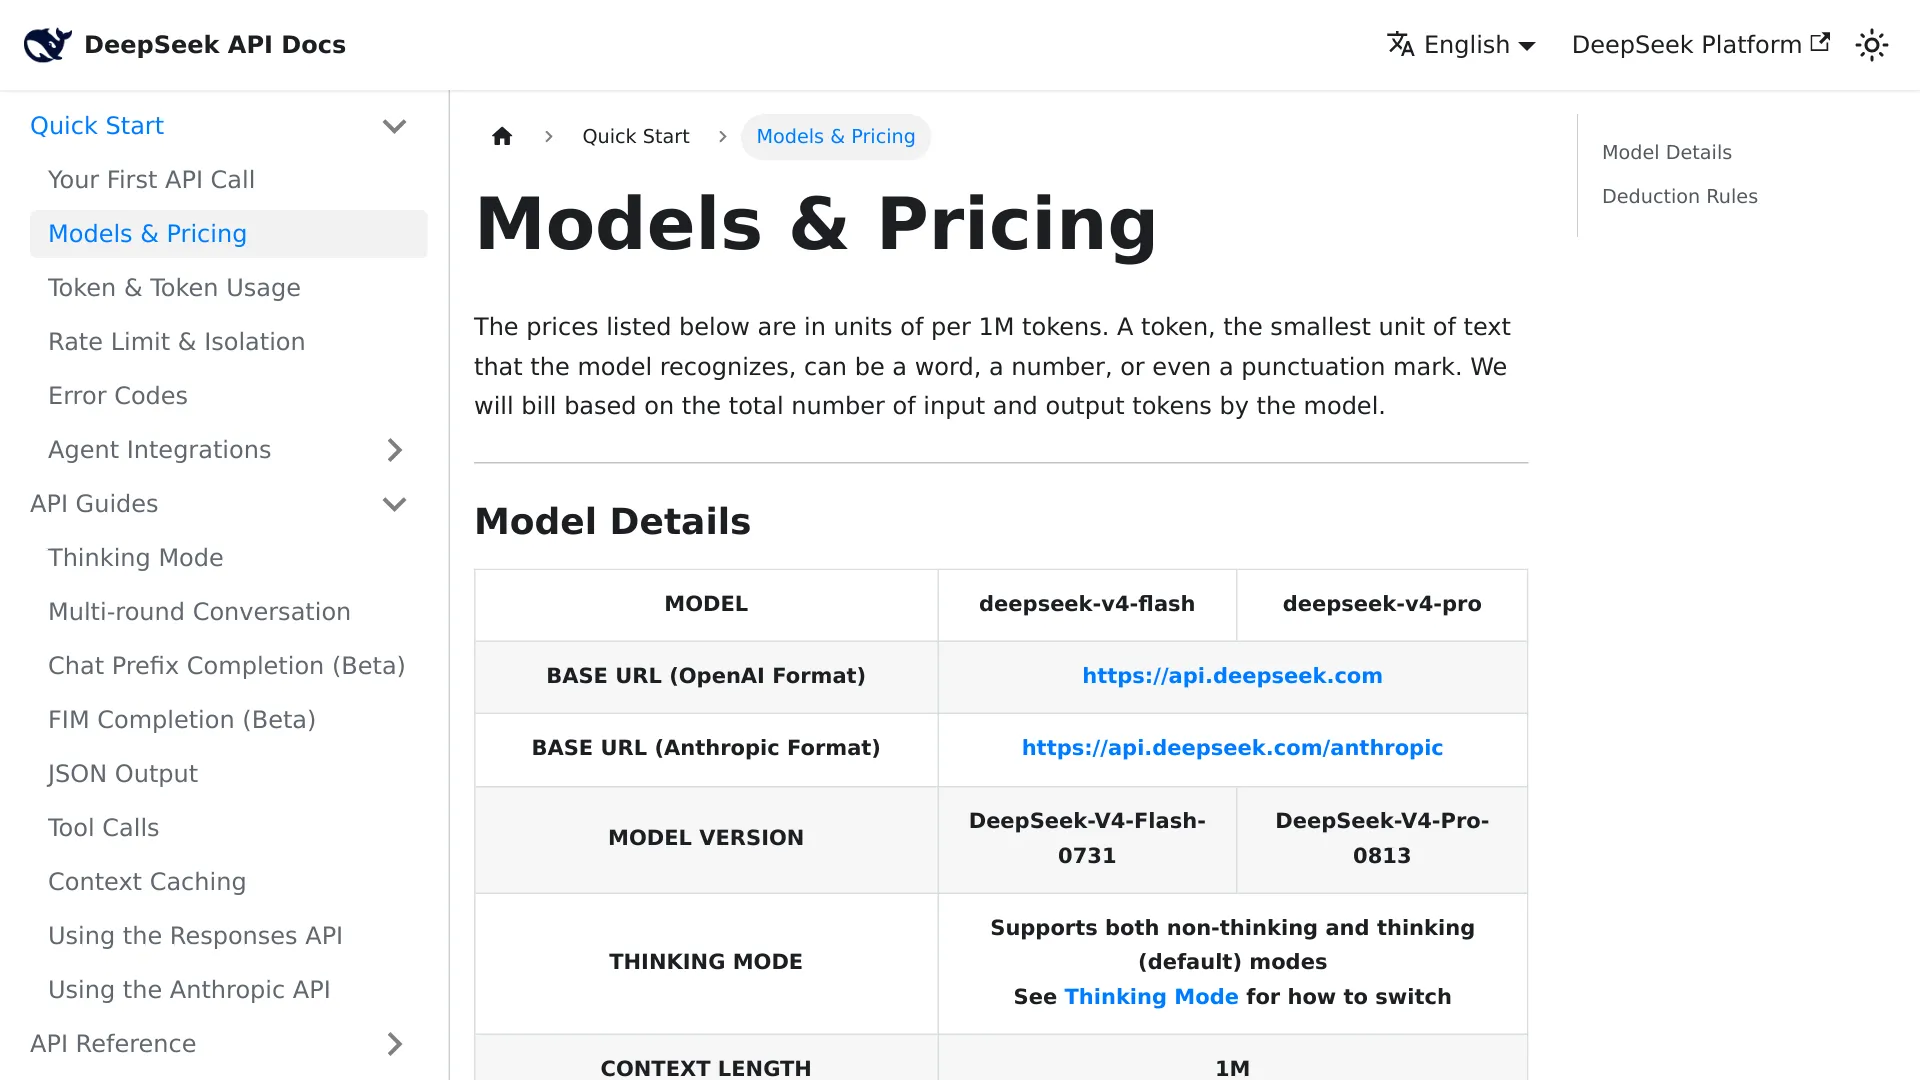
DeepSeek-V4-Pro-0813: cosa cambia con la release GA
L'alias API deepseek-v4-pro punta ora a DeepSeek-V4-Pro-0813, disponibile nell'app DeepSeek, sul web e via API. DeepSeek ha annunciato il rilascio il 13 agosto, parlando di capacità Agent "significativamente migliorate" rispetto alla build preview del 24 aprile.
Architettura e specifiche:
| Voce | DeepSeek-V4-Pro-0813 |
|---|---|
| Dimensione del modello pubblicata | 1.7T parametri (model card; la preview era da 1.6T) |
| Lunghezza del contesto | 1 milione di token |
| Output massimo | 384K token |
| Modalità di thinking | Non-thinking e thinking (thinking predefinita) |
| Livelli di effort per il ragionamento | low, high, max |
| Nuovo modulo di decoding | Decoding speculativo DSpark (7 token speculativi) |
| Compatibilità API | OpenAI ChatCompletions, Responses API, Anthropic API, Codex |
| Limite di concorrenza | 500 |
| Licenza | MIT |
La model card consiglia temperature = 1.0 e top_p = 0.95 per gli scenari agentici. Con effort high e max, la lunghezza massima dell'output è di 384K token.
I benchmark ufficiali della GA
DeepSeek ha pubblicato dieci confronti benchmark nella model card. Per i compiti da code agent è stato usato DeepSeek Harness in modalità minimal, con effort di ragionamento max. Le ultime due righe, DSBench, corrispondono a set di test interni di DeepSeek. Tutti i punteggi riportati qui sotto provengono dalla model card.
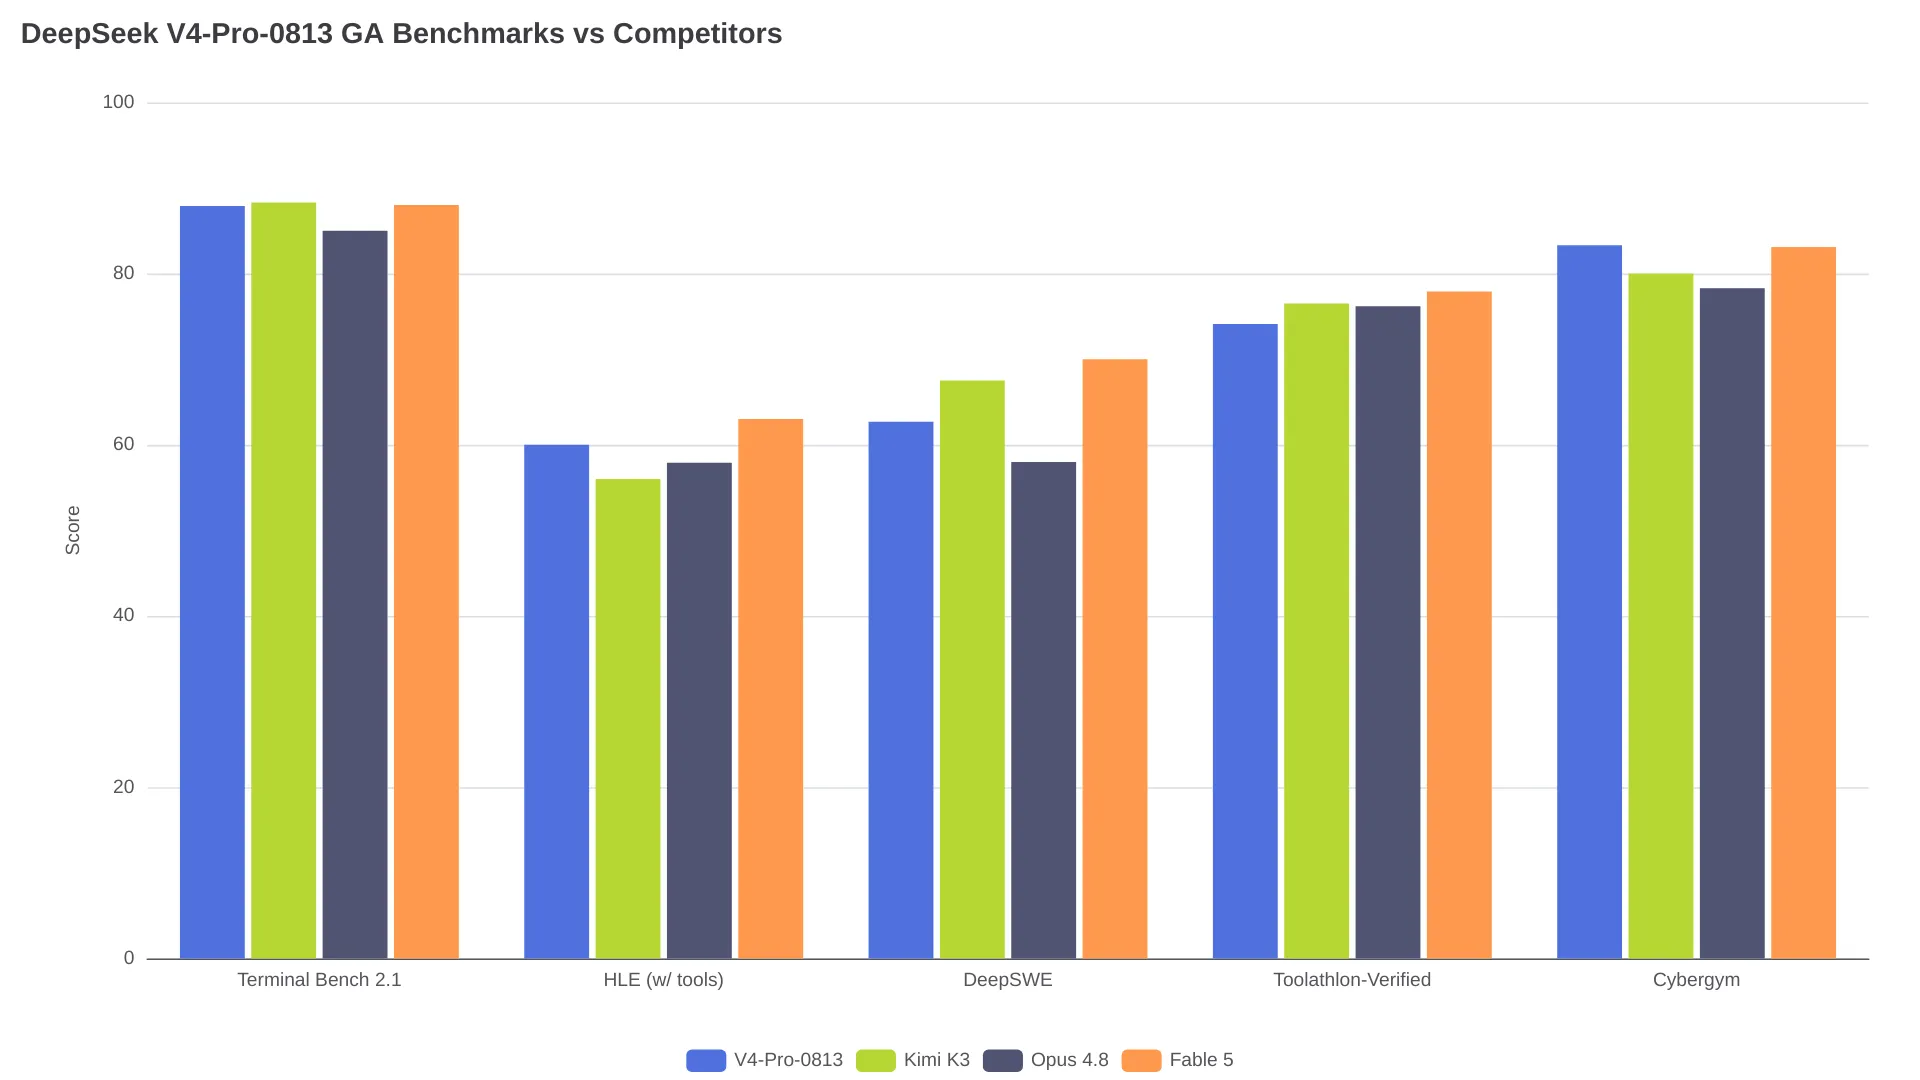
| Benchmark | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE (senza tool / con tool) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench (pubblico) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack (interno) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard (interno) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
Il salto rispetto alla preview è netto: DeepSWE passa da 12.8 a 62.7, mentre AutomationBench sale da 12.8 a 31.8. Nel confronto con i concorrenti, Pro-0813 guida HLE con tool, con 60.0 contro il 56.0 di Kimi K3 e il 57.9 di Opus 4.8, ma resta dietro a Kimi K3 e Fable 5 in DeepSWE, Terminal Bench e Toolathlon-Verified. Le due righe DSBench si basano su benchmark interni al fornitore e non andrebbero considerate allo stesso modo di benchmark gestiti in modo indipendente.
Pesi aperti
I pesi 0813 sono disponibili su Hugging Face con licenza MIT, insieme ai percorsi di deployment per vLLM e SGLang. La model card include un esempio di serving vLLM che usa decoding speculativo DSpark, cache KV FP8 e un singolo nodo 4x GB300.
"Ampiamente competitivo con i più forti modelli proprietari disponibili." — model card DeepSeek V4-Pro, Hugging Face
Prezzi API: tariffe attuali e nuove fasce dal 16 agosto
La pagina dei prezzi riporta sia una tariffa fissa attuale sia una tariffa programmata per fasce di punta e fuori punta, in vigore dal 16 agosto 2026 alle 16:00 UTC. Le fasce di punta sono 01:00–04:00 UTC e 06:00–10:00 UTC, ovvero 09:00–12:00 e 14:00–18:00 a Pechino. Tutte le altre ore sono fuori punta. La tariffa fuori punta è esattamente la metà di quella di punta.
DeepSeek V4 Pro (DeepSeek-V4-Pro-0813)
| Categoria di fatturazione | Tariffa fissa attuale | Fuori punta (16 ago) | Punta (16 ago) | Variazione in punta |
|---|---|---|---|---|
| Input, cache hit | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| Input, cache miss | $0.435/M | $0.66/M | $1.32/M | +203% |
| Output | $0.87/M | $1.98/M | $3.96/M | +355% |
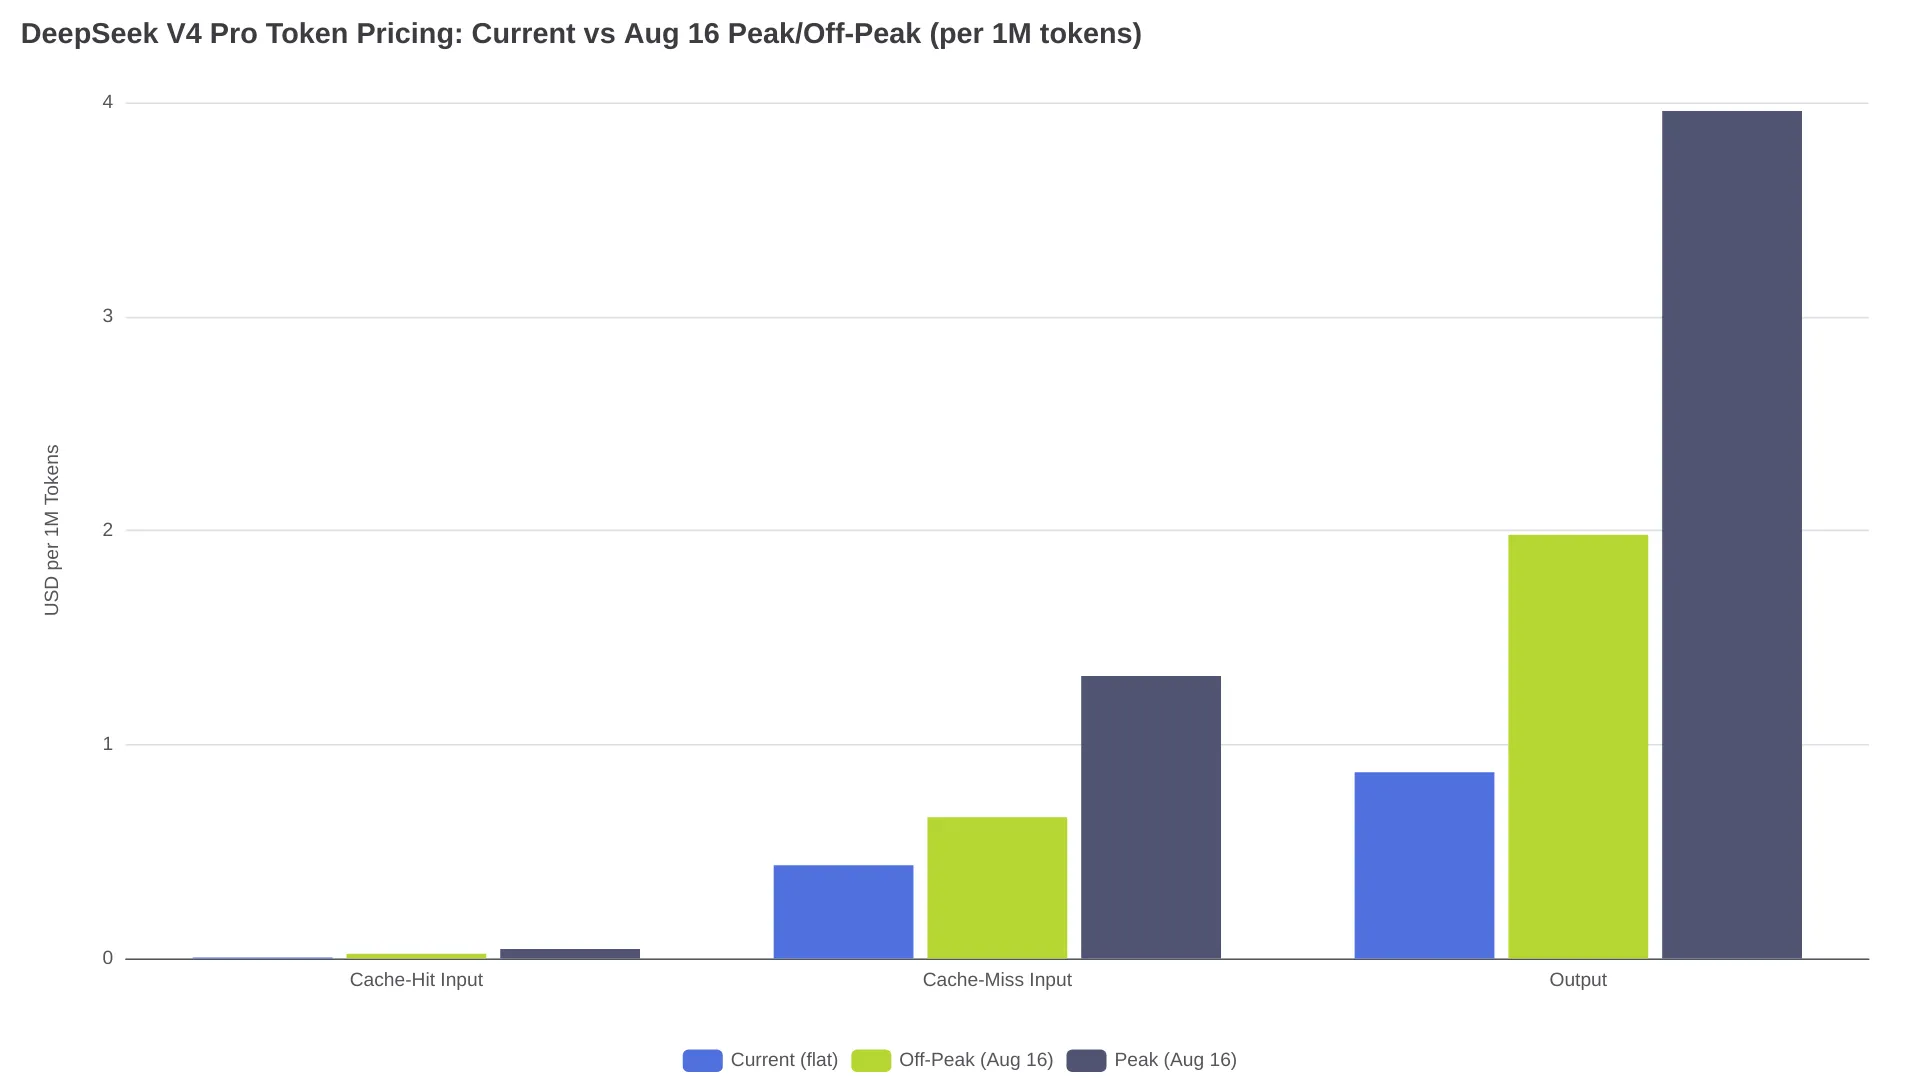
L'output in fascia di punta aumenta di 4.6x. Per i workflow agentici in produzione, l'impatto maggiore riguarda però la cache: il precedente prezzo di $0.003625/M per cache hit era circa 120x inferiore al cache miss. Dopo il 16 agosto, il rapporto scende a 30x in entrambe le fasce, 0.022 contro 0.66 fuori punta e 0.044 contro 1.32 in punta; al tempo stesso, il costo assoluto del cache hit cresce da 6x a 12x.
DeepSeek V4 Flash (DeepSeek-V4-Flash-0731)
| Categoria di fatturazione | Tariffa fissa attuale | Fuori punta (16 ago) | Punta (16 ago) | Variazione in punta |
|---|---|---|---|---|
| Input, cache hit | $0.0028/M | $0.007/M | $0.014/M | +400% |
| Input, cache miss | $0.14/M | $0.22/M | $0.44/M | +214% |
| Output | $0.28/M | $0.66/M | $1.32/M | +371% |
Limite di concorrenza: 2,500 richieste simultanee, cinque volte l'allocazione di Pro.
Orari di punta nei principali fusi orari
| Fuso orario | Prima fascia di punta | Seconda fascia di punta |
|---|---|---|
| Pechino (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| Londra (UTC+1) | 02:00–05:00 | 07:00–11:00 |
| New York (UTC-4) | 21:00–00:00 (giorno precedente) | 02:00–06:00 |
| San Francisco (UTC-7) | 18:00–21:00 | 23:00–03:00 |
Per i team negli Stati Uniti, le fasce di punta ricadono soprattutto nelle ore serali e notturne. In Cina e nell'Asia orientale, invece, coincidono con i normali orari lavorativi.
Quanto costa Pro con 10.000 chiamate al giorno
Prendiamo un agent in produzione che, a ogni chiamata, invia un prefisso in cache da 50K token e riceve una risposta da 2K token.
| Voce di costo | Tariffa fissa attuale | Fuori punta | Punta |
|---|---|---|---|
| Input cache hit (500M token) | $1.81 | $11.00 | $22.00 |
| Output (20M token) | $17.40 | $39.60 | $79.20 |
| Totale giornaliero | $19.21 | $50.60 | $101.20 |
| Totale per 30 giorni | $576 | $1,518 | $3,036 |
I carichi reali combinano chiamate in punta e fuori punta, quindi il costo finale si collocherà tra questi due estremi. Lo stesso workload su Flash costa $7.00/giorno alle attuali tariffe fisse, ~$16.70/giorno fuori punta e ~$33.40/giorno in punta. Flash in punta, $33.40/giorno, supera la tariffa fissa attuale di Pro, $19.21/giorno; Flash fuori punta, $16.70/giorno, resta invece al di sotto.
Migrazione API: ID modello, controllo del ragionamento e version pinning
Endpoint ritirati e ID sostitutivi
L'annuncio della preview del 24 aprile indicava che deepseek-chat e deepseek-reasoner sarebbero stati "completamente ritirati e inaccessibili dopo il 24 luglio 2026, 15:59 (UTC Time)." Il codice che fa riferimento a queste stringhe va aggiornato.
| Endpoint precedente | Modello a cui puntava | Sostituzione |
|---|---|---|
deepseek-chat | V4 Flash, non-thinking | deepseek-v4-flash |
deepseek-reasoner | V4 Flash, thinking | deepseek-v4-flash (thinking) oppure deepseek-v4-pro |
Molti team hanno dato per scontato che deepseek-reasoner offrisse un ragionamento di livello Pro. In realtà puntava a Flash in modalità thinking. La migrazione a deepseek-v4-pro comporta una qualità di output diversa e una fattura più elevata.
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
La base URL rimane https://api.deepseek.com. La struttura delle richieste non richiede altre modifiche.
Livelli di effort per il ragionamento
V4-Pro-0813 introduce tre livelli di effort: low per le attività semplici, high per il lavoro agentico quotidiano e max per i problemi complessi. La modalità thinking è attiva per impostazione predefinita e i token di thinking rientrano nella fatturazione dell'output. Un prompt che genera 3.000 token di thinking prima di una risposta da 200 token viene fatturato per 3.200 token di output in fascia di punta: $0.0127 per chiamata, contro $0.0008 della sola risposta. DeepSeek indica low per le attività semplici, dove un ragionamento prolungato aggiunge costi senza apportare valore.
Version pinning
L'alias deepseek-v4-pro punta alla build corrente e potrebbe aggiornarsi quando DeepSeek rilascerà versioni future. Se occorre un comportamento riproducibile in produzione, verificate se il provider supporta identificatori di modello datati. Alcuni gateway di terze parti offrono route bloccate a una specifica versione: prima di usarle in produzione, consultate la documentazione del provider per verificare quale build serva ogni route.
Compatibilità con i protocolli API
Entrambi i modelli supportano i formati OpenAI ChatCompletions e Anthropic API. L'endpoint Anthropic è https://api.deepseek.com/anthropic. La compatibilità con Responses API e Codex è una novità della build GA. Se incontrate errori dopo la migrazione, testate entrambi i percorsi di protocollo.
Pro o Flash dopo l'aumento dei prezzi?
V4-Pro-0813 supera V4-Flash-0731 in tutte e dieci le metriche pubblicate. Il margine, tuttavia, varia in base alla complessità del compito:
| Benchmark | Pro 0813 | Flash 0731 | Scarto |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 pt |
| DeepSWE | 62.7 | 54.4 | 8.3 pt |
| AutomationBench | 31.8 | 25.1 | 6.7 pt |
| Cybergym | 83.3 | 76.7 | 6.6 pt |
Scegli V4 Pro se:
- Il loop del tuo agent invia ripetutamente un prefisso grande e stabile. Il risparmio da cache hit resta valido, pur su una base di prezzo più alta
- Ti serve il maggior numero di parametri di Pro per ragionamento complesso, uso di tool in più passaggi o generazione di codice su larga scala
- Il tuo workload rientra nel limite di 500 richieste simultanee
Scegli V4 Flash se:
- I tuoi task sono semplici, ad alto volume o sensibili alla latenza
- Per workload con fan-out ti serve il limite di 2,500 richieste simultanee
- La differenza di qualità non giustifica un prezzo dell'output 3x superiore
Per un confronto più ampio tra i due modelli, consulta il nostro confronto DeepSeek V4 Flash vs Pro. Per provare i modelli senza gestire chiavi API, la pagina chat di V4 Pro e la pagina chat di V4 Flash offrono accesso immediato.
FAQ
I pesi di V4-Pro-0813 sono disponibili per il self-hosting?
Sì: sono distribuiti con licenza MIT su Hugging Face, con percorsi per vLLM e SGLang. Per i dettagli di deployment, vedi la sezione sui pesi aperti sopra.
Conviene passare da V4 Flash a V4 Pro con la GA?
Per la maggior parte dei workload sensibili ai costi, Flash resta la scelta dal miglior rapporto qualità-prezzo. Nei benchmark è dietro a Pro con scarti che vanno da 0.5 punti, in Agents' Last Exam, a 8.5 punti, in HLE con tool, ma l'output costa 3x meno. Il passaggio a Pro ha senso se il workload richiede l'intero numero di parametri per ragionamento complesso in più passaggi o generazione di codice su larga scala.
Come ridurre l'impatto dell'aumento dei prezzi?
Ci sono tre leve: pianificare job batch e agent differibili fuori dalle ore di punta, 01:00–04:00 e 06:00–10:00 UTC; massimizzare i cache hit mantenendo stabili i prefissi dei prompt; instradare i task semplici a Flash oppure usare effort di ragionamento low su Pro.
La tariffazione di punta e fuori punta vale anche per app e sito web di DeepSeek?
La pagina ufficiale dei prezzi documenta esclusivamente la fatturazione API a token. Il calendario indicato si applica alle chiamate API dirette; i gateway provider possono trasferirlo, applicare un markup o adottare tariffe diverse. Per i dettagli aggiornati, consulta la pagina prezzi.