 AIREITER
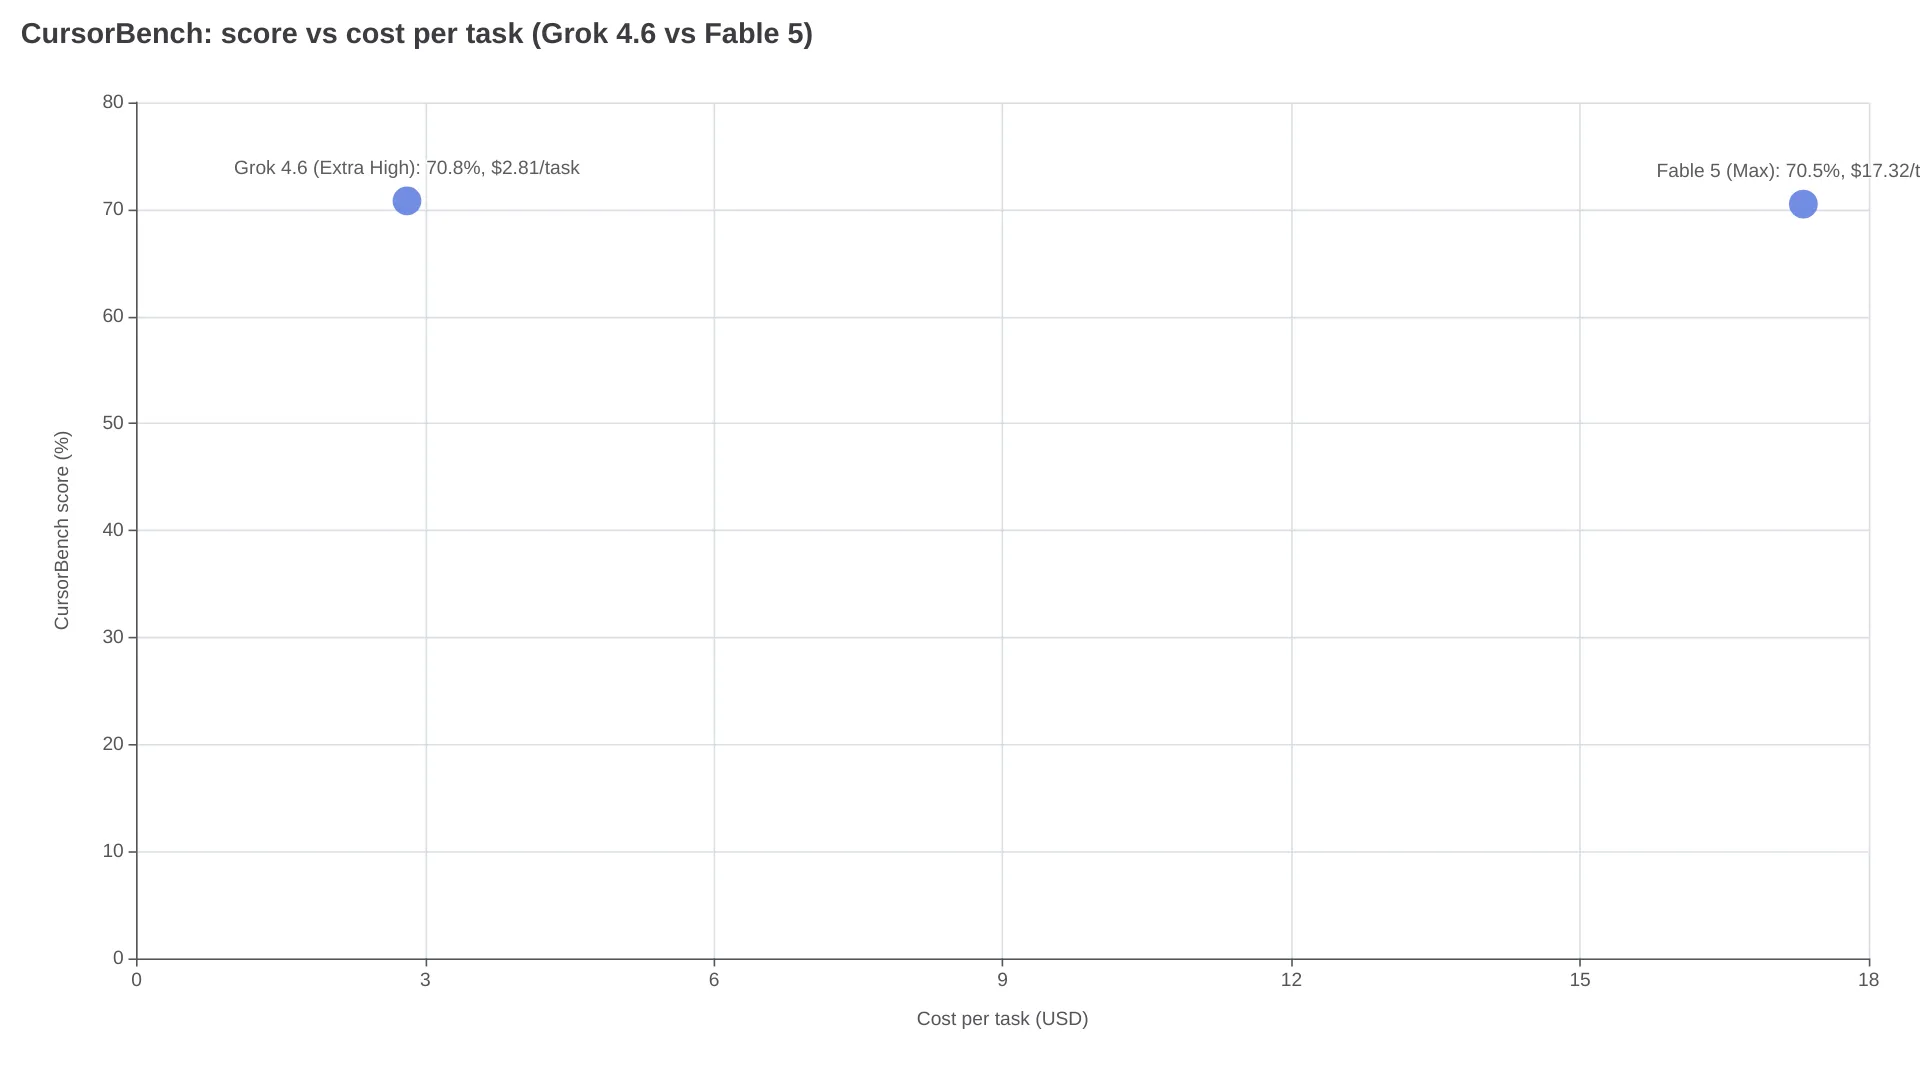
Sur CursorBench, Grok 4.6 Extra High atteint 70,8 % pour 2,81 $ par tâche terminée, tandis que Fable 5 Max obtient 70,5 % avec le même environnement d’agent, pour 17,32 $ par tâche. En clair : les deux agents font jeu égal sur ce benchmark de programmation, mais chaque tâche coûte 6 fois plus cher avec Fable 5. Son avantage reste néanmoins réel sur deux points : Fable 5 domine toujours l’indice d’intelligence d’Artificial Analysis et dispose d’une fenêtre de contexte deux fois plus grande.
Comment Grok 4.6 a rattrapé Fable 5
Il y a deux mois, le verdict était beaucoup plus net. En juillet 2026, Artificial Analysis attribuait 56 points à Grok 4.5 contre 62 à Fable 5 dans son Intelligence Index, soit six points d’écart. Lancé en août 2026, Grok 4.6 aurait gagné environ cinq points pour atteindre ~59, un niveau proche de GPT-5.6 Sol, selon les écarts de benchmarks rapportés. Fable 5 ne conserve donc plus qu’une avance d’environ trois points.
Du côté des agents de programmation, l’écart s’est encore réduit. Fable 5 avait fait son entrée dans Cursor en juin 2026 avec un score de référence de 72,9 % sur CursorBench (r/accelerate), soit 8 points de mieux que le précédent meilleur résultat. Dans le comparatif publié en août sur r/cursor, après la sortie de Grok 4.6, la version Extra High a atteint 70,8 %, contre 70,5 % pour Fable 5 Max. Même environnement d’agent, résultat quasiment identique. Un utilisateur de Cursor à l’origine du test a toutefois soulevé un point important :
« Grok 4.6 m’a fait me demander : quelle part de CursorBench revient au modèle, et quelle part revient à l’environnement d’agent ? » — discussion r/cursor, août 2026
Les scores de benchmark évaluent toute la chaîne de l’agent — structure des prompts, outils et nouvelles tentatives — et pas uniquement le modèle de base. De plus, le score de 72,9 % obtenu par Fable 5 lors de son lancement et celui de 70,5 % mesuré en août reposent sur des configurations différentes. Il faut donc les considérer comme des indicateurs de tendance.
Le coût par tâche est le vrai point fort de Grok 4.6
Les chiffres de la comparaison d’août sont particulièrement révélateurs :
| Indicateur (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| Score | 70,8 % | 70,5 % |
| Coût par tâche | 2,81 $ | 17,32 $ |
| Étapes par tâche | 46 | 72 |
Fable 5 a eu besoin de 57 % d’étapes d’agent supplémentaires pour atteindre un score équivalent. Ces étapes additionnelles, ainsi que les tokens de raisonnement qu’elles impliquent, expliquent largement l’écart de prix. De quoi pousser les développeurs qui ont testé les deux modèles à remettre en question la comparaison basée uniquement sur le tarif par token :
« Le prix au token devient une mauvaise façon de comparer les agents IA. » — titre d’une discussion r/grok, août 2026
Les tarifs à l’unité expliquent une partie de cette différence. L’API Anthropic API facture Fable 5 10 $ en entrée et 50 $ en sortie par million de tokens. Le tarif publié de l’API xAI pour Grok 4.5 était de 2 $ / 6 $ par million avec un prompt de moins de 200K tokens. xAI n’a pas publié de grille tarifaire distincte pour la version 4.6, tandis que la communauté r/grok évoque « des performances au niveau de Sol pour une fraction du prix de l’API ». Pour consulter la grille complète de Fable 5 selon les offres, référez-vous à cette analyse des tarifs de l’API Fable 5.
En pratique, l’avantage de Grok se réduit dans deux cas. Son prix double environ au-delà des prompts de 200K tokens — 4 $ / 12 $ par million à ce niveau, d’après les tarifs publiés par xAI — et les utilisateurs qui dépendent déjà fortement de Fable 5 peuvent réduire leurs coûts en tokens avec Fable 5 grâce à plusieurs optimisations structurelles, sans changer immédiatement de modèle.
Les domaines où Fable 5 garde l’avantage
| Domaine | Les faits | Ce que cela change pour vous |
|---|---|---|
| Indice d’intelligence | Fable 5 reste numéro 1 de l’AA Intelligence Index : 62 contre environ 59 pour Grok 4.6 | Trois des six points d’avance initiaux ont résisté à la progression de la version 4.6 |
| Fenêtre de contexte | Fable 5 accepte 1 000 000 tokens de contexte, contre 500 000 pour Grok | Un dépôt volumineux et l’historique de la tâche peuvent tenir en une seule passe, tandis que l’avantage tarifaire de Grok se réduit au-delà de 200K tokens |
| Fiabilité sur les tâches les plus difficiles | Dans le test de création de TryAI, Fable 5 a généré le Rubik’s Cube en 3D dès le premier essai et produit le meilleur SVG ; Grok 4.5 a dû relancer l’opération. Goldie Bench a placé Fable 5 devant, 20 à 17, sur 47 tâches en one-shot. Le modèle a notamment remporté les créations de shaders et de simulations physiques GPU avec une avance de 0,8 à 1,6 point | Sur une tâche ambiguë à résoudre en un seul essai, le plafond de raisonnement de Fable 5 se fait sentir |
Vitesse, latence et débit
Voici les mesures de TryAI, avec le même routage fournisseur, une limite de 400 tokens et trois exécutions par type de prompt :
| Indicateur | Grok 4.5 | Fable 5 |
|---|---|---|
| Temps avant le premier token | 0,44 s | 3,47 s |
| Débit | 110 tok/s | 28 tok/s |
| Coût par réponse | 0,00002 $ | 0,00009 $ |
| Taux de réussite | 100 % | 100 % |
Grok a généré 110 tok/s, soit environ deux fois plus que GPT-5.5 et Opus 4.8, et près de quatre fois plus que les 28 tok/s de Fable 5. Artificial Analysis fournit toutefois un chiffre moins flatteur pour Fable 5 lorsque le raisonnement est poussé au maximum : 113,68 secondes avant le premier token de réponse, contre 8,68 secondes pour Grok. Une fois la génération lancée, Fable 5 décode pourtant légèrement plus vite, à 63,1 contre 58,9 tok/s. En pratique, Grok paraît très réactif dans les boucles interactives ; Fable 5 consacre davantage de temps à réfléchir en amont, ce qui se paie sur la durée totale.
Accès, abonnements et outils pour les agents
Fable 5 est accessible via l’API Anthropic, Claude Code et Cursor. Les abonnements Claude Pro au forfait fixe couvrent la plupart des usages hors API. Son écosystème — CLAUDE.md, plugins, skills et serveurs MCP — bénéficie de plusieurs années de maturité.
Grok 4.6 est disponible via l’API xAI et le CLI Grok Build (curl -fsSL https://x.ai/cli/install.sh | bash), tandis que X Premium inclut l’accès conversationnel. Selon ClockedCode, Grok Build lit sans configuration les fichiers CLAUDE.md existants, les plugins et skills de Claude Code, les serveurs MCP, les agents et les hooks. Il peut fonctionner sans interface avec l’option -p pour la CI et propose un Agent Client Protocol pour l’intégration. L’écosystème est plus jeune, mais cette compatibilité avec Claude Code réduit presque à zéro le coût de migration dans les configurations compatibles.
Un point de facturation vaut pour les deux modèles : les abonnés Claude Pro et X Premium paient un forfait fixe. Dans ce cas, les limites d’utilisation liées à votre charge réelle comptent davantage que la grille tarifaire.
Quel modèle choisir selon votre usage
| Votre situation | Choix | Pourquoi |
|---|---|---|
| Tâches de programmation répétitives et bien définies, en grand volume | Grok 4.6 | 2,81 $ par tâche contre 17,32 $ pour un score CursorBench équivalent |
| Travail critique nécessitant un dépôt volumineux | Fable 5 | Fenêtre de contexte de 1 M, première place de l’indice d’intelligence et meilleure fiabilité au premier essai |
| Sessions interactives avec un agent et itérations rapides | Grok 4.6 | 0,44 s avant le premier token, 110 tok/s |
| Créations ambiguës en one-shot et raisonnement complexe | Fable 5 | Vainqueur de la tâche la plus difficile de TryAI et des comparatifs de Goldie Bench |
| Budget API strictement plafonné | Grok 4.6 | Les tokens de sortie coûtent environ huit fois moins cher que ceux de Fable 5 |
Mon verdict : utilisez Grok 4.6 par défaut pour les tâches cadrées et répétitives, et gardez Fable 5 pour les missions où une erreur coûte plus cher que les tokens consommés. Les équipes qui traitent un volume conséquent ont intérêt à exploiter les deux modèles et à orienter les tâches selon leur taille, leur taux de nouvelle tentative et le coût par tâche terminée. C’est plus économique que de s’enfermer dans un seul modèle.
FAQ
Grok 4.6 est-il meilleur que Fable 5 pour programmer ?
Sur CursorBench, les deux modèles sont à égalité : 70,8 % pour Grok 4.6 Extra High contre 70,5 % pour Fable 5 Max dans la comparaison d’août. Fable 5 reste devant dans l’indice d’intelligence plus général d’Artificial Analysis (62 contre ~59) et remporte les tâches one-shot les plus difficiles. Le « meilleur » choix dépend donc de votre priorité : réduire le coût par tâche ou maximiser le plafond de fiabilité.
Grok 4.6 est-il moins cher que Fable 5 ?
Oui, d’environ 6 fois par tâche CursorBench terminée (2,81 $ contre 17,32 $). La comparaison au token s’appuie sur le tarif publié de Grok 4.5 — 6 $ en sortie contre 50 $ par million pour Fable 5 — car xAI n’a pas publié de grille distincte pour Grok 4.6. L’écart se réduit au-delà de 200K tokens, niveau auquel le tarif de Grok double environ.
Quel modèle offre la plus grande fenêtre de contexte ?
Fable 5, avec 1 000 000 tokens contre 500 000 pour Grok. Pour les usages qui nécessitent de conserver un code source complet dans le contexte, cette différence peut peser davantage que l’avantage tarifaire de Grok.
Grok Build peut-il utiliser ma configuration Claude Code ?
Oui. Grok Build lit automatiquement les fichiers CLAUDE.md, les plugins et skills de Claude Code, les serveurs MCP, les agents et les hooks, sans migration. Il ajoute son propre répertoire .grok/ pour les réglages spécifiques à Grok.
Les benchmarks de Grok 4.5 permettent-ils d’estimer correctement Grok 4.6 ?
Pas pour évaluer ses capacités. Par rapport à Grok 4.5, Grok 4.6 a gagné environ cinq points dans l’Intelligence Index, réduisant de six à environ trois points son retard sur Fable 5. Il a aussi égalé Fable 5 Max sur CursorBench, alors que la version 4.5 accusait un retard net. Les chiffres de vitesse et de prix par token présentés ici correspondent à des mesures de Grok 4.5, car aucune donnée équivalente n’a encore été publiée pour Grok 4.6.
Un compromis qui reste entier
Aucun benchmark de cette comparaison ne permet de trancher lorsque le dépôt contient 50 000 lignes, que le ticket manque de précision et qu’un échec coûte une heure de débogage. La fenêtre de contexte de 1 M et le plafond d’intelligence supérieur de Fable 5 sont précisément conçus pour ce type de situation : une certitude plus chère face aux étapes économiques de Grok 4.6. L’écart reste suffisamment important pour que la plupart des équipes conservent les deux modèles actifs.
À lire aussi : Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5