 AIREITER
Sur l’Artificial Analysis Intelligence Index, Grok 4.6 et GPT-5.6 Sol se tiennent dans un mouchoir de poche : environ 61 contre 58,9. Pourtant, chaque token de sortie de Sol coûte 5x plus cher. L’écart tarifaire est net, mais l’avantage de Sol sur la fenêtre de contexte, deux fois plus grande, et sur l’efficacité des agents rend le calcul moins simple qu’il n’y paraît.
Un niveau d’intelligence comparable, mais un score qui ne dit pas tout
L’Artificial Analysis Intelligence Index v4.1 agrège des tâches de raisonnement, de programmation et de connaissances dans un score unique. D’après OpenAI, GPT-5.6 Sol atteint 58,9. Grok 4.6 serait autour de 61, selon des retours de la communauté citant les données d’arène d’Artificial Analysis. Ce chiffre issu de la communauté n’a pas été confirmé indépendamment, mais il concorde avec le positionnement d’Artificial Analysis, qui considère Grok 4.6 comme l’équivalent de Sol.
Un score composite masque forcément les différences de fenêtre de contexte, d’efficacité agentique et de variance entre benchmarks. Sol affiche notamment des résultats dominants sur des évaluations très orientées agents, telles que Terminal-Bench 2.1 (88,8 %) et DeepSWE v1.1 (72,7 %), d’après les résultats publiés par OpenAI. Les scores précis de Grok 4.6 sur ces tests ne sont pas encore disponibles de manière indépendante. L’Intelligence Index les place au même niveau en intelligence générale ; les benchmarks d’agents pourraient raconter une autre histoire.
| Caractéristique | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Développeur | xAI | OpenAI |
| Fenêtre de contexte | 500K tokens (x.ai/api) | ~1 050 000 tokens (openai.com) |
| Entrée API (par 1M) | $2.00 (x.ai/api) | $5.00 (openai.com) |
| Sortie API (par 1M) | $6.00 (x.ai/api) | $30.00 (openai.com) |
| Intelligence Index v4.1 | ~61 (signalé par la communauté) | 58.9 (officiel) |
| Disponibilité cloud | Azure AI Foundry, Oracle OCI, Google Vertex (x.ai/api) | Azure, AWS Bedrock (openai.com) |
Tarifs API : entrée 2,5x moins chère, sortie 5x moins chère
La page API de xAI affiche Grok 4.6 à $2.00 par million de tokens en entrée et $6.00 par million de tokens en sortie. La page GPT-5.6 d’OpenAI indique $5.00 en entrée et $30.00 en sortie par million de tokens pour Sol.
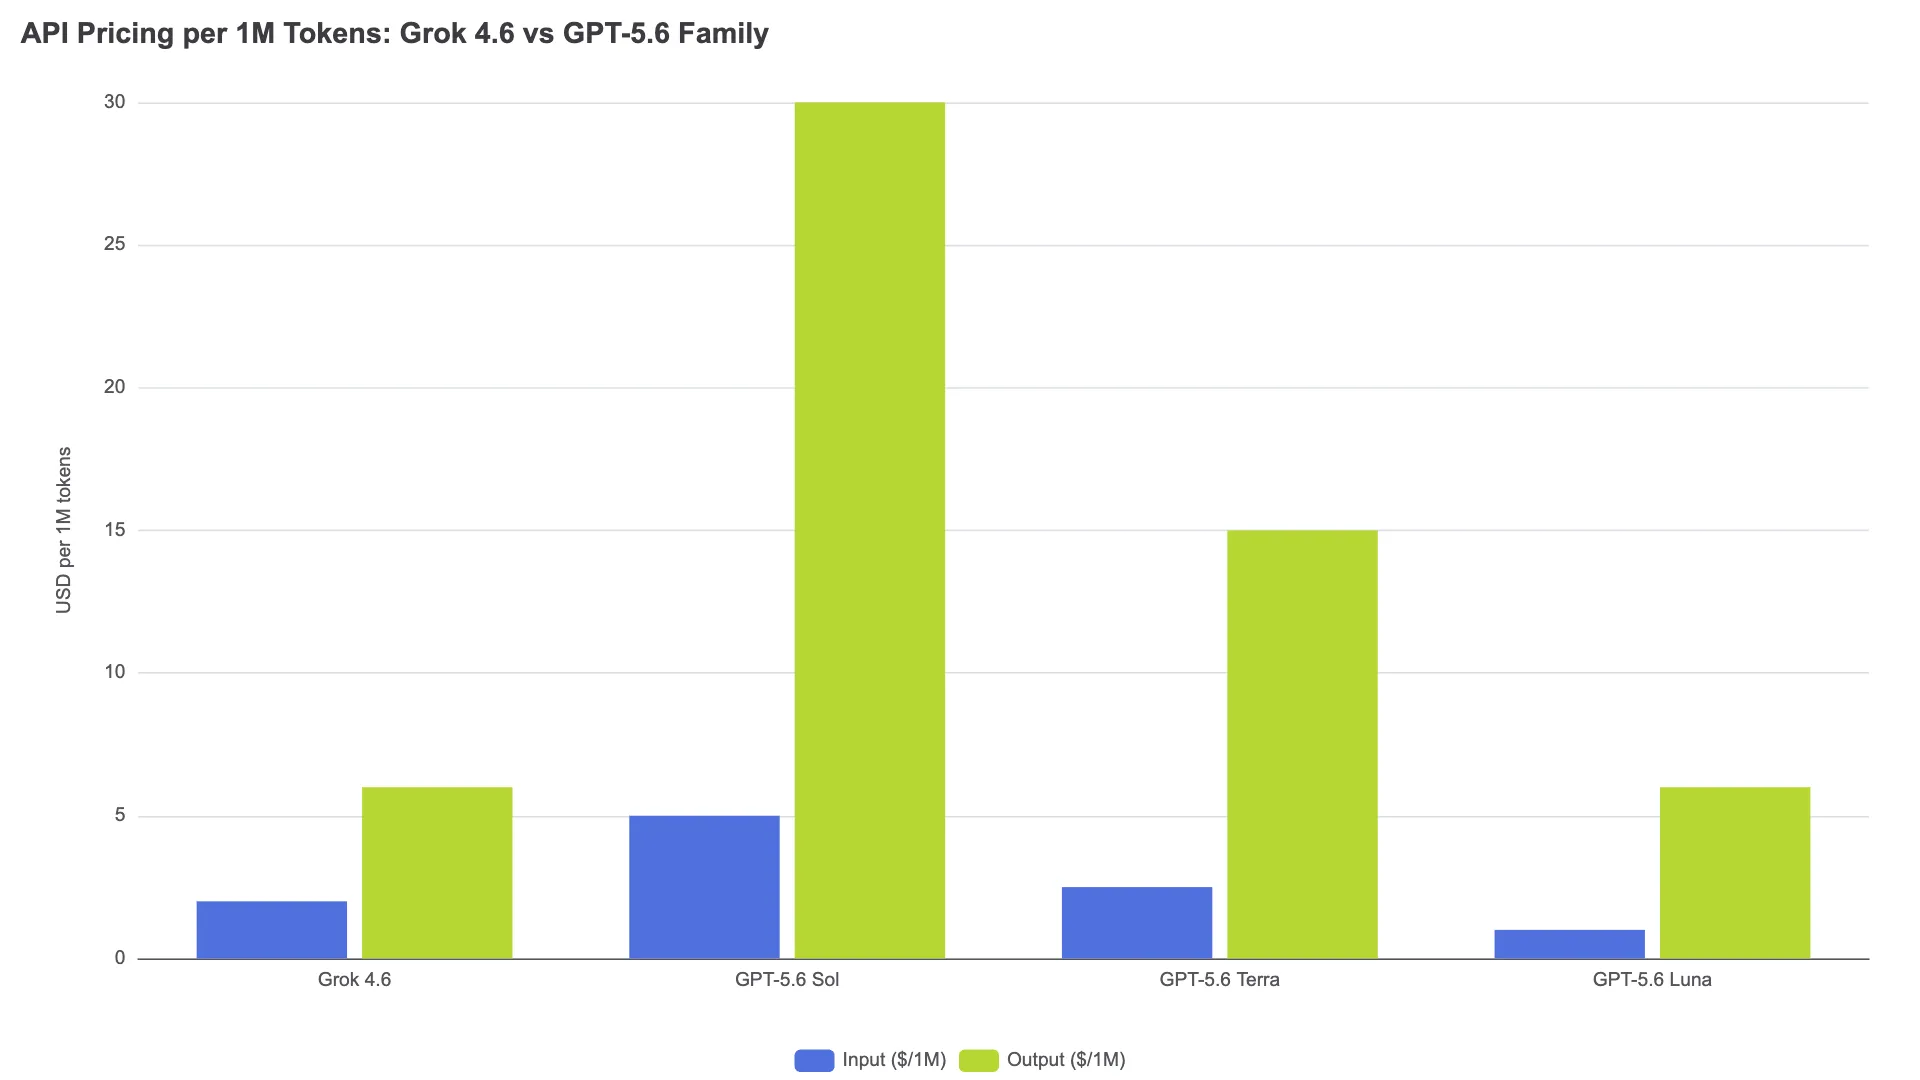
Pour une charge mensuelle de 50M de tokens d’entrée et 10M de tokens de sortie, Grok 4.6 revient à $160. Sol coûte $550. Cela représente un facteur 3,4, avant même de tenir compte du fait que les modes de raisonnement de Sol consomment davantage de tokens par tâche.
OpenAI propose aussi des paliers plus abordables : GPT-5.6 Terra à $2.50/$15.00 et GPT-5.6 Luna à $1.00/$6.00 (le prix de Luna a été réduit de 80 % le 30 juillet 2026). Luna rejoint Grok 4.6 sur le tarif de sortie et le devance en entrée, mais il s’agit d’un modèle plus petit, avec des scores inférieurs sur l’ensemble des benchmarks. Pour comparer des modèles à intelligence comparable, le face-à-face honnête reste Grok 4.6 contre Sol — et, sur ce terrain, l’avantage de coût de Grok est considérable.
Fenêtre de contexte : 500K contre 1M de tokens
Grok 4.6 dispose d’une fenêtre de contexte de 500K tokens, selon la page API de xAI. Sol monte à environ 1,05 million de tokens, d’après la documentation d’OpenAI. Avec 500K tokens, on couvre le développement courant au niveau d’un composant, d’un module et de la plupart des services. Le million de tokens de Sol devient utile lorsqu’il faut injecter dans une seule requête un monorepo complet, plusieurs documents volumineux ou un très long historique de conversation. Si votre workflow agentique doit analyser 800K tokens de code en une passe, Sol le peut ; Grok 4.6 non.
La fiabilité de la récupération d’information compte aussi. OpenAI indique que Sol obtient 77,1 % sur GraphWalks BFS à 1M de tokens. Grok n’a pas publié de score équivalent sur la récupération en contexte long. Pour un cas d’usage du type « trouver le bug dans cette base de code de 600K tokens », la fenêtre plus large de Sol ne concerne donc pas seulement la capacité : elle pose aussi la question de la capacité réelle du modèle à retrouver l’information à cette profondeur.
Benchmarks de code et d’agents : là où les écarts apparaissent
La quasi-égalité sur l’Intelligence Index ne se retrouve pas uniformément dans les benchmarks dédiés au code. Le tableau ci-dessous met en regard les scores officiels d’OpenAI pour GPT-5.6 Sol et les résultats de Grok 4.5 rapportés par Fritz.ai, utilisés ici comme point de comparaison. Les benchmarks de code propres à Grok 4.6 n’ont pas encore été publiés indépendamment : la colonne Grok doit donc être lue comme une référence sur le modèle précédent, et non comme un duel direct avec Grok 4.6.
| Benchmark | GPT-5.6 Sol (officiel) | Grok 4.5 (référence) | Écart |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58.9 | - | Grok 4.6 : ~61 (quasi-égalité) |
| Coding Agent Index v1.1 | 80.0 | - | Aucune donnée pour Grok 4.6 |
| Terminal-Bench 2.1 | 88.8% | 83.3% | Sol +5.5 pts |
| DeepSWE v1.1 | 72.7% | 53.0% | Sol +19.7 pts |
| SWE-Bench Pro | 64.6% | 64.7% | Égalité de fait |
| GPQA Diamond | 94.6% | 93.1% | Sol +1.5 pts |
Les avances de Sol sur Terminal-Bench et DeepSWE sont les plus parlantes. Terminal-Bench mesure la capacité d’un agent à accomplir de vraies tâches en terminal : installer des paquets, lancer des tests, déboguer des erreurs. DeepSWE évalue l’ingénierie logicielle de bout en bout sur de vrais tickets GitHub. L’avance de 19,7 points de Sol sur Grok 4.5 dans DeepSWE suggère qu’il est nettement meilleur pour les tâches de code complexes et multi-étapes, où le modèle doit planifier, exécuter puis se remettre d’erreurs. Reste à voir si les améliorations de post-entraînement de Grok 4.6 réduiront cet écart.
Les benchmarks donnent une direction, pas un verdict définitif : le harnais agentique, les outils, les prompts et l’environnement d’exécution influencent les résultats. Un modèle moins bien classé avec un harnais peut donc faire mieux avec un autre.
Au-delà du prix au token : le coût réel d’une tâche
Le prix par token de Grok 4.6 paraît écrasant sur une grille tarifaire, mais les agents ne s’achètent pas au token : ils s’évaluent sur les tâches terminées. Si Sol boucle une tâche de code avec 3 000 tokens de sortie, là où Grok 4.6 en consomme 6 000 pour le même résultat — davantage de tentatives, de chaînes de raisonnement plus longues ou un usage moins efficace des outils — l’écart de coût se réduit.
Une analyse de sensibilité aux tarifs actuels permet d’en mesurer l’amplitude. Prenons une tâche de code qui nécessite 10K tokens d’entrée et 4K de sortie avec Sol, contre 12K tokens d’entrée et 8K de sortie avec Grok 4.6, soit un avantage d’efficacité de 2x pour Sol :
| Facteur de coût | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| Coût d’entrée | $0.05 | $0.024 |
| Coût de sortie | $0.12 | $0.048 |
| Total par tâche | $0.17 | $0.072 |
Même dans ce scénario défavorable où Grok 4.6 utilise 2x plus de tokens, il reste 2,4x moins cher par tâche. Des utilisateurs Reddit citant Artificial Analysis ont estimé le coût par tâche de l’Intelligence Index de Grok 4.6 à environ $0.86. La capacité de Grok à conserver son avantage de coût avec une efficacité en tokens au niveau de Sol dépendra de la complexité des tâches et du harnais agentique de votre cas d’usage.
Le vrai risque ne réside pas dans l’économie des tokens, mais dans l’aboutissement de la tâche. Les meilleurs scores de Sol à Terminal-Bench et DeepSWE signifient qu’il réussit des tâches agentiques complexes là où Grok pourrait échouer complètement, imposant une nouvelle tentative ou une intervention humaine. Une tâche ratée coûte plus cher qu’une tâche réussie, quel qu’en soit le prix initial.
Accès et écosystème
Les deux modèles ne se limitent plus à l’API de leur fournisseur. La page API de xAI et la documentation d’OpenAI font ici office de sources principales :
| Canal d’accès | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry (x.ai) | Azure OpenAI (openai.com) |
| AWS | Non indiqué | Bedrock (openai.com) |
| Google Cloud | Vertex Model Garden (x.ai) | Non indiqué |
| Oracle | OCI Generative AI (x.ai) | Non indiqué |
| Intégrations IDE | Cursor, Devin | Cursor, Codex |
| Compatibilité SDK | SDK OpenAI + Anthropic (x.ai) | SDK OpenAI |
| Chat grand public | SuperGrok ($30/mo), X Premium+ | ChatGPT Plus ($20/mo) (fritz.ai) |
| Entraînement sur les données grand public | Activation par défaut ; désactivation requise | données API/Business exclues par défaut |
D’après la documentation de xAI, Grok prend en charge les SDK OpenAI et Anthropic : une migration ne demande donc qu’un changement de clé API et d’endpoint. Pour le code sensible ou propriétaire, la politique d’OpenAI, qui exclut par défaut les données API et Business de l’entraînement, constitue un avantage dans les processus d’achat. Les utilisateurs grand public de Grok doivent désactiver manuellement cet usage, selon l’analyse de confidentialité de Fritz.ai.
Quel modèle choisir ?
| Charge de travail | Choix | Pourquoi |
|---|---|---|
| Agents de code à très haut volume | Grok 4.6 | Coût par token 2,5 à 5x inférieur à grande échelle |
| Tâches agentiques complexes et multi-étapes | GPT-5.6 Sol (provisoire) | Les avances dans les benchmarks d’agents portent sur Grok 4.5, pas 4.6 |
| Analyse de grandes bases de code (>500K tokens) | GPT-5.6 Sol | Fenêtre de contexte 2x plus grande |
| Traitement par lots sensible au coût | Grok 4.6 | Intelligence quasi équivalente pour un coût par token inférieur |
| Recherche sociale/web en temps réel | Grok 4.6 | Recherche native sur X et le web (x.ai) |
| Code sensible / propriétaire | GPT-5.6 Sol | Données API non utilisées pour l’entraînement par défaut |
| Déploiement Azure en entreprise | L’un ou l’autre | Les deux sont disponibles sur Azure AI Foundry |
La méthode la plus fiable pour trancher reste de faire passer un échantillon représentatif de vos tâches réelles dans les deux API. Comparez le taux de réalisation, le coût médian par tâche réussie, le nombre de tentatives et la latence.
FAQ
Faut-il comparer Grok 4.6 à GPT-5.6 Terra plutôt qu’à Sol ?
Terra ($2.50/$15.00) est plus proche de Grok 4.6 côté prix, mais ses scores sont inférieurs à ceux de Sol sur tous les benchmarks publiés : Intelligence Index 55.0, Coding Agent Index 77.4, Terminal-Bench 87.4 % (selon OpenAI). Si le critère est le niveau d’intelligence, Grok 4.6 face à Sol est la comparaison la plus juste. Si le critère est le prix, Grok 4.6 face à Terra avantage Grok à la fois sur le coût et les scores de benchmark. Luna ($1.00/$6.00) est moins cher que les deux, mais avec un compromis important sur la qualité.
Pour aller plus loin sur les spécifications et capacités de Grok 4.6, consultez notre guide Grok 4.6. Si vous comparez GPT-5.6 à une version antérieure de Grok, notre analyse GPT-5.6 Sol vs. Grok 4.5 couvre ce face-à-face entre générations précédentes.