 AIREITER
Un agent de code peut sembler économique, jusqu’à ce que son contexte franchisse un palier tarifaire ou que son budget de raisonnement grignote la limite de sortie. Pour trancher entre Grok 4.6 et Opus 5, choisissez Grok 4.6 si le coût compte et que vos prompts restent sous 200K tokens ; préférez Claude Opus 5 si une fenêtre de 1M tokens, 128K tokens en sortie ou ses contrôles d’agents documentés sont réellement nécessaires.
Commencez par délimiter votre charge de travail
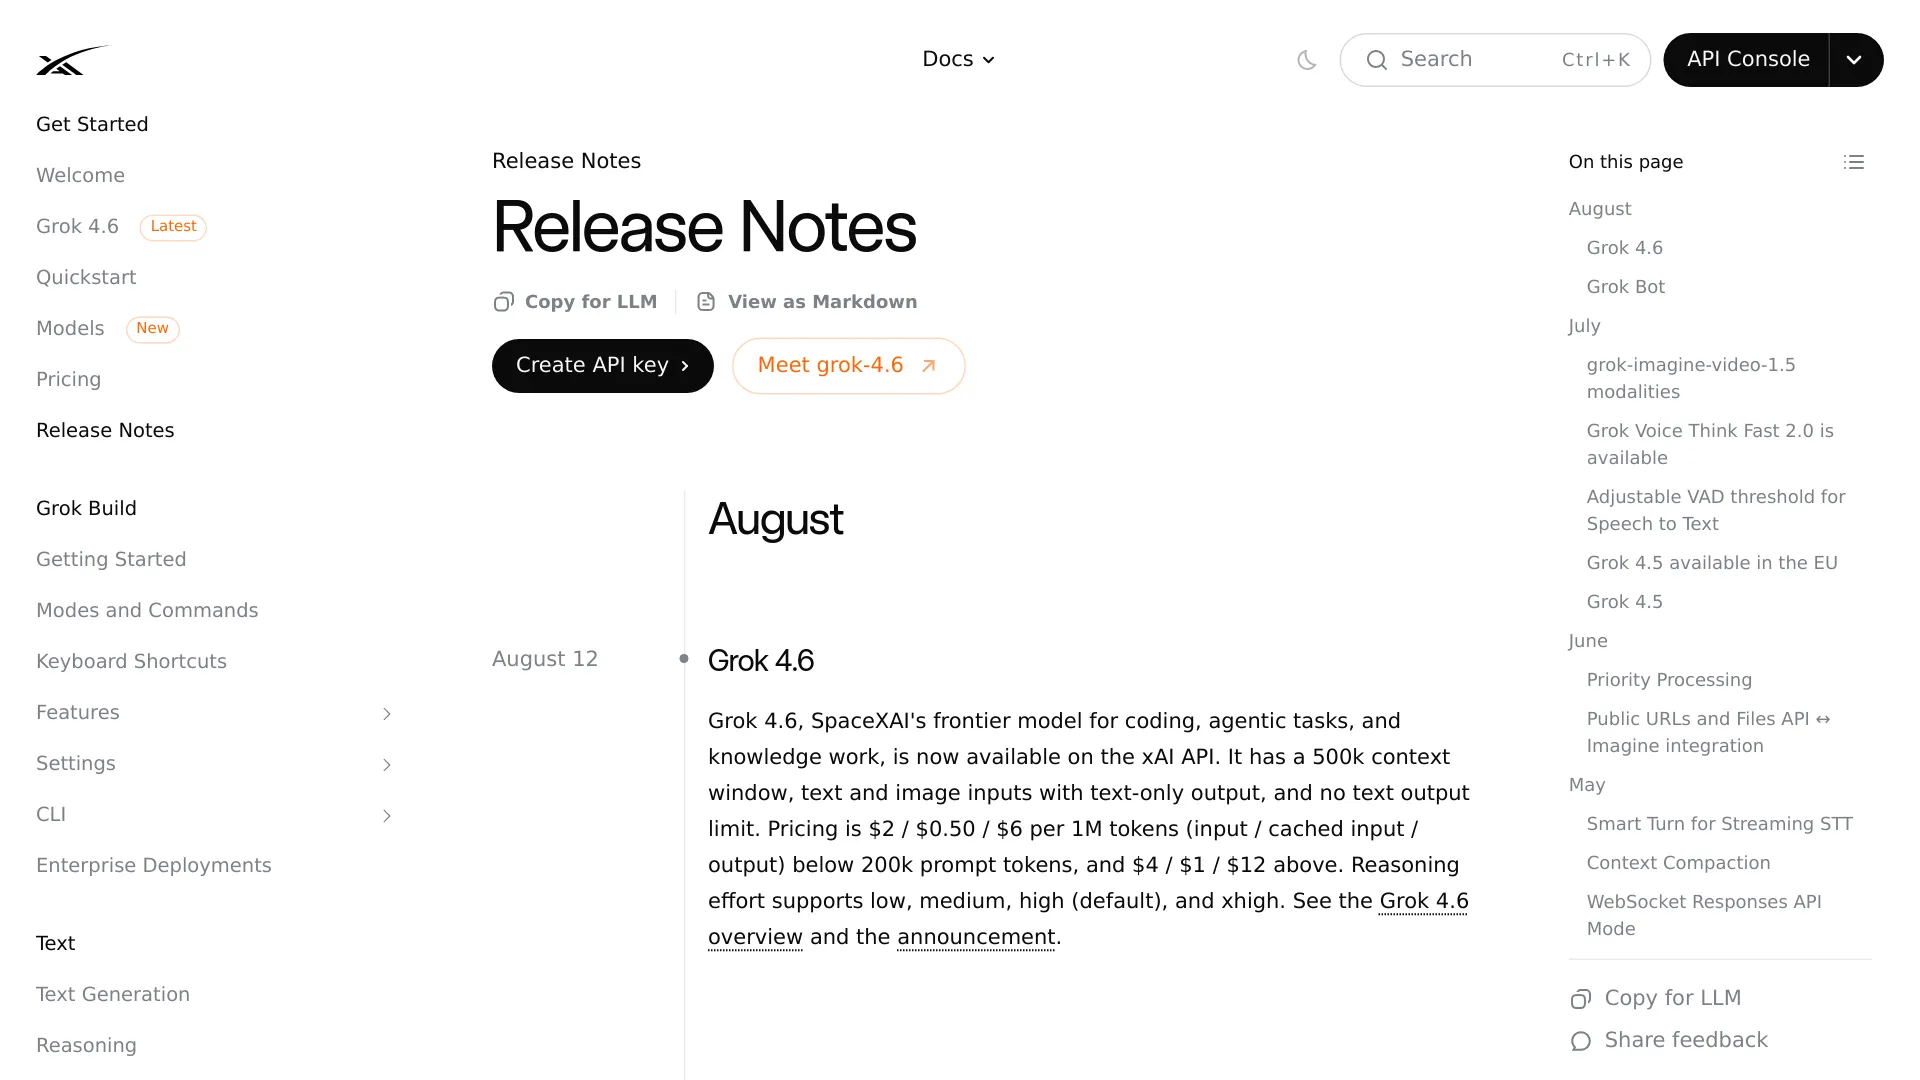
Grok 4.6 est le choix pragmatique par défaut pour un agent de code ou de travail intellectuel qui produit du texte et reste sous le seuil tarifaire xAI de 200K tokens de prompt. Dans ses notes de version du 12 août 2026, xAI annonce une fenêtre de contexte de 500K, des entrées texte et image, une sortie texte, ainsi que quatre niveaux d’effort, de low à xhigh. Les notes de version développeur de xAI constituent la source de référence pour ces spécifications.
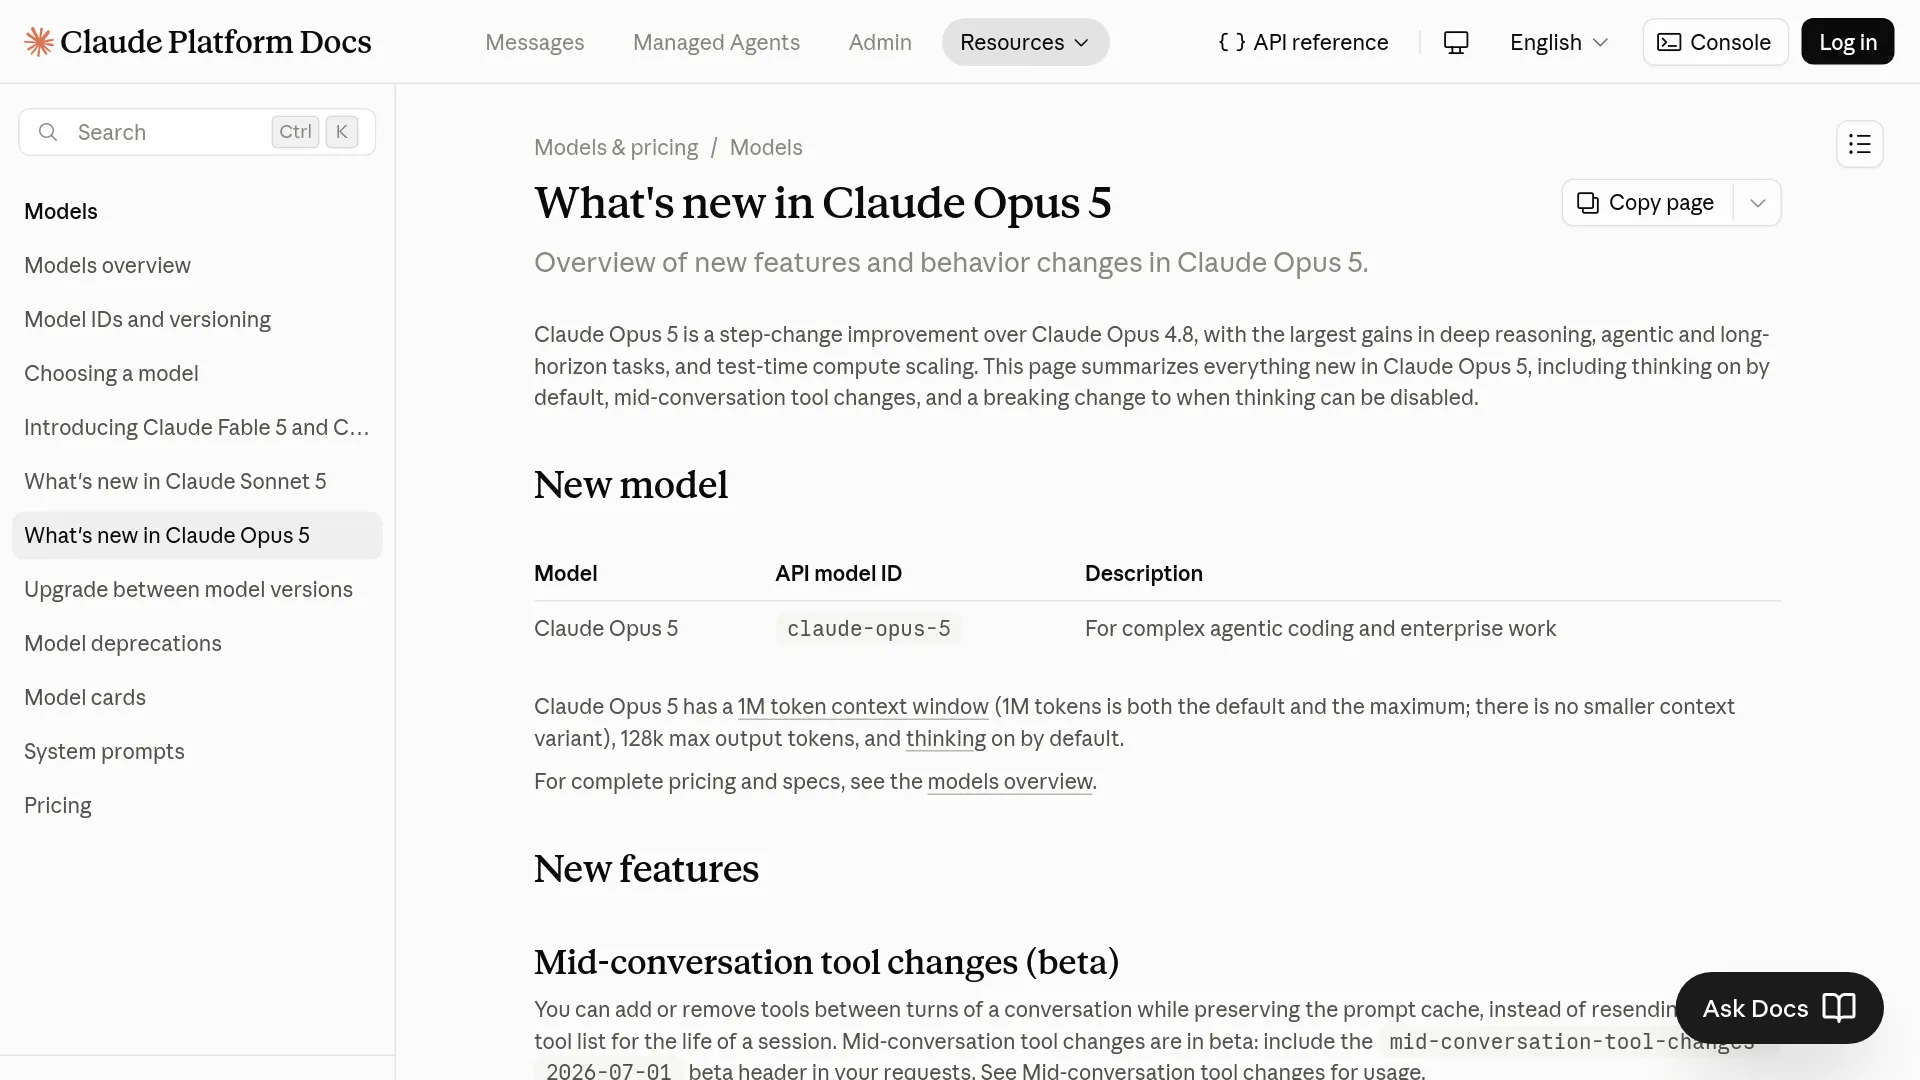
Claude Opus 5 convient davantage lorsque 500K tokens ne suffisent pas, qu’un flux de travail requiert jusqu’à 128K tokens en sortie, ou que l’intégration dépend des mécanismes de repli et des listes d’outils dynamiques d’Anthropic. Anthropic documente une fenêtre de contexte par défaut et maximale de 1M tokens, le thinking activé par défaut et la disponibilité de claude-opus-5 dans son API et chez ses principaux partenaires cloud. Dans ce cas, la documentation d’Opus 5 sur Claude Platform pèse davantage qu’un faible écart dans un classement.
Les sources citées ne proposent pas de benchmark commun permettant de départager tous les scénarios de code. Partez plutôt de la taille maximale des prompts, de la longueur de sortie requise, du contrat d’outillage et du coût par tâche terminée dans votre propre banc d’essai.
Les contraintes API à vérifier avant les benchmarks
Grok 4.6 et Claude Opus 5 acceptent tous deux le texte et les images, puis génèrent du texte. Les écarts déterminants concernent la capacité de contexte, la facturation des longs contextes, le contrat de sortie et les contrôles d’intégration.
| Caractéristique API | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| Fenêtre de contexte | 500K tokens | 1M tokens |
| Modalités d’entrée | Texte, image | Texte, image, flux PDF/document décrits par Anthropic |
| Modalité de sortie | Texte | Texte |
| Sortie texte maximale | Aucune limite chiffrée dans les notes de version xAI | 128K tokens |
| Réglages d’effort | low, medium, high, xhigh | low, medium, high, xhigh, max |
| Effort par défaut | high | high |
| Prix standard en entrée | $2/M tokens | $5/M tokens |
| Prix standard en sortie | $6/M tokens | $25/M tokens |
| Règle pour les longs prompts | $4/M en entrée et $12/M en sortie au-delà de 200K tokens de prompt | Aucun seuil équivalent indiqué dans la documentation de lancement d’Opus 5 |
| Entrée mise en cache | $0.50/M sous 200K ; $1/M au-delà de 200K | Prompt minimum cacheable de 512 tokens, avec une tarification du cache documentée séparément |
Les tarifs unitaires affichés de Grok 4.6 sont plus faibles, mais ils doublent au-delà de 200K tokens de prompt. Opus 5 coûte davantage, mais son contexte de 1M peut éviter les coûts de découpage ou de récupération d’information dans les flux qui en ont besoin.
Grok 4.6 : le seuil qui change le calcul des coûts
Grok 4.6 affiche $2 par million de tokens d’entrée et $6 par million de tokens de sortie sous les 200K tokens de prompt. Dès qu’un prompt dépasse 200K tokens, xAI annonce $4/M en entrée et $12/M en sortie ; les entrées en cache passent respectivement à $0.50/M et $1/M. Ce seuil importe plus que le tarif d’appel affiché au premier niveau. Les notes de version de xAI précisent les deux paliers.
Aux tarifs affichés, 100K tokens d’entrée non mis en cache et 20K tokens de sortie reviennent à $0.32 ; 250K tokens d’entrée et 20K tokens de sortie coûtent $1.24 après application du tarif supérieur. Il s’agit de calculs par requête, non d’estimations pour une exécution d’agent : les nouvelles tentatives, les appels d’outils, les préfixes mis en cache et le contexte accumulé peuvent dominer la facture.
Une discussion récente sur r/grok rapporte, pour CursorBench 3.2 et une configuration donnée, $2.81 par tâche et 46 étapes pour Grok 4.6 Extra High, contre $8.23 et 78 étapes pour Opus 5 Max. Considérez ces chiffres comme les résultats du banc d’essai déclarés par l’auteur, et non comme une garantie neutre vis-à-vis des fournisseurs : le même message attribue 26.0% à Grok 4.6 sur Terminal-Bench 3.0, derrière d’autres modèles cités.
Opus 5 : des choix d’intégration différents
Claude Opus 5 active le thinking par défaut. max_tokens est un plafond strict partagé entre le raisonnement caché et la sortie visible ; migrer depuis des requêtes Opus 4.8 sans thinking peut donc nécessiter un budget de sortie plus élevé. Anthropic précise aussi que l’association de thinking: {"type":"disabled"} avec xhigh ou max renvoie une erreur HTTP 400. Les notes de migration indiquent deux options : réduire l’effort tout en désactivant le thinking, ou supprimer le réglage qui le désactive.
Claude Opus 5 abaisse également le prompt minimal cacheable de 1,024 tokens avec Opus 4.8 à 512 tokens. Ses contrôles bêta permettent de modifier les outils en cours de conversation sans invalider le cache du prompt, et proposent un mode géré fallbacks: "default". Ces fonctions comptent pour un agent dont les autorisations ou l’ensemble d’outils évoluent ; elles ne changent rien pour un simple endpoint de complétion sans état.
Fast mode est un aperçu de recherche réservé à l’API, facturé $10/M en entrée et $50/M en sortie, soit deux fois le tarif standard d’Opus 5. Anthropic indique qu’il n’est pas disponible via Amazon Bedrock, Google Cloud ou Microsoft Foundry : portabilité et vitesse ne vont donc pas nécessairement de pair. L’annonce de lancement d’Anthropic fixe le tarif standard à $5/M en entrée et $25/M en sortie.
Pour les agents de code, les résultats orientent sans désigner un vainqueur universel
Anthropic indique qu’Opus 5, au niveau d’effort maximal, atteint environ 70.0% sur CursorBench 3.2 pour environ $8.50 par tâche, à moins de 0.5 point de pourcentage du meilleur score déclaré par Fable 5, pour environ la moitié du coût. Ces résultats tracés par Anthropic relèvent d’une évaluation du fournisseur, pas d’un audit inter-fournisseurs. L’annonce d’Opus 5 décrit sa méthode Frontier-Bench comme cinq tentatives par tâche au moyen d’une exécution interne à Anthropic.
Une mesure apparemment indépendante, mais plus ciblée, est plus utile pour la revue de code. CodeRabbit a testé environ 100 schémas d’erreurs vérifiés issus de pull requests open source réelles, a exécuté chaque configuration trois fois et évalué les commentaires de revue après filtrage. À l’effort xhigh, sa configuration Opus 5 a détecté 55.2% des problèmes connus contre 61.1% pour sa référence de production, tandis que la précision exploitable était de 39.3% contre 35.2% ; elle a aussi produit 92 remarques mineures contre 23. L’évaluation d’Opus 5 par CodeRabbit recommande un rôle précis centré sur la précision plutôt que d’utiliser Opus 5 comme seul filet de sécurité.
Ces éléments mènent à une règle concrète : évaluez Opus 5 à plusieurs niveaux d’effort et mesurez le rappel, la précision, l’usage de tokens et le bruit de revue sur vos propres pull requests. Pour Grok 4.6, les notes de version actuelles de xAI fournissent le contrat API et la tarification, mais pas d’étude directement comparable sur la revue de code. Un score d’agent de code ne suffit pas à conclure à un avantage en revue de code.
Quelle API retenir selon votre déploiement ?
Grok 4.6 est recommandé pour les agents dont le prompt habituel reste sous 200K tokens et dont la priorité est de réduire le coût API affiché. Prévoyez un budget d’évaluation autour de ce seuil : un agent de dépôt peut le franchir après les sorties d’outils et les nouvelles tentatives, même si son premier prompt est modeste.
Claude Opus 5 est recommandé pour une session sur un dépôt, des documents ou un agent nécessitant plus de 500K tokens de contexte actif, jusqu’à 128K tokens de sortie, ou les contrôles documentés d’Anthropic pour les changements d’outils et les mécanismes de repli. Commencez avec high, puis testez un effort inférieur avant de supposer que max justifie son coût.
Pour la revue de code automatisée, ne choisissez aucun des deux modèles sur la seule base d’un classement généraliste de code. Constituez un jeu de pull requests annotées, consignez le rappel des problèmes et la charge de faux positifs, et gardez une seconde voie de revue pour les défauts de concurrence, d’usage d’API et de validation. CodeRabbit a identifié ces catégories comme plus faibles pour ses configurations Opus 5 testées. Ses résultats par catégorie justifient de tester l’adéquation à la tâche, sans prétendre décrire tous les déploiements de Claude.
| Situation de déploiement | Choix par défaut | Critère de décision |
|---|---|---|
| Agent de code sensible aux coûts sous 200K tokens de prompt | Grok 4.6 | Ses tarifs affichés de $2/M en entrée et $6/M en sortie |
| Session longue sur un dépôt ou des documents au-delà de 500K de contexte | Claude Opus 5 | Fenêtre de contexte de 1M et plafond de sortie de 128K |
| Agent dont les outils changent dynamiquement | Claude Opus 5 | Les changements d’outils bêta en cours de conversation préservent le cache |
| Tâche avec de fréquents prompts au-delà de 200K tokens | Évaluer les deux | Grok 4.6 double ses tarifs de tokens affichés au seuil |
| Pipeline de revue de code | Évaluer les deux sur des PR annotées | Rappel, précision, nouvelles tentatives et bruit de revue comptent davantage qu’un score phare |
FAQ
Grok 4.6 est-il moins cher qu’Opus 5 ?
Sous 200K tokens de prompt, xAI affiche Grok 4.6 à $2/M en entrée et $6/M en sortie, contre $5/M en entrée et $25/M en sortie pour Opus 5. Les prix affichés de Grok 4.6 doublent au-delà de 200K tokens de prompt : comparez donc le coût d’une tâche terminée, pas seulement celui de la requête initiale.
Quel modèle utiliser pour programmer ?
Choisissez Grok 4.6 pour ses tarifs API affichés plus bas lorsque votre agent reste généralement sous 200K tokens de prompt. Choisissez Opus 5 si un contexte de 1M, 128K tokens de sortie ou les contrôles d’agents d’Anthropic sont indispensables ; dans les deux cas, validez le choix sur le langage, la structure de dépôt et la boucle d’outils que vous utilisez réellement.
Prochaine étape pour le déploiement
Exécutez les mêmes 20 à 50 tâches représentatives avec chaque candidat, des outils fixes, une limite fixe de nouvelles tentatives et une journalisation des tokens. Retenez le modèle qui atteint votre taux de réussite requis au coût le plus bas par tâche terminée, puis conservez l’autre comme option routée pour les charges où son avantage de contexte ou de plan de contrôle est décisif.
À lire aussi : Guide des tarifs API de Claude Opus 5, Détails de la sortie de Grok 4.6 et Grok 4.6 vs GPT-5.6.