 AIREITER
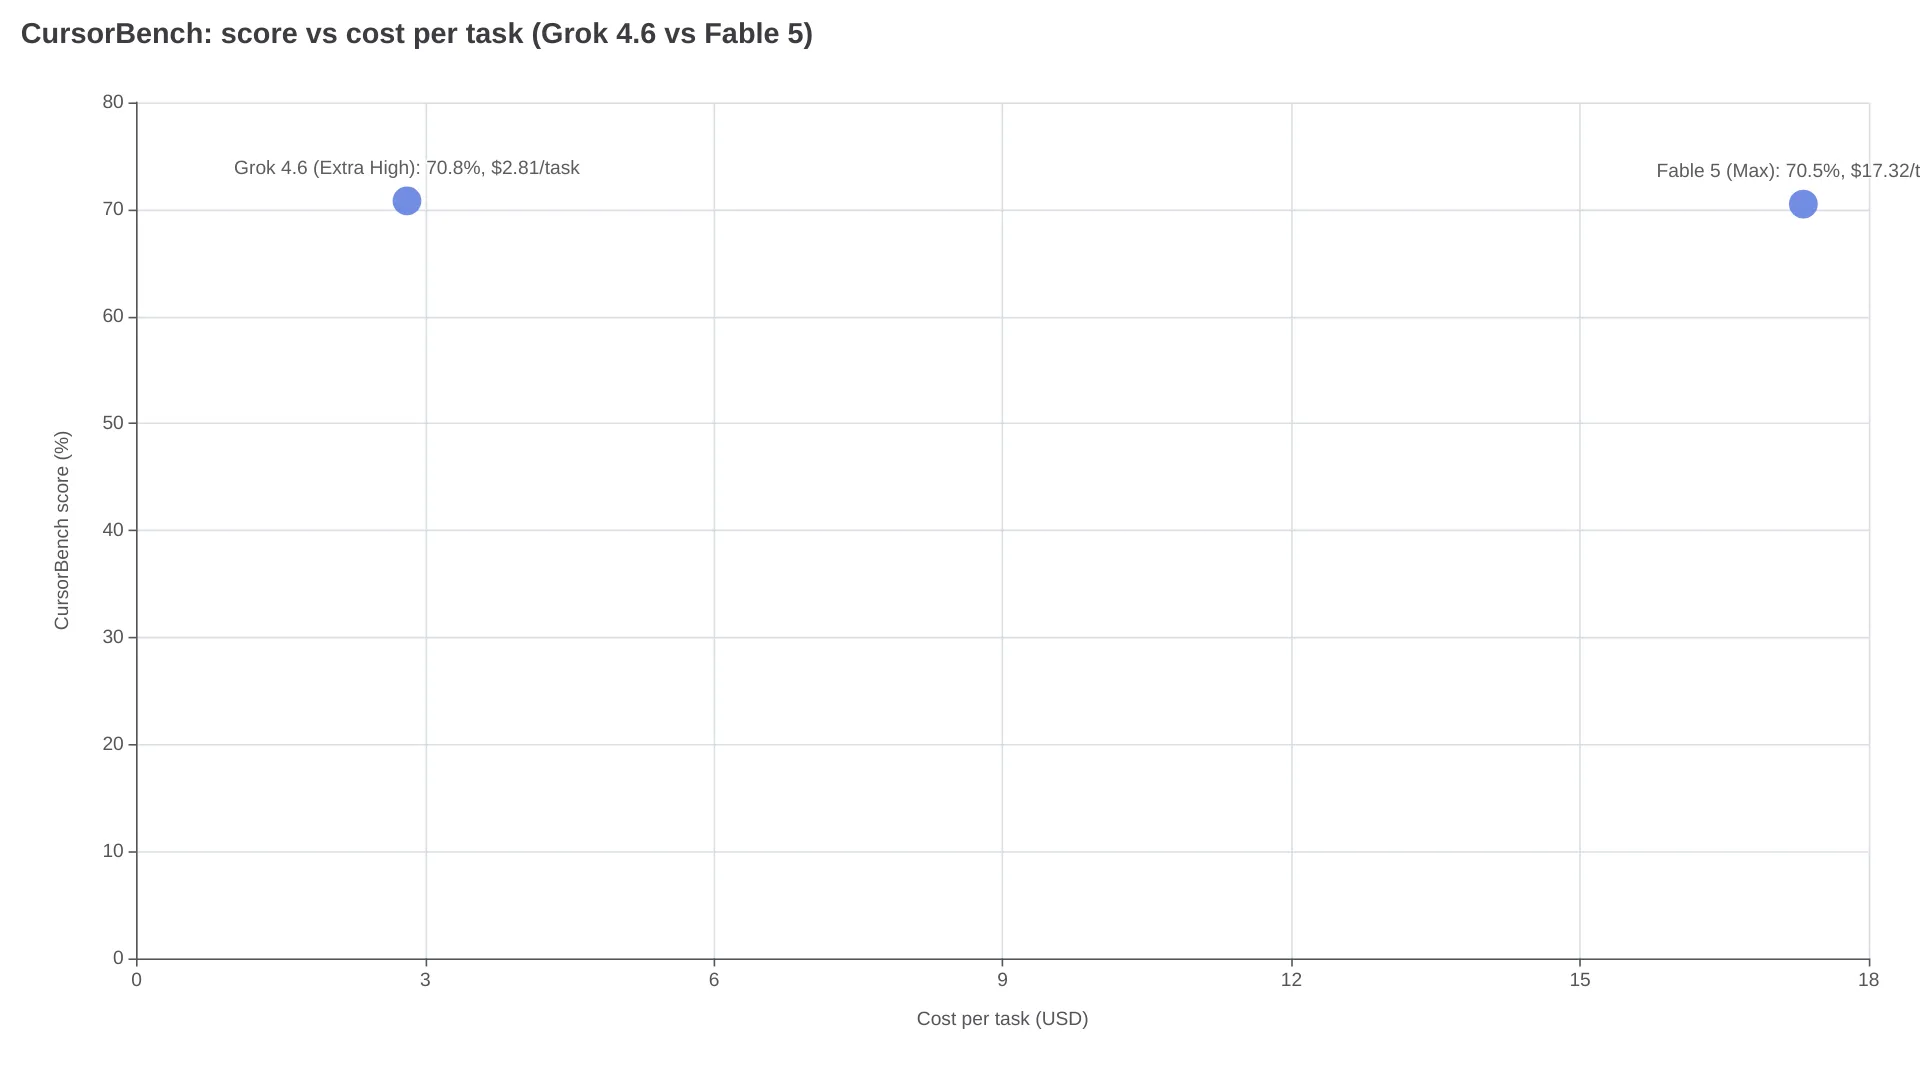
Bei Coding-Agenten liegen Grok 4.6 Extra High und Fable 5 Max auf CursorBench praktisch gleichauf: 70,8 % gegenüber 70,5 %. Der Unterschied steckt im Preis pro erledigter Aufgabe. Grok kam im selben Agent-Harness auf 2,81 $, Fable auf 17,32 $ – ein Abstand um den Faktor 6. Fable 5 hat dennoch zwei klare Trümpfe: Es führt weiterhin den umfassenderen Artificial Analysis Intelligence Index an und stellt das doppelt so große Kontextfenster bereit.
So hat Grok 4.6 zu Fable 5 aufgeschlossen
Vor zwei Monaten war das Urteil noch deutlich. Im Juli 2026 bewertete Artificial Analysis Grok 4.5 im Intelligence Index mit 56 Punkten, während Fable 5 auf 62 kam – ein Rückstand von sechs Punkten. Grok 4.6, veröffentlicht im August 2026, legte auf Basis gemeldeter Benchmark-Differenzen schätzungsweise fünf Punkte auf rund 59 zu und zog damit ungefähr mit GPT-5.6 Sol gleich. Der Vorsprung von Fable 5 schrumpfte so auf etwa drei Punkte.
Bei Coding-Agenten fiel der Abstand noch stärker. Fable 5 kam im Juni 2026 in Cursor auf den Markt und erzielte dort mit 72,9 % einen neuen Bestwert auf CursorBench (r/accelerate) – 8 Punkte über dem bisherigen Rekord. Im direkten Vergleich, der nach dem Release von Grok 4.6 im August auf r/cursor veröffentlicht wurde, erreichte Grok 4.6 Extra High 70,8 %, Fable 5 Max 70,5 %. Im identischen Agent-Harness ist das faktisch ein Gleichstand. Ein Nutzer, der den Vergleich durchgeführt hat, brachte den wichtigen Vorbehalt auf den Punkt:
"Grok 4.6 made me wonder: how much of CursorBench is the model, and how much is the harness?" - r/cursor thread, August 2026
Benchmark-Ergebnisse bewerten den gesamten Agent-Stack – Prompt-Gerüst, Tools und Wiederholungsversuche –, nicht allein das Basismodell. Außerdem stammen Fable 5s Launch-Ergebnis von 72,9 % und der August-Wert von 70,5 % aus unterschiedlichen Konfigurationen. Beide Werte sollten daher vor allem als Orientierung dienen.
Bei den Kosten pro Aufgabe spielt Grok 4.6 seine Stärke aus
Die Zahlen pro Aufgabe aus dem August-Vergleich erzählen die eigentliche Geschichte:
| Metrik (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| Score | 70.8% | 70.5% |
| Kosten pro Aufgabe | $2.81 | $17.32 |
| Schritte pro Aufgabe | 46 | 72 |
Fable 5 brauchte für praktisch dieselbe Punktzahl 57 % mehr Agent-Schritte. Die zusätzlichen Schritte und die darin enthaltenen Reasoning-Tokens passen zum deutlichen Kostenabstand. Genau deshalb hinterfragten Entwickler, die beide Modelle nutzten, zunehmend den reinen Listenpreis pro Token:
"$/token is becoming the wrong way to compare AI agents." - r/grok thread title, August 2026
Ein Teil des Unterschieds erklärt sich durch die Token-Preise. Fable 5 kostet über die Anthropic API 10 $ für Input und 50 $ für Output je eine Million Tokens. Für Grok 4.5 veröffentlichte xAI einen API-Preis von 2 $ / 6 $ pro Million Tokens bei Prompts unter 200K Tokens. Eine eigene Preisliste für 4.6 hat xAI bislang nicht veröffentlicht; laut r/grok-Community liefert 4.6 jedoch „Sol-level performance at a fraction of the API price.“ Die vollständige Fable-5-Preisliste über alle Stufen hinweg findet sich in der Aufschlüsselung der Fable 5 API-Preise.
In der Praxis relativieren zwei Faktoren diesen Vorteil. Oberhalb von Prompts mit 200K Tokens verdoppeln sich Groks Preise laut den veröffentlichten xAI-Raten ungefähr auf 4 $ / 12 $ je Million. Und wer ohnehin stark auf Fable 5 setzt, kann die Token-Kosten von Fable 5 senken, bevor ein Modellwechsel nötig wird.
Wo Fable 5 weiterhin vorn liegt
| Bereich | Die Datenlage | Was das für dich bedeutet |
|---|---|---|
| Intelligence Index | Fable 5 bleibt auf dem AA Intelligence Index auf Platz 1: 62 gegenüber rund 59 für Grok 4.6 | Von seinem früheren Vorsprung von sechs Punkten behält Fable 5 nach dem 4.6-Sprung noch etwa drei |
| Kontextfenster | Fable 5 bietet 1,000,000 Tokens Kontext, Grok 500,000 | Ein großes Repository samt Aufgabenverlauf passt in einem Durchgang hinein; oberhalb der 200K-Stufe wird zudem Groks Preisvorteil kleiner |
| Zuverlässigkeit bei den schwierigsten Aufgaben | Im Build-Test von TryAI renderte Fable 5 den 3D-Rubik’s Cube im ersten Versuch und lieferte das beste SVG; Grok 4.5 benötigte einen weiteren Durchlauf. Goldie Bench sah Fable 5 bei 47 One-Shot-Aufgaben mit 20 zu 17 vorn; bei Shader- und GPU-Physics-Builds gewann es mit 0,8 bis 1,6 Punkten | Bei mehrdeutigen One-Shot-Aufgaben zeigt sich die höhere Reasoning-Grenze von Fable 5 |
Geschwindigkeit, Latenz und Durchsatz
Gemessene Werte von TryAI: gleiches Provider-Routing, 400-Token-Limit und drei Durchläufe pro Prompt-Typ:
| Metrik | Grok 4.5 | Fable 5 |
|---|---|---|
| Zeit bis zum ersten Token | 0.44 s | 3.47 s |
| Durchsatz | 110 tok/s | 28 tok/s |
| Kosten pro Antwort | $0.00002 | $0.00009 |
| Erfolgsquote | 100% | 100% |
Mit 110 tok/s generierte Grok ungefähr doppelt so schnell wie GPT-5.5 und Opus 4.8 – und rund viermal so schnell wie Fable 5 mit 28 tok/s. Artificial Analysis nennt für Fable 5 bei Reasoning mit maximalem Aufwand einen noch deutlich größeren Latenzabstand: 113,68 Sekunden bis zum ersten Antwort-Token gegenüber 8,68 Sekunden bei Grok. Sobald das Streaming beginnt, dekodiert Fable 5 allerdings etwas schneller, mit 63,1 statt 58,9 tok/s. Praktisch heißt das: Grok reagiert in interaktiven Schleifen sehr direkt, während Fable 5 länger vorab nachdenkt und dafür mehr Echtzeit benötigt.
Zugang, Abos und Agent-Tooling
Fable 5 ist über die Anthropic API, Claude Code und Cursor verfügbar. Die Pauschaltarife von Claude Pro decken den Großteil der Nutzung außerhalb der API ab. Das Claude-Code-Ökosystem mit CLAUDE.md, Plugins, Skills und MCP-Servern ist über Jahre gereift.
Grok 4.6 steht über die xAI API sowie die Grok Build CLI zur Verfügung (curl -fsSL https://x.ai/cli/install.sh | bash); X Premium bündelt den Chat-Zugang. Laut ClockedCode liest Grok Build vorhandene CLAUDE.md-Dateien, Claude-Code-Plugins, Skills, MCP-Server, Agents und Hooks ohne Konfiguration ein. Mit dem Flag -p läuft es auch headless für CI und stellt ein Agent Client Protocol zur Einbettung bereit. Das Ökosystem ist jünger, doch die Kompatibilität mit Claude Code hält die Migrationskosten bei passenden Setups nahezu bei null.
Für beide gilt beim Abrechnen dieselbe Realität: Claude-Pro- und X-Premium-Abonnenten zahlen Pauschalpreise. Entscheidend sind deshalb die Nutzungslimits unter deiner tatsächlichen Last, nicht nur die Rate Card.
Welches Modell für welchen Einsatz?
| Deine Situation | Empfehlung | Warum |
|---|---|---|
| Große Mengen klar spezifizierter Coding-Aufgaben | Grok 4.6 | 2,81 $ pro Aufgabe statt 17,32 $ bei nahezu identischen CursorBench-Scores |
| Korrektheitskritische Arbeit in einem großen Repository | Fable 5 | 1M Kontextfenster, Platz 1 im Intelligence Index, beste Zuverlässigkeit im ersten Versuch |
| Interaktive Agent-Sitzungen und schnelle Iteration | Grok 4.6 | 0,44 s bis zum ersten Token, 110 tok/s |
| Mehrdeutige One-Shot-Builds und anspruchsvollstes Reasoning | Fable 5 | Gewann TryAIs schwierigste Aufgabe und die direkten Goldie-Bench-Duelle |
| API-Budget mit harter Obergrenze | Grok 4.6 | Output-Tokens kosten ungefähr ein Achtel des Fable-5-Preises |
Mein Fazit: Für klar abgegrenzte, wiederkehrende Arbeiten ist Grok 4.6 die sinnvolle Standardwahl. Fable 5 lohnt sich für Aufgaben, bei denen eine falsche Antwort teurer ist als die Tokens. Teams mit relevantem Volumen sollten beide Modelle einsetzen und nach repräsentativer Aufgabengröße, Wiederholungsrate und Kosten pro erledigter Aufgabe routen. Das ist günstiger, als sich vollständig auf eines der beiden festzulegen.
FAQ
Ist Grok 4.6 fürs Coding besser als Fable 5?
Auf CursorBench herrscht Gleichstand: Im August-Vergleich erzielte Grok 4.6 Extra High 70,8 %, Fable 5 Max 70,5 %. Fable 5 führt jedoch weiterhin den umfassenderen Artificial Analysis Intelligence Index an (62 gegenüber etwa 59) und gewinnt die schwierigsten One-Shot-Aufgaben. Ob es „besser“ ist, hängt also davon ab, ob bei dir die Kosten pro Aufgabe oder die maximale Korrektheit begrenzen.
Ist Grok 4.6 günstiger als Fable 5?
Ja, pro abgeschlossener CursorBench-Aufgabe um ungefähr den Faktor 6: 2,81 $ gegenüber 17,32 $. Der Vergleich der Token-Preise basiert auf dem veröffentlichten Grok-4.5-Tarif – 6 $ für Output gegenüber 50 $ bei Fable 5 je Million –, weil xAI keine separate Preisliste für 4.6 veröffentlicht hat. Oberhalb von 200K Tokens wird der Abstand kleiner, da sich Groks Preise dort ungefähr verdoppeln.
Welches Modell hat das größere Kontextfenster?
Fable 5: 1,000,000 Tokens gegenüber 500,000 bei Grok. Bei Workloads, die eine komplette Codebasis im Kontext halten, kann dieser Unterschied Groks Preisvorteil aufwiegen.
Kann Grok Build mein Claude-Code-Setup verwenden?
Ja. Grok Build liest CLAUDE.md, Claude-Code-Plugins, Skills, MCP-Server, Agents und Hooks automatisch ohne Portierung ein. Zusätzlich gibt es ein eigenes Verzeichnis .grok/ für Grok-spezifische Konfiguration.
Sind Grok-4.5-Benchmarks ein guter Ersatzwert für Grok 4.6?
Nicht für die Fähigkeiten. Grok 4.6 gewann gegenüber 4.5 ungefähr fünf Punkte im Intelligence Index, verringerte den Rückstand auf Fable 5 von sechs auf etwa drei Punkte und zog auf CursorBench mit Fable 5 Max gleich, während 4.5 dort klar zurücklag. Die Angaben zu Geschwindigkeit und Token-Preisen in diesem Artikel stammen von Grok 4.5, da für Grok 4.6 noch keine gleichwertigen Werte veröffentlicht wurden.
Der Zielkonflikt bleibt bestehen
Kein Benchmark in diesem Vergleich beantwortet abschließend, ob der Kostenvorteil auch dann trägt, wenn das Repository 50,000 Zeilen umfasst, das Ticket mehrdeutig ist und ein Fehlversuch eine Stunde Debugging kostet. Genau für diesen Fall gibt es Fable 5s 1M-Kontext und die höhere Intelligenzgrenze: teure Sicherheit gegen günstige Schritte mit Grok 4.6. Der Abstand ist groß genug, dass die meisten Teams beide Modelle aktiv halten.
Weiterführend: Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5