 AIREITER
Bei Coding-Agenten kippt die Kostenrechnung oft erst im Betrieb: Ein langer Kontext überschreitet plötzlich eine Preisgrenze, oder das Reasoning-Budget frisst das Output-Limit auf. Für kostensensible Workloads unter 200K Prompt-Tokens ist Grok 4.6 die naheliegende Wahl. Claude Opus 5 lohnt sich, wenn ein 1M-Token-Kontextfenster, 128K Output-Tokens oder die dokumentierten Agentensteuerungen von Anthropic tatsächlich benötigt werden.
Entscheidend ist zuerst der Rahmen des Workloads
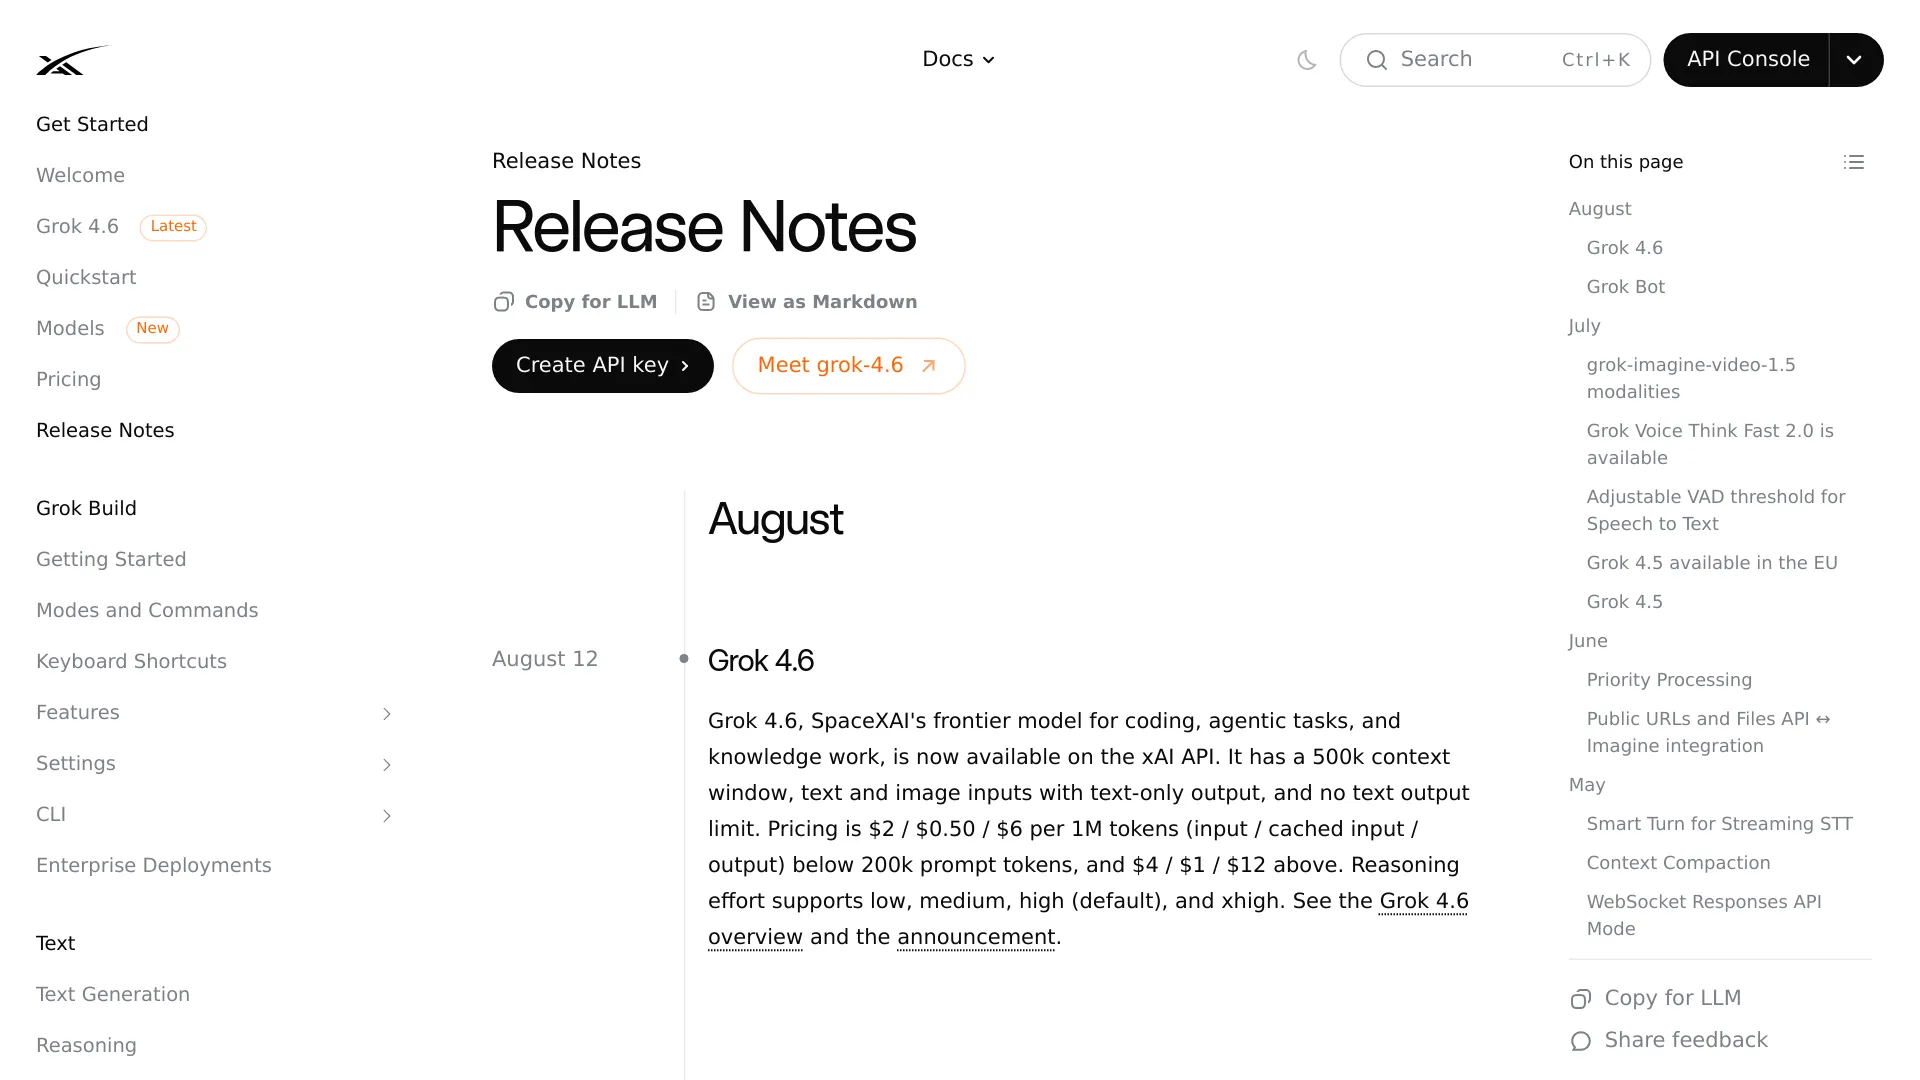
Grok 4.6 ist die praktische Standardwahl für textgenerierende Coding- oder Wissensarbeits-Agenten, solange sie unter der 200K-Prompt-Token-Preisgrenze von xAI bleiben. In den Release Notes vom August 12, 2026 nennt xAI ein Kontextfenster von 500K, Text- und Bildeingaben, Textausgabe sowie vier Aufwandseinstellungen von low bis xhigh. Die Developer Release Notes von xAI sind dafür die maßgebliche Primärquelle.
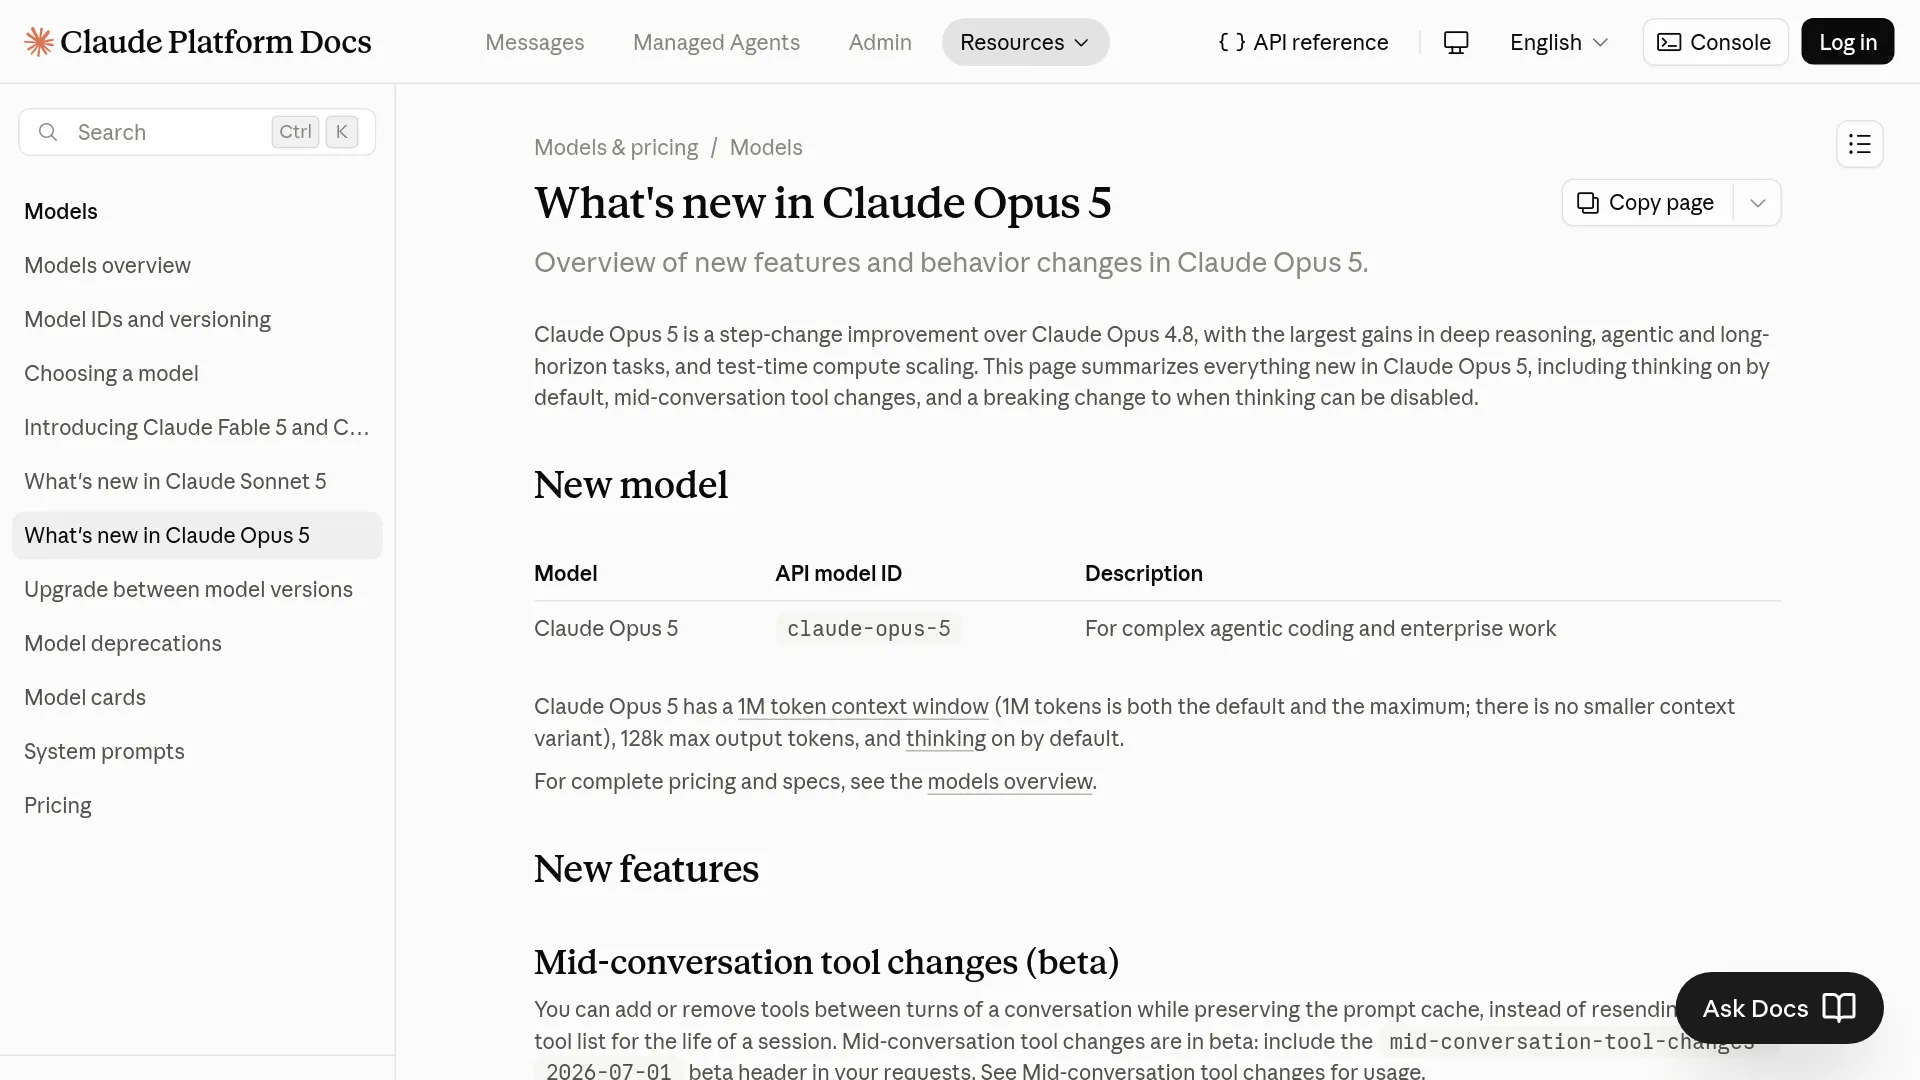
Claude Opus 5 passt besser, wenn 500K Tokens nicht reichen, ein Workflow bis zu 128K Output-Tokens benötigt oder die Integration auf den Fallback- und dynamischen Tool-Listen-Funktionen von Anthropic beruht. Anthropic dokumentiert ein standardmäßig verfügbares und maximales Kontextfenster von 1M Tokens, standardmäßig aktiviertes Thinking und die Verfügbarkeit von claude-opus-5 über die API sowie bei großen Cloud-Partnern. Für diese Entscheidung ist die Opus-5-Dokumentation der Claude Platform wichtiger als ein kleiner Abstand in einem Leaderboard.
Die hier zitierten Quellen liefern keinen gemeinsamen Benchmark, der jede Coding-Aufgabe eindeutig entscheidet. Prüfen Sie daher in Ihrem eigenen Test-Setup zunächst maximale Prompt-Größe, erforderliche Ausgabelänge, Tool-Vertrag und Kosten pro abgeschlossener Aufgabe.
API-Grenzen vor dem Benchmark-Vergleich klären
Grok 4.6 und Claude Opus 5 akzeptieren beide Text und Bilder und erzeugen Text. Die relevanten Unterschiede liegen bei Kontextkapazität, Abrechnung langer Kontexte, Output-Vertrag und Integrationssteuerung.
| API-Eigenschaft | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| Kontextfenster | 500K Tokens | 1M Tokens |
| Eingabemodalitäten | Text, Bild | Text, Bild, von Anthropic beschriebene PDF-/Dokument-Workflows |
| Ausgabemodalität | Text | Text |
| Maximale Textausgabe | Keine numerische Grenze in den xAI-Release-Notes genannt | 128K Tokens |
| Aufwandseinstellungen | low, medium, high, xhigh | low, medium, high, xhigh, max |
| Standardaufwand | high | high |
| Standardpreis für Eingaben | $2/M Tokens | $5/M Tokens |
| Standardpreis für Ausgaben | $6/M Tokens | $25/M Tokens |
| Regel für lange Prompts | $4/M Input und $12/M Output über 200K Prompt-Tokens | Keine entsprechende Schwelle in der Opus-5-Release-Dokumentation genannt |
| Gecachte Eingaben | $0.50/M unter 200K; $1/M über 200K | Mindestens 512 Tokens für cachebare Prompts, Cache-Preise separat dokumentiert |
Grok 4.6 hat die niedrigeren Listenpreise pro Token, verdoppelt diese aber oberhalb von 200K Prompt-Tokens. Opus 5 ist teurer, kann mit seinem 1M-Kontext jedoch Chunking- oder Retrieval-Overhead vermeiden, wenn ein Workflow diesen Kontext benötigt.
Ab 200K Tokens rechnet Grok 4.6 anders
Unterhalb von 200K Prompt-Tokens listet Grok 4.6 $2 pro Million Input-Tokens und $6 pro Million Output-Tokens. Überschreitet ein Prompt 200K Tokens, nennt xAI $4/M für Input und $12/M für Output; gecachte Eingaben kosten jeweils $0.50/M beziehungsweise $1/M. Diese Grenze ist wichtiger als der günstige Einstiegspreis. Die Release Notes von xAI führen beide Tarifstufen auf.
Zu den gelisteten Preisen kosten 100K ungecachte Input-Tokens plus 20K Output-Tokens $0.32; bei 250K Input-Tokens plus 20K Output-Tokens fallen nach Anwendung der höheren Stufe $1.24 an. Das sind Berechnungen pro Request, keine Schätzungen für komplette Agentenläufe: Retries, Tool-Calls, gecachte Präfixe und wachsender Kontext können die Rechnung dominieren.
Eine aktuelle Diskussion in r/grok nennt konfigurationsspezifische CursorBench-3.2-Werte von $2.81 pro Aufgabe und 46 Schritten für Grok 4.6 Extra High, gegenüber $8.23 und 78 Schritten für Opus 5 Max. Diese Werte sind als vom Autor gemeldete Ergebnisse seines Test-Setups zu verstehen, nicht als anbieterneutrale Zusage: Derselbe Beitrag meldet für Grok 4.6 26.0% bei Terminal-Bench 3.0, hinter anderen dort genannten Modellen.
Opus 5 verändert vor allem die Integrationsarchitektur
Bei Claude Opus 5 ist Thinking standardmäßig aktiviert. max_tokens ist ein hartes, gemeinsames Limit für verborgenes Thinking und sichtbaren Output. Wer von Anfragen für Opus 4.8 ohne Thinking migriert, braucht daher möglicherweise ein höheres Output-Budget. Anthropic weist außerdem darauf hin, dass thinking: {"type":"disabled"} in Kombination mit xhigh oder max zu HTTP 400 führt. Die Migrationshinweise nennen zwei Optionen: bei deaktiviertem Thinking den Aufwand reduzieren oder die Einstellung zum Deaktivieren von Thinking entfernen.
Claude Opus 5 senkt zudem die Mindestgröße eines cachebaren Prompts von 1,024 Tokens bei Opus 4.8 auf 512 Tokens. Die Beta-Steuerungen erlauben Tool-Änderungen mitten in einer Konversation, ohne den Prompt-Cache zu invalidieren, und bieten einen verwalteten Modus fallbacks: "default". Das ist relevant, wenn ein Agent wechselnde Berechtigungen oder Tool-Sets hat; für einen einfachen zustandsfreien Completion-Endpunkt spielt es keine Rolle.
Fast mode ist eine API-exklusive Research Preview und kostet $10/M Input sowie $50/M Output, also das Doppelte der Standardpreise von Opus 5. Laut Anthropic ist der Modus nicht über Amazon Bedrock, Google Cloud oder Microsoft Foundry verfügbar. Portabilität und Geschwindigkeit sollten deshalb nicht einfach vorausgesetzt werden. Die Launch-Ankündigung von Anthropic nennt Standardpreise von $5/M Input und $25/M Output.
Bei Coding-Agenten zeigt die Evidenz eine Richtung, keinen Gesamtsieger
Anthropic berichtet, dass Opus 5 bei maximalem Aufwand rund 70.0% auf CursorBench 3.2 bei etwa $8.50 pro Aufgabe erreicht. Das liegt innerhalb von 0.5 Prozentpunkten von Fable 5s gemeldetem Bestwert, bei ungefähr der Hälfte der Kosten. Es handelt sich um von Anthropic dargestellte Ergebnisse und damit um Evidenz aus der Anbieterbewertung, nicht um ein Audit über mehrere Provider hinweg. Die Opus-5-Ankündigung beschreibt für Frontier-Bench fünf Versuche pro Aufgabe mit dem internen Run von Anthropic.
Für Code Review ist eine unabhängig wirkende, aber engere Messung greifbarer. CodeRabbit testete rund 100 verifizierte Fehlermuster aus echten Open-Source-Pull-Requests, führte jede Konfiguration dreimal aus und bewertete nachgefilterte Review-Kommentare. Bei xhigh Aufwand erkannte die Opus-5-Konfiguration 55.2% der bekannten Probleme gegenüber 61.1% der Produktions-Baseline; die verwertbare Präzision lag bei 39.3% gegenüber 35.2%. Zudem erzeugte sie 92 Nitpicks statt 23. Die Opus-5-Evaluierung von CodeRabbit empfiehlt deshalb eine spezifische, auf Präzision ausgerichtete Rolle, statt Opus 5 als einziges Sicherheitsnetz einzusetzen.
Die daraus ableitbare Regel ist konkret: Opus 5 auf mehreren Aufwandsebenen testen und Recall, Präzision, Token-Verbrauch sowie Review-Rauschen an den eigenen Pull Requests messen. Für Grok 4.6 liefern die aktuellen Release Notes von xAI API-Vertrag und Preise, aber keine direkt vergleichbare Code-Review-Studie. Aus einem Score für Coding-Agenten sollte kein Vorteil beim Code Review abgeleitet werden.
Diese Matrix hilft bei der Modellwahl im Deployment
Grok 4.6 ist die Empfehlung für Agenten, deren üblicher Prompt unter 200K Tokens bleibt und bei denen niedrige gelistete API-Kosten Priorität haben. Legen Sie ein Evaluierungsbudget rund um diese Grenze fest: Ein Repository-Agent kann sie durch Tool-Output und Retries überschreiten, selbst wenn sein erster Prompt klein ist.
Claude Opus 5 ist die Empfehlung für Repository-, Dokument- oder Agentensitzungen, die mehr als 500K Tokens aktiven Kontext, bis zu 128K Output oder die dokumentierten Tool-Change- und Fallback-Steuerungen von Anthropic benötigen. Beginnen Sie mit high und testen Sie anschließend niedrigere Aufwandseinstellungen, bevor Sie davon ausgehen, dass sich max auszahlt.
Für automatisiertes Code Review sollten Sie keines der beiden Modelle anhand eines allgemeinen Coding-Leaderboards auswählen. Nutzen Sie einen gelabelten Pull-Request-Satz, erfassen Sie Problem-Recall und False-Positive-Last und behalten Sie einen zweiten Review-Pfad für Defekte bei Concurrency, API-Nutzung und Validierung. CodeRabbit fand diese Kategorien bei seinen getesteten Opus-5-Konfigurationen schwächer. Die Kategoriebefunde sind ein Grund, den Aufgaben-Fit zu testen, keine Aussage über alle Claude-Deployments.
| Deployment-Situation | Standardwahl | Entscheidender Faktor |
|---|---|---|
| Kostensensibler Coding-Agent unter 200K Prompt-Tokens | Grok 4.6 | Die gelisteten Preise von $2/M Input und $6/M Output |
| Lange Repository- oder Dokumentsitzung über 500K Kontext | Claude Opus 5 | 1M-Kontextfenster und 128K-Output-Limit |
| Agent mit dynamisch wechselnden Tools | Claude Opus 5 | Beta-Tool-Änderungen während der Konversation erhalten den Cache |
| Aufgabe mit häufigen Prompts über 200K Tokens | Beide evaluieren | Grok 4.6 verdoppelt die gelisteten Tokenpreise an dieser Schwelle |
| Code-Review-Pipeline | Beide mit gelabelten PRs evaluieren | Recall, Präzision, Retries und Review-Rauschen zählen mehr als ein Spitzenwert |
FAQ
Ist Grok 4.6 günstiger als Opus 5?
Unter 200K Prompt-Tokens listet xAI für Grok 4.6 $2/M Input und $6/M Output, gegenüber $5/M Input und $25/M Output bei Opus 5. Die gelisteten Preise von Grok 4.6 verdoppeln sich oberhalb von 200K Prompt-Tokens. Vergleichen Sie daher die Kosten pro abgeschlossener Aufgabe und nicht nur den ersten Request.
Welches Modell sollte ich fürs Coding verwenden?
Wählen Sie Grok 4.6 für niedrigere gelistete API-Preise, wenn Ihr Agent üblicherweise unter 200K Prompt-Tokens bleibt. Wählen Sie Opus 5, wenn 1M Kontext, 128K Output oder die Agentensteuerungen von Anthropic erforderlich sind. Validieren Sie beide Optionen mit der Sprache, Repository-Struktur und Tool-Schleife, die Sie tatsächlich einsetzen.
Der nächste Schritt fürs Deployment
Führen Sie dieselben 20 bis 50 repräsentativen Aufgaben mit jedem Kandidaten aus – mit festen Tools, festem Retry-Limit und Token-Logging. Wählen Sie das Modell, das Ihre geforderte Erfolgsquote zu den niedrigeren Kosten pro abgeschlossener Aufgabe erreicht. Das andere Modell bleibt als geroutete Option für Workloads erhalten, bei denen sein Kontext- oder Control-Plane-Vorteil ausschlaggebend ist.
Weiterführend: Claude Opus 5 API pricing guide, Grok 4.6 release details und Grok 4.6 vs GPT-5.6.