 AIREITER
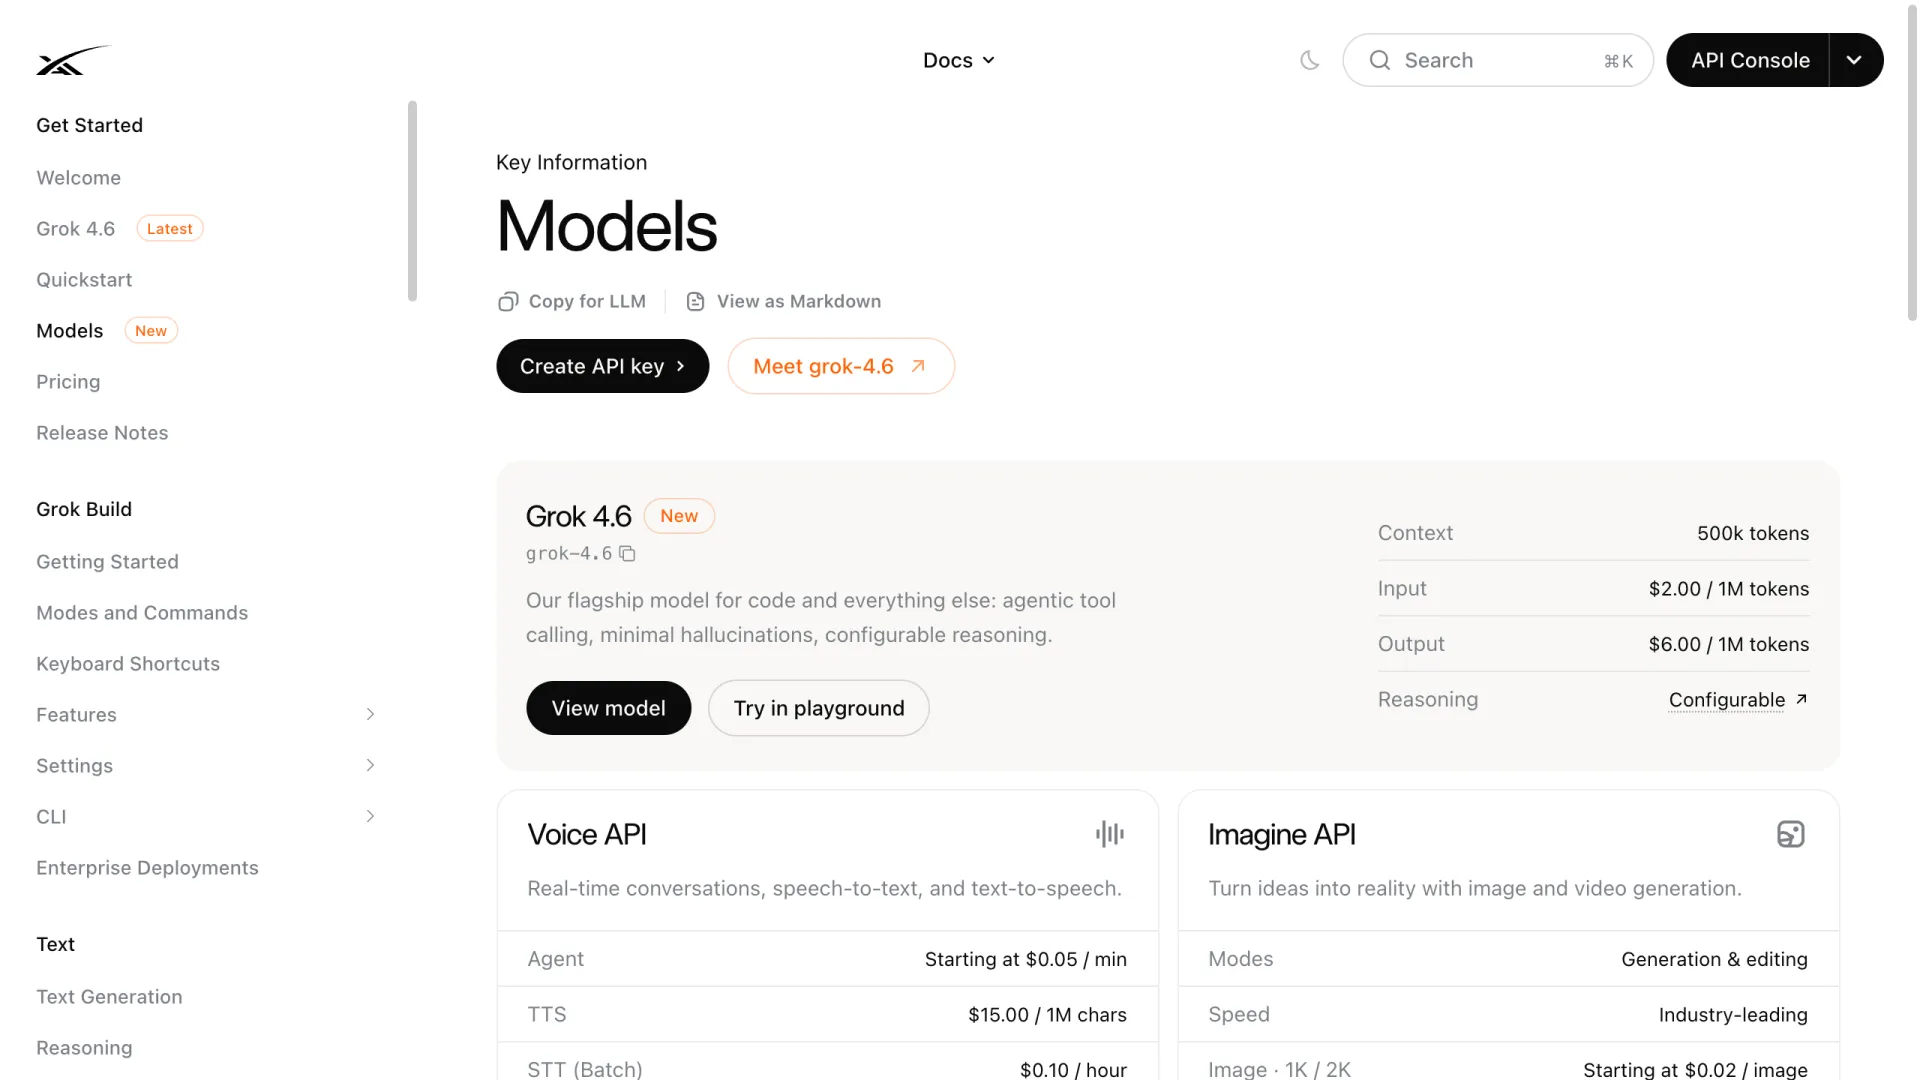
Auf dem Papier kostet Grok 4.6 exakt so viel wie Grok 4.5: $2.00 für Input und $6.00 für Output je Million Tokens, dazu ein Kontextfenster von 500K Tokens. Verfügbar ist das Modell seit dem 12. August 2026 – fünf Tage nach dem Termin, den Elon Musks Ankündigung von „zwei Wochen“ nahelegte. In der Praxis wird es trotzdem teurer: Gecachte Eingaben kosten gegenüber 4.5 um 67 % mehr, und unabhängige Messungen zeigen einen höheren Tokenverbrauch für dieselben Aufgaben.
Das ist mit Grok 4.6 am 12. August erschienen
Die Modell-ID lautet grok-4.6. Laut den Release Notes von SpaceXAI wurde es am 12. August 2026 für die API freigeschaltet. Die dokumentierten Eckdaten:
| Eigenschaft | Grok 4.6 |
|---|---|
| Modell-ID | grok-4.6 |
| Kontext | 500K Tokens |
| Eingabe | Text und Bild |
| Ausgabe | Nur Text, kein angegebenes Output-Limit |
| Reasoning-Aufwand | low, medium, high (Standard), xhigh |
| Wissens-Cutoff | 1. Februar 2026 |
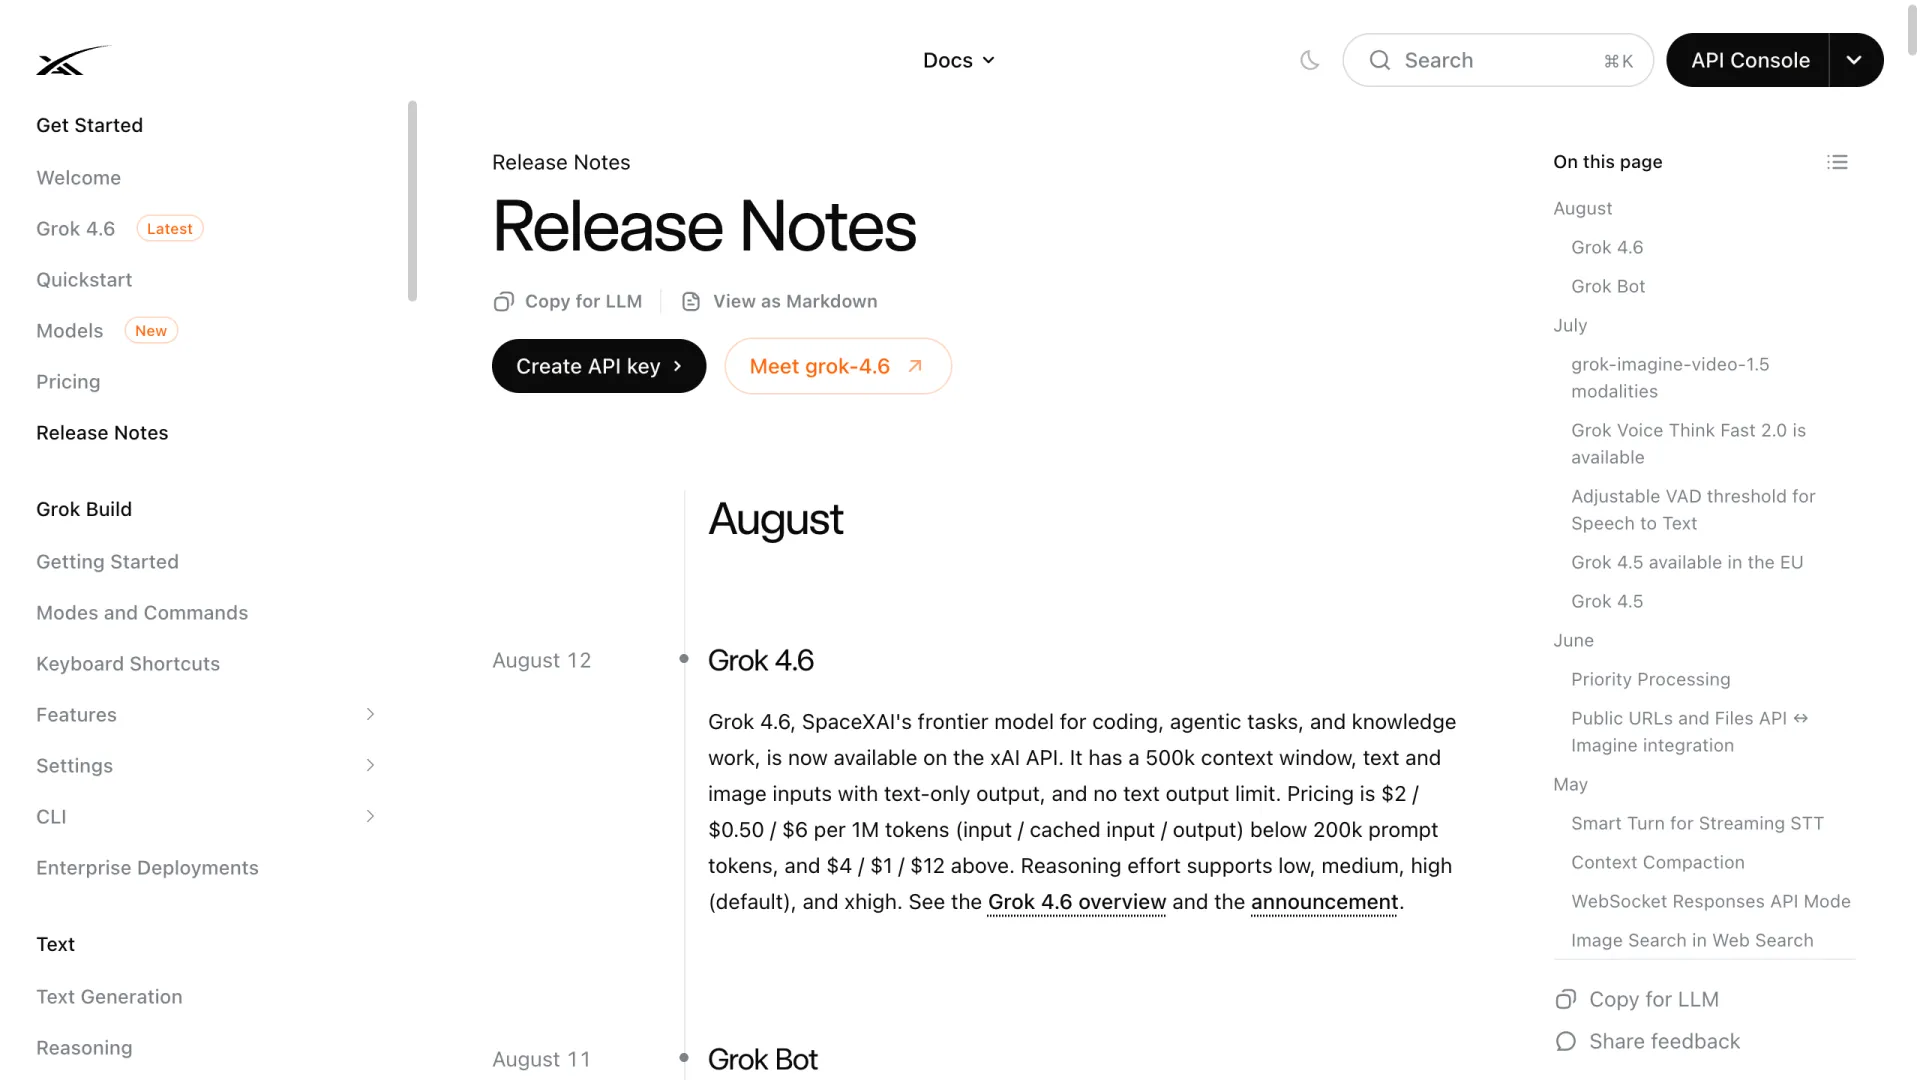
Zwei Punkte sind neu. Mit xhigh gibt es eine vierte Reasoning-Stufe, die Grok 4.5 nicht kennt; dort endet die Skala bei high. Neu dokumentiert ist außerdem der Wissens-Cutoff vom 1. Februar 2026. Das ist relevant, wenn zeitgebundene Fragen bislang um den blinden Fleck des Modells herumgeroutet wurden.
Im Modellkatalog führt SpaceXAI Grok 4.6 als Flaggschiff für Code und Chat. In der Seitenleiste trägt es das Label Latest, die Seite selbst ist auf den 12. August 2026 datiert. Grok 4.5 bleibt parallel erhältlich und steht weiterhin mit eigenen Tarifen auf der Preisseite.
Die Verbreitung startete am ersten Tag breit. In der Ankündigung nennt SpaceXAI Cursor und Grok Build, jeweils mit 2x enthaltenem Nutzungskontingent in der ersten Woche. Hinzu kommen API-Zugang und Partner wie OpenRouter, Vercel und Cloudflare. Erwähnt wird auch eine schnelle Variante zum doppelten Preis. Da sie noch nicht in der öffentlichen Preisliste auftaucht, ist der 2x-Wert als Angabe aus der Ankündigung zu verstehen, nicht als veröffentlichter Tarif.
Grok 4.6: Listenpreis gleich, Cache deutlich teurer
Die Preise für Input und Output übernimmt Grok 4.6 unverändert von Grok 4.5. Anders sieht es beim gecachten Input aus.
| Preis je 1M Tokens | Grok 4.5 | Grok 4.6 |
|---|---|---|
| Input (unter 200K) | $2.00 | $2.00 |
| Gecachter Input (unter 200K) | $0.30 | $0.50 |
| Output (unter 200K) | $6.00 | $6.00 |
| Input / gecacht / Output (200K+) | $4.00 / $0.60 / $12.00 | $4.00 / $1.00 / $12.00 |
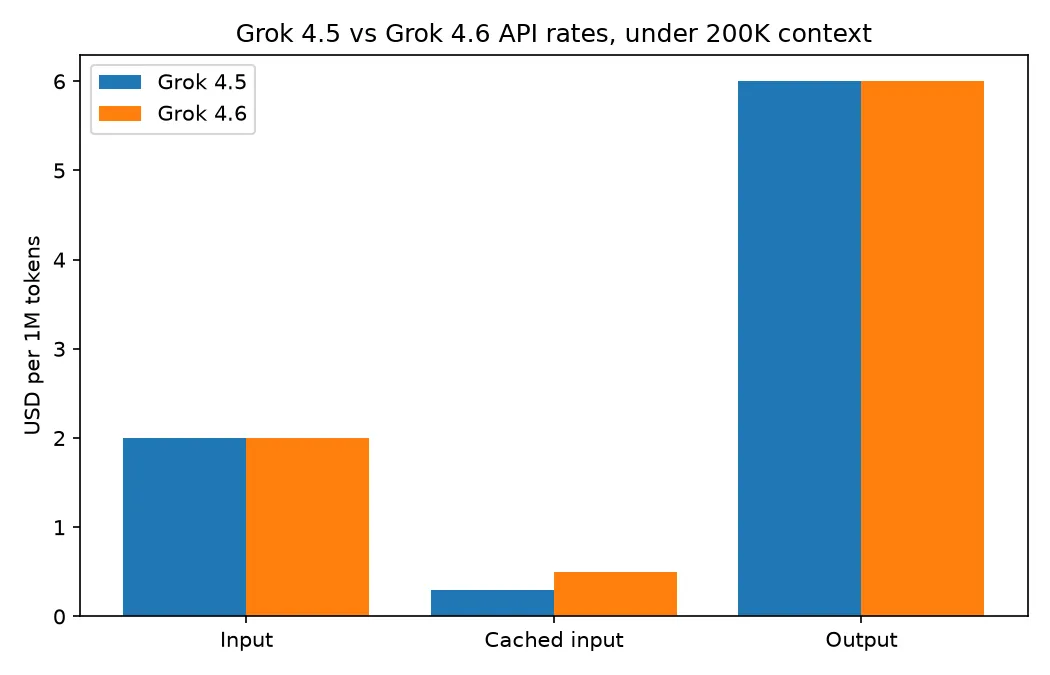
Der Rabatt auf gecachte Eingaben sinkt damit von 85 % auf 75 %: Pro Million Tokens fallen 20 Cent mehr an – ausgerechnet für den Posten, der bei Agenten-Schritten und nicht primär mit der Anzahl der Aufgaben wächst. Ein Harness, das täglich 50M gecachte Tokens erneut abspielt, zahlt mit 4.6 $15.00 statt $9.00 mit 4.5.
Die Regel für lange Kontexte bleibt unverändert und ist weiterhin eine häufige Kostenfalle. Erreicht der Prompt einer Anfrage 200K Tokens, wird jeder Token dieser Anfrage zum höheren Tarif abgerechnet. Ein Call mit 210K Tokens kostet also über die gesamte Anfrage $4.00 je Million Input-Tokens und nicht einen Mischpreis aus beiden Stufen. Auch der öffentliche Modelleintag von OpenRouter nennt dieselben Tarife und dieselbe 200K-Schwelle. Über einen Drittanbieter zu routen, ändert daher nichts an der Rechnung.
Bei welchen offiziellen Evals Grok 4.6 vorn liegt – und wo nicht
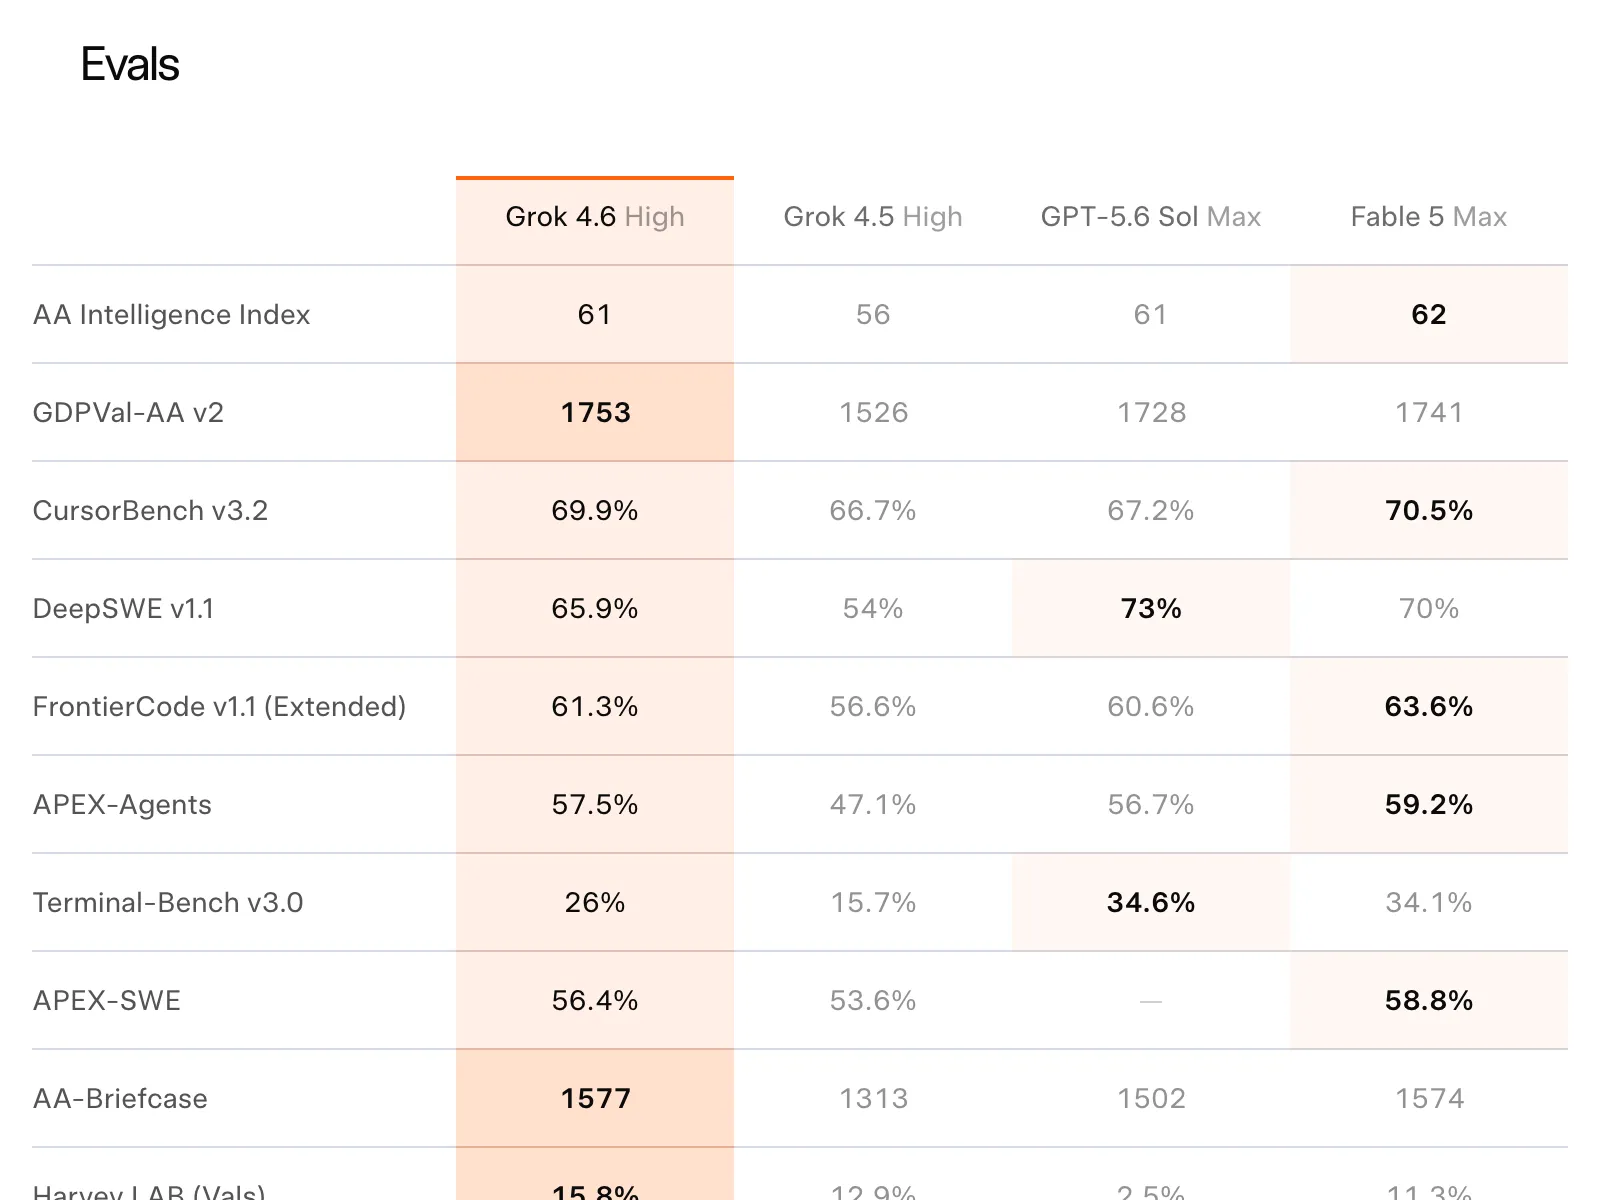
SpaceXAI hat einen Vergleich über zehn Zeilen gegen Grok 4.5, GPT-5.6 Sol Max und Fable 5 Max veröffentlicht. Grok 4.6 erreicht in drei davon den Spitzenwert: GDPVal-AA v2 (1753), AA-Briefcase (1577) und Harvey LAB (15.8%). Die übrigen sieben gewinnt es nicht. Für Routing-Entscheidungen sind diese acht Werte besonders relevant:
| Eval | Grok 4.6 | Grok 4.5 | GPT-5.6 Sol | Fable 5 |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54% | 73% | 70% |
| FrontierCode v1.1 | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26% | 15.7% | 34.6% | 34.1% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
Besonders genau sollte man auf Terminal-Bench schauen. Grok 4.6 erzielt 26 %, während GPT-5.6 Sol auf 34.6 % und Fable 5 auf 34.1 % kommen. Das sind acht Punkte Rückstand und Rang drei bei einem Eval, der einem Agenten am ähnlichsten ist, der eine Shell bedient. DeepSWE zeigt mit anderen Zahlen dasselbe Bild: 65.9 % gegenüber 73 % für Sol. Wer terminalgesteuerte Agenten betreibt, findet laut Tabelle des Herstellers hier nicht das führende Modell.
Gegenüber Grok 4.5 sind die Fortschritte jedoch real und durchgehend. Jeder Wert steigt; bei APEX-Agents (47.1 % auf 57.5 %) und Terminal-Bench (15.7 % auf 26 %) sind es jeweils mehr als zehn Punkte. SpaceXAI führt das auf einen längeren ergänzenden Trainingslauf, neu erzeugte SFT-Trajektorien und agentisches RL in Coding- und Knowledge-Work-Umgebungen zurück. Nicht genannt wird in der Ankündigung eine Parameterzahl. Die mit dem Modell verknüpfte Zahl von 2 Billionen stammt von Musk, nicht aus dem Release.
Was die bessere Leistung tatsächlich kostet
Hersteller-Tabellen liefern Scores, aber keine Kosten pro Score. Artificial Analysis veröffentlicht beides. In der Messung vom 13. August wird der eigentliche Kompromiss von Grok 4.6 sichtbar.
| Auf demselben Index gemessen | Grok 4.5 (high) | Grok 4.6 (high) |
|---|---|---|
| Intelligence Index | 56 (#16 von 184) | 61 (#6 von 184) |
| Output-Geschwindigkeit | 56.9 Tokens/s (#102) | 67.6 Tokens/s (#74) |
| Generierte Output-Tokens | 60M | 72M |
| Kosten der vollständigen Evaluation | $579.21 | $1,068.47 |
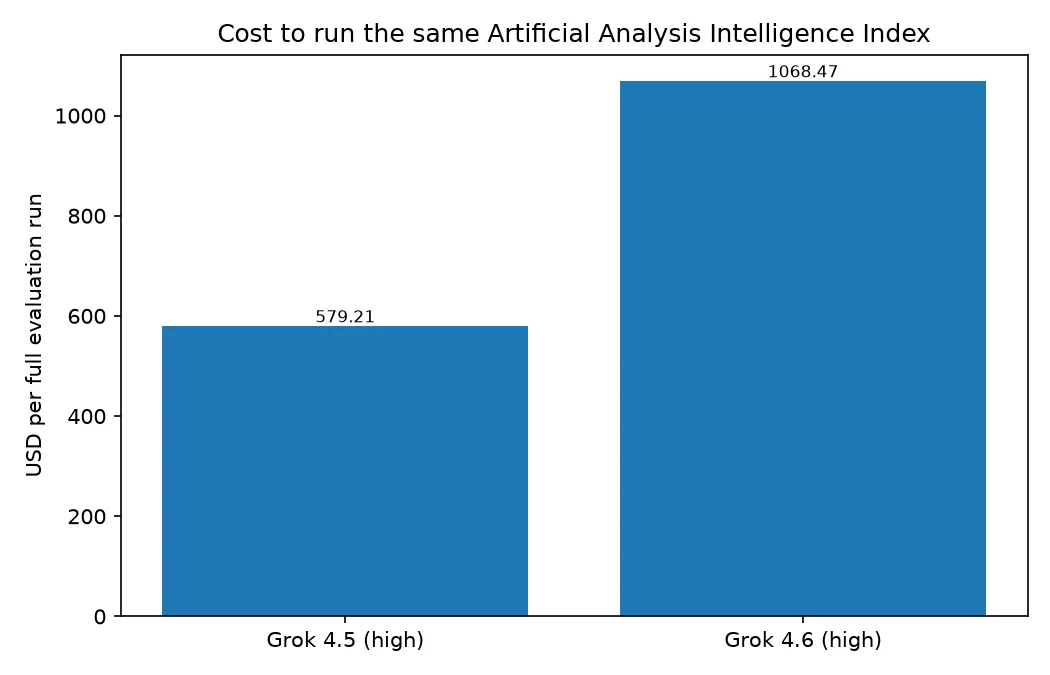
Fünf Punkte mehr Intelligenz kosten das 1.8-Fache. Trotz identischer Listenpreise kostete dieselbe Benchmark-Suite $489 mehr: zum Teil wegen der höheren Ausführlichkeit mit 72M statt 60M Output-Tokens, zum Teil wegen der oben beschriebenen Cache-Preiserhöhung. Artificial Analysis veröffentlicht keine Aufschlüsselung nach Kostenpositionen. Die 1.8x sind daher ein beobachteter Gesamtwert und keine Formel, die sich nachrechnen lässt.
Bei der Geschwindigkeit geht die Entwicklung in die richtige Richtung: 67.6 Output-Tokens pro Sekunde gegenüber 56.9 bei 4.5. Damit steigt das Modell aus der unteren Hälfte ungefähr bis in den Median der 184 Modelle seiner Klasse auf.
Musks Ankündigungen im Abgleich mit dem Release
Der Name tauchte zunächst in einer Antwort aus drei Wörtern auf. Am 18. Juli schrieb Musk in einer Antwort auf @minchoi: „Our 2T model, which is better than our 1.5T in every way, will finish initial training next week. It might be able to exceed Kimi, but with speed and token efficiency close to our 1.5T (aka Grok 4.5).“ Auf Andrew Currans Frage, ob damit Grok 4.6 gemeint sei, antwortete er: „Yeah, Grok 4.6.“
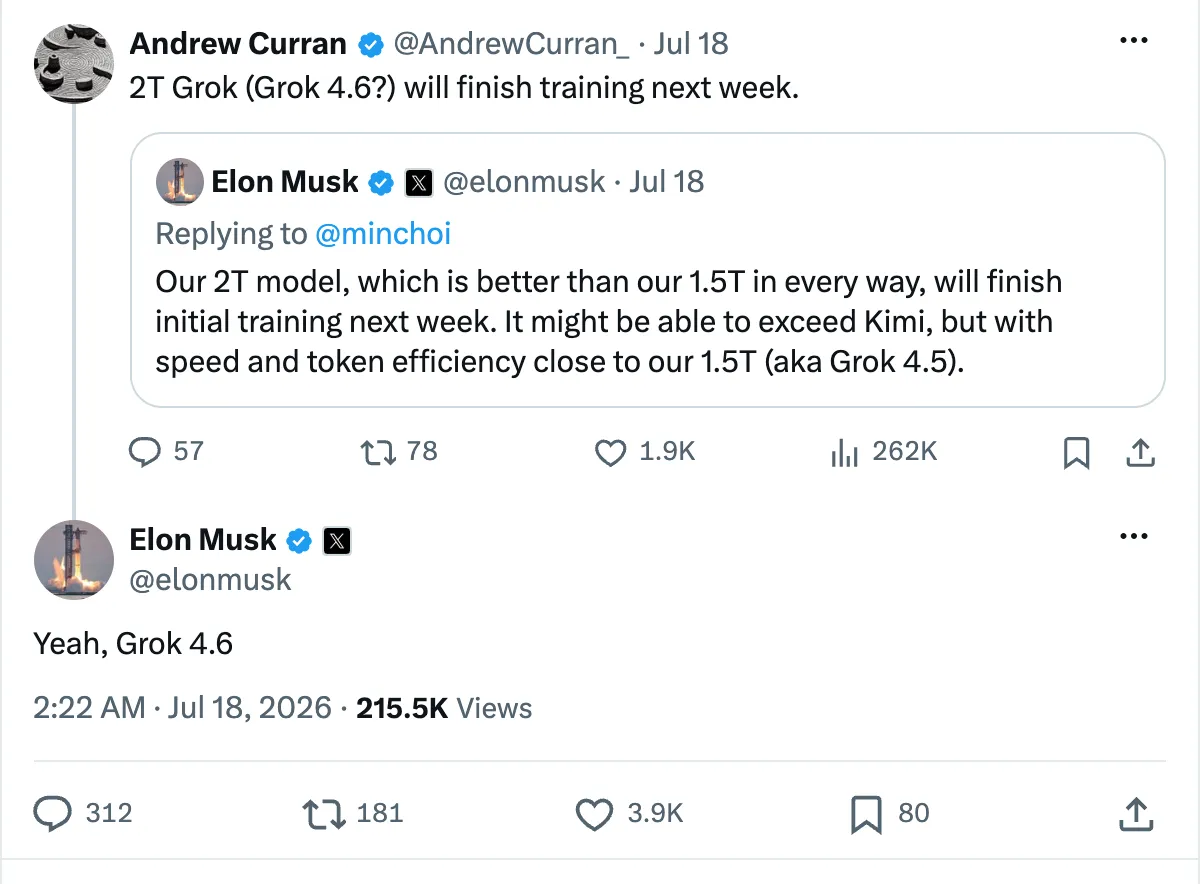
Am 24. Juli folgte der Zeitplan: „Grok 4.6 in 2 weeks and Grok 4.7 in 4 weeks.“ Zwei Wochen ab diesem Datum führen ungefähr zum 7. August; erschienen ist das Modell am 12. August, fünf Tage später.
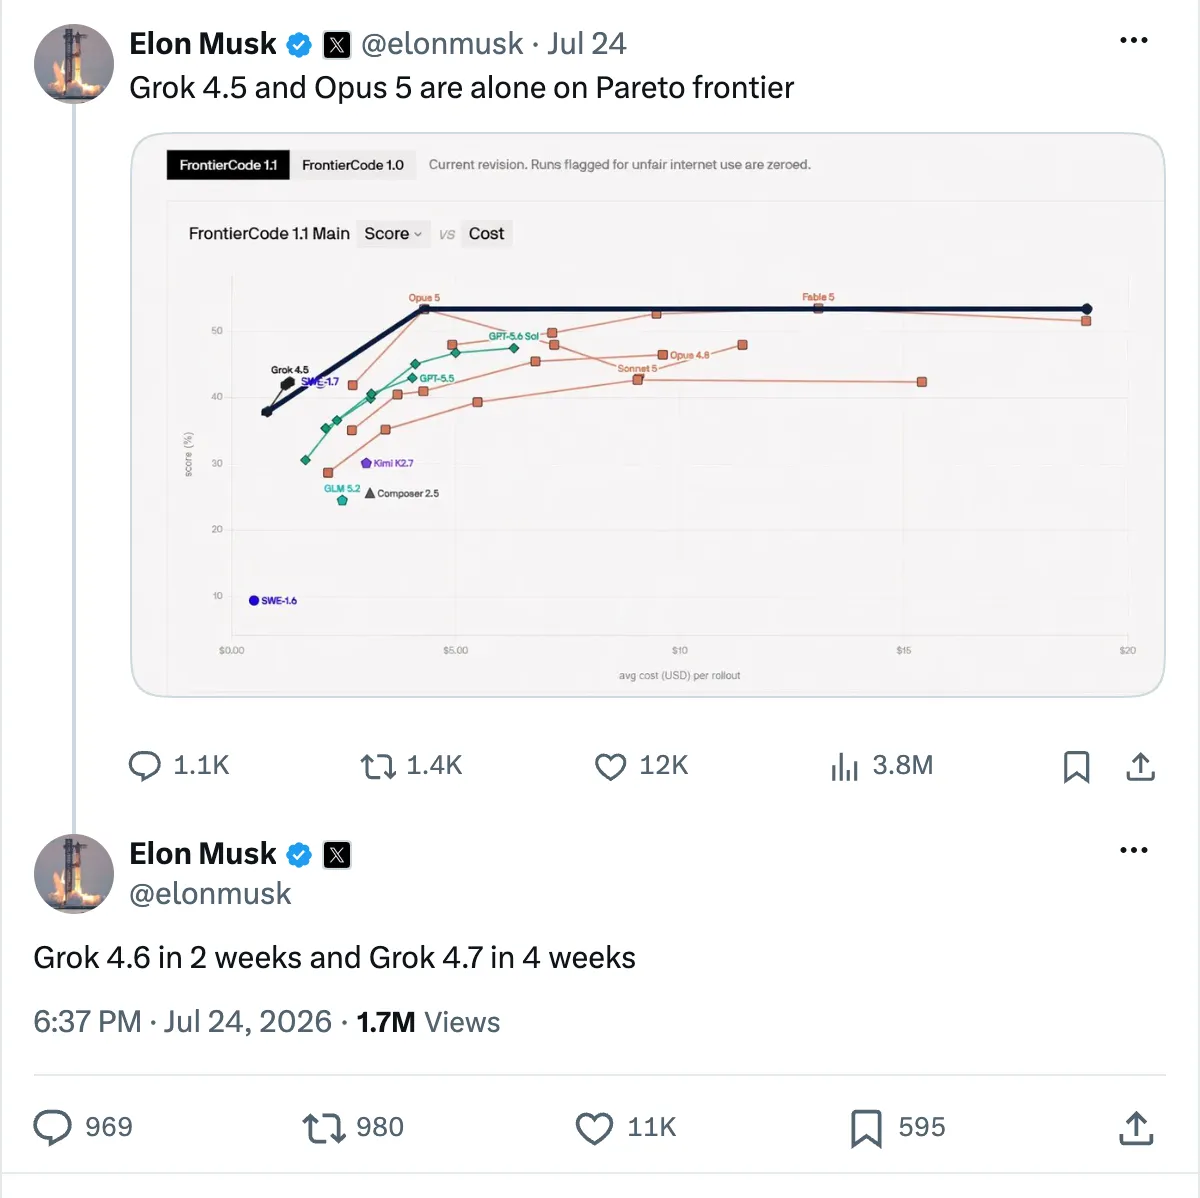
Drei Aussagen aus diesen Posts haben das Release nicht unverändert überstanden:
- 2 Billionen Parameter sind weiterhin nicht bestätigt. Weder die Ankündigung noch Modelldokumentation oder Release Notes von SpaceXAI nennen eine Parameterzahl für Grok 4.6.
- „Token efficiency close to Grok 4.5“ widerspricht der Messung von Artificial Analysis: 72M Output-Tokens statt 60M bei derselben Evaluation.
- „Might exceed Kimi“ bleibt gegenüber K3 von Moonshot ungeprüft. Die SpaceXAI-Tabelle vergleicht nur mit GPT-5.6 Sol und Fable 5.
Lohnt sich der Wechsel von Grok 4.5 auf Grok 4.6?
Für agentische Aufgaben und Knowledge Work lautet die Antwort beim Umstieg von Grok 4.5: ja – aber die Tokenrechnung sollte nach einer Woche geprüft werden, nicht erst beim Migrationsbeschluss. Grok 4.5 bleibt zu den bisherigen Preisen verfügbar. Der Wechsel ist also reversibel und sollte gemessen statt vorausgesetzt werden.
Ein sofortiger Umstieg bietet sich für Long-Horizon-Agenten oder Wissensaufgaben an: APEX-Agents gewinnt 10.4 Punkte, GDPVal-AA 227 Punkte, und die schnellere Generierung summiert sich bei mehrstufigen Abläufen. Bei cache-lastigem und preissensiblem Traffic ist Grok 4.5 die bessere Wahl. Der Anstieg der Cache-Read-Kosten um 67 % ist eine echte Verschlechterung, während die Scores von 4.5 mit dem Start von 4.6 nicht gesunken sind. Für Terminal-Agenten sollte man sich gezielt anderswo umsehen: In der eigenen Tabelle von SpaceXAI liegt Grok 4.6 acht Punkte hinter GPT-5.6 Sol und Fable 5.
Vor der Umstellung einer Production-Route sind drei Punkte zu prüfen:
- Beide IDs sind Aliase. Die Alias-Regeln von SpaceXAI verweisen bei
grok-4.6auf den neuesten stabilen Build und beigrok-4.6-latestauf den aktuellsten Build. Nur eine datierte ID nach dem Muster<modelname>-<date>ist eingefroren. Weder Modellkatalog noch OpenRouter führen eine datierte 4.6-Variante. Für reproduzierbare Workflows gibt es derzeit keine pinbare Version. - Reasoning-Aufwand neu testen. Die neue Stufe
xhighist kein kostenloses Upgrade. Sie verbraucht mehr Tokens bei einem Modell, das bereits messbar ausführlicher als sein Vorgänger arbeitet. Der Standardwerthighist der passende Vergleichsmodus zu 4.5. - Verfügbarkeit beim Provider kontrollieren. Verfügbarkeit am ersten Tag bei SpaceXAI bedeutet nicht automatisch Verfügbarkeit bei allen Anbietern. Bei einer Abfrage von
/v1/modelsam 13. August lieferten sowohl die offizielle API als auch OpenRoutergrok-4.6. Ein von mir getesteter OpenAI-kompatibler Reseller-Endpunkt reichte dagegen nur bisgrok-4.5und lehnte die neue ID mitmodel_not_foundab. Vor dem Traffic-Routing sollte die konkrete ID mit dem eigenen Key geprüft werden.
FAQ
Was kostet die Grok 4.6 API?
Unterhalb von 200K Kontext kosten eine Million Input-Tokens $2.00 und eine Million Output-Tokens $6.00; gecachter Input kostet $0.50. Ab 200K Prompt-Tokens wird die komplette Anfrage zu $4.00 für Input, $1.00 für gecachten Input und $12.00 für Output abgerechnet. Eine schnelle Variante zum doppelten Preis wird in der Ankündigung erwähnt, steht aber nicht auf der öffentlichen Preisseite.
Ist Grok 4.6 besser als Grok 4.5?
In jedem von SpaceXAI veröffentlichten Benchmark: ja. Im AA Intelligence Index erreicht es 61 statt 56, die größten Zuwächse gibt es bei agentischen Evals. Die unabhängige Messung ergänzt jedoch einen wichtigen Vorbehalt: Bei derselben Evaluation erzeugte es 72M Output-Tokens gegenüber 60M bei Grok 4.5. Dieselbe Aufgabe wird damit teurer.
Wie viele Parameter hat Grok 4.6?
Nicht bekannt. Musk beschrieb am 18. Juli 2026 ein Modell mit 2 Billionen Parametern und bestätigte anschließend den Namen. Die Release-Materialien von SpaceXAI nennen jedoch weder eine Parameterzahl noch Architekturdetails oder die Zahl der pro Token aktivierten Parameter.
Wie groß sind Kontextfenster und Wissens-Cutoff von Grok 4.6?
Das Kontextfenster umfasst 500K Tokens. Das Modell verarbeitet Text und Bilder als Input, gibt aber nur Text aus. Die Dokumentation nennt den 1. Februar 2026 als Wissens-Cutoff. Ohne aktivierte serverseitige Web Search oder X Search hat das Modell keinen Zugriff auf Ereignisse danach.
Wird Grok von xAI oder SpaceXAI entwickelt?
Beide Namen bezeichnen dasselbe Unternehmen. Die Entwicklerdokumentation heißt „SpaceXAI Docs“, während im Footer der Ankündigung nach dem Wechsel unter SpaceX im Jahr 2026 weiterhin X.AI LLC steht. Die Domains unter x.ai und die Modell-IDs nach dem Muster grok-* wurden nicht umbenannt.
Wann erscheint Grok 4.7?
Ein Datum wurde nicht angekündigt. Musks Post vom 24. Juli verortete Grok 4.7 bei ungefähr vier Wochen später, also etwa am 21. August 2026. Grok 4.6 kam bereits fünf Tage nach seinem eigenen implizierten Termin.
Weiterführende Artikel
- Grok 4.5: Alles, was wir bisher wissen
- GPT-5.6 Sol und Terra vs. Grok 4.5
- Claude Opus 5: Was bestätigt ist
Preise, Modell-IDs und Benchmark-Werte wurden am 13. August 2026 anhand der SpaceXAI-Dokumentation, der Grok-4.6-Ankündigung und Artificial Analysis überprüft.