 AIREITER
Auf der Preisliste sieht GPT Image 2.6 zunächst unverändert aus. In der Praxis sind günstige Entwürfe aber deutlich teurer geworden: Für gpt-image-2.6-flare und gpt-image-2.6-sunburst nennt OpenAI dieselben Tokenpreise, während bei Low-Quality-Ausgaben 4,2-mal so viele Tokens anfallen wie bei GPT Image 2.5. Wer quality explizit setzt, vermeidet zusätzliche Kostenüberraschungen.
Ein 1:1-Bild kostet $0.025 bis $0.211 – Low ist nicht mehr günstig
Bei identischem Prompt kostet ein GPT-Image-2.6-Bild im 1:1-Format je nach Qualitätsstufe ungefähr $0.025 bei Low bis $0.211 bei Max. TrezaLabs hat am 5. November 2026 denselben 1:1-Prompt in fünf Qualitätsstufen gerendert und $0.00003 pro Bild-Output-Token berechnet.
| Qualität | Gemessene Output-Tokens | Ungefähre Kosten pro 1:1-Bild |
|---|---|---|
| Low | 824 | $0.025 |
| Medium | 1,449 | $0.043 |
| High | 1,756 | $0.053 |
| Extra high | 3,122 | $0.094 |
| Max | 7,024 | $0.211 |
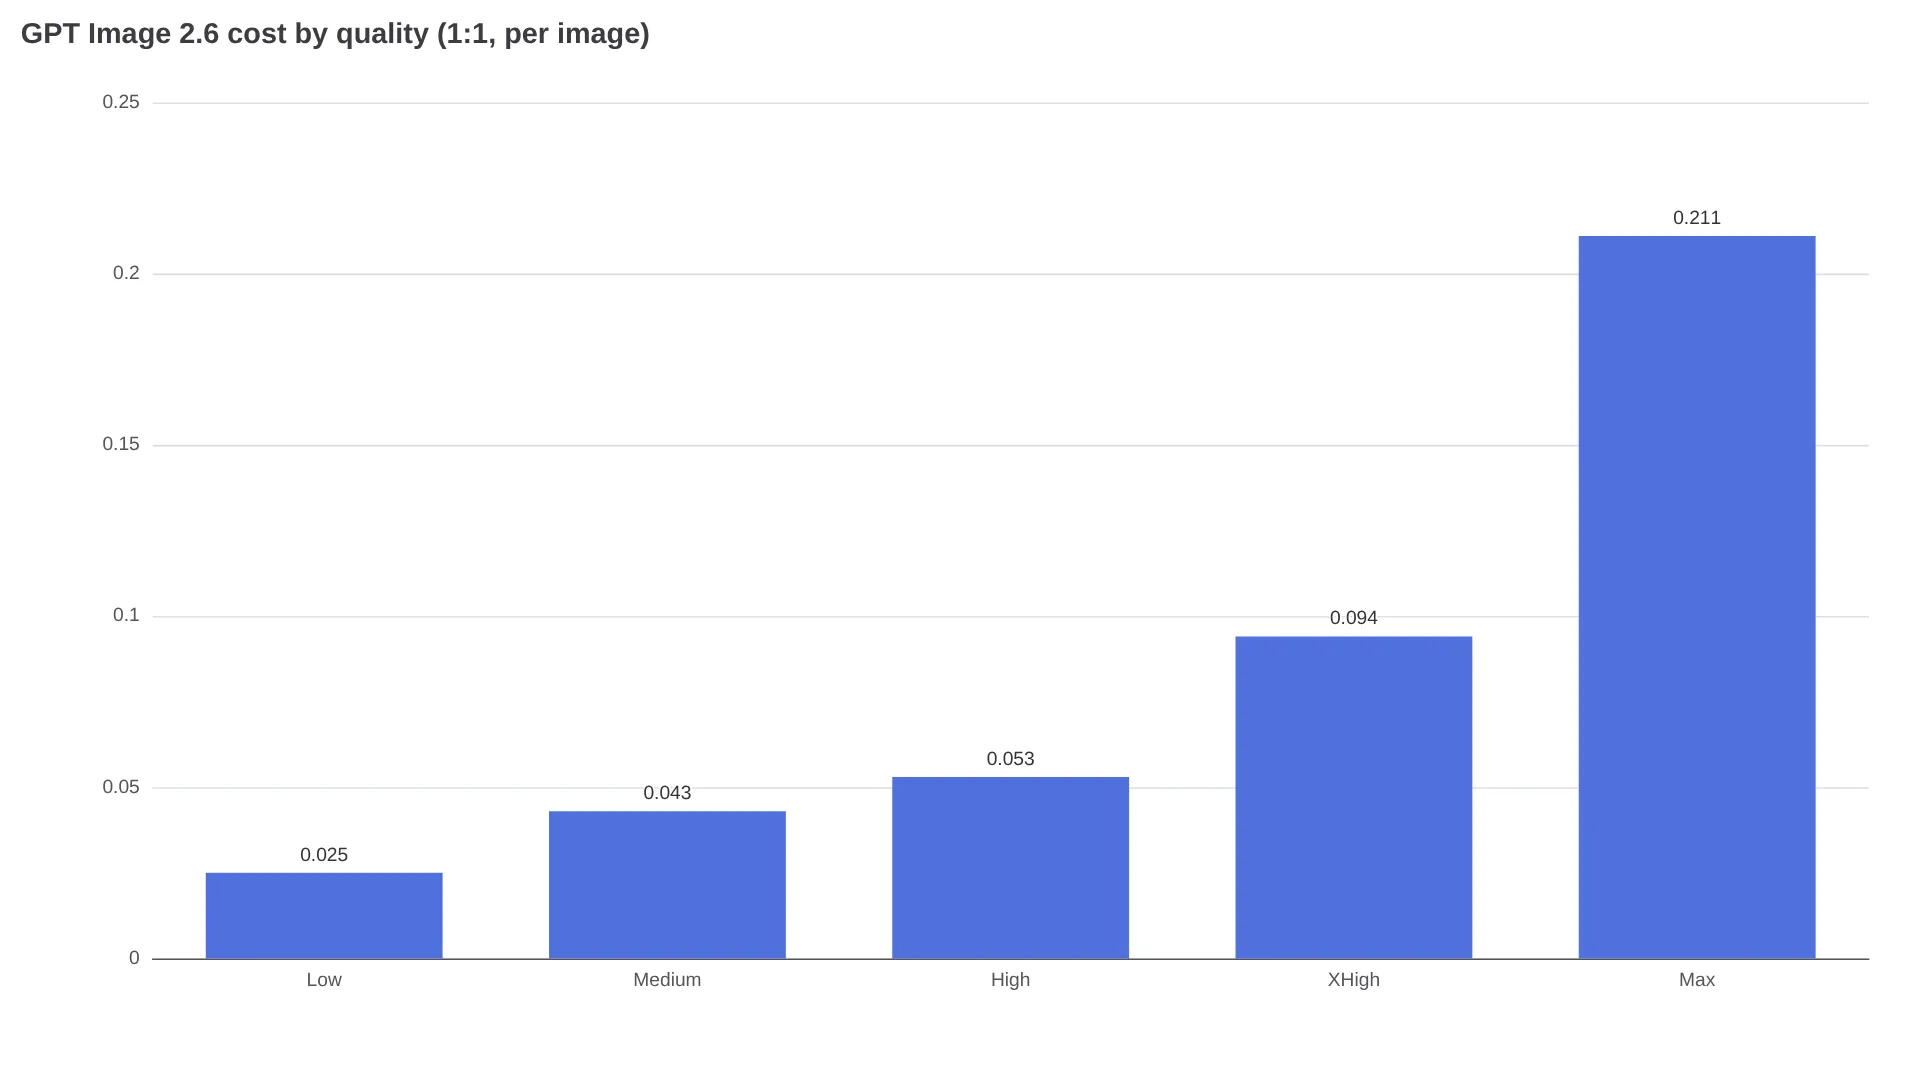
Die Kostenfalle lauert beim Upgrade ohne Anpassung der Qualität. Low bei GPT Image 2.6 ist nicht mehr die Entwurfsstufe für unter einen Cent, die GPT Image 2.5 bot. Für 100 Low-Entwürfe sollten Sie $2.47 an Output-Kosten zuzüglich Inputs einplanen, für 100 Max-Finalbilder etwa $21 – nicht beides als denselben Kostenposten behandeln.
Offizielle Tokenpreise: Warum drei Preisübersichten voneinander abweichen
Die OpenAI-API-Preisliste führt für GPT Image 2.6 Flare und Sunburst identische Standardpreise auf: $5 pro 1 Mio. Text-Input-Tokens, $1.25 pro 1 Mio. gecachte Text-Input-Tokens, $8 pro 1 Mio. Bild-Input-Tokens, $2 pro 1 Mio. gecachte Bild-Input-Tokens und $30 pro 1 Mio. Bild-Output-Tokens. Bei Preisänderungen ist die offizielle Preisseite maßgeblich. Auch die OpenAI-Modellseiten für Flare und Sunburst bestätigen diese Tokenpreise.
Drei Preisbetrachtungen sind im Umlauf – und sie messen jeweils etwas anderes:
- Offizielle Tokenpreise nennen den Stückpreis, nicht den Gesamtbetrag pro Bild. Der gemessene Output variiert je nach Qualität und Größe; Referenzbilder verursachen zusätzlich Bild-Input-Tokens.
- Gemessene Tokenabrechnung rechnet einen festen Prompt in Dollar um. TrezaLabs maß im 1:1-Format je nach Stufe 824 bis 7,024 Output-Tokens, zuzüglich einer kleinen Gebühr für Text-Tokens. Mockingbird kam bei einer Werbeanzeige in 1088x1360 und hoher Qualität auf rund 1,600 Output-Tokens – also etwa $0.048 Output-Kosten vor den Inputs.
- Feste Preisraster von Drittanbietern vereinfachen die Planung. HiAPI veröffentlicht ein Raster mit 15 Feldern: von $0.023 für Low in 1K bis $0.636 für Max in 4K. Yir schätzt über den offiziellen Weg etwa $0.0367 bis $0.2227 für 1K von Low bis Max.
Für Verträge sollten die offiziellen Preise gelten, für die eigene Prompt- und Bildgröße gemessene Tokens und für grobe Kapazitätsplanung allenfalls feste Preisraster. Ein pauschaler Preis von $0.04 pro Bild setzt eine bestimmte Qualität, Auflösung und Anzahl an Referenzen voraus – und muss nicht zu Ihrer Pipeline passen.
Zur Auswahl stehen die Qualitätsstufen low, medium, high, xhigh, max und auto. Bei der Auflösung gibt es 1K, 2K und 4K. Höhere Qualität liefert mehr interne Details, nicht mehr Pixel: TrezaLabs erhielt in jeder 1:1-Qualitätsstufe 1024x1024. complexity (low/medium/high, Standard: high) steuert den Planungsaufwand statt sichtbarer Details und verursacht keine separate Gebühr.
Warum das Budget von GPT Image 2.5 bei 2.6 nicht mehr aufgeht
GPT Image 2.6 verwendet denselben Preis pro Token wie GPT Image 2.5. In den genannten 1:1-Messungen von TrezaLabs verbrauchte 2.6 beim gleichen Format in den Qualitätsstufen Low und Medium allerdings mehr Output-Tokens.
| Qualität | GPT Image 2.5 Tokens | GPT Image 2.6 Tokens | Kosteneffekt |
|---|---|---|---|
| Low | 196 | 824 | ~4.2x mehr |
| Medium | 439 | 1,449 | ~3.3x mehr |
| High | 1,756 | 1,756 | unverändert |
| Extra high | 3,122 | 3,122 | unverändert |
| Max | 7,024 | 7,024 | unverändert |
Low stieg von unter $0.01 bei 2.5 auf rund $0.025 bei 2.6, Medium von rund $0.013 auf rund $0.043. Der r/codex-Abrechnungsthread bestätigt den Sprung um das 4,2-Fache bei Low (Thread). Für viele günstige Entwürfe sollten Sie daher GPT Image 2.5 beibehalten und quality explizit setzen, um Schwankungen durch auto zu vermeiden (TrezaLabs).
Flare oder Sunburst: gleicher Preis, anderes Tempo
Flare und Sunburst haben offiziell dieselben Tokenpreise und lagen in kleinen Tests innerhalb von 3 % beieinander. Die Wahl der Variante ist daher vor allem eine Frage der Latenz – testen Sie Ihren eigenen Workload. TrezaLabs fand mit Ausnahme von zwei Tokens Unterschied bei High identische Tokenmengen. Bei Werbeanzeigen maß Mockingbird für Flare rund 3 % mehr Output-Tokens; die Kosten pro Bild unterschieden sich dadurch um weniger als $0.001.
Beim Tempo trennen sich die Varianten. TrezaLabs stoppte am 5. November 2026 für jede Qualitätsstufe denselben Prompt, jeweils mit einem Renderdurchlauf. Das ist ein Anhaltspunkt, kein formaler Benchmark.
| Qualität | Flare-Laufzeit | Sunburst-Laufzeit |
|---|---|---|
| Low | 6 Sek. | 17 Sek. |
| Medium | 10 Sek. | 27 Sek. |
| High | 10 Sek. | 50 Sek. |
| Extra high | 23 Sek. | 82 Sek. |
| Max | 41 Sek. | 166 Sek. |
Bei Werbeanzeigen in 1088x1360 und hoher Qualität benötigte Mockingbird mit Flare 16–26 Sekunden, mit Sunburst 2.6 dagegen 51–55 Sekunden. Die Kosten lagen bei $0.089-$0.108 gegenüber $0.088-$0.107. OpenAI verspricht für Flare 50 % schnellere Generierung und bei Low-Qualität nur sechs Sekunden (Ankündigung). Mockingbird bestätigte den Flare-Vorteil, stellte in seinen zwei Anzeigentests aber fest, dass Sunburst 2.6 langsamer als Sunburst 2.5 war. OpenAI positioniert Flare für schnelle Iterationen und Sunburst für konsistente Details (Ankündigung).
In frühen Nutzerthreads überwiegt Skepsis gegenüber dem Tausch von Qualität gegen Geschwindigkeit, wie die r/singularity-Diskussion und Threads auf r/OpenAI zeigen:
Ich wünschte wirklich, sie würden das Modell so überarbeiten, dass es nicht mehr diese hässliche Fleckigkeit hineinrechnet.
— u/lyeeedar, r/OpenAI-Thread zum GIF-Test
GIFs, SVGs und Referenzbilder kosten extra
Zusätzliche Ausgabeformate werden außerhalb des Basisrasters der Qualitätsstufen abgerechnet. Für jedes Format gilt eine eigene Abrechnungsregel und eine zentrale Einschränkung.
| Funktion | Zusatzkosten | Abrechnungsregel | Wichtigste Einschränkung |
|---|---|---|---|
| GIF | $0.070 bei Low bis $0.598 bei Max (HiAPI) | Nur Qualitätsstufe, nicht Auflösung; 2–16 Frames, Standard 9, 20–2,000 ms pro Frame | Limits für das Sheet: maximale Seitenlänge 3840 px, maximale Fläche 8,294,400 px, maximales Verhältnis 3:1 |
| SVG | +$0.030 auf den Stufenpreis (HiAPI) | Fester Aufschlag; Low 1K $0.053, Max 4K $0.666 | Nur Text-zu-Bild; Bild-zu-Bild bleibt bei PNG, JPEG und WebP |
| Referenzbilder | Im Beispiel +$0.012 je Bild; tokenabhängig | Basispreis der Stufe + $0.012 x Anzahl im genannten Beispiel, 1–16 Referenzen (HiAPI) | Ein Produktfoto verbrauchte 1,523 Input-Tokens (TrezaLabs); 16 Referenzen kosten in diesem Beispiel zusätzlich $0.192 |
Für die Ebenen mask und markup fallen keine Zusatzgebühren an (HiAPI).
Batch- und Responses-Lücken verändern die tatsächlichen Kosten
Zum Start läuft GPT Image 2.6 nur über die Generations- und Edits-Endpunkte der Images API – ohne Responses API und ohne Batch API (Vergleich). GPT Image 2.5 bietet weiterhin Zugriff auf Responses und Batch, einschließlich eines Batch-Output-Preises von $15 pro 1 Mio. Tokens.
- Für 2.6 gibt es keinen Batch-Rabatt von 50 %. Teams mit hohem Volumen können 2.6-Jobs also nicht über Nacht zum halben Preis ausführen.
- Agents auf Responses-Basis müssen bei 2.5 bleiben oder ihren Stack zwischen Responses-Reasoning und Images-API-Aufrufen aufteilen – inklusive separater Erfassung von Wiederholungsversuchen.
- ChatGPT-Abonnements decken keine API-Nutzung ab. ChatGPT und Codex enthalten Images 2.6 in allen Stufen einschließlich Free (Ankündigung), API-Aufrufe werden jedoch pro Token abgerechnet. Außerdem bietet ChatGPT keine dokumentierte Auswahl für Flare oder Sunburst. Für reproduzierbare Tests sollten Sie daher die Modell-ID explizit setzen.
Ein Workflow, der die Kosten im Griff behält
Ein kostenkontrollierter Workflow mit GPT Image 2.6 erstellt Entwürfe mit Flare und niedriger Qualität; für Finalbilder kommen Sunburst sowie High oder Max zum Einsatz.
- Erstellen Sie 100 Varianten mit Flare Low im 1:1-Format für rund $2.47 Output-Kosten zuzüglich Inputs. Bewerten Sie die Komposition, nicht die Textur.
- Heben Sie 10 Favoriten auf Flare High für etwa $0.053 je Bild an Output-Kosten an – rund $0.53 für diese Runde. Prüfen Sie Text, Hände und Produktbeschriftungen.
- Finalisieren Sie 2–3 Assets mit Sunburst High oder Max. Zwei Max-Finalbilder im 1:1-Format kosten rund $0.42 an Output-Kosten.
- Begrenzen Sie Referenzen. Sechs ungenutzte Moodboards schlagen im genannten Beispiel bei jedem Render mit rund $0.072 zu Buche – mehr als ein Low-Bild im 1:1-Format selbst.
- Setzen Sie
qualityundcomplexityexplizit. OpenAI empfiehlt für fokussierte Bearbeitungen niedrige Komplexität (Mockingbird).
| Workload | Einstellung | Ungefähre Output-Kosten für 100 Bilder |
|---|---|---|
| Entwürfe in großer Zahl | Flare Low 1:1, gemessen | $2.47 |
| Prüfung vor dem Final | Flare High 1K, gemessener 1:1-Proxy | ~$5.30 |
| Finalbilder für den Einsatz | Sunburst Max 1:1, gemessen | $21.10 |
Setzen Sie GPT Image 2.6 für lesbare Speisekarten, Etiketten, Poster und produktgetreue Bildbearbeitungen ein – dort rechtfertigt die Texterkennung $0.05-$0.21 pro Bild.
FAQ
Kosten Flare und Sunburst gleich viel?
Ja. OpenAI nennt für gpt-image-2.6-flare und gpt-image-2.6-sunburst identische Tokenpreise. Die gemessenen Output-Tokens wichen zwischen Testern um höchstens 3 % ab, sodass sich die Kosten pro Bild um etwa $0.001 unterscheiden. Entscheiden Sie nach Geschwindigkeit und Konsistenz bei Bearbeitungen, nicht nach dem Preis.
Warum gibt es keinen festen Preis pro Bild?
OpenAI berechnet $30 pro 1 Mio. Bild-Output-Tokens plus Input-Tokens. Je nach Qualität reichen die Output-Tokens pro 1:1-Bild jedoch von etwa 824 bis 7,024. Jeder feste Dollarbetrag setzt daher Qualität, Auflösung und Anzahl der Referenzen voraus.
Ist GPT Image 2.6 teurer als GPT Image 2.5?
Bei Low und Medium: ja. Bei Low sind es etwa 824 statt 196 Tokens, bei Medium 1,449 statt 439. Ab High sind die gemessenen Tokenmengen identisch. Pipelines mit vielen Entwürfen sollten für günstige Varianten bei 2.5 bleiben.
Wie werden GIFs und SVGs abgerechnet?
Bei GIFs richtet sich die Abrechnung nur nach der Qualitätsstufe: etwa $0.070 bei Low bis $0.598 bei Max für 2–16 Frames. SVG kostet rund $0.030 zusätzlich zum Stufenpreis und funktioniert nur bei Text-zu-Bild.
Welche Tokens treiben die Rechnung wirklich?
Den größten Anteil haben Bild-Output-Tokens zu $30 pro 1 Mio. Tokens; ein Textprompt mit 1,000 Tokens kostet bei $5 pro 1 Mio. $0.005. Gecachter Text ($1.25) und Bild-Inputs ($2) helfen bei wiederholten Bearbeitungen mit denselben Referenzen, Output-Tokens werden jedoch nicht gecacht.