 AIREITER
Beim Artificial Analysis Intelligence Index liegen Grok 4.6 und GPT-5.6 Sol fast gleichauf: 61 gegenüber 58,9 Punkten. Beim Output zahlt man für Sol allerdings das Fünffache pro Token. Ganz so einfach ist die Rechnung trotzdem nicht, denn Sol bietet ein doppelt so großes Kontextfenster und erzielt höhere Werte bei der Effizienz von Agenten.
Fast gleich intelligent – aber der Index zeigt nicht alles
Der Artificial Analysis Intelligence Index v4.1 bündelt Aufgaben aus Schlussfolgern, Coding und Wissen zu einem Gesamtwert. OpenAI gibt für GPT-5.6 Sol 58,9 Punkte an. Grok 4.6 kommt laut Community-Berichten, die sich auf Arena-Daten von Artificial Analysis beziehen, auf etwa 61 Punkte. Diese aus der Community stammende Zahl wurde nicht unabhängig bestätigt, passt aber zu der Einschätzung von Artificial Analysis, Grok 4.6 sei Sol ebenbürtig.
Ein Gesamtwert verdeckt Unterschiede beim Kontextfenster, bei der Agent-Effizienz und zwischen einzelnen Benchmarks. Gerade bei agentenlastigen Tests wie Terminal-Bench 2.1 mit 88,8 % und DeepSWE v1.1 mit 72,7 % liefert Sol laut den veröffentlichten Ergebnissen von OpenAI sehr starke Werte. Vergleichbare, unabhängig veröffentlichte Resultate speziell für Grok 4.6 gibt es bislang nicht. Der Intelligence Index sieht beide Modelle bei der allgemeinen Intelligenz auf Augenhöhe; bei Agenten-Benchmarks könnte sich jedoch ein anderes Bild ergeben.
| Merkmal | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Entwickler | xAI | OpenAI |
| Kontextfenster | 500K Tokens (x.ai/api) | ~1.050.000 Tokens (openai.com) |
| API-Input (pro 1 Mio.) | $2.00 (x.ai/api) | $5.00 (openai.com) |
| API-Output (pro 1 Mio.) | $6.00 (x.ai/api) | $30.00 (openai.com) |
| Intelligence Index v4.1 | ~61 (aus der Community berichtet) | 58,9 (offiziell) |
| Cloud-Verfügbarkeit | Azure AI Foundry, Oracle OCI, Google Vertex (x.ai/api) | Azure, AWS Bedrock (openai.com) |
API-Preise: Input 2,5x, Output 5x günstiger
Auf xAIs API-Seite ist Grok 4.6 mit $2.00 pro Million Input-Tokens und $6.00 pro Million Output-Tokens gelistet. Auf der GPT-5.6-Seite von OpenAI kostet Sol $5.00 für Input und $30.00 für Output je Million Tokens.
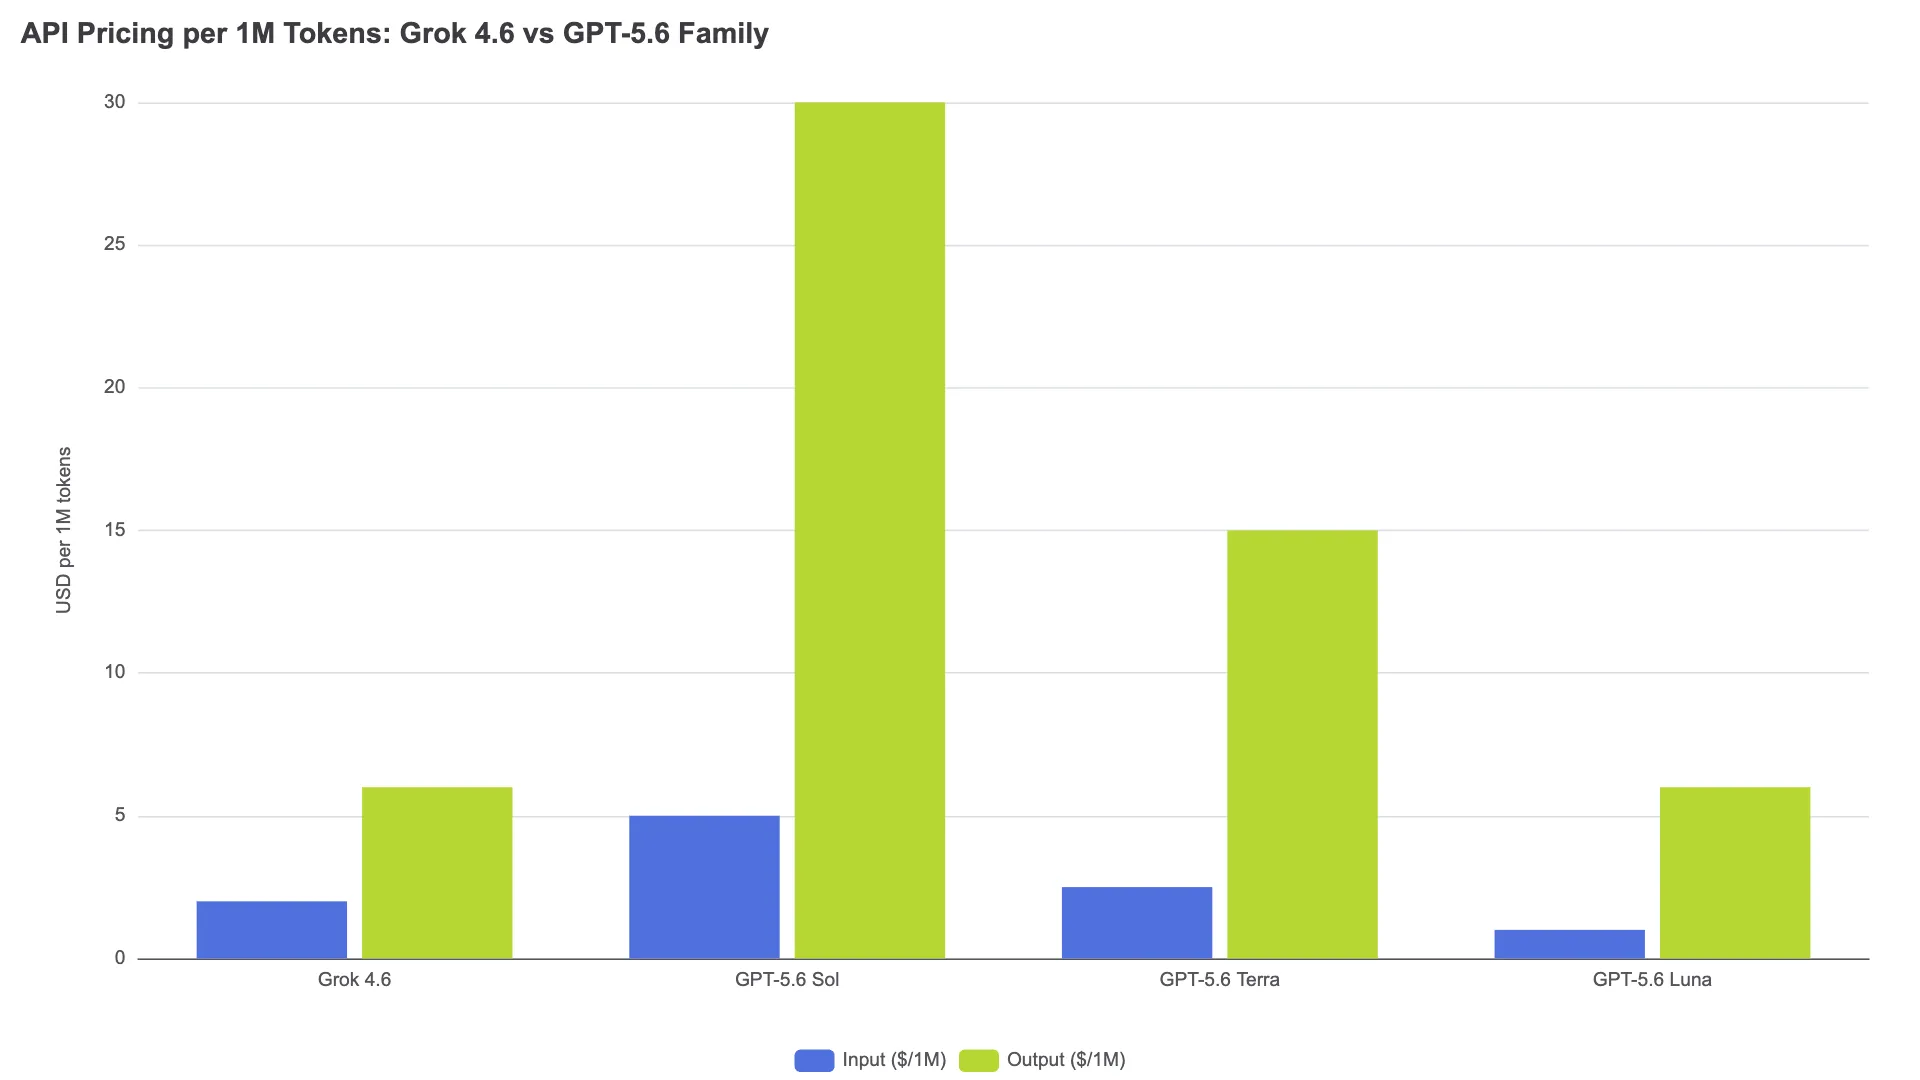
Bei einem monatlichen Workload mit 50 Mio. Input- und 10 Mio. Output-Tokens kostet Grok 4.6 $160. Für Sol fallen $550 an. Das entspricht einem Faktor von 3,4 – bevor berücksichtigt wird, dass Sols Reasoning-Modi pro Aufgabe mehr Tokens verbrauchen.
OpenAI bietet auch günstigere Varianten an: GPT-5.6 Terra für $2.50/$15.00 und GPT-5.6 Luna für $1.00/$6.00 (Lunas Preis wurde am 30. Juli 2026 um 80 % gesenkt). Luna liegt beim Output preislich gleichauf mit Grok 4.6 und ist beim Input günstiger, ist aber ein kleineres Modell mit durchweg niedrigeren Benchmark-Werten. Für einen fairen Vergleich bei annähernd gleicher Intelligenz muss Grok 4.6 gegen Sol antreten – und dabei ist Groks Kostenvorteil erheblich.
Kontextfenster: 500K gegen 1 Mio. Tokens
Grok 4.6 verfügt laut xAIs API-Seite über ein Kontextfenster von 500K Tokens. Sol kommt laut OpenAIs Dokumentation auf rund 1,05 Millionen Tokens. 500K Tokens reichen für normale Arbeiten an Komponenten und Modulen sowie die meisten Coding-Aufgaben auf Service-Ebene. Sols 1M-Fenster wird relevant, wenn ein kompletter Monorepo, mehrere große Dokumente oder ein langer Gesprächsverlauf in einem einzigen Prompt stecken müssen. Soll ein Agent beispielsweise 800K Tokens Codebasis-Kontext in einem Durchgang analysieren, schafft Sol das – Grok 4.6 nicht.
Hinzu kommt die Zuverlässigkeit beim Wiederfinden von Informationen. OpenAI berichtet für Sol 77,1 % bei GraphWalks BFS mit 1M Tokens. Grok hat keine vergleichbaren Retrieval-Werte für lange Kontexte veröffentlicht. Bei einem Anwendungsfall wie „Finde den Bug in dieser 600K-Token-Codebasis“ geht es beim größeren Fenster von Sol daher nicht nur um Kapazität, sondern auch darum, ob das Modell Informationen aus dieser Tiefe tatsächlich abrufen kann.
Bei Coding- und Agenten-Benchmarks trennen sich die Wege
Der knappe Gleichstand im Intelligence Index setzt sich nicht gleichmäßig in Coding-spezifischen Benchmarks fort. Die folgende Übersicht stellt den offiziellen Ergebnissen von OpenAI für GPT-5.6 Sol die von Fritz.ai berichteten Werte von Grok 4.5 als Näherung gegenüber. Unabhängig veröffentlichte Coding-Benchmarks speziell für Grok 4.6 fehlen bislang. Die Grok-Spalte ist deshalb nur eine Referenz zum Vorgänger, kein direkter Grok-4.6-Vergleich:
| Benchmark | GPT-5.6 Sol (offiziell) | Grok 4.5 (Referenzwert) | Abstand |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58,9 | - | Grok 4.6: ~61 (fast gleichauf) |
| Coding Agent Index v1.1 | 80,0 | - | Keine Daten für Grok 4.6 |
| Terminal-Bench 2.1 | 88,8 % | 83,3 % | Sol +5,5 Punkte |
| DeepSWE v1.1 | 72,7 % | 53,0 % | Sol +19,7 Punkte |
| SWE-Bench Pro | 64,6 % | 64,7 % | Praktisch gleichauf |
| GPQA Diamond | 94,6 % | 93,1 % | Sol +1,5 Punkte |
Besonders aussagekräftig sind Sols Vorsprünge bei Terminal-Bench und DeepSWE. Terminal-Bench misst, wie gut ein Agent reale Terminal-Aufgaben erledigt: Pakete installieren, Tests ausführen oder Fehler analysieren. DeepSWE bewertet durchgängige Softwareentwicklung anhand echter GitHub-Issues. Der Vorsprung von 19,7 Punkten gegenüber Grok 4.5 bei DeepSWE legt nahe, dass Sol bei komplexen Coding-Aufgaben mit mehreren Schritten deutlich stärker ist – also dort, wo das Modell planen, ausführen und Fehler korrigieren muss. Ob die Verbesserungen durch das Post-Training von Grok 4.6 diesen Abstand verkleinern, muss sich noch zeigen.
Benchmark-Ergebnisse geben eine Richtung vor, sind aber kein endgültiges Urteil. Agent-Frameworks, Tools, Prompts und Ausführungsumgebungen beeinflussen die Resultate. Ein Modell, das in einem Setup schlechter abschneidet, kann in einem anderen besser sein.
Tokenpreis oder Kosten pro erledigter Aufgabe?
Auf der Preisliste wirkt Grok 4.6 mit seinen niedrigeren Tokenpreisen klar überlegen. Agenten kaufen aber keine Tokens, sondern erledigte Aufgaben. Schließt Sol eine Coding-Aufgabe mit 3.000 Output-Tokens ab, während Grok 4.6 dafür 6.000 Tokens braucht – etwa wegen zusätzlicher Versuche, längerer Reasoning-Ketten oder weniger effizienter Tool-Nutzung –, schrumpft der Kostenabstand.
Eine Sensitivitätsanalyse zu den aktuellen Preisen zeigt die mögliche Spanne. Für eine Coding-Aufgabe mit 10K Input- und 4K Output-Tokens bei Sol gegenüber 12K Input- und 8K Output-Tokens bei Grok 4.6 – also einem 2x-Vorteil bei der Token-Effizienz für Sol – ergibt sich:
| Kostenfaktor | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| Input-Kosten | $0.05 | $0.024 |
| Output-Kosten | $0.12 | $0.048 |
| Gesamt pro Aufgabe | $0.17 | $0.072 |
Selbst in diesem Szenario mit einem 2x-Effizienznachteil bleibt Grok 4.6 pro Aufgabe 2,4x günstiger. Reddit-Nutzer, die sich auf Artificial Analysis beziehen, schätzten Grok 4.6s Kosten pro Intelligence-Index-Aufgabe auf ungefähr $0.86. Ob Grok seinen Kostenvorteil bei einer Token-Effizienz auf Sol-Niveau in Ihrem konkreten Workload behält, hängt von Aufgabenkomplexität und Agent-Framework ab.
Das eigentliche Risiko liegt nicht in der Token-Ökonomie, sondern darin, ob die Aufgabe gelingt. Sols höhere Werte bei Terminal-Bench und DeepSWE bedeuten, dass das Modell komplexe Agenten-Aufgaben möglicherweise schafft, an denen Grok scheitert und einen erneuten Versuch oder menschliches Eingreifen erfordert. Eine gescheiterte Aufgabe ist unabhängig vom Preis teurer als eine erfolgreich abgeschlossene.
Zugang und Ökosystem
Beide Modelle sind inzwischen über mehr als einen einzelnen API-Anbieter verfügbar. xAIs API-Seite und OpenAIs Dokumentation dienen dabei als primäre Quellen:
| Zugangskanal | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry (x.ai) | Azure OpenAI (openai.com) |
| AWS | Nicht gelistet | Bedrock (openai.com) |
| Google Cloud | Vertex Model Garden (x.ai) | Nicht gelistet |
| Oracle | OCI Generative AI (x.ai) | Nicht gelistet |
| IDE-Integrationen | Cursor, Devin | Cursor, Codex |
| SDK-Kompatibilität | OpenAI + Anthropic SDKs (x.ai) | OpenAI SDK |
| Consumer-Chat | SuperGrok ($30/Monat), X Premium+ | ChatGPT Plus ($20/Monat) (fritz.ai) |
| Training mit Nutzerdaten | Standardmäßig Opt-in; Opt-out erforderlich | API-/Business-Daten sind standardmäßig ausgeschlossen |
Laut xAIs Dokumentation unterstützt Grok sowohl OpenAI- als auch Anthropic-SDKs. Für eine Migration müssen somit lediglich API-Key und Endpoint geändert werden. Bei sensiblem oder proprietärem Code ist OpenAIs standardmäßige No-Training-Regel für API- und Business-Daten ein Vorteil im Beschaffungsprozess. Grok-Nutzer müssen das Training dagegen laut der Datenschutzanalyse von Fritz.ai manuell deaktivieren.
Welches Modell passt zu welchem Einsatz?
| Workload | Empfehlung | Warum |
|---|---|---|
| Code-Agenten mit hohem Volumen | Grok 4.6 | Bei Skalierung 2,5- bis 5x niedrigere Tokenkosten |
| Komplexe Agenten-Aufgaben mit mehreren Schritten | GPT-5.6 Sol (vorläufig) | Die Vorsprünge in Agenten-Benchmarks gelten für Grok 4.5, nicht 4.6 |
| Analyse großer Codebasen (>500K Tokens) | GPT-5.6 Sol | 2x größeres Kontextfenster |
| Kostensensitives Batch-Processing | Grok 4.6 | Nahezu gleiche Intelligenz bei niedrigeren Kosten pro Token |
| Social-/Web-Recherche in Echtzeit | Grok 4.6 | Natives X und Web Search (x.ai) |
| Vertraulicher / proprietärer Code | GPT-5.6 Sol | API-Daten werden standardmäßig nicht fürs Training verwendet |
| Enterprise-Deployment auf Azure | Beide | Beide sind auf Azure AI Foundry verfügbar |
Die verlässlichste Entscheidungshilfe: Einen repräsentativen Ausschnitt der eigenen Aufgaben durch beide APIs laufen lassen. Verglichen werden sollten die Erfolgsquote, die mittleren Kosten pro erfolgreicher Aufgabe, die Zahl der Wiederholungen und die Latenz.
FAQ
Sollte ich Grok 4.6 eher mit GPT-5.6 Terra als mit Sol vergleichen?
Terra ($2.50/$15.00) liegt preislich näher an Grok 4.6, erzielt aber bei allen veröffentlichten Benchmarks niedrigere Werte als Sol: Intelligence Index 55,0, Coding Agent Index 77,4, Terminal-Bench 87,4 % (laut OpenAI). Wenn der Vergleich nach Intelligenz erfolgen soll, ist Grok 4.6 gegen Sol die faire Gegenüberstellung. Geht es primär um den Preis, schneidet Grok 4.6 gegenüber Terra sowohl bei den Kosten als auch bei den Benchmark-Werten besser ab. Luna ($1.00/$6.00) ist günstiger als beide, bringt aber deutliche Qualitätseinbußen mit sich.
Einen detaillierteren Blick auf Spezifikationen und Fähigkeiten von Grok 4.6 bietet unser Grok-4.6-Guide. Für den Vergleich von GPT-5.6 mit einer früheren Grok-Version behandelt unsere Analyse GPT-5.6 Sol vs. Grok 4.5 das Duell mit dem Vorgängermodell.