 AIREITER
OpenAI 现在有三个名称里带着“fast”或“ultra”的选项,但其中只有一个能跑到每秒 750 个 token。2026 年 8 月 13 日公布的 OpenAI Ultrafast mode,是面向 API 的新服务层级:它让 GPT-5.6 Sol 运行在 Cerebras 晶圆级芯片上,速度最高可达 Standard 的 14 倍。不过,Ultrafast 目前仅限受邀客户预览,OpenAI 也尚未公布价格。因此,现阶段真正可以直接购买的最快选项,仍是每百万 token 输入 $10、输出 $60 的 Fast mode。
别把 ultra、Fast mode 和 Ultrafast 搞混
对于 GPT-5.6 Sol 用户而言,这三个带有速度意味的名称其实指向完全不同的东西。下面这张表可以一次说清。
| 名称 | 它是什么 | 如何获得 | Sol 价格(每 100 万 token) | 宣传速度 |
|---|---|---|---|---|
ultra 推理设置 | 一种推理/工作模式,会为单项任务投入子代理和额外算力 | Codex 设置,并非可单独购买的 API 服务层级 | 没有独立定价;会很快消耗使用额度 | 设计上更慢 |
| Fast mode | API 处理层级,2026 年 7 月 30 日由 Priority 更名而来 | 在任意 API 请求中设置 service_tier="fast" | $10 输入 / $60 输出(短上下文) | 最高可达 Standard 的 2.5 倍 |
| Ultrafast mode | 由 Cerebras 驱动、面向 GPT-5.6 Sol 的 API 层级,于 2026 年 8 月 13 日开启预览 | 限量预览,仅面向部分客户 | 未披露 | 最高可达 Standard 的 14 倍 |
它们追求的方向恰好相反:ultra 是一种以速度换取更充分思考的子代理工作模式;Ultrafast mode 则是在同一模型上追求纯粹的生成速度。位于两者之间的 Fast mode,是可以购买的低延迟升级服务,OpenAI 在其 Fast mode 页面中单独说明了这一选项。
8 月 13 日预览版到底带来了什么
官方公告确认了五项具体信息:Ultrafast 首先在 OpenAI API 中推出;仅支持 GPT-5.6 Sol;处理速度最高可达 Standard 的 14 倍,输出速度最高达到每秒 750 个 token;底层由 Cerebras 提供支持;并以限量预览形式提供给部分客户,包括 Jane Street、Podium、Basis 和 Rogo。
但对于潜在买家最关键的四项信息,公告都没有给出:按 token 计费的价格、模型 ID、速率限制,以及延迟 SLA。公告中同样没有列出具名基准测试。
OpenAI 给出的演示,是让 Ultrafast 和 Standard Sol 根据同一条提示词分别构建 3D 仓库模拟器,并进行并排对比。Rogo 的 Alex Wang 用一句话概括了其卖点:“Ultrafast makes complex financial research feel like a real-time interaction.”
从 2.5 倍到 14 倍,速度差能带来什么
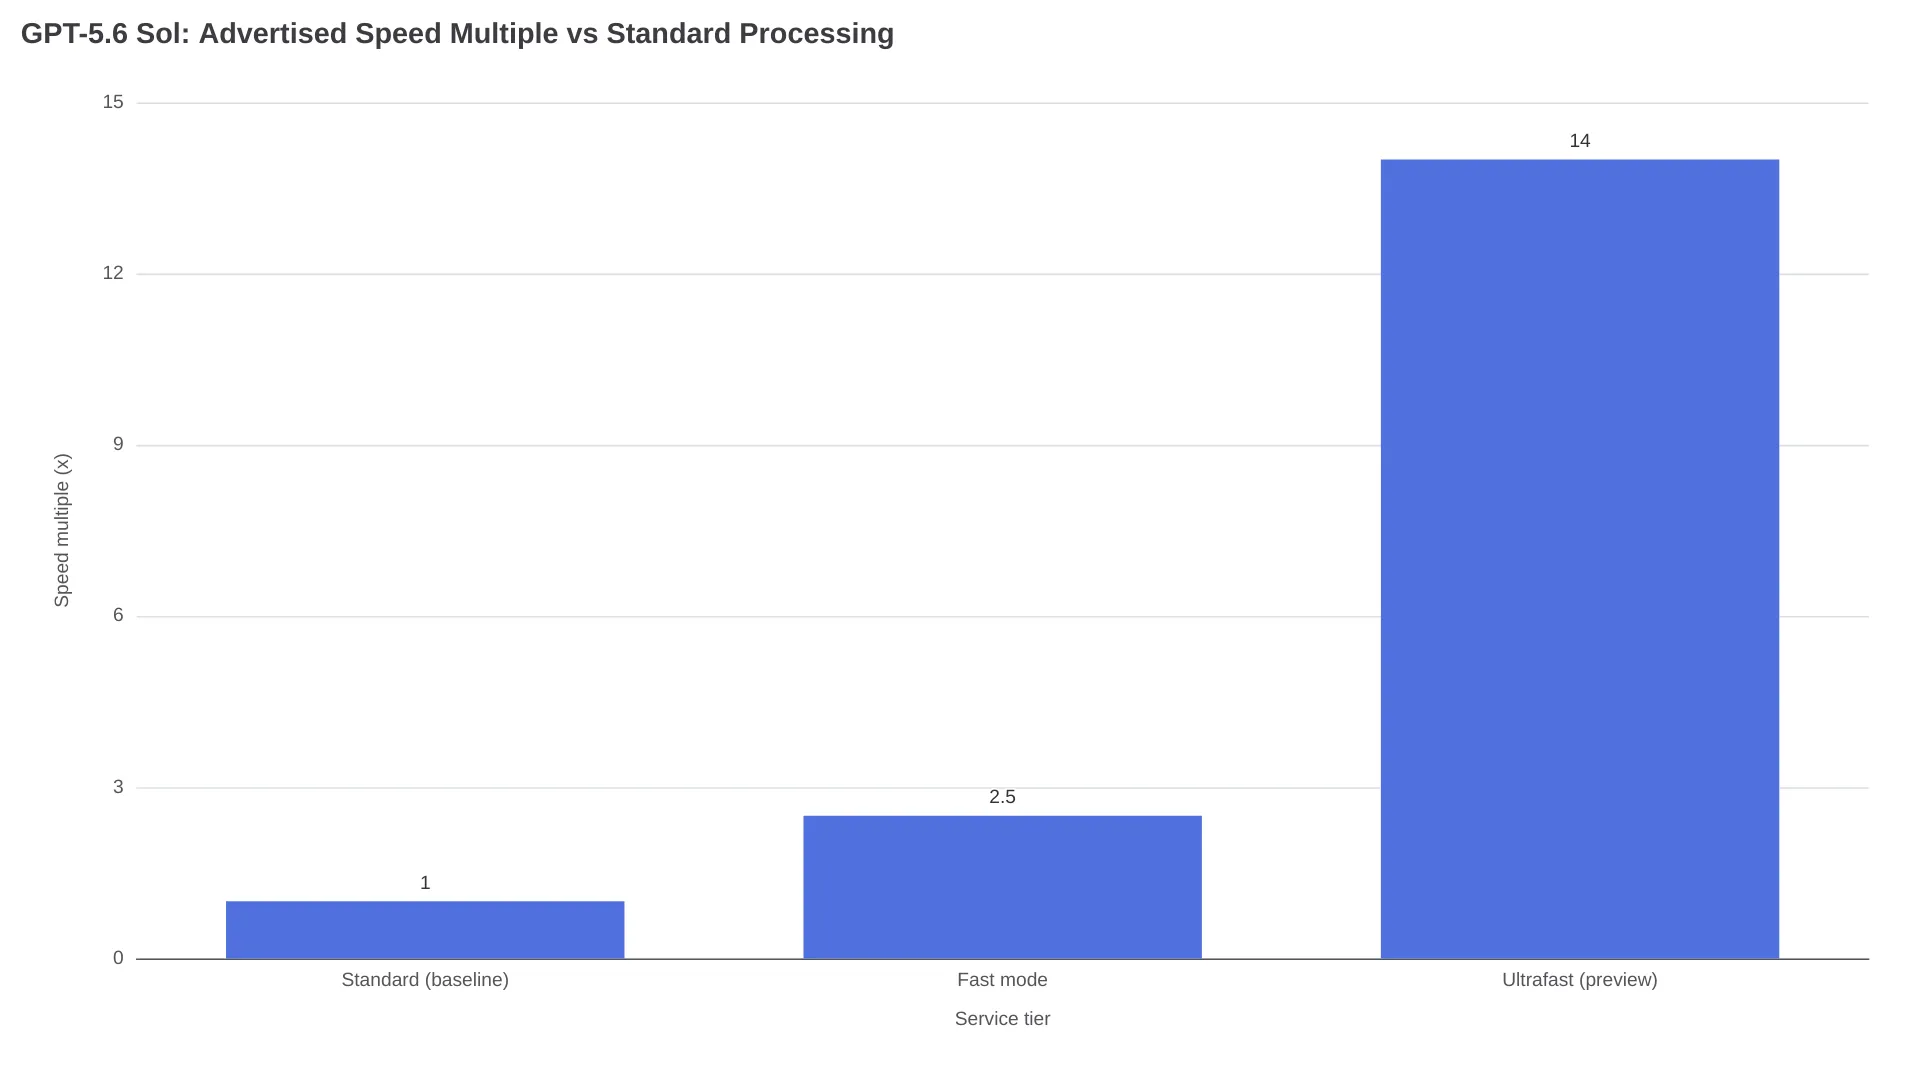
先说一个口径上的注意事项:750 tokens/sec 是宣传的输出吞吐量,而 Fast mode 的数字是 SLA 下限,两者有关联,但并非完全相同的指标。以 750 除以 14 推算,Standard Sol 的生成速度约为每秒 54 个 token。按这个速度计算,生成 10,000 个 token,Standard 大约需要 186 秒;Fast mode 在其 Enterprise SLA 的每秒 80 个 token 下限下最长为 125 秒;Ultrafast 则约为 13 秒。
| 工作负载 | Standard(约 54 tok/s,推算) | Fast mode(SLA ≥80 tok/s) | Ultrafast(宣传值 750 tok/s) |
|---|---|---|---|
| 生成 10,000 个 token | 约 186 秒 | ≤125 秒 | 约 13 秒 |
| 5 轮代理循环,每轮 1,000 个 token | 约 93 秒 | ≤63 秒 | 约 7 秒 |
r/AIToolsPerformance 上流传的数据将这些对比归因于 Artificial Analysis 和 Cerebras:Ultrafast 的速度是 Claude Fable 5 的 11 倍,是 Fast mode 下 Opus 4.8 的 5 倍;完整跑完 2,500 道 Humanity's Last Exam 问题耗时 11 小时 11 分钟,而 Fable 5 需要 78 小时 27 分钟。这些数据均由厂商报告,尚未有独立复现结果。
预览外用户都不知道的价格
Ultrafast 的公开定价目前并不存在。公告没有提供任何费率,社区也立刻注意到了这个空白。正如一位 r/AIToolsPerformance 用户所说:“What the blog doesn't say is price. Nobody outside the preview knows what it costs.”
目前可作为参考的,是 GPT-5.6 Sol 已知的每百万 token 价格体系:
| 层级 | 输入(短上下文) | 输出(短上下文) | 输入(长上下文 >272k) | 输出(长上下文) | 缓存输入 |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | 未披露 | 未披露 | 未披露 | 未披露 | 未披露 |
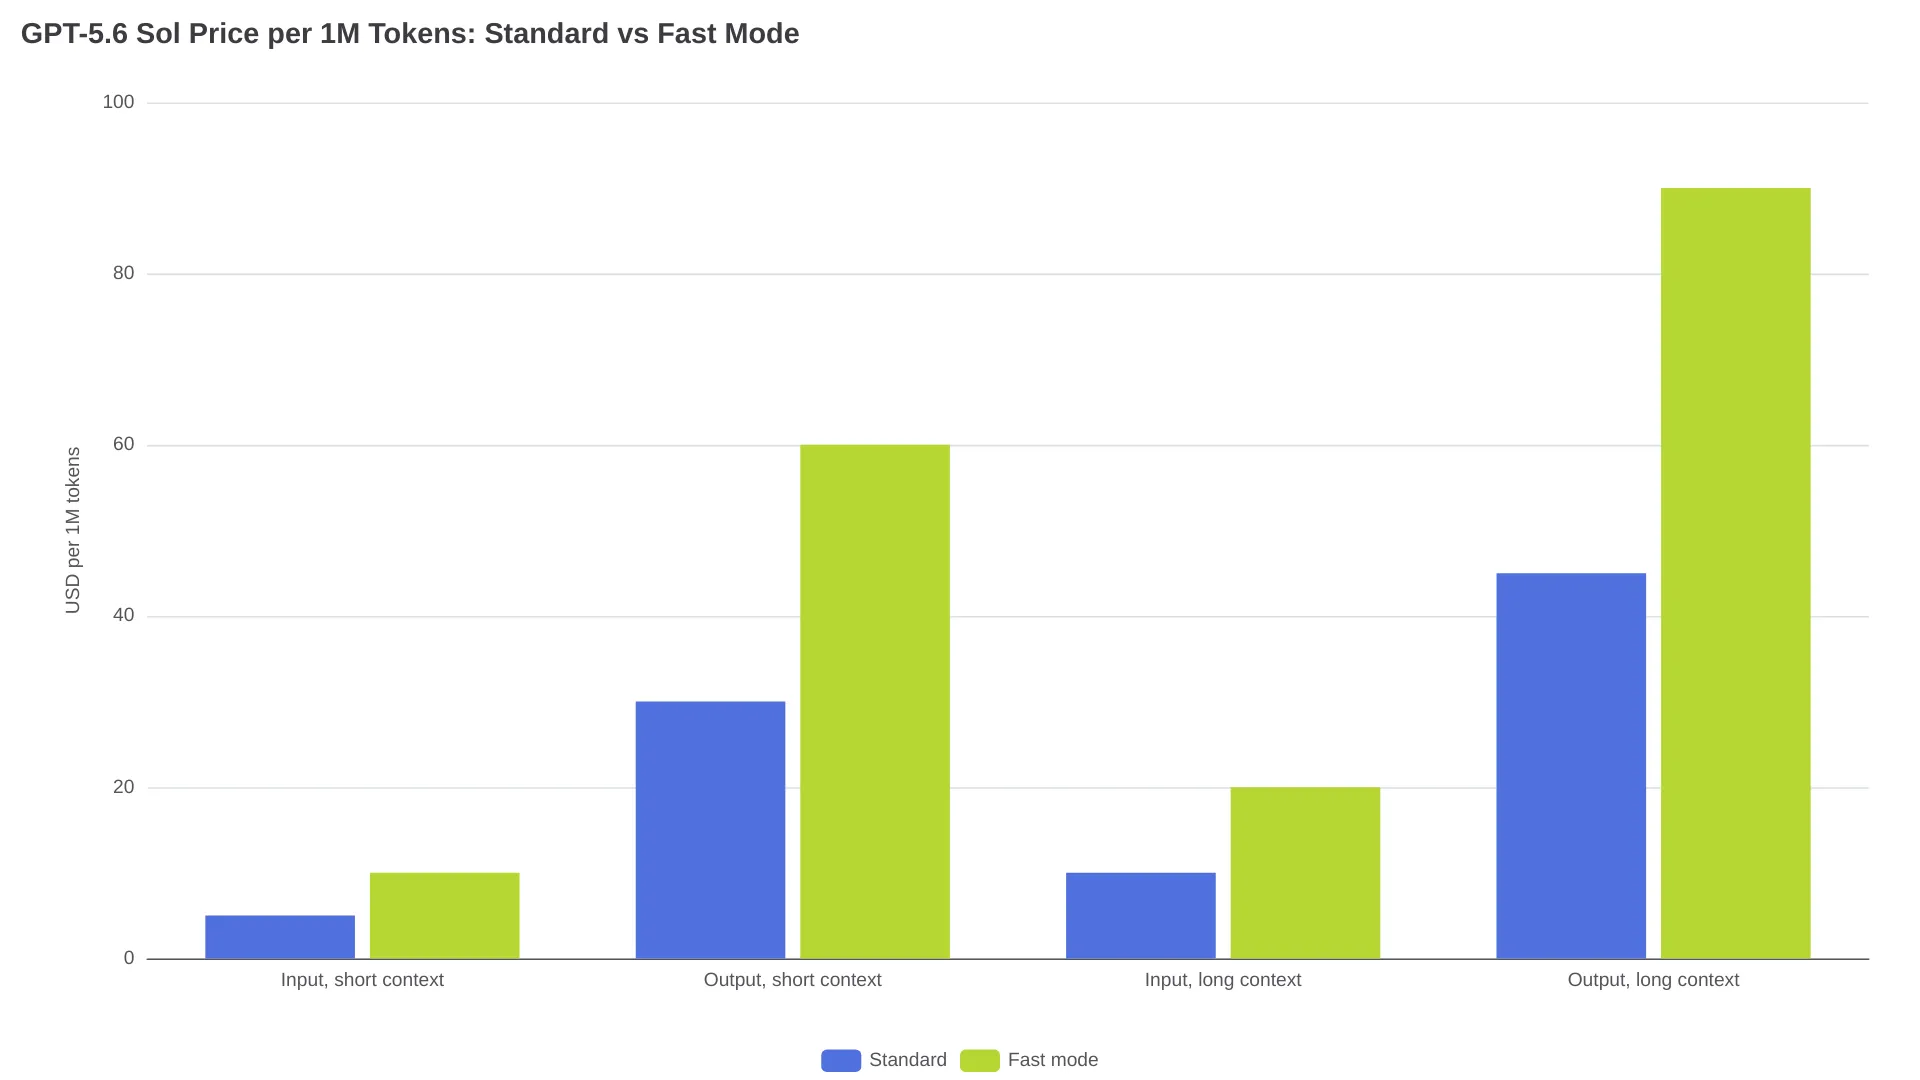
Fast mode 对 Sol 的收费正好是 Standard 的 2 倍,但公开信息不足以据此推测 Ultrafast 的价格,因为费率可能双向变化——OpenAI 曾在 7 月 30 日下调 Terra/Luna 的价格。对于有延迟预算要求的团队,Fast mode 的细则也值得注意:如果每分钟超过 100 万个 token,且流量在不足 15 分钟内增加超过 50%,超出的请求会静默降级为 Standard,返回 service_tier="Default",并按 Standard 费率计费。
如何获得资格:目前的访问方式
Ultrafast 采用邀请制,而非公开候补名单。OpenAI 表示,预览将“随着容量增长”而扩大,并在公告页面提供访问更新订阅入口。另有7 月的报道称,早期 Sol 访问权限当时仅覆盖约 20 家组织。
这一基础设施并非首次出现:OpenAI 与 Cerebras 的合作可追溯至 2026 年 1 月 14 日,其中预留了 750 MW 的晶圆级计算容量;同一硬件上的GPT-5.3-Codex-Spark 已经突破每秒 1,000 个 token。
等邀请期间,先把输出速度提上去
任何 API 客户现在都可以使用 Fast mode,启用它只需改一个参数:
- 在
/v1/responses或/v1/chat/completions的请求中加入service_tier="fast"。 - 旧的
service_tier="priority"值仍然可用。现有模型会继续在用量仪表盘中显示priority,GPT-5.6 之后的模型则会显示fast。 - 若要为整个项目设定默认值,请依次进入 Project settings -> Default Service Tier -> Fast。
| 支持 Fast mode 的模型 | 每 100 万 token 价格(输入 / 输出) | 延迟 SLA |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 tok/s |
| GPT-5.6 Terra | $4 / $24 | >70 tok/s |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 tok/s |
三者中,Luna 的 SLA 下限最高。根据相关说明,缓存读取可将输入成本降低 90%;Standard Sol 的缓存输入价格为 $0.50/M,TTL 约为 30 分钟。因此,无论使用哪个层级,长期会话都比每次重新发起请求更划算。如需在真实流量下测试这些层级,GPT-5.6 API endpoint 可通过统一接口提供这三个模型。
常见问题
Ultrafast mode 能在 ChatGPT 或 Codex 中使用吗?
不能。Ultrafast 首先在 OpenAI API 中推出,公告没有给出其进入 ChatGPT 或 Codex 的时间表。
GPT-5.6 Sol 跑在 Cerebras 上会影响输出质量吗?
OpenAI 将 Ultrafast 定位为更快交付同一个 GPT-5.6 Sol,而不是另一个模型。目前唯一关于质量的说法,是Cerebras 报告的 GDP-Val 速度提升 5.6 倍且质量未下降;尚无独立基准测试复现这一结论。
Ultrafast mode 有延迟 SLA 吗?
目前没有公开信息。Fast mode 为 Enterprise 客户提供 >80 tokens/sec 的 p50 SLA 和 99.9% 可用性;Ultrafast 在预览期间没有公布 SLA。
哪些模型支持 Ultrafast mode?
只有 GPT-5.6 Sol。Terra 和 Luna 支持 Fast mode,但不在 Ultrafast 预览范围内。
Ultrafast mode 将如何定价?
目前没有官方价格。Fast mode 相比 Standard Sol 的公开 2 倍溢价,是唯一可参考的基准。