 AIREITER
DeepSeek API 已于 2026 年 8 月 16 日涨价。原先按 token 统一计费的方式,改为 deepseek-v4-flash 和 deepseek-v4-pro 均按高峰、非高峰时段分别定价。非高峰时段,缓存未命中输入与输出价格已升至旧价的 1.5–2.4 倍;高峰时段再翻一倍。缓存命中输入的涨幅更明显:非高峰为 2.5–6.1 倍,高峰最高达到 12.1 倍。你的实际账单会涨多少,关键就看提示词缓存命中率。
2026 年 8 月 16 日,DeepSeek API 改了什么
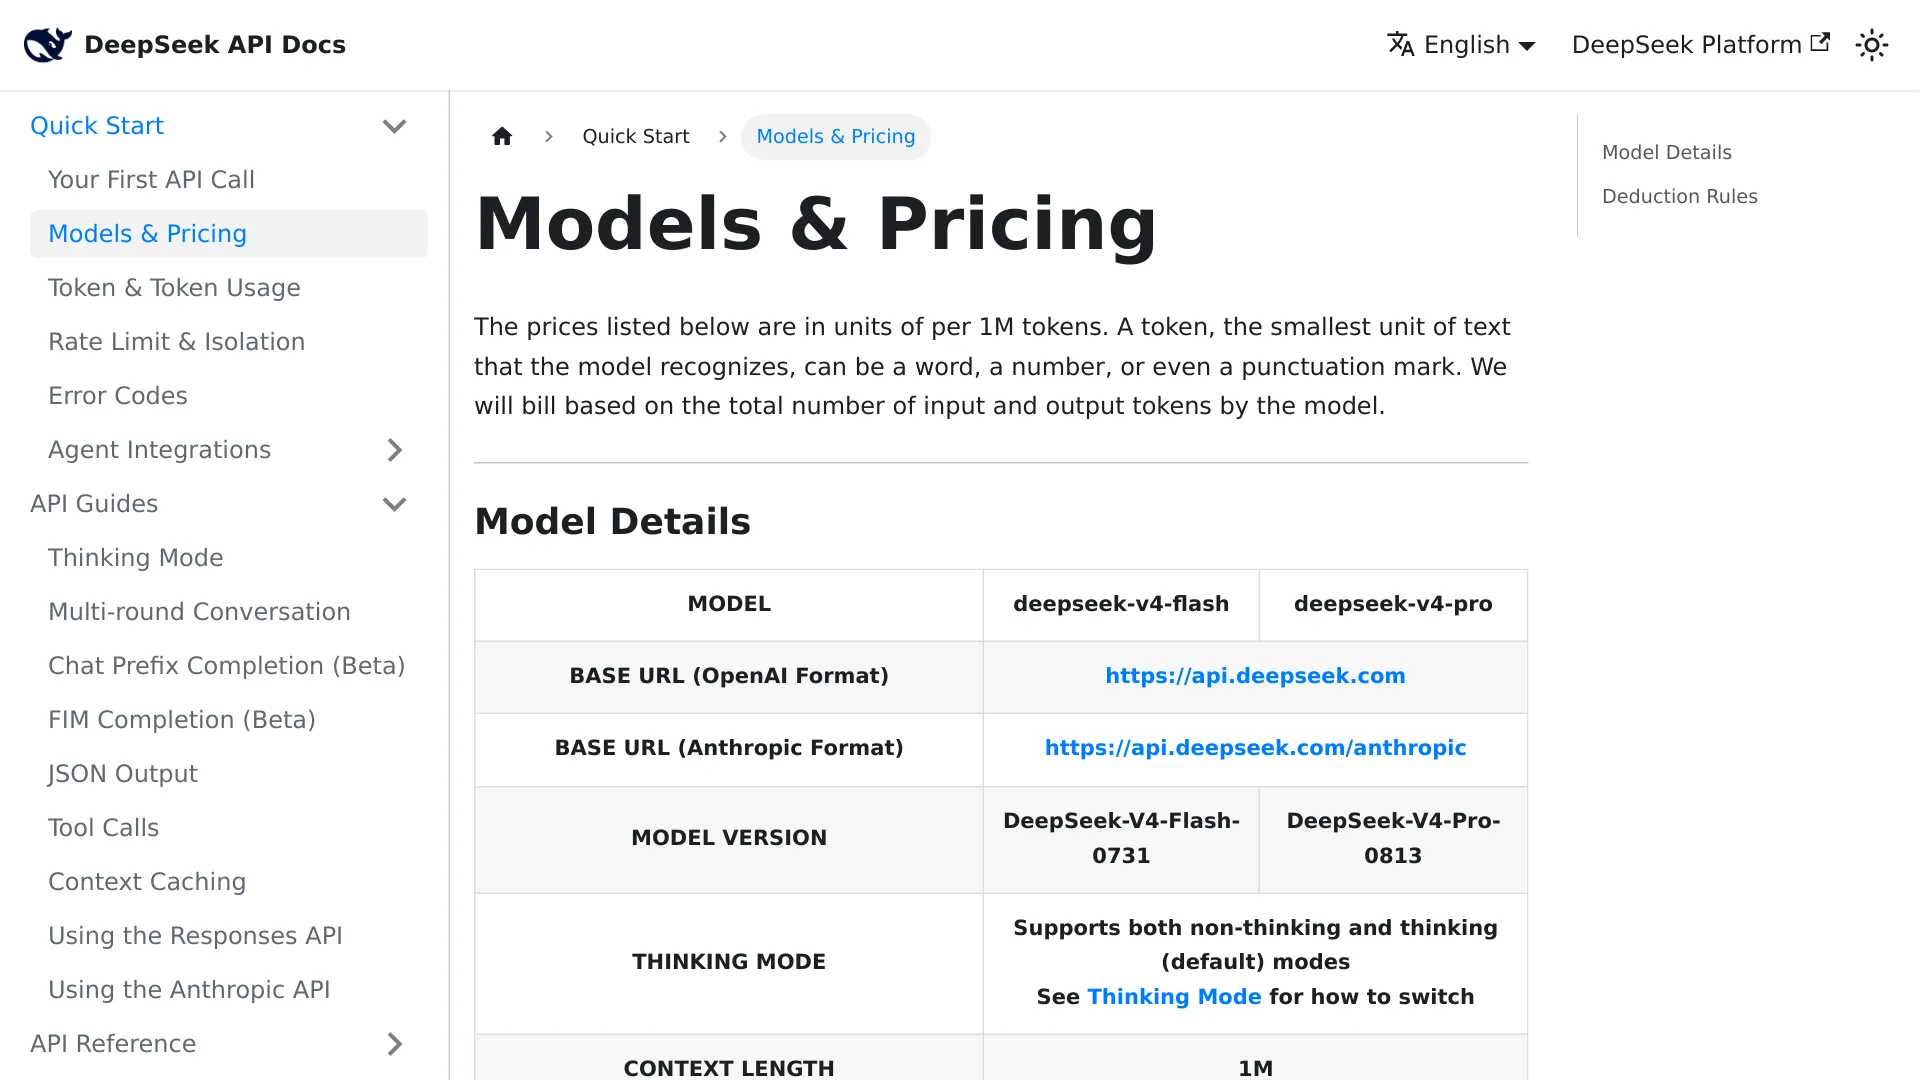
根据 r/DeepSeek 的公告讨论帖和一份650 次调用审计报告,新计费于 8 月 16 日星期日 16:00 UTC 生效,即北京时间 8 月 17 日零点。官方模型与定价页面现已列出新价格表,说明这不是预告,而是已经正式执行的变更。
DeepSeek 将计费划分为高峰和非高峰时段,高峰价格严格等于非高峰的 2 倍。每天的高峰窗口为 01:00–04:00 UTC 及 06:00–10:00 UTC,共 7 小时;其余 17 小时为非高峰。模型版本(DeepSeek-V4-Flash-0731、DeepSeek-V4-Pro-0813)、API 兼容性和已公布的规格在同一官方页面均未变化——这是一次计费调整,不是模型更新。
DeepSeek API 最新价格表
以下价格均为每 100 万 token 的美元价格,信息来自 2026 年 8 月 16 日的官方定价页面。
| V4 Flash | 非高峰 | 高峰 |
|---|---|---|
| 输入,缓存命中 | $0.007 | $0.014 |
| 输入,缓存未命中 | $0.22 | $0.44 |
| 输出 | $0.66 | $1.32 |
| V4 Pro | 非高峰 | 高峰 |
|---|---|---|
| 输入,缓存命中 | $0.022 | $0.044 |
| 输入,缓存未命中 | $0.66 | $1.32 |
| 输出 | $1.98 | $3.96 |
除价格外,其他计费机制没有改变:请求按实际执行时所在时段的费率计费,DeepSeek 也明确保留再次调整价格的权利。
这次涨价到底涨了多少
第三方价格追踪网站确认,截至 2026 年 7 月 31 日,旧版统一费率为:Flash 的缓存未命中输入 $0.14、缓存命中输入 $0.0028、输出 $0.28;Pro 则为 $0.435 / $0.003625 / $0.87(TLDL、BenchLM)。新旧价格并排看会更直观:
| 每 100 万 token | 旧统一价格 | 新非高峰价格 | 新高峰价格 | 非高峰较旧价 | 高峰较旧价 |
|---|---|---|---|---|---|
| Flash 输入,缓存命中 | $0.0028 | $0.007 | $0.014 | 2.5× | 5.0× |
| Flash 输入,缓存未命中 | $0.14 | $0.22 | $0.44 | 1.57× | 3.14× |
| Flash 输出 | $0.28 | $0.66 | $1.32 | 2.36× | 4.71× |
| Pro 输入,缓存命中 | $0.003625 | $0.022 | $0.044 | 6.07× | 12.14× |
| Pro 输入,缓存未命中 | $0.435 | $0.66 | $1.32 | 1.52× | 3.03× |
| Pro 输出 | $0.87 | $1.98 | $3.96 | 2.28× | 4.55× |
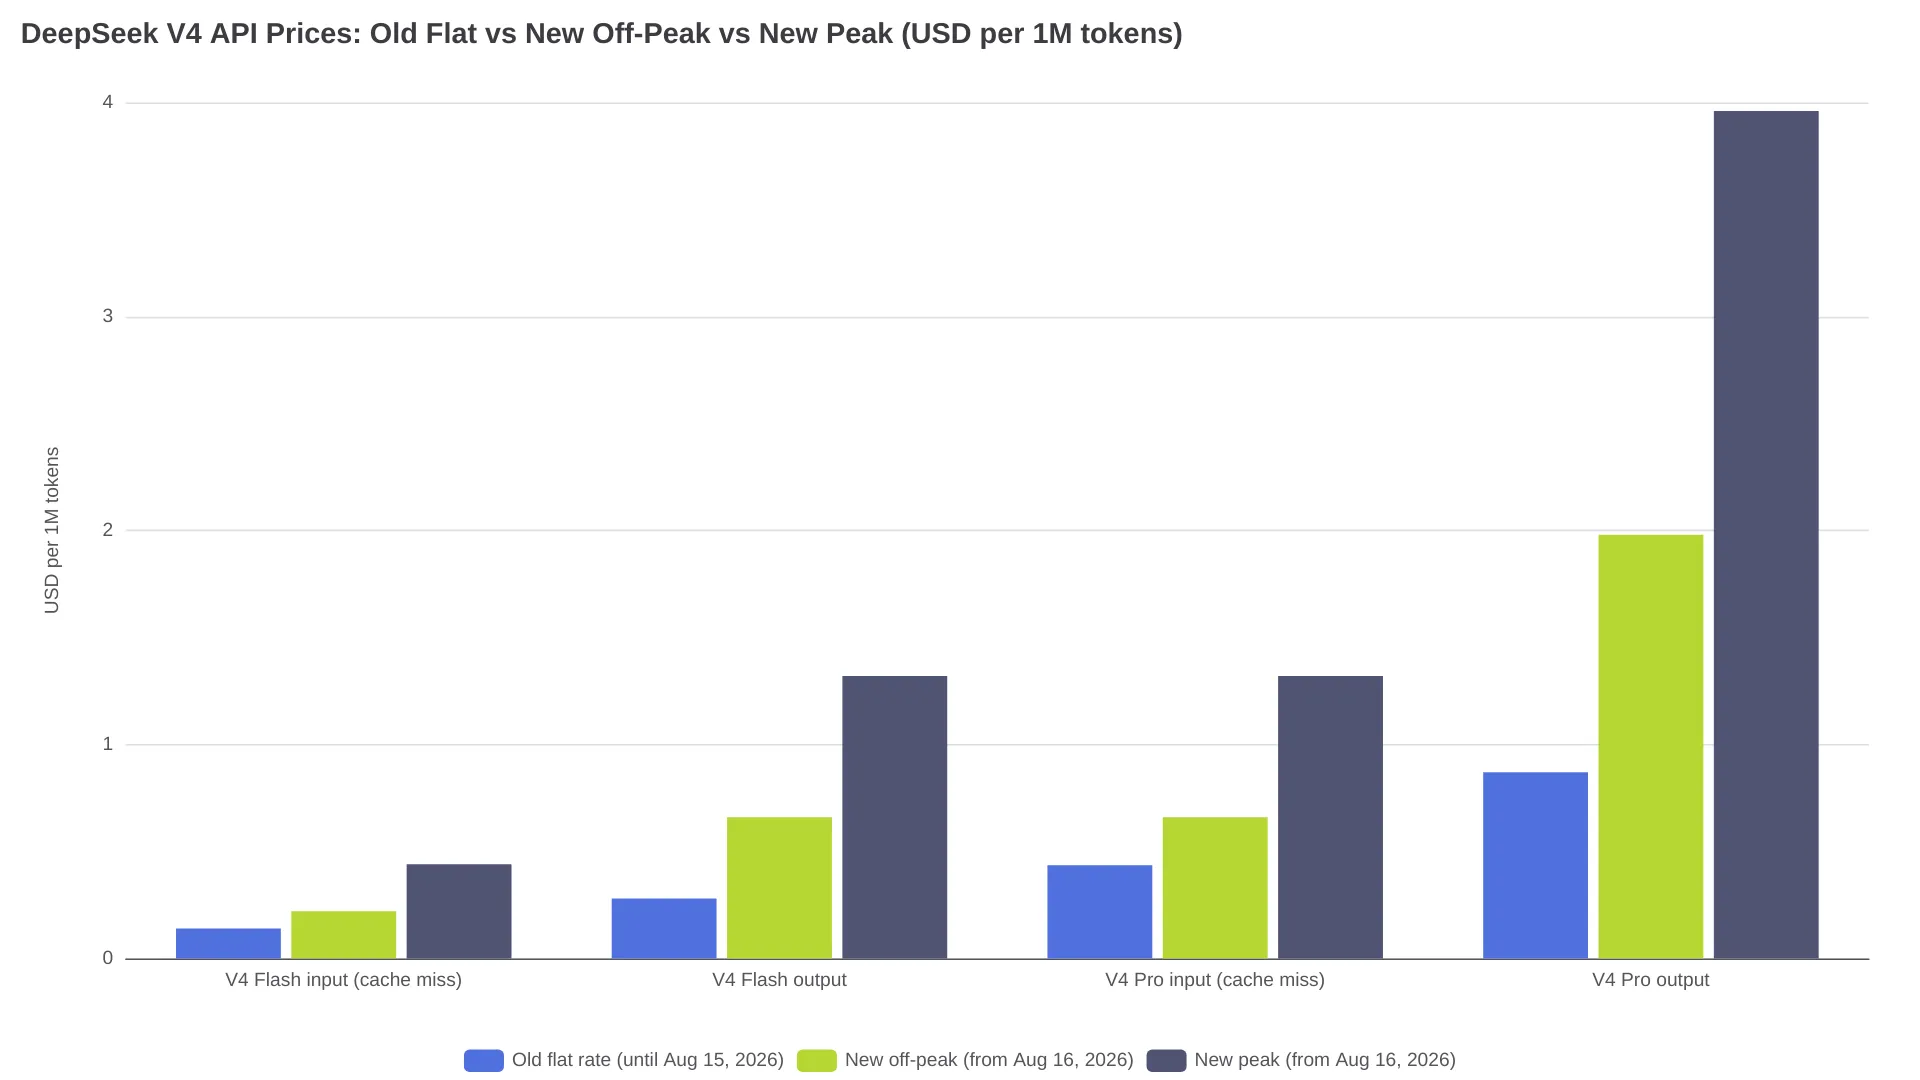
Reddit 上流传的“上涨 1,114%”并非错误,但它只对应一个非常具体的场景:V4 Pro 的高峰时段缓存命中输入,价格从 $0.003625 升至 $0.044。若工作负载没有缓存命中,非高峰时段的涨幅更接近 1.5–2.3 倍。你的实际涨幅,就落在这两个极端之间。
缓存占比越高,受冲击越大
缓存命中价格涨了 2.5–12 倍,而缓存未命中和输出价格上涨了 1.5–4.7 倍。也就是说,过去输入量越依赖超低价的缓存命中通道,账单的百分比涨幅就越大。一位 r/DeepSeek 用户将 650 次真实 API 调用重新按两套价格计算:共 16 个会话、155.9M 提示词 token、缓存命中率 98.09%,并将结果与 DeepSeek 控制台账单核对,误差在 2% 以内:
“你现在的缓存效果越好,涨幅就越大。”——u/Swimming-Soup-1173,对 r/DeepSeek 650 次 API 调用的审计
该用户的 Agent 工作负载在非高峰时段重算后为原来的 2.7×;同一工作负载若完全没有缓存命中,则为 1.5×。另一位用户测算了长上下文工作负载:非高峰成本从 $33 升至 $100,高峰则升至 $200,相当于上涨 3–6 倍。批处理任务、RAG 流水线,以及带固定系统提示词的 Agent 是此次最受挤压的类型;相比之下,一次性摘要这类流量更接近非高峰 1.5–2.3 倍的下限。
高峰时段换算到各地时区
官方页面只标注 UTC 时段。按 8 月的时区和夏令时换算如下:
| 地区 | 本地高峰时段 | 朝九晚五期间 |
|---|---|---|
| 北京(UTC+8) | 09:00–12:00、14:00–18:00 | 除 12:00–14:00 午休外均为高峰 |
| 中欧(UTC+2) | 03:00–06:00、08:00–12:00 | 上午为高峰 |
| 伦敦(UTC+1) | 02:00–05:00、07:00–11:00 | 上午为高峰 |
| 美国东部(UTC-4) | 21:00–00:00、02:00–06:00 | 工作时间完全处于非高峰 |
| 美国西部(UTC-7) | 18:00–21:00、23:00–03:00 | 工作时间完全处于非高峰 |
高峰时段基本覆盖中国工作日,唯独午休时间除外:北京时间 12:00–14:00 为非高峰。美国团队整个工作日都能享受非高峰价格;欧洲团队则会在上午批任务时支付双倍费用,适合将这些任务调整到下午或夜间执行。
提示词缓存还值得用吗?
值得,而且没有模糊空间。缓存优惠只是缩水,并没有消失。此前 Flash 的缓存命中输入约比未命中便宜 50 倍,Pro 则约便宜 120 倍;现在两款模型都约便宜 30 倍——非高峰时段 Flash 为 31 倍、Pro 为 30 倍,分别是 $0.007 对 $0.22、$0.022 对 $0.66。测得 2.7× 涨幅的审计作者仍然得出这样的结论:
“缓存依然绝对值得用。”——同一份 r/DeepSeek 审计
在该用户的工作负载中,相比每次都不走缓存地发送相同上下文,缓存仍可将成本压低约 15 倍。不过缓存采用尽力而为的机制,命中率没有保证;未使用的缓存条目通常会在数小时至数天后清除(BenchLM)。因此,预算前应先实测:按照 BenchLM 的建议,记录 usage 对象中的 prompt_cache_hit_tokens 和 prompt_cache_miss_tokens 字段,计算真实缓存命中占比。
涨价后,DeepSeek 还是低价选择吗?
非高峰时段是;高峰时段,Flash 相比 GPT-5.6 的价格优势已几乎消失。以下为标准费率下每 100 万 token 的输入和输出价格:
| 模型 | 输入 | 输出 | 备注 |
|---|---|---|---|
| DeepSeek V4 Flash(非高峰) | $0.22 | $0.66 | 1M 上下文 |
| DeepSeek V4 Flash(高峰) | $0.44 | $1.32 | 输出价格高于 Luna |
| GPT-5.6 Luna | $0.20 | $1.20 | 7 月 30 日降价 80% |
| DeepSeek V4 Pro(非高峰) | $0.66 | $1.98 | 仍比 Terra 低约 6× |
| DeepSeek V4 Pro(高峰) | $1.32 | $3.96 | 比 Terra 低约 3× |
| GPT-5.6 Terra | $2 | $12 | |
| Claude Sonnet 5 | $2 | $10 | 介绍价持续至 8 月 31 日,之后为 $3/$15 |
非高峰时段,V4 Flash 的 $0.66 输出价格比 GPT-5.6 Luna 低 45%,比 Terra 低 18 倍;对于高量输出任务,DeepSeek 仍是最便宜的选择。高峰时段,Luna 的输出价格为 $1.20、输入价格为 $0.20,两项标准费率都优于 Flash。不过,Luna 在AI Price Index 更新日志中的缓存读取费率为 $0.02/M,任意时段都高于 Flash 的缓存命中通道;同时,Flash 在官方规格表中仍标有 1M token 上下文和 2,500 并发。正如公告帖中一位评论者所说:“DS4 很好,但前提是便宜。”
这一周该怎么做
- 先重算自己的账单,不要急着恐慌。调取上个月的用量日志,按以下方式计算:缓存命中输入 × 命中率 × 命中价格 + 缓存未命中输入 × 未命中率 × 未命中价格 + 输出 × 输出价格。每次请求都要套用其执行窗口对应的高峰或非高峰费率。审计结果给出了区间参考:零缓存命中为 1.5×,98% 命中率为 2.7×。
- 把可批处理任务移到非高峰。Cron 任务、评测、文档处理等不需要用户实时等待的工作,都可以放在每天 17 个非高峰小时执行。对美国团队而言,这几乎不需要额外操作,因为工作日原本就在非高峰;欧洲团队则应将上午批任务移至下午。
- 继续维持缓存命中。任何目前能为你带来缓存命中的提示词结构都应保留,缓存命中通道的价格仍比缓存未命中输入低约 30 倍。
- 常规调用可测试降级到 Flash。Pro 的各项价格均约为 Flash 的 3 倍,缓存命中则为 3.1 倍。如果自 0731 后训练更新以来还没重新测试过 Flash,不妨将一部分常规流量切过去;模型选择的取舍可参考我们的 V4 Flash 与 V4 Pro 对比。
- 如果要迁移,改动可能很小。对于兼容 OpenAI 的客户端,迁移可能只需更改 base URL 和模型 ID。第三方托管商和中继平台会按自己的价目表收费——DataLLM Lab记录到,即便本次涨价前,已有托管商对 V4 Pro 报价约为每 100 万 token $1.74/$3.48。因此要比较实际有效费率,而不是只看标价。
用一张表总结决策:
| 你的情况 | 建议 |
|---|---|
| 美国时区、缓存占比高的 Agent 流量 | 继续使用——非高峰费率加上约 30× 的缓存通道,仍能将缓存密集型流量的输入成本维持在最低水平 |
| 欧洲时区、上午运行批任务 | 继续使用,但调整排程——高峰暴露是可以避免的 |
| 只能在高峰使用、对质量敏感的 Pro 编程任务 | 重新评估——Pro 高峰输出价格 $3.96 仍低于 Terra 的 $12,但差距已是 3×,不再是 8 月 16 日之前的 14× |
| 无缓存的一次性工作负载 | 继续使用——非高峰 1.5–2.3× 是表中最小的涨幅 |
常见问题
DeepSeek 新价格具体在什么时候生效?
根据 r/DeepSeek 的公告讨论帖及650 次调用审计报告,生效时间是 2026 年 8 月 16 日 16:00 UTC,即北京时间 8 月 17 日零点。当天官方定价页面也已更新为新价格表。
我的 DeepSeek 账单会涨多少?
没有缓存的工作负载在非高峰时段约为原来的 1.5×;实测缓存命中率 98% 的工作负载为 2.7×。高峰时段这些数字会翻倍,Pro 的缓存命中输入最高可达 12×。上方的倍数对照表列出了所有费率组合。
美国时区的高峰时段是什么时候?
美国东部时间为 21:00–00:00 和 02:00–06:00;美国太平洋时间为 18:00–21:00 和 23:00–03:00。美国常规工作时间完全位于非高峰窗口。
deepseek-chat 和 deepseek-reasoner 还能用吗?
不能。根据BenchLM 的模型 ID 历史记录,这两个旧别名已于 2026 年 7 月 24 日达到退役截止日期;新的集成应调用 deepseek-v4-flash 或 deepseek-v4-pro。
DeepSeek 仍比 GPT-5.6 和 Claude 便宜吗?
非高峰时段是:Flash 输出比 GPT-5.6 Luna 低 45%,比 Terra 低 18 倍。高峰时段,Luna 的输出价格为 $1.20/M,低于 Flash 的 $1.32/M,因此答案取决于你的流量实际运行在哪个时段。