 AIREITER
若工作流程需要直接處理截圖、文件或影片,GLM-5.3-Flash 是較自然的選擇;若主要是高快取命中率的文字與程式任務,則應先看 DeepSeek V4 Flash。比起單一跑分,實際工作負載與計費方式更能決定哪個模型划算。
先確認:這次比較的是哪些模型?
本文比較的是 GLM-5.3-Flash(glm-5.3-flash)與 DeepSeek 的正式 API 模型 deepseek-v4-flash;後者在官方定價頁中標示為 DeepSeek-V4-Flash-0731。DeepSeek V4 Pro,以及獨立的 deepseek-v4-flash-vision-exp 端點,都不能直接視為本文所指主要 Flash 模型的替代品。若想了解 Ox Alpha 的身分、硬體限制與預覽版注意事項,可參考 AIReiter GLM-5.3-Flash review。
依工作負載快速選擇
| 你的優先需求 | 建議選擇 | 原因 |
|---|---|---|
| 截圖轉程式碼、UI 檢查、影片或檔案輸入 | GLM-5.3-Flash | 同一模型原生支援圖片、影片與檔案輸入 |
| 高快取命中率的大量純文字處理 | DeepSeek V4 Flash | 官方快取輸入價格更低,尤其是離峰時段 |
| GLM 優惠期間的大量新輸入與高輸出流量 | GLM-5.3-Flash | 優惠輸入與輸出價格低於 DeepSeek 官方的未命中快取與輸出費率 |
| 以終端機為主的程式代理,且想採取較保守的正式環境選擇 | DeepSeek V4 Flash | 具備版本化公開 Beta 路線與官方 Flash 評測結果 |
| 視覺型瀏覽器或電腦操作代理 | GLM-5.3-Flash | 視覺回饋可直接留在程式或工具使用迴圈中 |
| 100 萬 token 的文字上下文 | 預設不選任何一方 | 兩者都宣稱具備百萬級上下文,應在實際提示詞長度下測試檢索效果 |
| 單一模型同時處理文字、程式碼與圖片 | GLM-5.3-Flash | 主要多模態流程不需要另接視覺端點 |
官方規格真正透露了什麼
Z.AI model documentation 與 Z.AI pricing page 說明了 GLM 的模型能力與計費方式;DeepSeek 對應資訊則可見於 Models & Pricing documentation 與change log,其中涵蓋 Flash 的版本與功能細節。
| 規格 | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| API 模型 ID | glm-5.3-flash | deepseek-v4-flash |
| 公開版本 | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| 上下文視窗 | 1M tokens | 1M tokens |
| 官方文件列出的最大輸出 | 128K tokens | 384K tokens |
| 主要輸入類型 | 文字、圖片、影片與檔案 | 文字與程式碼;視覺功能為獨立實驗性模型 |
| 輸出 | 文字 | 文字 |
| 推理控制 | 支援思考模式與 reasoning_effort | 提供思考與非思考模式,以及 low、high、max effort |
| 工具與結構化輸出 | Function calling、串流、上下文快取與 JSON 輸出 | 工具呼叫、JSON 輸出、Responses API 與 Anthropic API 相容性 |
| 權重 | 供應商已公開發布權重 | 供應商已公開發布權重 |
GLM 的 320B 總參數與 18B 活躍參數,描述的是稀疏專家架構,而不是可在本機運行的 18B checkpoint;DeepSeek 官方 Flash 定價頁則沒有公布可對照的參數量。
GLM 在主要模型路徑中即可接收視覺輸入;DeepSeek 則另提供 deepseek-v4-flash-vision-exp,這會改變模型路由與測試方式的假設。
程式能力與代理能力,要拆成兩種測試看
終端機代理主要考驗程式庫理解與工具執行;視覺代理則還必須能讀懂渲染後的介面與 GUI 狀態。
終端機與程式庫任務
Z.ai 的launch table,以及 DeepSeek 的官方 7 月 31 日更新,公布了以下結果:
| Benchmark | GLM-5.3-Flash | DeepSeek V4 Flash | 證據狀態 |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | 由兩家供應商分別公布的評測 |
| DeepSWE | 63.4 | 54.4 | 由兩家供應商分別公布的評測 |
| Toolathlon Verified | 78.4 | 70.3 | 由兩家供應商分別公布的評測 |
| AutomationBench | 48.8 | 25.1 | 由兩家供應商分別公布的評測 |
| Agents’ Last Exam | 26.3 | 25.2 | 由兩家供應商分別公布的評測 |
在這些供應商自行公布的 benchmark 中,GLM 領先;不過測試 harness 並不相同,這些數據適合拿來建立候選名單,不能直接代替最終選型。
獨立測試讓結論不再是一面倒。Composio 在 8 月 27 日測試了 30 項多步驟代理任務,結果顯示 GLM-5.3-Flash 完成 21/30 項,DeepSeek V4 Flash 則完成 20/30 項。DeepSeek 在 30 項任務中的 19 項速度最快;每項成功任務的回報成本約為 DeepSeek $0.028,GLM 約 $0.06。這些數字來自 Composio’s test,並非任一供應商提供。
若代理以終端機操作為主,而速度、可重現性與可辯護的初始選擇是關鍵限制,建議先從 DeepSeek V4 Flash 開始。若你重視首次修復品質或希望比較更廣泛的工具操作能力,再把 GLM 納入測試,衡量其是否值得高於該低成本基準的投入。
工具操作、瀏覽器狀態與視覺回饋
當代理必須檢查自己寫出的程式實際產生了什麼畫面時,GLM 的產品契合度更高。Z.ai 描述的流程是:模型讀取截圖或渲染介面、修改實作,接著再次檢查結果。這類迴圈適用於截圖轉程式碼、前端除錯、瀏覽器操作、文件處理,以及部分 3D 工作流程。
DeepSeek 可透過 deepseek-v4-flash 處理文字與程式碼代理任務;視覺輸入則要改走獨立的 deepseek-v4-flash-vision-exp。若既有流程本來就已經具備視覺路由,這種分離未必是問題。不過,若代理會在原始碼、瀏覽器截圖與影片之間切換,且不希望切換端點,GLM 會是更乾淨的選擇。網站上的 DeepSeek V4 Flash Vision Exp API guide 介紹了這個替代路線。
跑分之外,使用者實際怎麼說?
社群回饋顯示兩者更像取捨,而不是存在絕對贏家。一名使用者在重度使用 GLM-5.3-Flash 兩天後表示,它在較小上下文中表現不錯,也肯定其圖片支援,但提示詞變長後的穩定度較差:
「內容一變大,它就開始顯得焦躁而草率。」— @XBToshi,在公開比較中分享兩天的 GLM-5.3-Flash 重度使用經驗
這只是個人經驗,不代表失敗率;但它點出 benchmark 表格不容易呈現的問題:超大的上下文上限,不等於多輪代理行為一定穩定。
另一個小型Ollama experiment 也在供應商特定的配額單位上偏向 DeepSeek,但作者並未將那些單位直接等同於 API 的美元成本。
延遲與服務表現,可能讓答案改變
目前沒有針對這兩個確切模型、使用相同 harness 公開的 p50 延遲或吞吐量比較;不要把 Pro、Vision-Exp 或其他路線的數據套用過來。Composio 發現 DeepSeek 在 19/30 項代理任務中最快,這是有參考價值、但不等同於吞吐量的訊號。互動式助理應測量首次產生有用工具呼叫的時間;批次工作則應測量從開始到得到可接受結果的整體耗時。
每 token 的價格,不等於完成一項任務的成本
官方價目表給出的結論,比「DeepSeek 較便宜」更複雜。Z.AI 列出 GLM-5.3-Flash 的 50% 優惠活動,期限至 2026 年 9 月 9 日 24:00 UTC+8。DeepSeek 則依快取命中與未命中分別定價,另有尖峰與離峰費率。
以下價格皆以每 100 萬 tokens 的美元計算。
| 計費項目 | GLM-5.3-Flash 優惠價 | GLM-5.3-Flash 定價 | DeepSeek V4 Flash 離峰 | DeepSeek V4 Flash 尖峰 |
|---|---|---|---|---|
| 新輸入/快取未命中輸入 | $0.075 | $0.15 | $0.22 | $0.44 |
| 快取輸入 | $0.015 | $0.03 | $0.007 | $0.014 |
| 輸出 | $0.25 | $0.50 | $0.66 | $1.32 |
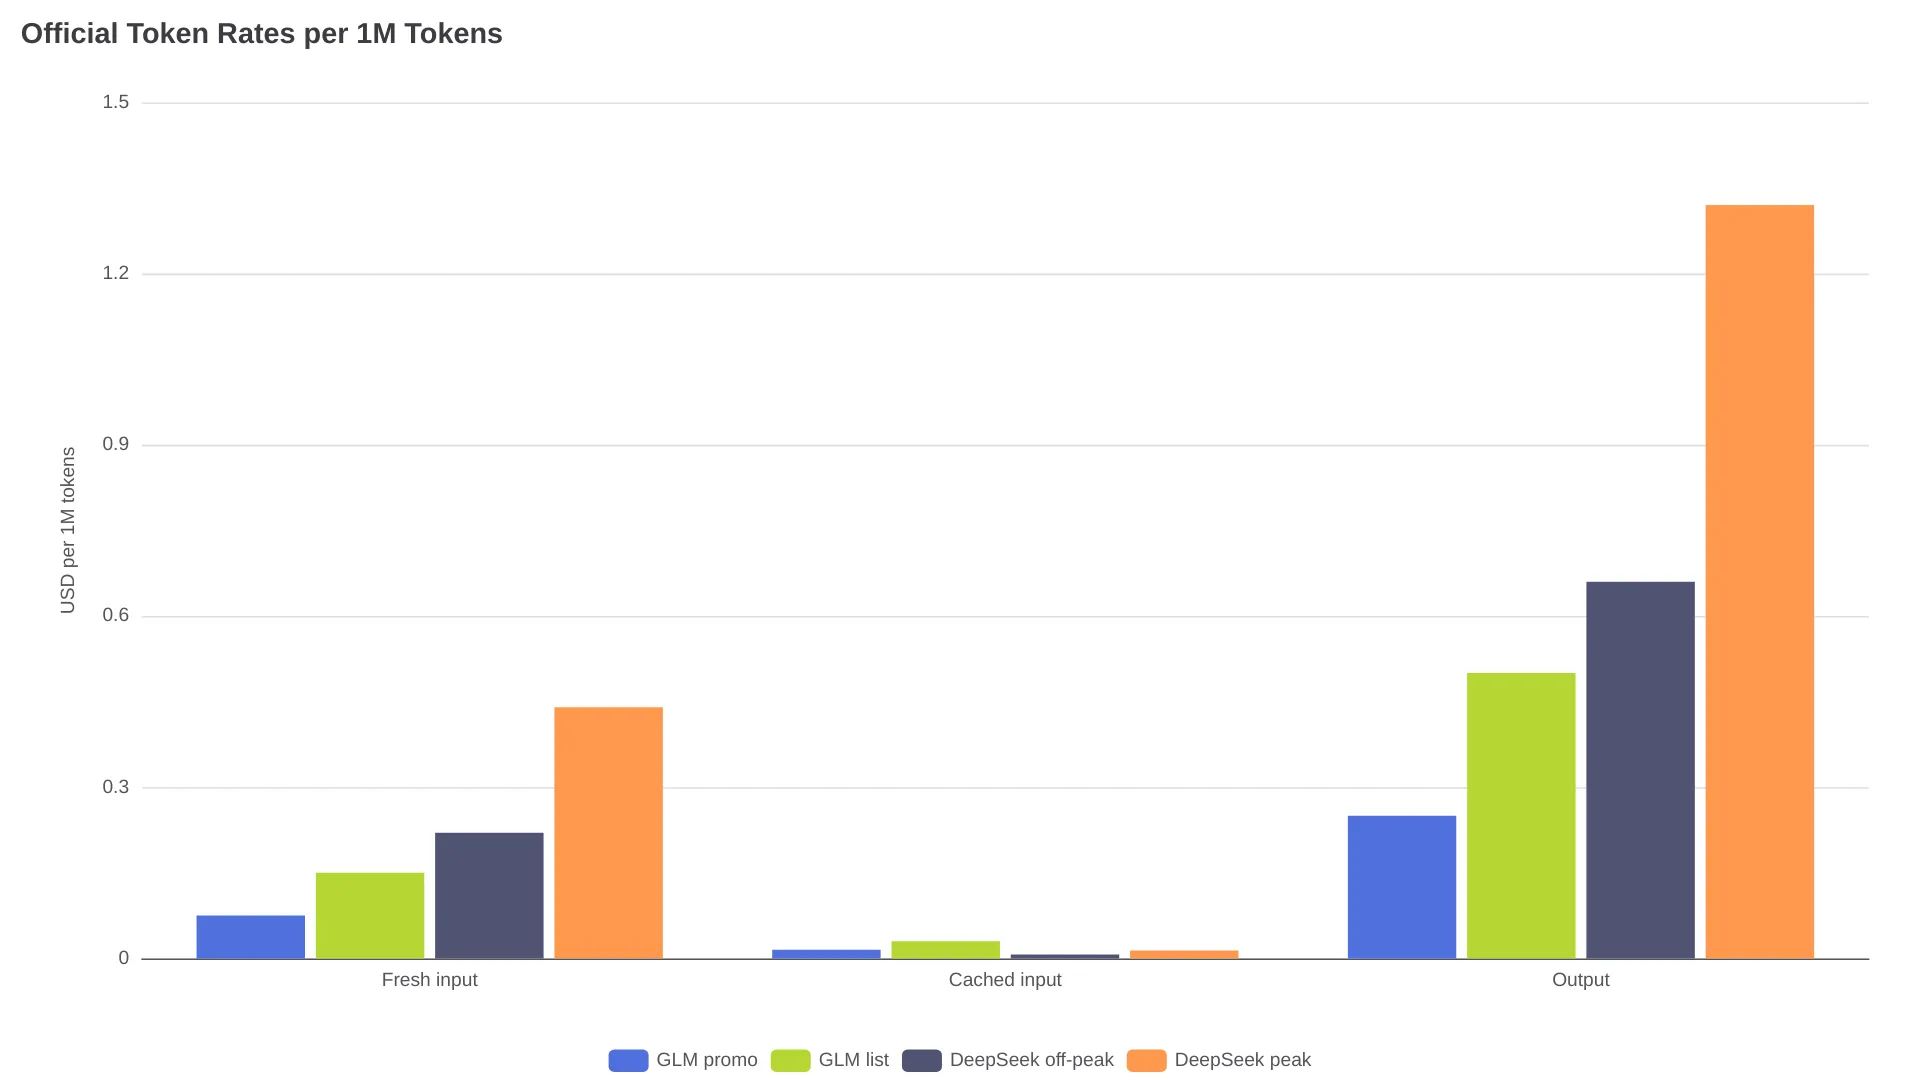
DeepSeek 的尖峰時段為週一至週五 01:00–04:00 UTC 與 06:00–10:00 UTC;其餘時間皆為離峰。官方表格也列出 V4 Flash 支援 2,500 併發。GLM 的定價頁列有期間限定的免費快取輸入儲存,但未在該頁提供通用的併發數字。
- 快取輸入價格由 DeepSeek 勝出,在所有對應時段都是如此。
- GLM 優惠期間的新輸入與輸出價格更低,優於 DeepSeek 官方的未命中快取與輸出費率。
- 即使優惠結束,GLM 的定價新輸入與輸出費率仍低於 DeepSeek 列出的離峰費率。
- DeepSeek 最有利的價格情境,是高快取、輸入占比高、輸出短的流量,尤其可排程至離峰時段時。
以 10M 輸入/2M 輸出為例
假設有 1,000 萬個新輸入 tokens、200 萬個輸出 tokens,不計工具費用與重試:
| 模型與計費路徑 | 計算方式 | 總計 |
|---|---|---|
| GLM 優惠價 | 10 × $0.075 + 2 × $0.25 | $1.25 |
| GLM 定價 | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek 離峰、快取未命中 | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek 尖峰、快取未命中 | 10 × $0.44 + 2 × $1.32 | $7.04 |
若全部 1,000 萬個輸入 tokens 都是快取命中,DeepSeek 離峰總價會是 $1.39(10 × $0.007 + 2 × $0.66),GLM 優惠價則為 $0.65(10 × $0.015 + 2 × $0.25)。當輸入與輸出的比例再拉高、而輸出很短時,DeepSeek 的快取優勢會變得更重要。
哪些情況下,DeepSeek 較低帳單足以定案?
若大多數請求都會重複使用很長且穩定的系統提示詞或程式庫前綴、輸出答案很短,並且可安排在非尖峰時段執行,應選 DeepSeek V4 Flash。分類、資料擷取、摘要,以及例行的純文字自動化,通常比截圖驅動的代理更符合這種模式。
GLM 的額外能力何時反而更省錢?
如果圖片、文件或影片原本需要額外發送一次視覺請求,GLM 可以降低整體流程成本。對於會產生長篇程式碼修補的代理而言,其優惠輸出費率也很重要。不過,應根據實際計費 token、修復迴圈與任務接受率驗證這個假設,而不是預設它一定在每項任務成本上獲勝。
長上下文是容量宣告,不是品質保證
兩份官方文件都列出1M-token 上下文視窗,因此單看上下文大小是平手。DeepSeek 列出的最大輸出為 384K;Z.AI 的模型文件則列出 GLM-5.3-Flash 為最大輸出 128K。只有允許異常長生成內容的應用,才會真正受到這項差異影響。
Z.ai 表示,相較於 GLM-5.3,GLM 的注意力計算量降低3.01×、KV-cache 大小降低4.44×,但同時指出 GLM 的 KV cache 仍略高於 DeepSeek V4 Flash。這些供應商主張無法證明 GLM 相較 DeepSeek 具有延遲或檢索品質優勢。
請在 50K、200K,以及你的實際最大提示詞長度下,測試檢索能力、工具完成率與任務接受率,並採用下方 gate 所列的接受規則。
選定預設模型,或同時建立路由
| 工作負載 | 第一個應測試的模型 | 備援或升級路徑 |
|---|---|---|
| 純文字分類與擷取 | DeepSeek V4 Flash | 若格式或品質不合格則改用 GLM |
| 高快取程式庫對話 | DeepSeek V4 Flash | 困難的修復回合交給 GLM |
| 終端機程式代理 | DeepSeek V4 Flash | 首次完成率重要時改用 GLM |
| 截圖轉程式碼 | GLM-5.3-Flash | 純文字後續工作使用 DeepSeek |
| 瀏覽器或電腦操作代理 | GLM-5.3-Flash | 非視覺規劃步驟使用 DeepSeek |
| 以影片、圖片或檔案為依據的分析 | GLM-5.3-Flash | 可接受獨立路由時採用 DeepSeek Vision Exp |
| 長文字搭配短輸出 | DeepSeek V4 Flash | 檢索品質下降時改用 GLM |
| 優惠期間的長程式碼生成 | GLM-5.3-Flash | 快取命中經濟性占主導時改用 DeepSeek |
在正式環境切換工作負載前,可先跑一個小型的相同 harness 驗證:
- 固定精確模型 ID:
glm-5.3-flash與deepseek-v4-flash;不要讓路由器在無提示的情況下替換成 Pro 或 Vision-Exp。 - 使用 20–50 個真實任務,涵蓋成功案例與近期失敗案例。若產品屬於代理型工作流,至少納入五個工具使用任務。
- 記錄通過率、修復迴圈、遺漏工具呼叫、首次有用動作時間、總輸入/輸出 tokens,以及快取命中率。
- 比較每個已接受任務的成本;在逾時率與失敗率穩定前,保留另一個模型作為備援。
Z.AI’s quick start 與 DeepSeek’s first API call guide 都說明了 OpenAI 相容存取方式;不過兩者的推理控制、視覺路由與計費語意並不相同。
採購方還常問的問題
GLM-5.3-Flash 和 Ox Alpha 是同一個模型嗎?
Z.ai 已正式確認,GLM-5.3-Flash 就是其先前以 Ox Alpha 匿名測試的模型。不過,預覽版的路由、配額與端點行為,不應被當成公開模型的永久規格。
先依照上方路由表選擇方向,再用固定 ID、真實失敗案例與相同 harness 驗證預設模型。GLM-5.3-Flash review 涵蓋模型身分與部署證據;DeepSeek V4 Flash Vision Exp API guide 則說明獨立的視覺路線。