 AIREITER
在正式揭曉之前,一個名為 Ox Alpha 的匿名模型已經在開發者社群流傳一段時間。如今,Z.ai 終於替這項實驗公開命名:GLM-5.3-Flash。不過,「Flash」這個名稱不能只看字面解讀:它每個 token 只啟用 18B 參數,但公開釋出的 checkpoint 總規模約為 320B,在本地執行時仍然需要相當可觀的硬體。
先講結論:Ox Alpha 就是 GLM-5.3-Flash 的預覽版本
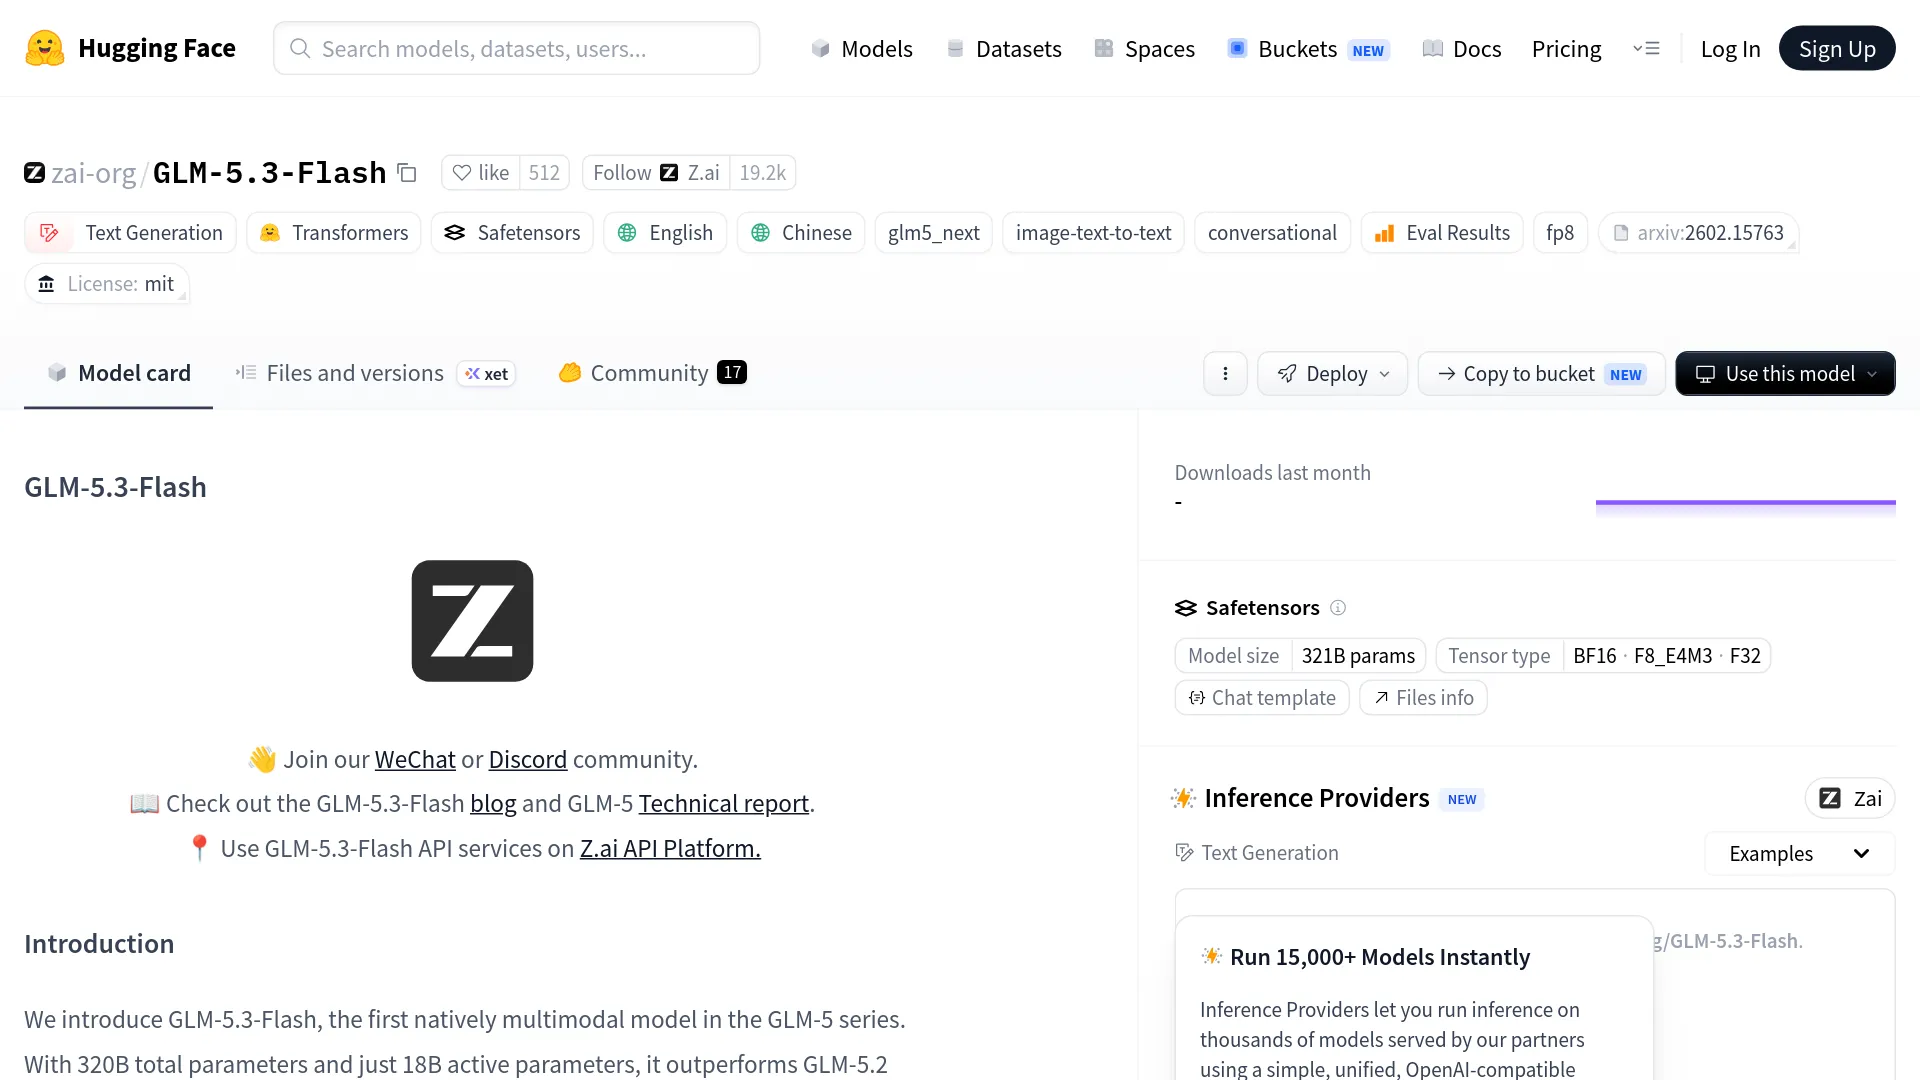
Z.ai 在2026 年 8 月 26 日的公告中確認,先前在 OpenCode 和 OpenRouter 上以匿名身分預覽的 Ox Alpha,正式名稱就是 GLM-5.3-Flash。官方的 Hugging Face model card 現在也列出公開 checkpoint、MIT 授權、多模態輸入,以及本地部署參考資料。
因此,Ox Alpha 時期的各種回報比較適合視為預覽階段的使用證據,而不是已正式出貨模型的規格說明。當時的 Ox Alpha 有自己的路由、流量和營運條件,早期使用者提到的速度、配額與政策限制,不一定適用於每一個 GLM-5.3-Flash 端點。
「對我來說什麼都沒變。這兩個模型對我的 32 GB RAM 系統來說都太大了。」—— u/dampflokfreund,發表於 r/LocalLLaMA
GLM-5.3-Flash 規格快速看
| 規格 | GLM-5.3-Flash |
|---|---|
| 正式發布 | 2026 年 8 月 26 日 |
| 早期預覽名稱 | Ox Alpha / ox-alpha |
| 模型規模 | 總參數量 320B,每個 token 啟用 18B |
| 上下文視窗 | 1,048,576 tokens(1M) |
| 輸入 | 文字、圖片與影片 |
| 輸出 | 文字 |
| 授權 | MIT |
| 官方 checkpoint | zai-org/GLM-5.3-Flash |
| API 標準輸入價格 | 每 1M tokens $0.15 |
| API 快取輸入價格 | 每 1M tokens $0.03 |
| API 標準輸出價格 | 每 1M tokens $0.50 |
Hugging Face 頁面顯示的模型儲存規模約為 321B 參數,而模型說明則以 320B-A18B 的簡寫呈現。這兩組數字分別代表儲存的總容量與每個 token 實際啟用的計算量;18B active 並不代表它在本地就是一個 18B 模型。
從 Ox Alpha 到公開版本,真正改變了什麼?
Z.ai 表示,在正式發布前,它曾以 Ox Alpha 的匿名身分在 OpenCode 和 OpenRouter 上運行 GLM-5.3-Flash,以蒐集真實世界的使用回饋。當時的 OpenRouter listing 將它列為支援多模態與長上下文的模型,並暫時提供 $0 價格;正式版本則讓服務提供者、checkpoint 和授權條款都有了清楚的公開歸屬。
不過,預覽版與正式模型仍然是兩個不同的運作環境。tokenizer 相同,或出現 GLM 風格的 API 錯誤,可以作為模型血統的線索,卻無法證明每一個匿名請求都使用了最終權重,或經過相同的路由層。如今,公開 checkpoint 才是部署與重現結果時應該採用的基準。
「Flash」名稱背後的模型架構
GLM-5.3-Flash 採用稀疏混合專家架構,並加入針對超長上下文降低成本的注意力機制改良。Z.ai 公布的設計包括 320B 總參數、18B 啟用參數、45 層、混合式稀疏與線性注意力、IndexPool 檢索,以及 Manifold-Constrained Hyper-Connections(mHC)。模型卡另指出,訓練資料來自一個 30T tokens 的多模態預訓練語料庫。
Z.ai 表示,在 1M 上下文下,與 GLM-5.3 相比,GLM-5.3-Flash 可減少 3 倍注意力計算量,KV cache 也縮小 4.4 倍。不過,這些是供應商提出的架構層面數據,並不等同於適用所有硬體的延遲保證。實際速度仍會受到上下文長度、並行請求數、視覺前處理,以及推論服務堆疊影響。
它原生支援多模態,對 agent 的價值比單純貼上「視覺聊天機器人」標籤更值得注意。Z.ai 設想的使用方式,是讓 agent 檢視已渲染的介面、瀏覽器狀態、文件或其他視覺產物,再據此修改程式碼或輸出結果。官方模型卡展示了圖片輸入,公開模型與部署文件也同時描述了影片輸入能力。
基準測試能證明什麼,又不能證明什麼?
官方發布資料與模型卡都呈現了相當強的結果,尤其是在程式設計與 agent 任務上。模型卡目前列出的項目包括 TerminalBench 2.1 的 84.3、DeepSWE 的 63.4,以及 HLE 的 55.3。Z.ai 的發布資料另外公布 Artificial Analysis Intelligence Index 得分 57、AutomationBench 得分 48.8,以及 Z.ai Code Bench 在 maximum-effort 設定下的 29.0。
| 基準測試 | GLM-5.3-Flash | 比較對象或基準 | 來源與限制 |
|---|---|---|---|
| TerminalBench 2.1 | 84.3 | GLM-5.2:81.0;Claude Opus 4.8:85.0 | Z.ai/模型卡結果;測試框架與資源預算都會影響結果 |
| DeepSWE v1.1 | 63.4 | GLM-5.2:46.2 | 公布的評測結果;不能直接套用到所有程式碼儲存庫 |
| AutomationBench | 48.8 | GLM-5.2:26.2 | 採用指定基準測試版本的公布評測結果 |
| Z.ai Code Bench,maximum effort | 29.0 | Claude Opus 4.8:29.5 | 在 Z.ai 測試設定下接近持平 |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai 表示與 Claude Opus 4.8 相當 | 外部綜合指數;測試任務並非只評估程式設計 |
這些結果採用不同的測試框架、上下文限制、逾時設定與評分模型,因此比較時應看整體方向,而不是把它們當成同一張萬用排行榜。比較穩妥的結論是:GLM-5.3-Flash 在程式設計 agent 評測上,有可信證據顯示它比 GLM-5.2 大幅進步;但這不代表它在所有前沿模型面前都占上風。
同樣的保留態度也適用於早期社群測試。@prz_chojecki 曾回報,Ox Alpha 在 ErdosBench 的全部 226 道題目上都取得比 GLM-5.2 更好的成績。這個觀察適合用來設計後續測試案例,卻不能取代針對你自己的工具鏈與程式碼儲存庫所做的受控評測。
早期使用者實際遇到的限制
「Flash」更可靠地描述了啟用計算量與成本定位,而不是互動延遲。r/opencodeCLI 的真實使用討論同時出現了優秀的程式設計成果與令人挫折的等待時間,尤其是在匿名預覽期間。這些是取決於服務提供商與工作負載的使用觀察,不是官方延遲基準。
「如果它比主模型慢很多,怎麼能叫作『Flash』?」—— u/ahriad,發表於 r/opencodeCLI
目前最值得關注的營運訊號,是高負載下長時間 agent 任務的穩定性。@solomonneas 曾回報,在為期七天的測試中完成了 49 次建置中的 30 次,另有 14 次失敗是因逾時造成。這並不能證明官方 API 存在固定失敗率,但對於可能執行數小時的任務而言,準備備援路由是合理做法。
基準測試標題往往掩蓋了另一個本地部署限制:官方 FP8 checkpoint 在計入執行環境與 KV cache 額外開銷前,就約需 306 GiB。換句話說,雖然每個 token 只啟用 18B 參數,總參數約 320B 的模型仍需要高記憶體基礎設施。
API、託管服務與本地部署怎麼選?
如果使用託管服務,Z.ai 的價格頁面列出 GLM-5.3-Flash 的價格為:每 1M 輸入 tokens $0.15、每 1M 快取輸入 tokens $0.03,以及每 1M 輸出 tokens $0.50。目前另有一項限時 50% 優惠,價格為輸入 $0.075、快取輸入 $0.015、輸出 $0.25,優惠至 2026 年 9 月 9 日 24:00(UTC+8)結束。由於優惠有明確截止時間,規劃預算前請先查看Z.AI 官方價格表。
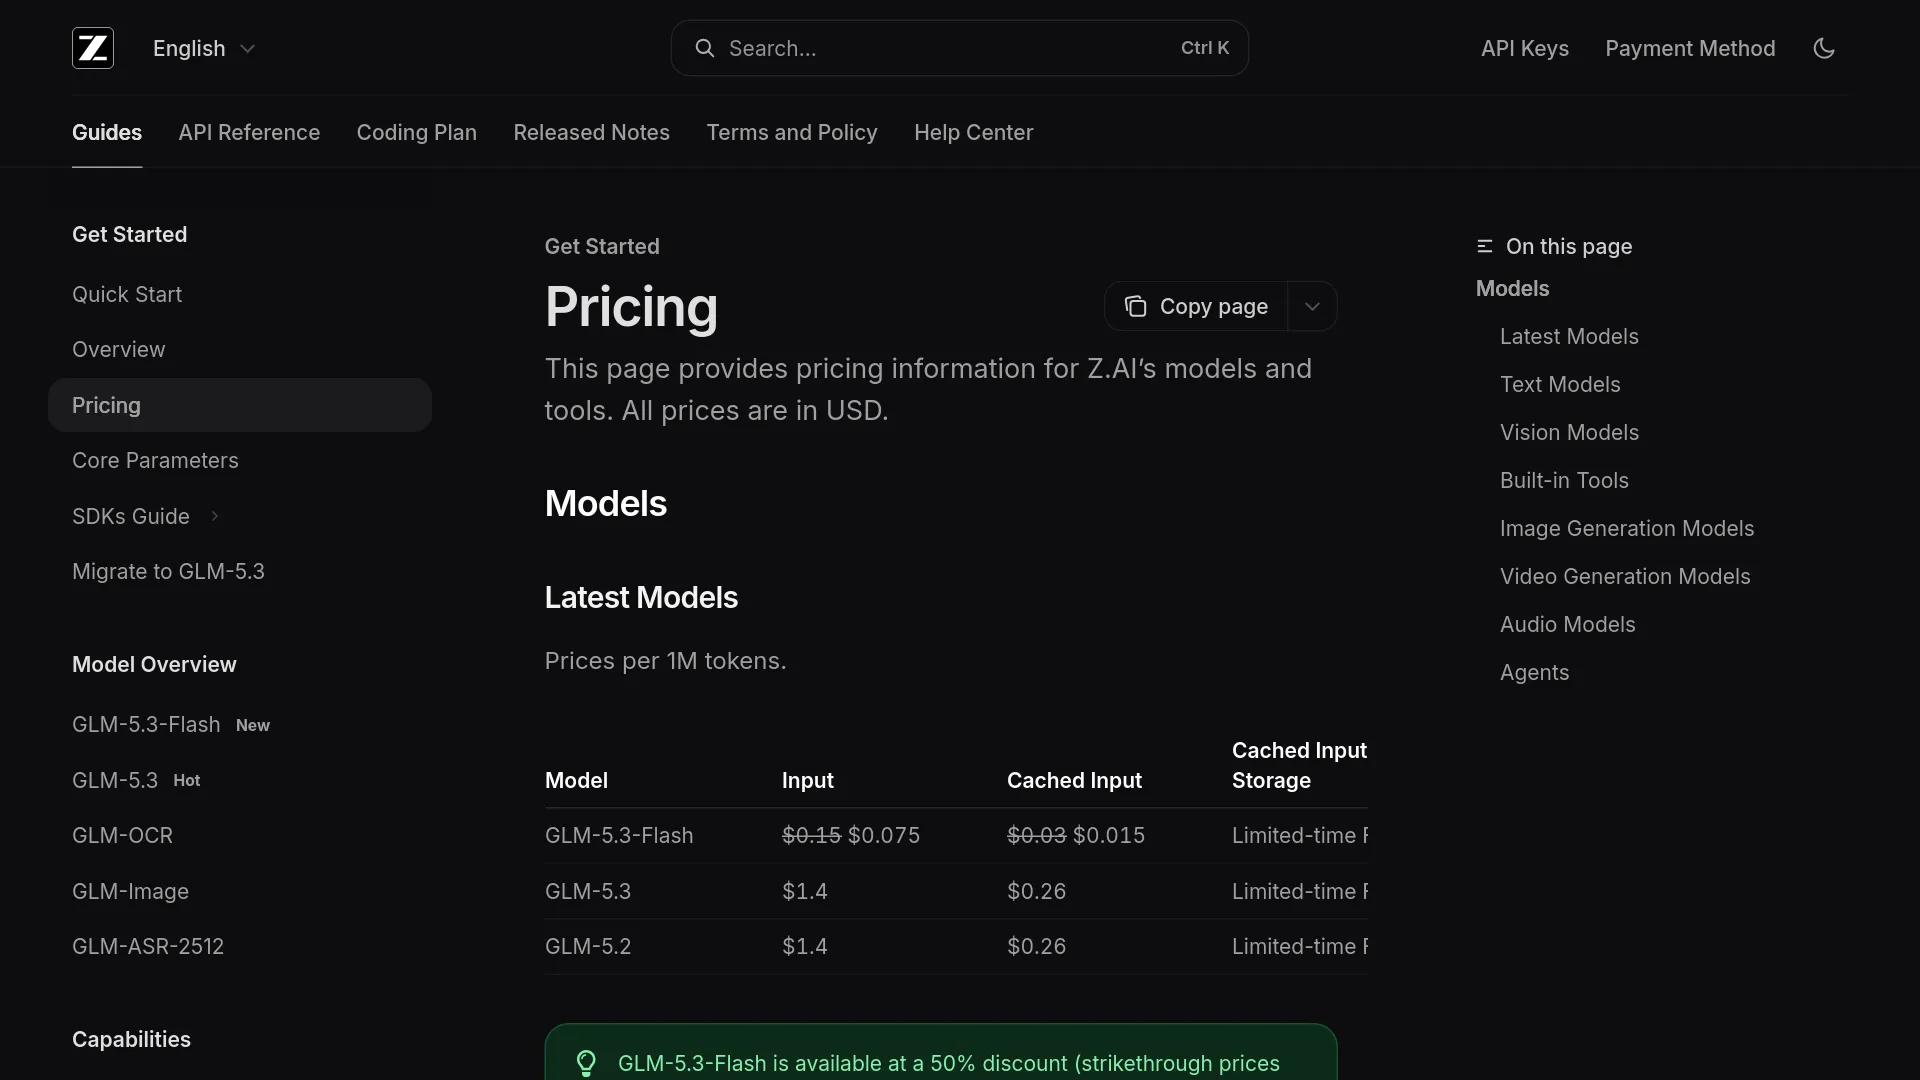
公開標準價格,與 Ox Alpha 預覽期間的臨時價格是兩回事。舉例來說,若使用 10M 輸入 tokens 加上 2M 輸出 tokens,按照標準價格計算,在不含其他供應商費用的情況下,總成本為 $2.50:10 × $0.15 + 2 × $0.50。如果供應商將部分輸入 tokens 視為快取內容並據此計費,輸入部分的成本還能進一步降低。
本地執行並非不可能,但它比較像一項基礎設施工程,而不是下載後就能在筆電上運作的模型。官方的 vLLM recipe 指出,FP8 權重約需 306 GiB;採用預設 FP8 部署時,需要 386GB VRAM,BF16 則列為 772GB。目前支援路徑要求 NVIDIA Hopper 或更新世代 GPU、近期版本的 FlashInfer,以及專用的 vLLM 映像檔,整合工作仍在持續成熟。
KTransformers 教學文件則記錄了 CPU-GPU 異質推論、直接使用官方 FP8 權重,以及至少 350GB 可用系統記憶體的需求。它提供的單 GPU 範例屬於 offload 配置,不能解讀為單張消費級 GPU 就能完整容納模型。該教學也採用經驗證的 501,025-token 設定,並將每次多模態請求限制為八張圖片或一部影片。
| 部署方式 | 文件支援的內容 | 主要限制 |
|---|---|---|
| Z.ai API | 按量計費的託管服務;公開標準與優惠 token 價格 | 確認速率限制、地區條款與目前優惠 |
| vLLM | FP8/BF16 服務、OpenAI 相容端點、tensor parallelism、多模態路徑 | 需要高記憶體 NVIDIA 基礎設施;目前 recipe 以 Hopper+ 為目標 |
| KTransformers | CPU-GPU 異質推論與 FP8 載入 | 權重約 306 GiB;建議至少 350GB 系統記憶體 |
| Ollama/LM Studio/llama.cpp 生態系 | 模型卡提供量化版本與相容工具的參考 | 量化支援與速度取決於具體版本 |
現在適合哪些人使用 GLM-5.3-Flash?
適合成本敏感的程式設計 agent,以及長上下文工程試驗。 低廉的標準價格、1M 上下文,以及相較 GLM-5.2 的評測進步,讓它很適合用於程式碼儲存庫分析、多檔案修改、測試產生,以及反覆呼叫 agent。正式採用前,仍應保留驗收測試與備援模型,直到你自己的成功率穩定下來。
當純文字 GLM 模型成為瓶頸時,適合用於多模態技術工作。 圖片與影片輸入能讓 agent 檢查瀏覽器畫面、UI 版面、圖表、文件和渲染結果。它不是影片生成器,而是理解視覺輸入後,以文字或程式碼回應。
不要只因為「18B active」聽起來像桌面級模型就選它。 這個 checkpoint 的總規模約為 320B 參數,在計入上下文與執行環境額外開銷前,本地部署就需要數百 GB 的儲存空間或記憶體。除非你手上已經有高記憶體推論硬體,否則使用託管 API 通常是更簡單、也更符合經濟效益的選擇。
不要把機密程式碼送進未驗證的預覽端點。 公開版 GLM-5.3-Flash 已正式歸屬於 Z.ai,但服務提供商的條款、資料保留政策與路由方式仍然重要。若要用於正式環境,請記錄端點目前的資料政策,並使用官方 API,或選擇營運條款可供你稽核的服務提供商。
常見問題
Ox Alpha 與 GLM-5.3-Flash 完全相同嗎?
Z.ai 已正式確認,GLM-5.3-Flash 就是先前以 Ox Alpha 名稱預覽的模型。早期 Ox Alpha 的行為仍有參考價值,但預覽階段的路由與限制不應當成公開模型的規格。
GLM-5.3-Flash 是開源模型嗎?
官方 Hugging Face checkpoint 採用 MIT 授權,Z.ai 也提供本地部署參考。更精確的說法是「開放權重」:模型權重可以取得,但要執行完整模型仍需要相當可觀的基礎設施。
GLM-5.3-Flash 在本地需要多少記憶體?
官方 FP8 權重在計入執行環境與 KV cache 額外開銷前,約占 306 GiB。vLLM recipe 列出的預設 FP8 部署需要 386GB VRAM,而 KTransformers 則建議異質推論至少準備 350GB 系統記憶體。
API 真的只要每百萬輸入 tokens $0.15 嗎?
是的。Z.AI 官方價格頁面列出的輸入價格為 $0.15、快取輸入為 $0.03、輸出為 $0.50;50% 優惠則列出至 2026 年 9 月 9 日(UTC+8)。
GLM-5.3-Flash 比其他 Flash 模型更快嗎?
現有證據無法建立一個適用所有情境的延遲排名。早期使用者曾回報 agent 工作階段速度緩慢或逾時,因此請在你實際使用的供應商路由上,測量首 token 時間、完成時間、重試次數與任務最終採納率。
GLM-5.3-Flash 支援圖片和影片嗎?
支援。Z.ai 與官方模型卡都描述了文字、圖片和影片輸入,以及文字輸出。另一方面,本地部署文件也列出請求限制,例如 KTransformers 文件中的設定每次最多支援八張圖片或一部影片。
如果你想使用 GLM-5.3-Flash 的低成本與多模態能力,又不想購買一台需要數百 GB 記憶體的推論伺服器,託管 API 會是較實際的選擇;只有在既有基礎設施已經到位時,才值得試行本地部署。至於長時間運行的 agent 任務,請保留經過測試的備援方案,因為目前公開證據對它的能力與價格較有信心,對持續互動的可靠度則仍然有限。