 AIREITER
如果你正在找GLM-5-3-Flash 替代方案,現在真正需要的,應該不是再看一次 Ox Alpha 揭曉身分的故事,而是找出一條能取代低價但偶爾偏慢的 Agent 路徑、避開 320B 本機模型,或在不重寫 API Client 的前提下保留多模態能力。該選哪個替代品,取決於你想解決的到底是成本、速度、硬體,還是可靠性問題。
先講結論:先釐清你要修正的是哪種問題
DeepSeek V4 Flash 適合需要快取命中計價、可選擇非思考模式,以及高並發能力的彈性文字路徑。它提供 1M token 上下文、2,500 個請求的並發上限,官方離峰價格則是每百萬個未快取輸入 token $0.22、輸出 token $0.66。
Qwen3.8-Flash 適合用來測試託管式多模態方案,尤其是你需要圖片與影片輸入、API 相容性和內建工具時。官方列出的價格是每百萬個輸入 token $0.15、輸出 token $0.47。
GLM-5.3 是留在 Z.ai 生態系、但升級到旗艦文字模型時的同系列方案。GPT-5.6 Terra 和 Claude Opus 4.8 則是高階路徑,適合「任務成功一次」的價值,值得支付數倍成本的情境。Kimi K3 提供 1M 上下文能力,但並不是便宜替代品。
真正的問題不是「哪個模型最強」,而是你目前要最佳化的是token 成本、視覺輸入、長流程程式碼工作、本機控制權,還是任務成功率。
Ox Alpha 端點已經消失:先確認你的遷移狀態
Z.ai 官方公告在 2026 年 8 月 26 日確認,匿名的 Ox Alpha 預覽版就是 GLM-5.3-Flash。正式公開後,Z.ai 提供了具名模型檢查點、公開價格、採用 MIT 授權的 Hugging Face 模型,以及有文件說明的 API 存取方式。舊版預覽環境不應被視為永久的模型合約:預覽路由、配額、延遲與政策行為,都可能和正式 API 不同。
如果現有設定仍在呼叫 stealth/ox-alpha,公開的 OpenRouter 識別碼是 z-ai/glm-5.3-flash;直接呼叫 Z.ai 時,則使用一般基礎 URL https://api.z.ai/api/paas/v4。Z.ai 另外提供 Coding Plan 專用端點 https://api.z.ai/api/coding/paas/v4,因此不要假設訂閱方案和一般 API 會採用完全相同的計費方式或限制。
既有的 AIReiter GLM-5.3-Flash 評測已經整理基準資料,包括 18B 活躍參數與約 320B 總參數檢查點之間的差異。本文接著回答下一個問題:當它的價格、速度、硬體需求或可靠性不再符合你的需求時,應該換成什麼?
「對我來說,什麼都沒改變。這兩個模型對我的 32 GB RAM 系統來說都太大了。」— u/dampflokfreund,r/LocalLLaMA
按價格、上下文與部署方式比較替代方案
以下價格是截至 2026 年 8 月 28 日查到的供應商公開資料快照,並非同一項促銷活動:DeepSeek 會依尖峰與離峰時段調整價格,而 Z.ai 的 Flash 價格則包含截至 2026 年 9 月 9 日 24:00 UTC+8 的限時折扣。
| 模型 | 輸入/每 1M token | 輸出/每 1M token | 上下文 | 輸入模態 | 最適合取代的原因 |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | 離峰 $0.22;尖峰 $0.44 | 離峰 $0.66;尖峰 $1.32 | 1M | 文字 | 支援快取感知的文字路由與非思考模式 |
| Qwen3.8-Flash | $0.15 | $0.47 | 1M | 文字、圖片、影片 | 託管式多模態與 API 相容性 |
| GLM-5.3 | $1.40 | $4.40 | 1M | 文字 | 同一供應商、更高能力的同系列路徑 |
| GPT-5.6 Terra | $2.00 | $12.00 | 1.05M | 文字 | 需要更高成功信心的複雜 Agent 工作 |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | 文字 | 高難度程式設計與長上下文檢視 |
| Kimi K3 | $3.00 | $15.00 | 1M | 文字 | 需要長上下文的高能力工作 |
Z.ai 目前列出的 GLM-5.3-Flash 價格,在 50% 促銷期間為每百萬 token 輸入 $0.075、快取輸入 $0.015、輸出 $0.25。牌價則分別是 $0.15、快取輸入 $0.03,以及輸出 $0.50。比較圖採用牌價,而不是暫時促銷價。(Z.ai 價格資訊)
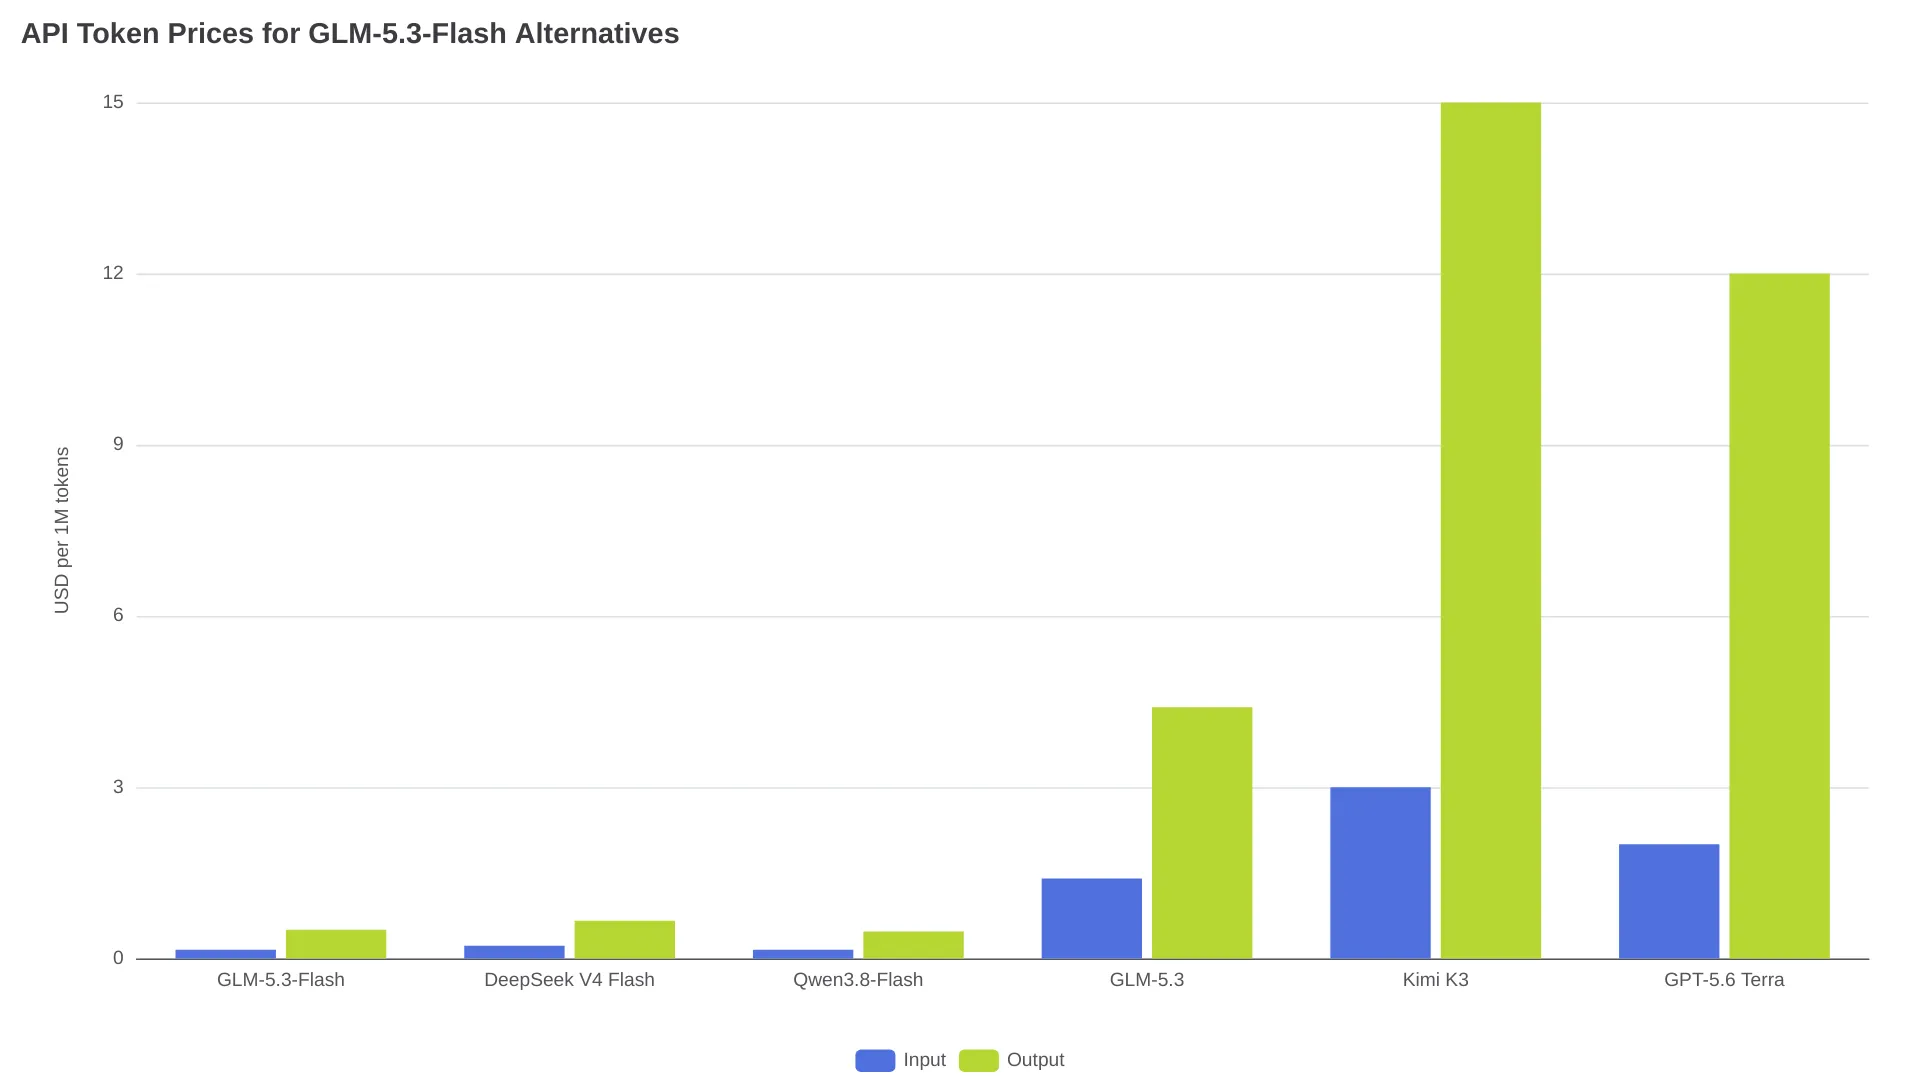
價格基準:GLM-5.3-Flash 牌價、DeepSeek V4 Flash 官方離峰價格,以及其他列出模型目前由供應商公布的價格。DeepSeek 尖峰價格是離峰價格的兩倍。
6 條值得實際測試的替代路徑
DeepSeek V4 Flash:懂快取的文字與程式碼路徑
DeepSeek V4 Flash 是 GLM-5.3-Flash 用於日常文字流量時價格太高,最值得優先測試的模型。DeepSeek 列出的能力包括 1M token 上下文、384K 最大輸出、JSON 輸出、工具呼叫、Responses API,以及 Anthropic 相容存取。官方並發上限為 2,500 個請求。
它的計費差異很關鍵。DeepSeek 將快取命中與未命中分開計價,並在平日尖峰時段 01:00–04:00 與 06:00–10:00 UTC 將價格加倍。此外,它同時支援思考與非思考模式;相較之下,GLM-5.3-Flash 模型卡記載的是低、高與最大推理強度,而不是簡單的關閉思考選項。
如果你的工作負載會重複使用上下文、以檢索為主,或是文字限定的程式碼任務,而且在意快取命中或可控的推理模式,可以選 DeepSeek V4 Flash。不過,Qwen3.8-Flash 的新 token 牌價更低,因此 DeepSeek 並不會在每一種文字請求中自動成為最便宜的選擇。它也不是視覺輸入的直接替代品:圖片輸入要使用 DeepSeek 另一條 deepseek-v4-flash-vision-exp 路徑,而且由圖片產生的 token 會按輸入計費。
Qwen3.8-Flash:最接近的託管式多模態替代品
Qwen3.8-Flash 是你的 Agent 會傳送螢幕截圖、圖表或影片,而且希望保留單一 API 介面時,最接近的託管式替代方案。QwenCloud 列出圖片、文字與影片輸入;上下文長度 1M token;最大輸入 991K;最大輸出 131K。它支援 OpenAI 與 Anthropic 相容 API、工具、結構化輸出、快取、批次處理、網路搜尋與微調。
實際運作上的取捨在於快取計價。QwenCloud 列出的隱式快取讀取價格是每百萬 token $0.016,明式快取建立為 $0.20,輸出則為 $0.47。公開限制為每分鐘 2M token、每分鐘 15,000 個請求,但該頁面沒有說明這些限制是套用在帳戶、金鑰、組織,還是部署層級。
如果視覺輸入不可或缺,或你更在意新 token 價格,可以優先選 Qwen3.8-Flash。不過,官方模型頁面沒有提供具名的基準測試表、延遲結果或長工作階段可靠性研究,因此不要因為功能列表相似,就直接假設實際行為也完全相同;請用自己的 Agent trace 驗證。
GLM-5.3:Flash 不夠用時的同系列升級
GLM-5.3 並不是平價替代品。當問題是文字工作的深度不夠,而不是價格或多模態能力不足時,它才是合理的升級路徑。Z.ai 的價格表列出每百萬 token 輸入 $1.40、快取輸入 $0.26、輸出 $4.40,約為 Flash 牌價的一個數量級。
Z.ai 將 GLM-5.3 定位為旗艦程式碼模型,而 GLM-5.3-Flash 則是成本較低、原生支援多模態的模型。對於困難且以文字為主的任務,可以選擇性地改用 GLM-5.3;但升級後,也可能失去讓 Flash 實用的視覺工作流程。
GPT-5.6 Terra:需要更高 Agent 執行成功率時
GPT-5.6 Terra 適合重視複雜任務完成度、而不是低 token 價格的團隊。OpenAI 列出的價格是每百萬 token 輸入 $2、快取輸入 $0.20、輸出 $12,上下文視窗約為 1.05M token。在 Z.ai 公開的基準測試表中,GPT-5.6 Terra 在 Terminal-Bench 2.1 得分 87.4、DeepSWE v1.1 得分 69.6;在所引用的測試設定下,高於 GLM-5.3-Flash 的 84.3 與 63.4。
這些數字足以支持你在「程式碼任務失敗的代價高於 API 費用」時測試 Terra,但不能證明它在所有正式環境都全面勝出。比較適合把它當成高價值儲存庫修改或複雜自主工作的升級層。
Claude Opus 4.8:處理高難度程式碼與長上下文檢視
Claude Opus 4.8 依 Anthropic 的標準全球價格計算,每百萬 token 輸入 $5、輸出 $25。Anthropic 另外列出每百萬 token $0.50 的快取讀取價格,以及標準輸入與輸出價格一半的批次處理費率。
在 Z.ai 的比較表中,Opus 4.8 在 Terminal-Bench 2.1、Agents’ Last Exam、HLE with Tools 與 NL2Repo 領先 GLM-5.3-Flash;但在數個高度依賴工具與自動化的項目中,則由 Flash 勝出。這種分布更適合把 Opus 當成經過測量後的升級模型,而不是所有工作負載的通用預設值。
Kimi K3:為了 1M 上下文能力,而不是低價推論
Kimi K3 解決的是另一種切換需求:如果你需要 1M 上下文路徑,處理長時間的軟體工程或研究工作流程,它就值得納入比較。Kimi 列出的價格為每百萬 token 快取輸入 $0.30、輸入 $3、輸出 $15。
以這樣的價格來看,只有在它的上下文長度與能力特性足以支撐溢價時,才適合選 Kimi K3。若你的問題是「如何降低 token 帳單」,它就不是答案。
按照工作負載選模型,不要只看排行榜
| 你的工作負載或限制 | 優先測試的模型 | 原因 |
|---|---|---|
| 大量文字分類或擷取 | Qwen3.8-Flash | 新輸入與輸出 token 牌價低於 DeepSeek V4 Flash 離峰價格 |
| 帶有重複前綴的長文字 | DeepSeek V4 Flash | 快取命中計價,並可選擇非思考模式 |
| 大多數輸入都是新內容的長文字 | Qwen3.8-Flash | 新 token 牌價較低 |
| API 工作流程中需要螢幕截圖、圖表或影片 | Qwen3.8-Flash | 原生圖片/影片輸入與熟悉的 API 協定 |
| 留在 Z.ai 生態系,但需要更複雜的文字推理 | GLM-5.3 | 保留同一供應商,同時升級到更高的系列層級 |
| 失敗代價高的程式碼工作 | GPT-5.6 Terra | 具備更強引用程式碼分數的高階升級方案 |
| 仔細的程式碼檢視或儲存庫規劃 | Claude Opus 4.8 | 高階推理能力,並提供快取與批次選項 |
| 上下文比價格更重要的長流程工作 | Kimi K3 | 定位為具備 1M 上下文的高能力模型 |
| 一般筆電或 32GB 工作站 | 先用託管式 API | GLM-5.3-Flash 是約 320B 總參數的檢查點,不是 18B 的本機模型 |
本機部署的門檻相當高。官方 GLM-5.3-Flash 檢查點約有 320B 總參數;AIReiter 的部署評測記錄指出,FP8 佔用空間約為 306 GiB,而以 vLLM 預設部署時約需要 386GB VRAM。量化可以降低門檻,但仍不是一般筆電能隨手下載執行的模型。
更穩妥的 Agent 遷移方式
把供應商介面和任務路由分開,接著用真正重要的工作負載評估替代方案。
- 保留單一請求介面。只要供應商支援,就保留 OpenAI 相容的訊息、工具與結構化輸出層。至於推理控制、視覺載荷、工具呼叫、結構化輸出和上下文限制,應該視為能力旗標,而不是每個模型都通用的欄位。
- 測試任務是否完成,不只看生成文字。記錄程式碼能否建置、工具呼叫是否有效、視覺檢查是否通過,以及任務能否在不重試的情況下完成。第一次回覆很便宜,但如果需要兩次以儲存庫規模進行的重試,總成本未必比較低。
- 按照失敗模式分流。重複上下文的文字工作交給 DeepSeek V4 Flash,多模態請求交給 Qwen3.8-Flash;高風險程式碼任務則依照你的驗收結果,分配給 GPT-5.6 Terra、Claude Opus 4.8 或 GLM-5.3。
- 保留備援路徑。AIReiter 評測記錄了一次為期七天的社群測試:49 次嘗試中有 30 次成功建置,並有 14 次逾時失敗。這不是所有供應商在所有情境下的失敗率,但已足以說明正式環境的 Agent 不該只依賴單一路徑。
- 按照正常價格編列預算。Z.ai 的 Flash 促銷將於 2026 年 9 月 9 日結束。DeepSeek 價格會依尖峰時段變動;Qwen 的快取建立與快取讀取也採用不同價格。只有在臨時費率下才成立的遷移方案,不能算是穩定的成本模型。
實際上,可以先準備 10 個日常或文字密集型請求,再加上 10 個程式碼、工具使用或視覺任務。比較任務成功率、完成所需總時間、重試次數與 token 總支出。對許多團隊而言,這代表先測試用 DeepSeek V4 Flash 處理重複上下文文字,用 Qwen3.8-Flash 處理多模態工作,同時保留 GLM-5.3-Flash 作為備援,直到新路徑證明足夠可靠。
常見問題
Ox Alpha 最好的免費替代方案是什麼?
在本文查閱的官方資料中,尚未確認有永久且不受供應商限制的免費替代品。供應商可能提供變動中的配額或促銷,但正式環境的決策應以公開付費價格為依據,並把免費存取視為額外福利。
哪個替代方案支援圖片和影片?
Qwen3.8-Flash 官方列出圖片、文字與影片輸入。DeepSeek 的標準 V4 Flash 路徑和 deepseek-v4-flash-vision-exp 路徑不同,因此在遷移視覺 Agent 前,務必先測試實際使用的端點。
哪個替代方案可以在本機執行?
開放權重方案包括 GLM-5.3-Flash 檢查點與 Qwen3.8-Flash-Next。GLM-5.3-Flash 約有 320B 總參數;Qwen 的開放權重 Flash-Next 文件則記載原生 262K 上下文,並可透過 YaRN 延伸至 1M。不要假設其中任何一個都能塞進 32GB 機器。
更換供應商後,如何避免出現預期之外的問題?
在兩條路徑上執行 20 個具代表性的任務,比較任務成功率、完成所需總時間、重試次數與 token 總支出。在替代方案於你自己的工具和儲存庫上證明可靠之前,保留現有的 GLM-5.3-Flash 路徑作為備援。