 AIREITER
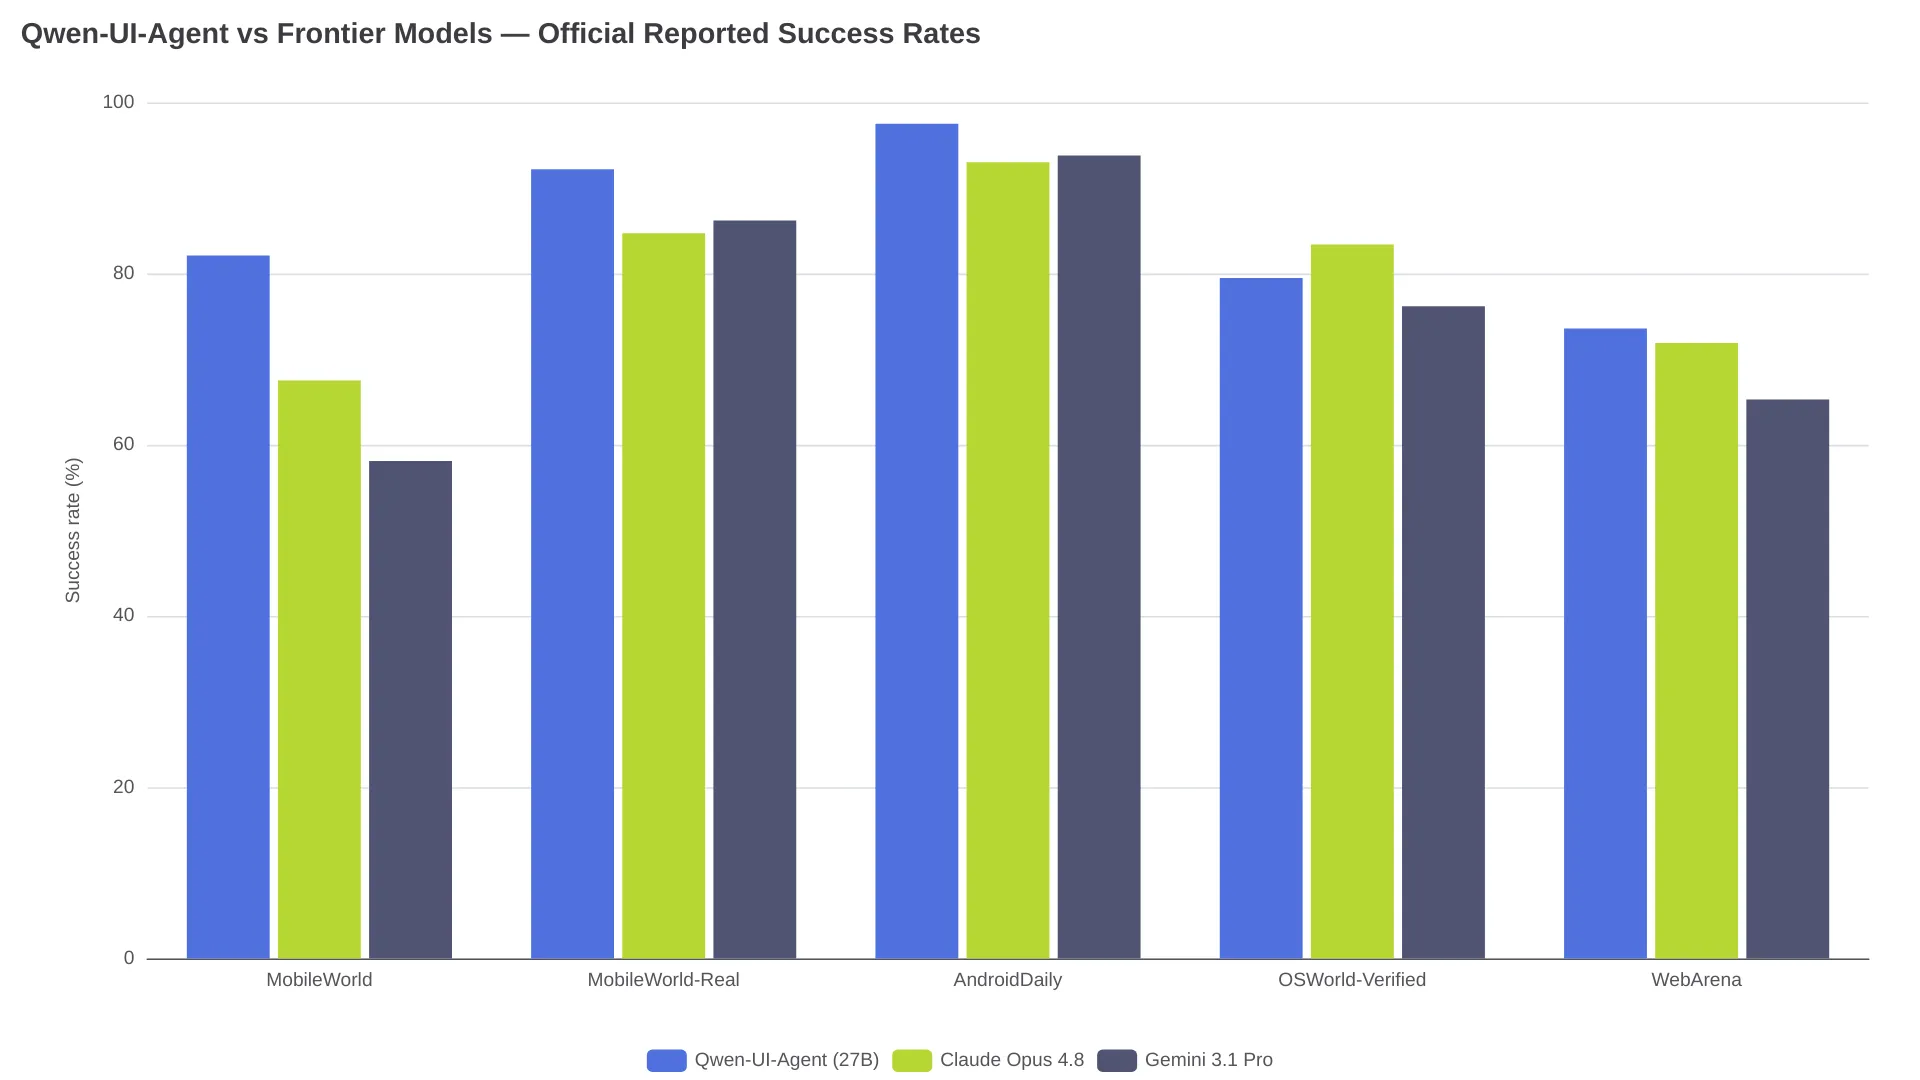
В официальных сравнительных тестах Qwen-UI-Agent особенно уверенно выглядит на мобильных устройствах: 92.2% в реальном MobileWorld-Real и 97.5% в AndroidDaily. Но саму 27B-модель, показавшую эти результаты, пока нельзя ни скачать, ни вызвать через API. На сегодня доступны технический отчёт, демонстрации и только более ранние компактные модели семейства MAI-UI. В этом и состоит главное противоречие релиза: лидерские цифры есть, а практического доступа к модели нет. Ниже собраны все официальные результаты и подробно разобрано, что именно можно получить уже сейчас.
Все результаты Qwen-UI-Agent: мобильные устройства, ПК, веб и grounding
Qwen-UI-Agent — базовая GUI-агентная модель команды Tongyi-MAI из Alibaba, представленная в техническом отчёте 30 июля 2026 года (arXiv 2607.28227). Единая модель работает в мобильных сценариях, задачах управления компьютером, веб-средах и DeepSearch. Её общее пространство действий охватывает операции в GUI, выполнение CLI-команд и пакетные последовательности действий. На официальной странице результатов Qwen-UI-Agent занимает первое место во всех показанных мобильных и grounding-бенчмарках, второе — в OSWorld-Verified и третье — в долгосрочном тесте OSWorld-v2. В отчёте оцениваются варианты на 27B, 35B-A3B и 4B параметров; приведённые ниже результаты относятся к флагманской версии 27B.
Мобильные сценарии: заявка на лидерство
Именно в мобильных задачах авторы заявляют state of the art — и отрыв здесь заметный. В GUI-only части MobileWorld Qwen-UI-Agent набирает 82.1%: это на 8.9 пункта выше ближайшей универсальной модели Seed 2.1 Pro с 73.2% и на 38.2 пункта выше сильнейшего специализированного GUI-агента GUI-Owl-1.5-32B-Instruct с 43.9%.
| Модель | MobileWorld (только GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
В официальных таблицах для мобильных строк указан GPT-5.6 Sol с результатами 70.1 / 85.4 / 92.6, а для десктопных — GPT-5.5. Это важно учитывать, прежде чем ссылаться на отдельную цифру для «GPT».
MobileWorld-Real — центральный бенчмарк отчёта и собственная разработка авторов. Он включает 409 сквозных задач в 104 реальных Android-приложениях из семи повседневных категорий. Тесты запускаются на физических устройствах, с настоящими аккаунтами и помехами из реального мира, а оценку выставляет ансамбль из пяти VLM по принципу большинства голосов.
Управление компьютером: сильный результат, но не первое место
На десктопе формулировка отчёта о «конкурентоспособности» звучит уже более сдержанно. Qwen-UI-Agent получает 79.5% в OSWorld-Verified и занимает второе место, уступая Claude Opus 4.8 3.9 пункта. В долгосрочном OSWorld-v2 показатель 40.0% отражает частичный прогресс, а не долю полностью завершённых задач: при бинарной оценке результат составляет 13.9%. Claude Opus 4.8 с 54.8 и GPT-5.5 с 49.5 находятся заметно впереди.
| Модель | OSWorld-Verified | OSWorld-v2 (частичный прогресс) | OSWorld-v2 (бинарная оценка) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | не указано |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | не указано | не указано |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | не указано | 22.3 | не указано |
При этом аргумент об эффективности выглядит убедительно. Пакетные действия снижают среднее число шагов на задачу до 135.8 — против 326.7 у MiniMax M3 и 173.5 у Qwen 3.7 Plus. Одновременно Qwen-UI-Agent опережает каждую модель с открытыми весами более чем на 17 пунктов по частичному прогрессу. В OSWorld-v2 свыше 50% операций агента приходится на CLI-команды, так что гибридная схема GUI+CLI здесь даёт измеримый эффект.
Веб-задачи и DeepSearch
В WebArena лидирует Qwen-UI-Agent с 73.6%: впереди Claude Opus 4.8 с 71.9, GPT-5.5 с 69.5 и Gemini 3.1 Pro с 65.3. В исследовательских задачах BrowseComp модель получает 64.1 против 61.0 у базовой Qwen3.5-27B, а в BrowseComp-ZH — 75.0 против 62.1. Иными словами, обучение DeepSearch улучшает не только наведение на элементы интерфейса.
GUI grounding: первое место во всех тестах
В grounding-задачах — когда по визуальной инструкции нужно нажать точно в нужную точку интерфейса — Qwen-UI-Agent показывает полный набор первых мест. Согласно официальной странице результатов, модель лидирует во всех представленных grounding-бенчмарках.
| Бенчмарк | Qwen-UI-Agent | Лучший конкурент |
|---|---|---|
| ScreenSpot-Pro (без масштабирования) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (с увеличением) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
Цена универсальности оказалась небольшой
Специализированные GUI-модели нередко теряют способность нормально работать как языковые модели. Qwen-UI-Agent в основном избегает этой проблемы: в MMLU-Pro она набирает 86.5 против 86.0 у Qwen3.5-27B, а в IFEval — 90.2 против 90.4. На фоне узкоспециализированных конкурентов разрыв становится огромным.
| Бенчмарк | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | не указано | не указано | не указано |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
Единственное заметное поражение собственной базовой модели — QwenClawBench: 44.2 против 48.5. Также стоит учесть, что на официальной странице эти показатели общих способностей помечены как воспроизведённые авторами в собственной среде оценки.
Как обучали Qwen-UI-Agent
Согласно техническому отчёту, данные для Qwen-UI-Agent собирались на парке реальных устройств: более 100 физических смартфонов с покрытием свыше 150 приложений. Эта инфраструктура питает агентный цикл сбора данных, в котором система самостоятельно формирует и диагностирует задачи. После supervised fine-tuning модель проходит многоэтапное RL-обучение на траекториях длиннее 100 ходов, развёрнутых более чем в 10 000 параллельных сред.
Насколько можно доверять этим таблицам
На официальной странице есть три важных оговорки, и их стоит упоминать вместе с любыми цитируемыми результатами. Во-первых, MobileWorld-Real создан самими авторами. Во-вторых, результаты базовых моделей, отмеченные кинжалом, были воспроизведены авторами в собственной среде: тестовый harness, судья, симулятор и подмножества задач могут отличаться от официальных оценок других поставщиков. В-третьих, 40.0% в OSWorld-v2 — это частичный прогресс, а не процент успешного завершения задач. Источник: примечания на официальной странице результатов и технический отчёт.
«Новый GUI-агент Alibaba побеждает на телефонах и буксует на десктопе». — @Daily_AI_Brief на X, где также отметили, что «Alibaba оценивала все базовые модели в собственной среде».
Независимые разборы в X пришли к похожему выводу. Японский обзор от @itarutomy отметил лидерство на мобильных устройствах с реальными девайсами, но подчеркнул второе место в десктопных тестах. Первичным источником о самом релизе остаётся официальный анонс Pengxiang Li из Tongyi Lab (@oliverlee1999). Вывод такой: MobileWorld-Real — сильная, но пока ожидающая независимого воспроизведения заявка; OSWorld-Verified — более переносимое сравнение, поскольку этот бенчмарк создан не авторами модели.
Как получить доступ к Qwen-UI-Agent сейчас
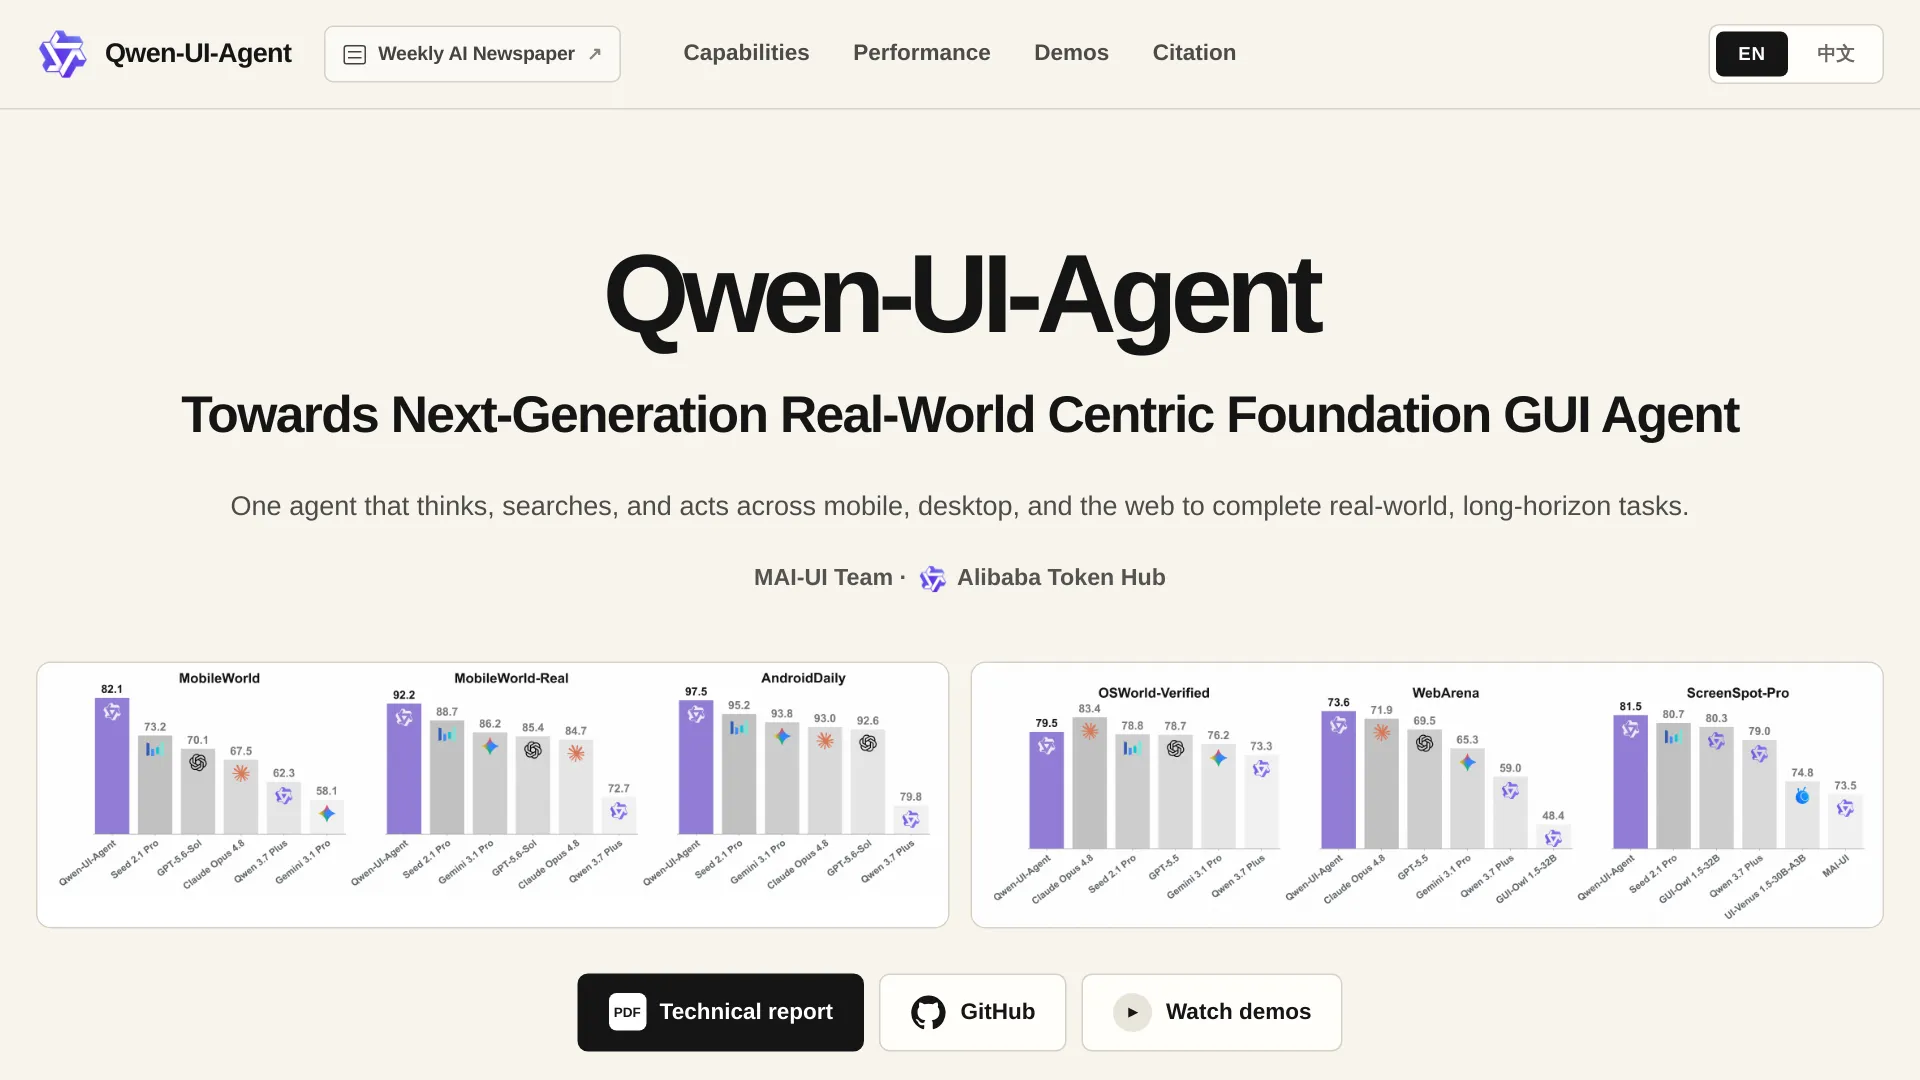
На данный момент Qwen-UI-Agent существует как исследовательский релиз: опубликованы статья, страница проекта и репозитории с кодом, но подтверждённого публичного чекпойнта самой модели нет. Ниже — что содержит каждый из доступных артефактов.
Что опубликовано на самом деле
| Артефакт | Ссылка | Содержимое |
|---|---|---|
| Технический отчёт | arxiv.org/abs/2607.28227 | Полная статья, отправлена 30 июля 2026 года; доступны PDF, HTML и исходники TeX |
| Страница проекта | tongyi-mai.github.io/Qwen-UI-Agent | Демонстрации возможностей, полные графики бенчмарков, информация для цитирования |
| Репозиторий MAI-UI | github.com/Tongyi-MAI/MAI-UI | Репозиторий Apache-2.0, переименованный для Qwen-UI-Agent; содержит ссылки на чекпойнты MAI-UI-8B и MAI-UI-2B в Hugging Face, выпущенные в декабре 2025 года |
| Репозиторий Qwen-UI-Agent | github.com/Tongyi-MAI/Qwen-UI-Agent | Только исходники сайта — в репозитории прямо указано, что моделей, кода обучения и реализации агента там нет |
Официальным продолжением проекта служит репозиторий MAI-UI: 30 июля 2026 года в нём анонсировали Qwen-UI-Agent, и сейчас именно оттуда ведут ссылки на единственные доступные для скачивания чекпойнты этой линейки.
Что известно о весах моделей
Скачать можно только MAI-UI-8B и MAI-UI-2B — предшественников, выпущенных в декабре 2025 года. Ссылки на них размещены в разделе Hugging Face репозитория MAI-UI. Публичный выпуск чекпойнтов Qwen-UI-Agent на 27B, 35B-A3B или 4B параметров не подтверждён. Статус доступности проверялся по официальным репозиториям и странице проекта в конце августа 2026 года, и релиза там не обнаружилось. Не следует принимать ссылки на чекпойнты MAI-UI или репозиторий с исходниками сайта за веса Qwen-UI-Agent.
API и локального запуска пока нет
Ни в одном официальном канале не обнаружены публичный API Qwen-UI-Agent, размещённый сервис или пакет для vLLM/Ollama. Практический выбор сейчас такой: для десктопных сценариев, которые нужно внедрять в продукт, опубликованные результаты склоняют в пользу Claude Opus 4.8; для экспериментов с GUI-моделями с открытыми весами доступен путь через MAI-UI 2B/8B и собственный harness. Но это именно MAI-UI, а не Qwen-UI-Agent. За анонсами релиза стоит следить в официальных репозиториях Tongyi-MAI и каналах Qwen. Для универсальной линейки Qwen, у которой API уже доступен, каталог моделей Qwen от AIReiter отслеживает актуальные эндпоинты и цены.
Место Qwen-UI-Agent в эволюции GUI-агентов Alibaba
Qwen-UI-Agent — третье поколение GUI-агентов Alibaba. UI-TARS заложил подход Qwen к работе с графическими интерфейсами в 2025 году. MAI-UI (arXiv 2512.22047, декабрь 2025 года) представил ориентированный на реальные сценарии цикл сбора данных и открыл веса 2B/8B. Qwen-UI-Agent масштабирует этот рецепт до 27B и добавляет гибридное выполнение через GUI+CLI. В обеих метриках OSWorld из таблиц выше лидирует Claude Opus 4.8.
Qwen-UI-Agent: ответы на частые вопросы
Qwen-UI-Agent — это open source?
Репозитории кода распространяются по лицензии Apache-2.0, а отчёт находится в открытом доступе, но открытые веса самой модели не подтверждены. Скачать можно только чекпойнты предшественника MAI-UI-8B и MAI-UI-2B, опубликованные в Hugging Face в декабре 2025 года. На момент написания текста не было подтверждённого публичного релиза Qwen-UI-Agent на 27B, 35B-A3B или 4B параметров.
Можно ли сегодня запустить Qwen-UI-Agent локально?
Нет. Проверенной локальной конфигурации не существует: нет чекпойнта, пакета GGUF или Ollama, а также рецепта для vLLM. Локальные эксперименты ограничены MAI-UI 2B/8B с собственным harness.
Есть ли у Qwen-UI-Agent API?
Нет, публичный эндпоинт или размещённый продукт не анонсированы. Следите за объявлениями в официальных GitHub-репозиториях Tongyi-MAI и каналах команды Qwen.
Как Qwen-UI-Agent сравнивается с Claude Opus 4.8 в управлении компьютером?
Claude Opus 4.8 лидирует в OSWorld-Verified со счётом 83.4 против 79.5 и в OSWorld-v2 по частичному прогрессу — 54.8 против 40.0. В то же время Qwen-UI-Agent впереди в WebArena, 73.6 против 71.9, и во всех показанных мобильных бенчмарках. Для длительных десктопных задач сейчас предпочтительнее Claude, а самые сильные заявленные результаты Qwen-UI-Agent относятся к mobile-first сценариям.
Что такое MobileWorld-Real?
Это Android-бенчмарк на реальных устройствах, созданный авторами Qwen-UI-Agent: 409 задач в 104 работающих приложениях из семи повседневных категорий. Оценку проводит ансамбль из пяти VLM по большинству голосов. Результаты заявлены самими авторами и ожидают независимого воспроизведения.
Что может изменить эту оценку
Существенно пересмотреть картину заставят три сигнала:
| Сигнал | Почему это важно |
|---|---|
| Чекпойнт Qwen-UI-Agent в Hugging Face-аккаунте Tongyi-MAI | Превратит исследовательский релиз в вариант, на котором можно строить решения, и запустит поток сторонних результатов |
| Воспроизведение OSWorld-Verified вне инфраструктуры Alibaba | Покажет, сохраняется ли результат 79.5% за пределами среды авторов |
| Любая продуктовая форма: API, интеграция в приложение Qwen или превью | Переведёт сравнение из плоскости таблиц в статье к реальным компромиссам продакшена |
До тех пор остаётся нерешённый вопрос: лидерские результаты в мобильных сценариях из опубликованных сравнений заявлены самой командой и получены на бенчмарке, который она же разработала.
Читайте также: о новом универсальном флагмане Alibaba и статусе его открытых весов рассказывается в материале Qwen3.8-Max open weights, а стоимость эндпоинтов собрана в Qwen3.8-Max API pricing guide.