 AIREITER
Веса Qwen3.8-2.4T-A95B появились на ModelScope 12 августа 2026 года — спустя три недели после статуса «скоро». Главная цифра здесь — 2,4 трлн параметров, однако на обработку каждого токена задействуется лишь 95 млрд. Есть и существенное ограничение: даже в 4-битной квантизации модели требуется около 1,2 ТБ VRAM. Запустить её локально смогут разве что владельцы дата-центров. Разбираемся, что именно вышло, во сколько обходится доступ и почему для большинства случаев API остаётся единственным разумным вариантом.
Веса Qwen3.8-2.4T-A95B уже можно скачать
Checkpoint опубликован. Команда Qwen от Alibaba разместила Qwen3.8-2.4T-A95B в аккаунте сообщества ModelScope поздно вечером 12 августа. Это первая модель уровня Qwen-Max, для которой компания открыла веса. Три предыдущие версии — Qwen3.5-Max, Qwen3.6-Max и Qwen3.7-Max — были доступны только через API.
Важно не путать два продукта с названием «Qwen3.8»:
| Название | Что это | Где получить |
|---|---|---|
| Qwen3.8-2.4T-A95B | Базовая модель с открытыми весами | ModelScope (checkpoint для скачивания) |
| Qwen3.8-Max | Облачная версия с дополнительными возможностями для production | Alibaba Token Plan, Qoder, QoderWork |
Qwen3.8-Max построена на открытой модели A95B, но получила дополнительные улучшения после обучения. Alibaba описывает трёхэтапную систему: масштабирование в реальной среде, единые сигналы вознаграждения и онлайн-балансировку данных. Открытые веса дают базовую модель, но не весь production-стек Max.
Материалы, где веса всё ещё названы «обещанными, но недоступными», уже устарели: релиз состоялся в обозначенное Alibaba окно — на неделе 10 августа.
Подтверждённые характеристики: 95B активных параметров и 256K контекста
После предварительного запуска 19 июля ключевой неизвестной оставалось число активных параметров. Во многих сторонних гайдах оно прямо отмечалось как «не опубликовано». Теперь есть официальный ответ: на каждый токен активируется 95 млрд параметров из общего объёма в 2,4 трлн.
| Характеристика | Подтверждённое значение |
|---|---|
| Всего параметров | 2.4T |
| Активных параметров на токен | 95B |
| Архитектура | MoE (развитие гибридного дизайна Qwen3.5) |
| Экспертов в каждом MoE-слое | 512 |
| Маршрутизируемых экспертов на токен | 10 |
| Общих экспертов на токен | 1 |
| Нативное контекстное окно | 262,144 токенов (256K) |
| Расширяемый контекст | 1,010,000 токенов (1.01M) |
| Метод обучения | Multi-Token Prediction (MTP) |
| Первый релиз Qwen-Max с открытыми весами | Да (12 августа 2026 года) |
Здесь есть два важных нюанса. Во-первых, нативное окно контекста составляет 256K, а не 1 млн токенов, как многие предполагали. Значение 1,01M относится к расширяемому режиму, компромиссы по качеству для которого Alibaba пока не раскрыла. Во-вторых, маршрутизация MoE крайне разреженная: на токен срабатывает лишь 11 из 512 экспертов — 10 маршрутизируемых и один общий. Именно такое соотношение активных параметров, около 4% (95B из 2.4T), позволяет экономически обосновать цену $2 за миллион входных токенов, несмотря на общий масштаб модели.
Обучение MTP (Multi-Token Prediction) означает, что совместимые движки инференса могут предсказывать несколько токенов за один прямой проход, потенциально повышая пропускную способность. Какие именно движки это поддерживают, Alibaba не уточнила.
Self-hosting Qwen3.8: во что упираются 2,4T параметров
Характеристики впечатляют, пока не приходит время загружать модель в память. Посчитаем реальные требования.
При 4-битной квантизации 2,4 трлн параметров занимают приблизительно 1,2 ТБ памяти — без учёта KV-кеша, памяти активаций и накладных расходов рантайма. У NVIDIA H200 доступно 141 ГБ памяти. Восемь H200 суммарно дают 1 128 ГБ: этого недостаточно, чтобы одновременно разместить веса и обслуживать сколько-нибудь значимое контекстное окно.
| Сценарий развёртывания | Требуемая VRAM (оценка) | Оборудование | Практично? |
|---|---|---|---|
| Полная точность (16 бит) | ~4.8 TB | 34+ H200 GPUs | Только дата-центр |
| 4-битная квантизация | ~1.2 TB | 9+ H200 GPUs | Только дата-центр |
| 1,5-битная квантизация | ~450 GB | 4+ H200 GPUs | На пределе; потери качества неизвестны |
| Qwen3.8-27B (альтернатива) | ~27 GB at 4-bit | 1 consumer GPU | Да |
95 млрд активных параметров помогают с производительностью инференса на токен: при каждом прямом проходе модель обращается лишь к части экспертов. Но это не уменьшает объём памяти, необходимый для хранения всех 512 экспертных сетей. Как сформулировали в GEO Toolbox: «Разреженная активация делает модель недорогой в эксплуатации в масштабе, но не дешёвой во владении».
Для локального запуска или развёртывания на одном сервере реалистичным выбором остаётся вариант Qwen3.8-27B. Он относится к той же обучающей линейке Qwen3.8 и в 4-битной квантизации помещается на одной потребительской GPU. Версия на 2,4T параметров — решение для исследований и дата-центров.
Почему в большинстве случаев разумнее выбрать API
Самостоятельно развернуть MoE-модель на 2,4T параметров недоступно почти любой команде, поэтому практический путь к Qwen3.8 лежит через API. В Model Studio Qwen3.8 Max стоит $2 за миллион входных токенов и $6 за миллион выходных токенов. Это дешевле и предшественника, и ближайшего китайского конкурента.
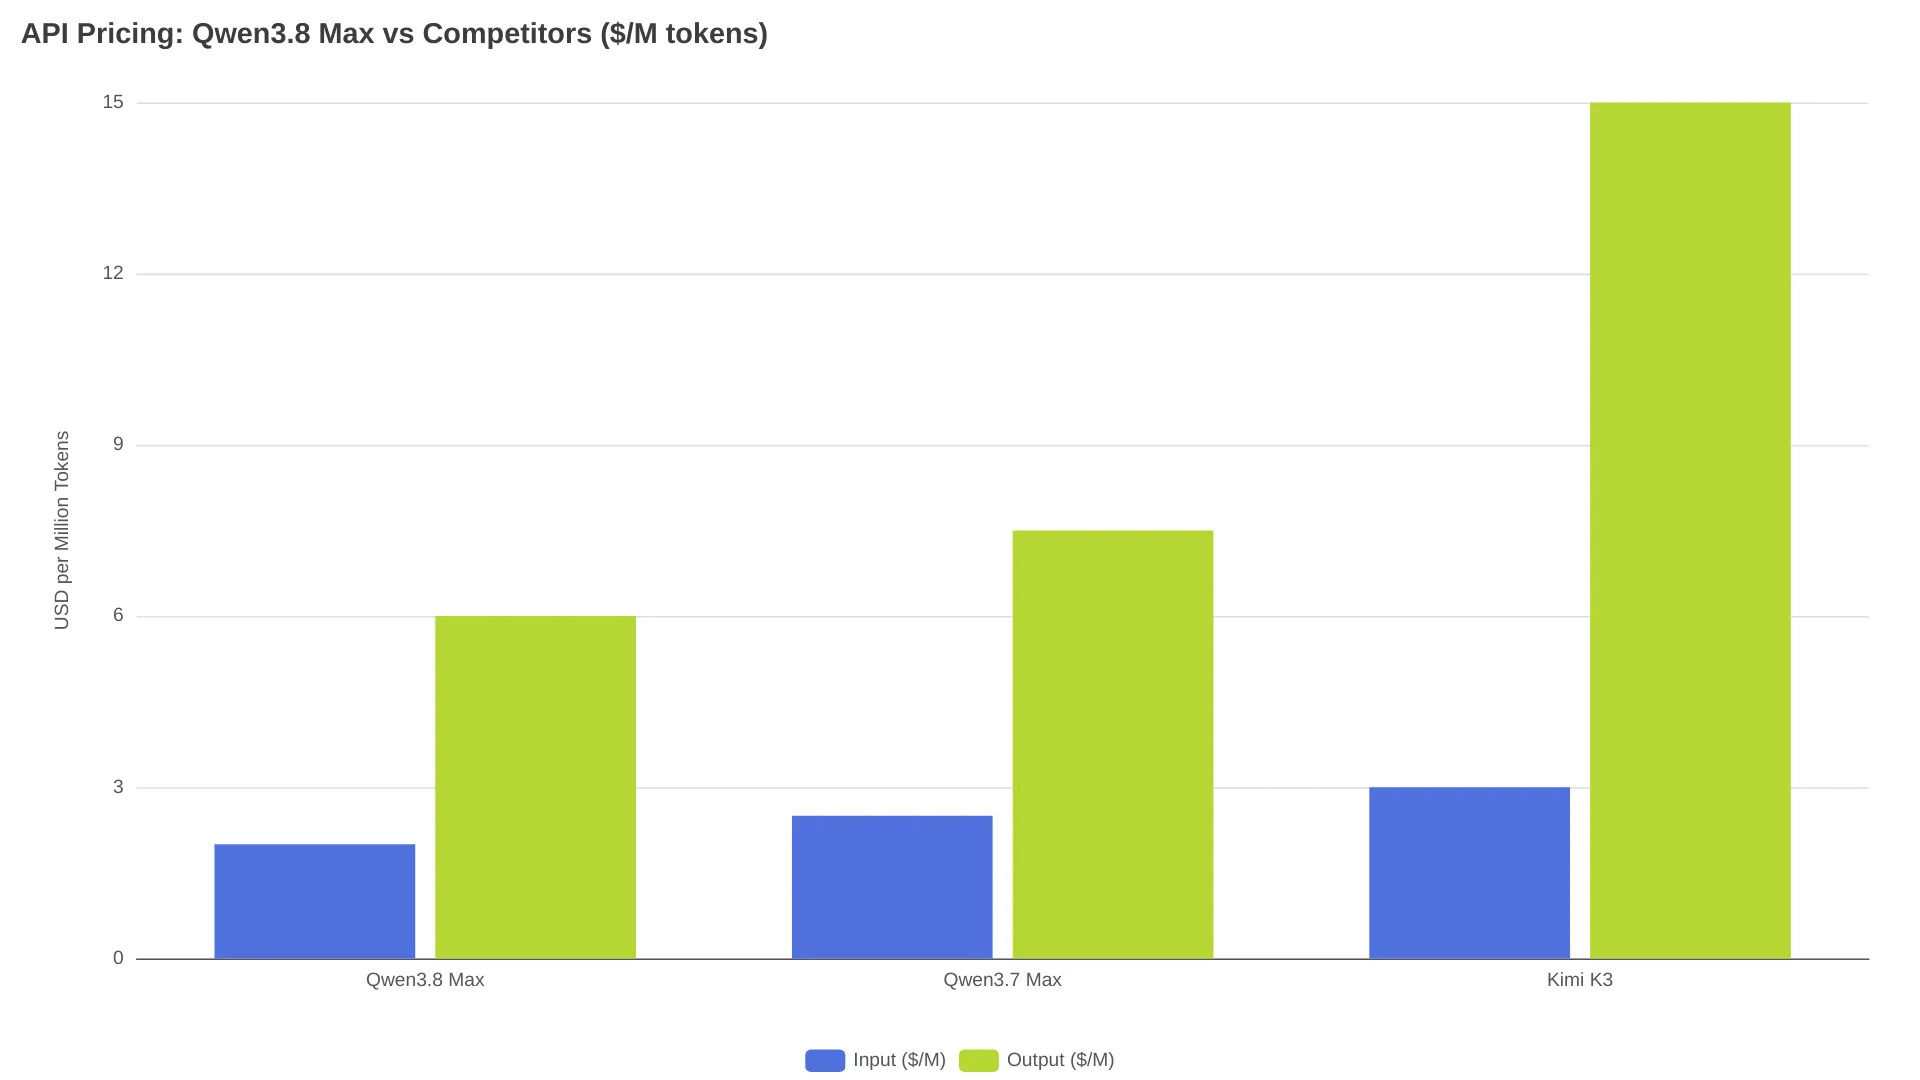
| Модель | Вход ($/M) | Выход ($/M) | Контекст |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K нативный (1.01M расширяемый) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
Помимо тарификации API по токенам, Alibaba предлагает три уровня подписки:
- Lite: $6 в месяц (~10 000 кредитов)
- Standard: $18 в месяц (~40 000 кредитов)
- Pro: $68 в месяц (~160 000 кредитов)
Endpoint Token Plan поддерживает форматы API, совместимые и с OpenAI, и с Anthropic. Поэтому Claude Code, Cursor и OpenCode работают без изменений на стороне клиента. В Qoder, продукте Alibaba для разработки, во внепиковые часы (14:00–00:00 UTC) действуют промоставки кредитов от 0,01x стандартной цены. Впрочем, это скидки к запуску, а не постоянный прайс.
У подписочной модели есть неприятная особенность. Режим рассуждений Qwen3.8 Max многословен, и сообщения сообщества о быстром расходе квоты выглядят вполне согласованно:
«Qwen склонна ОЧЕНЬ много думать». — u/darko, r/Qwen_AI
В той же ветке Reddit один подписчик Lite сообщил, что израсходовал недельный лимит менее чем за два дня, обработав примерно 50 млн токенов. Пользователь тарифа Pro рассказал о расходе 500 млн токенов за один день при работе семи параллельных агентов и 94% попаданий в кеш. Параметр reasoning_effort, для которого доступны значения low, medium и xhigh, напрямую регулирует объём генерируемых моделью рассуждений — а значит, и скорость исчезновения кредитов. В тесте одного пользователя значение low сократило время размышления примерно до 10 секунд на запрос.
Подробный разбор расходов читайте в нашем гайде по ценам API Qwen3.8 Max.
Бенчмарки Qwen3.8 Max: сильные стороны и отставание
Alibaba опубликовала результаты Qwen3.8 Max в сравнении с Fable 5 и GPT-5.6 Sol. Картина неоднозначная, а разрыв между результатами поставщика и независимыми замерами достаточно велик, чтобы его учитывать.
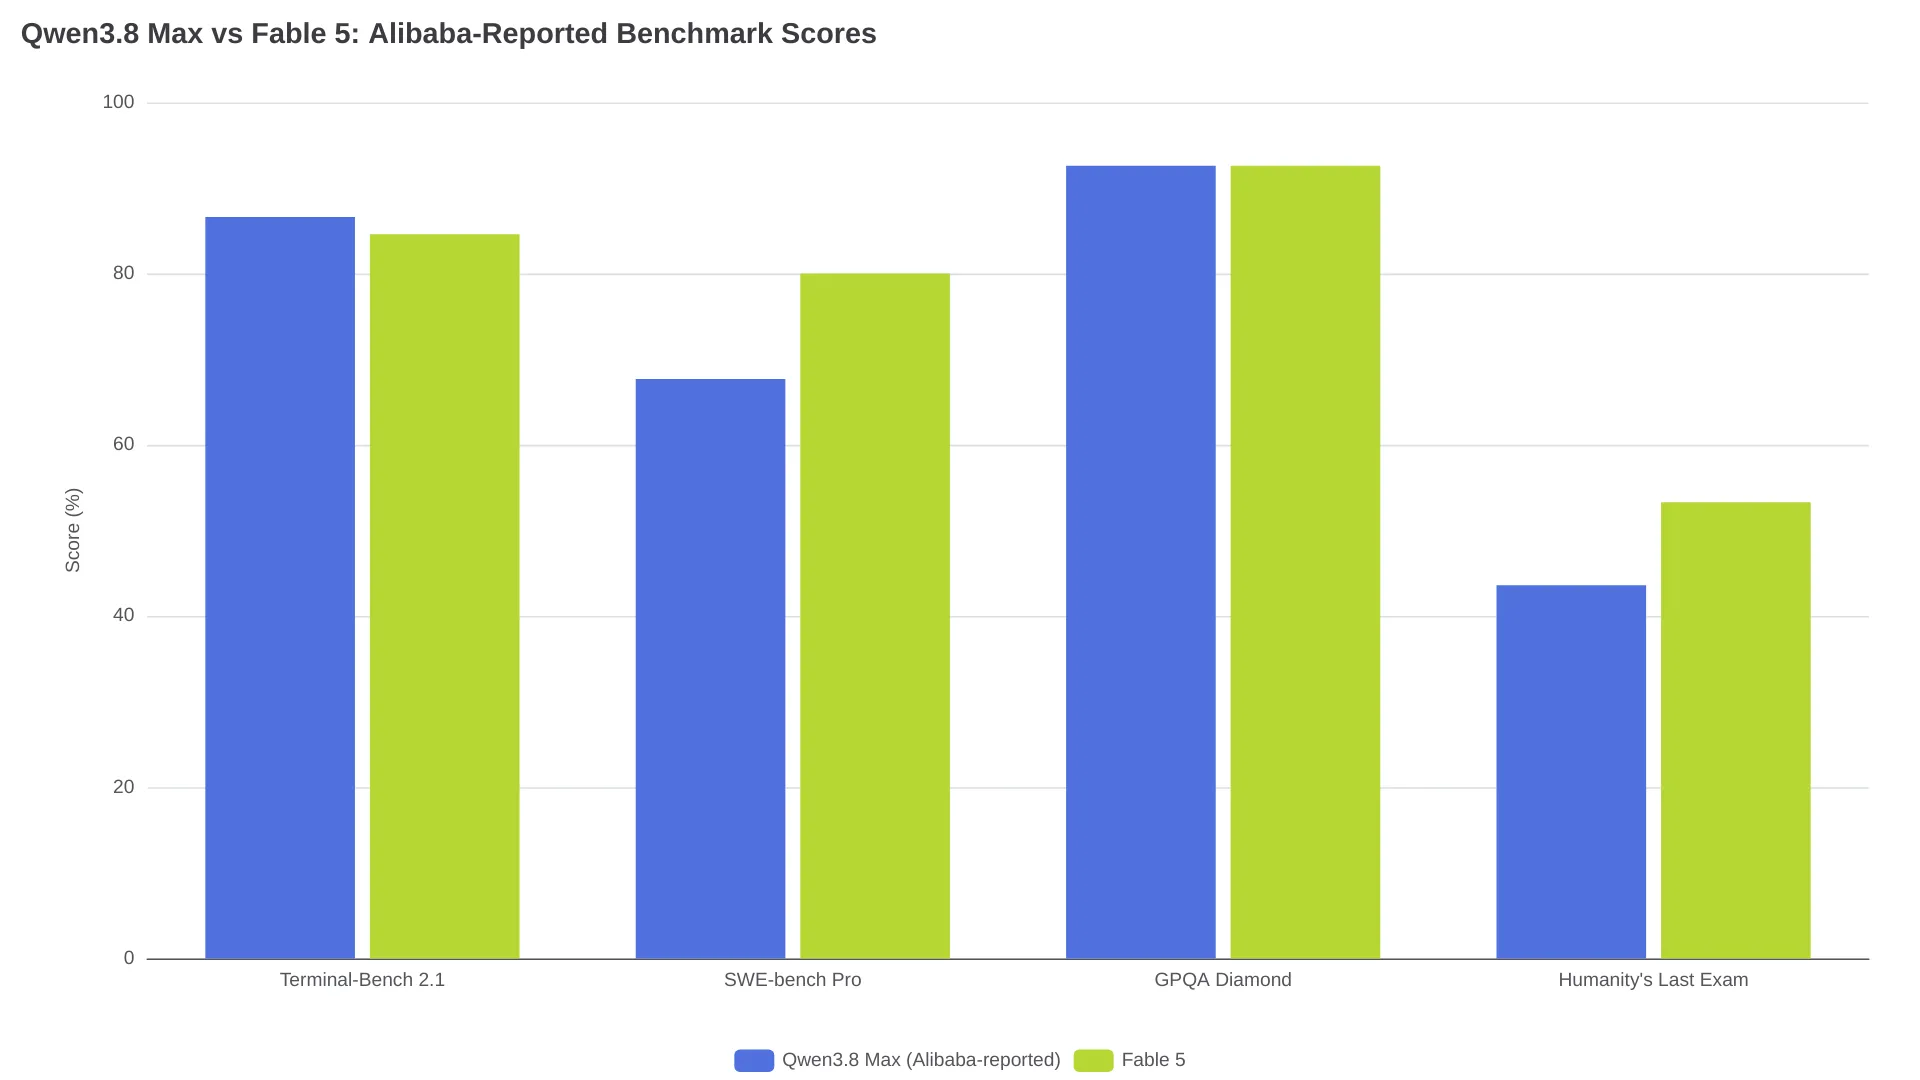
| Бенчмарк | Qwen3.8 Max (Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Выше Qwen (точный результат не опубликован) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Выше Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | Не опубликован |
Независимые измерения дают другую картину. Artificial Analysis получил для Qwen3.8 Max 81,3% в Terminal-Bench 2.1 — на 5,3 пункта ниже заявленных Alibaba 86,6%. С таким независимым результатом Qwen занимает примерно десятое место в общем зачёте, уступая Fable 5 (84,6%) и Kimi K3 (85,0%).
Тем не менее у Qwen3.8 Max есть заметные преимущества. В SWE-bench Pro её 67,7% опережают 64,6% у GPT-5.6 Sol, а мультимодальные результаты сильные: MathVision — 95,2 против 92,7 у Fable 5, LogicVista — 91,9 против 85,7. Модель также резко прибавила относительно Qwen3.7 Max в DeepSWE 1.1 — с 21,6 до 56,6, — что указывает на реальные улучшения в задачах агентной разработки ПО.
Реакция сообщества столь же противоречива. В той же ветке Reddit, где жаловались на чрезмерные размышления, был и такой отзыв:
«Но результат был просто божественным». — u/TangerineLogical9779, r/Qwen_AI
Скорость, по сообщениям пользователей, нестабильна: от 8 токенов в секунду до 60 токенов в секунду в зависимости от нагрузки и времени суток. Детальное прямое сравнение с Kimi K3 — в нашем материале Qwen3.8 Max vs Kimi K3.
FAQ
Можно ли скачать веса Qwen3.8-Max?
Да. Alibaba выпустила checkpoint Qwen3.8-2.4T-A95B на ModelScope 12 августа 2026 года. Это первая модель уровня Qwen-Max с открытыми весами. Облачная Qwen3.8-Max получила дополнительные production-возможности поверх этой базовой модели.
Под какой лицензией распространяются открытые веса?
На момент написания точная лицензия не подтверждена. Исторически наиболее вероятным выглядит Apache 2.0: Qwen3.6 выходила под этой лицензией. Однако Qwen3.7 Max осталась закрытой. Прежде чем создавать что-либо для коммерческого использования, изучите фактический файл лицензии в репозитории ModelScope.
Чем Qwen3.8-2.4T-A95B отличается от Qwen3.8-Max?
Qwen3.8-2.4T-A95B — базовая модель с открытыми весами: 2,4T параметров, 95B активных, архитектура MoE и нативный контекст 256K. Qwen3.8-Max — облачная версия Alibaba, построенная на этой модели и дополненная post-training для production-среды, включая единые системы вознаграждения и онлайн-балансировку данных. Открытые веса дают базу, API — улучшенную версию.
Можно ли запустить Qwen3.8-Max локально?
На практике — нет. В 4-битной квантизации модели нужно приблизительно 1,2 ТБ VRAM: девять или больше H200 только для весов, без запаса под кеш контекста. Даже 1,5-битная квантизация оставляет требования на уровне сотен гигабайт. Реалистичная локальная альтернатива — Qwen3.8-27B, которая помещается на одной потребительской GPU.
Сколько стоит API Qwen3.8 Max?
API Model Studio берёт $2 за миллион входных токенов и $6 за миллион выходных. Подписки начинаются от $6 в месяц за Lite и доходят до $68 в месяц за Pro. В Qoder действуют промоскидки на кредиты до 98% во внепиковые часы, но это цены запуска, и они могут измениться.