 AIREITER
Скачать 17 ГБ весов — ещё не значит получить комфортного локального агента. Qwen3.8-27B — сильная open-weight-модель под лицензией Apache-2.0, но её стандартный режим рассуждений xhigh способен превратить простую задачу в долгое ожидание. Всё упирается в подходящую квантизацию, лимит контекста и стек запуска.
Стоит ли запускать Qwen3.8-27B локально?
Qwen3.8-27B имеет смысл запускать локально разработчикам, у которых есть около 24 ГБ видеопамяти или объединённой памяти, важна локальная обработка данных и приемлема менее быстрая интерактивная работа по сравнению с хорошим облачным API. Её ключевое преимущество — не один отдельный бенчмарк, а сочетание плотной архитектуры под Apache-2.0, поддержки входных изображений и видео, нативного контекста в 262 144 токена и настраиваемого режима рассуждений при размере, подходящем для самостоятельного развёртывания. В официальной карточке Qwen указана дата релиза: 14 августа 2026 года.
Но считать её автоматической заменой любой API-модели не стоит. Официальные результаты заявлены самим поставщиком, агрессивная квантизация влияет и на качество, и на скорость, а включённый по умолчанию xhigh для многих интерактивных локальных задач — неудачная стартовая настройка.
Сначала оцените память, а не таблицы бенчмарков
Qwen3.8-27B — плотная модель: при генерации каждого токена задействуются все её параметры. Поэтому решающими становятся пропускная способность памяти, KV-кеш, квантизация и запрошенный контекст — а размер файла с весами сам по себе мало что говорит о реальной эксплуатации. В карточке Qwen заявлен нативный контекст 262K, но на локальной машине его часто приходится снижать, чтобы сохранить разумный расход памяти и скорость. В примерах запуска Qwen указан максимум 262 144 токена; это предел возможностей, а не разумное значение по умолчанию для любого потребительского ПК.
| Доступная память | Практичная отправная точка | Чего ожидать | Рекомендация |
|---|---|---|---|
| 12 ГБ | Агрессивная квантизация уровня Q3 плюс выгрузка в CPU/RAM | Короткий контекст и заметные компромиссы по задержке | Лучше выбрать модель поменьше, если цель не локальный эксперимент |
| 16 ГБ | Агрессивная Q3 либо тщательно подобранная квантизация класса Q4 | Подходит для коротких задач под контролем пользователя; контекст и скорость ограничены | Протестируйте перед переносом агентного сценария |
| 24 ГБ | Квантизация класса Q4 | Практический минимум для программирования, инструментов и умеренного контекста | Оптимальный вариант для большинства локальных пользователей Qwen3.8-27B |
| 32 ГБ+ | Квантизация более высокого качества или больший запас под контекст | Меньше компромиссов с KV-кешем и длинными сессиями | Предпочтительный уровень для постоянной агентной работы |
Это рекомендации по эксплуатации, а не официальные минимальные требования. Независимые пользователи сообщают, что RTX 3060 с 12 ГБ способна запустить локальную сборку и обрабатывать вызовы инструментов, тогда как другие предупреждают: плотный агент при таком объёме VRAM работает плохо. Именно поэтому нельзя путать «модель загрузилась» с «ею удобно пользоваться». Реальные обсуждения есть в r/LLM.
Видеокарта на 24 ГБ — это нижняя граница для комфортного 4-битного сценария, а не гарантия удобной работы с длинным контекстом. В ориентированном на развёртывание анализе суммарное потребление памяти в 4-битном режиме оценивается в 17–19 ГБ, но отдельно отмечается быстрый рост KV-кеша в длинных агентных сессиях. Анализ локального развёртывания от Neoteric полезен для планирования, но не является официальной спецификацией железа.
Почему со стандартными настройками модель может показаться непригодной
В Qwen3.8-27B рассуждения включены по умолчанию. Официальная карточка предлагает значения reasoning_effort, включая xhigh, medium и low, а для запросов без рассуждений — enable_thinking=False. Параметр preserve_thinking тоже включён по умолчанию. В разделе Qwen с рекомендациями отмечается, что снижение усилия рассуждений не всегда сокращает полное время выполнения задачи. Но для тривиальной работы высокий уровень всё равно слишком дорог в качестве настройки по умолчанию.
Разницу хорошо показывает локальный тест Саймона Уиллисона. В LM Studio с Q4_K_M-сборкой первая задача на SVG при стандартных настройках израсходовала 22 276 токенов рассуждений и выполнялась 21 минуту; после отключения рассуждений другой результат был получен за 137 секунд. Его конфигурация не является универсальным бенчмарком, но наглядно демонстрирует риск неправильной настройки. Полный тест и транскрипты — здесь.
«Я ожидал примерно уровень 3.6 35b, только медленнее из-за сильной квантизации, но в итоге она обошла её по всем пунктам». u/AltruisticList6000, r/LocalLLaMA, о тесте Q3 на RTX 4060 Ti с 16 ГБ.
Однако хороший результат не отменяет компромиссов. В другом пользовательском отчёте упоминаются ограниченный контекст 32K и ненадёжная работа агентной сессии, а ещё один участник обсуждения советует давать модели для локального программирования чёткие и атомарные инструкции. Обсуждение рабочих сценариев — здесь.
Что официально предлагает Qwen3.8-27B
Qwen3.8-27B — плотная нативная vision-language-модель, а не MoE. В официальной карточке заявлены текстовый, графический и видео-ввод, 64 слоя, скрытая размерность 5 120, 262 144 токена нативного контекста и лицензия Apache-2.0. Там же описано расширение до 1M токенов на основе YaRN, но с прямым предупреждением: статический YaRN может ухудшить качество на коротких текстах. Приоритет стоит отдавать официальным спецификациям и рекомендациям по контексту, а не сторонним пересказам релиза.
В официальном репозитории перечислены Transformers, vLLM, SGLang, TokenSpeed, а среди локальных путей с квантизированными версиями — llama.cpp, Ollama и LM Studio. Поддержка рантайма важна, поскольку модель использует гибридную компоновку Gated DeltaNet и Gated Attention. Прежде чем искать проблему в самой модели, обновите средство запуска. В репозитории с быстрым стартом Qwen есть примеры OpenAI-совместимого сервинга.
Что показывают опубликованные бенчмарки — и чего они не доказывают
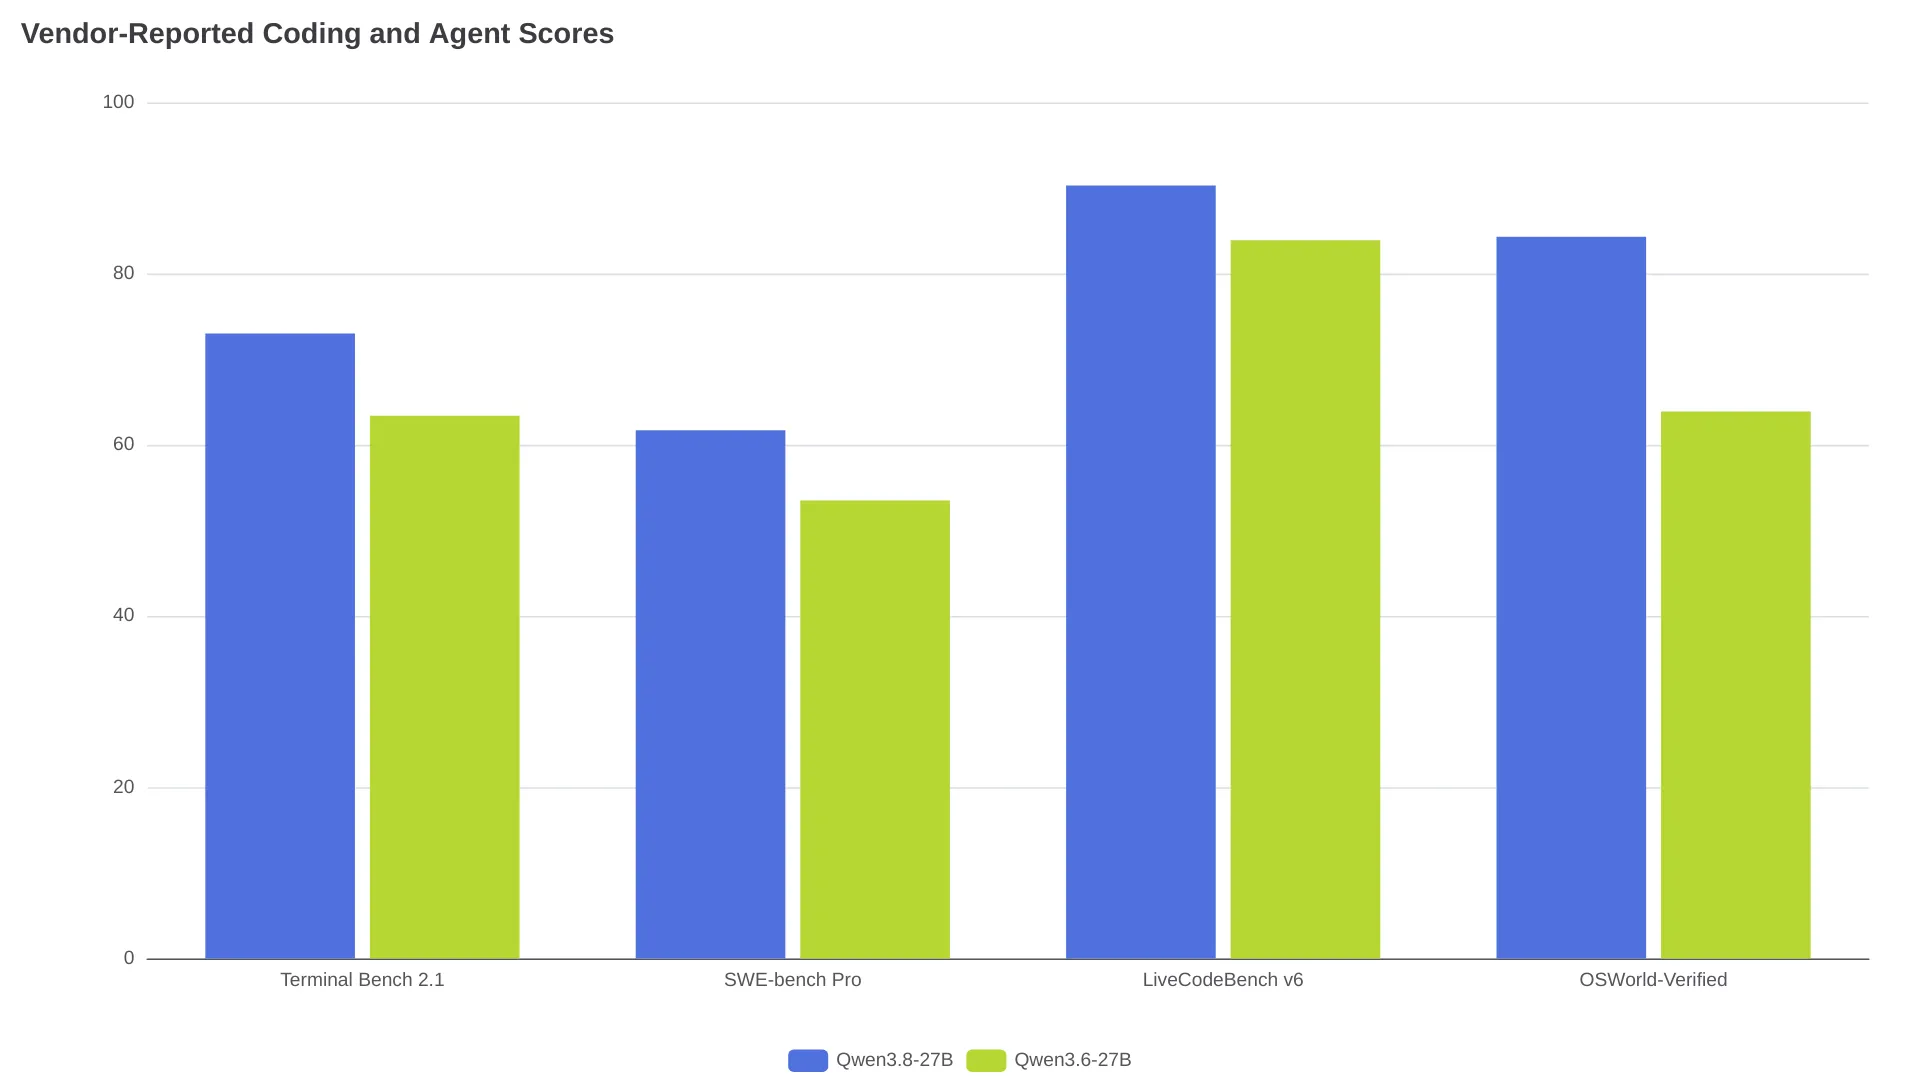
Qwen сообщает о заметном превосходстве над Qwen3.6-27B в тестах программирования и работы за компьютером. На графике приведены четыре результата из официальной карточки модели, заявленные поставщиком, а не независимо воспроизведённые показатели.
| Официальный бенчмарк | Qwen3.8-27B | Qwen3.6-27B | Как это интерпретировать |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Показатель агентного программирования в терминале |
| SWE-bench Pro | 61.7 | 53.5 | Показатель решения проблем в репозиториях |
| LiveCodeBench v6 | 90.3 | 83.9 | Показатель в задачах программирования |
| OSWorld-Verified | 84.3 | 63.9 | Показатель работы за компьютером |
Полное сравнение и методология опубликованы в карточке модели. Для SWE-bench Pro и DeepSWE 1.1 Qwen указывает использование harness Claude Code с temperature=1.0, top_p=0.95 и контекстом 256K; также приведены внутренние бенчмарки, включая QwenSWEBench. Изучите методологию перед сравнением моделей. Эти цифры подтверждают тезис о «существенном официально заявленном улучшении относительно Qwen3.6-27B», но не о «доказанной универсальной замене передового API».
Разумная первая конфигурация для локального запуска
Первое локальное развёртывание стоит настраивать на предсказуемость, а не на максимальную глубину рассуждений. Используйте актуальный рантайм, на железе класса 24 ГБ начните с квантизации Q4, намеренно ограничьте контекст и сначала прогоните короткие агентные задачи — прежде чем разрешать долгие автономные циклы.
- Поднимите OpenAI-совместимый сервер на поддерживаемом движке, например vLLM или SGLang. Qwen публикует примеры с
Qwen/Qwen3.8-27B,--reasoning-parser qwen3и--tool-call-parser qwen3_coder. Официальные команды приведены в репозитории. - Для обычной классификации, извлечения данных или быстрых правок кода задайте
enable_thinking=False. Для режима без рассуждений Qwen рекомендуетtemperature=0.7,top_p=0.80иpresence_penalty=1.5. Смотрите официальный пример API. - Для сложной отладки сначала попробуйте
lowилиmedium, а уже затемxhigh. Сравнивайте полное время выполнения и качество вызовов инструментов на реальной задаче. - Отключайте сохранение рассуждений, если задачи не связаны друг с другом. Оставляйте его только тогда, когда многоходовой контекст рассуждений оправдывает дополнительную нагрузку на KV-кеш.
- Перед работой без присмотра проверьте вызовы инструментов, соблюдение схемы вывода и переход через лимит контекста. Модель, которая хорошо пишет код по одному промпту, всё ещё может сорваться в долгом агентном цикле.
Когда Qwen3.8-27B — неудачный выбор для локального запуска
Qwen3.8-27B не стоит выбирать первой, если жёсткий лимит составляет 12 ГБ VRAM или меньше, если скорость ответа важнее локального контроля либо если агент должен работать автономно со строгим соблюдением формата. В ограниченных конфигурациях модель может запуститься, но это не означает надёжную интерактивную производительность или достаточный контекст для работы с репозиторием.
Независимое тестирование также отмечает склонность к длинным ответам, высокую хвостовую задержку и неидеальное следование строгим инструкциям. В одной структурированной оценке было зафиксировано 4 тайм-аута в 49 тестах и P95 времени ответа 143.32 секунды на конфигурации рабочей станции автора. Эти значения нельзя переносить как гарантию производительности на другие системы, но они хорошо предостерегают от использования локальной 27B-модели как компонента автоматизации без проверки результатов. В отчёте CrucibleMark приведены конфигурация и ограничения теста.
FAQ по Qwen3.8-27B
Qwen3.8-27B уже вышла официально?
Да. Официальный репозиторий Qwen указывает 14 августа 2026 года как дату выхода Qwen3.8-27B на Hugging Face Hub и ModelScope. Первичный источник — хронология релизов Qwen.
Можно ли запустить Qwen3.8-27B на GPU с 16 ГБ?
Сильно квантизированная конфигурация с коротким контекстом может работать, но это будет ограниченное развёртывание. Отчёты пользователей варьируются от обнадёживающих результатов Q3 на RTX 4060 Ti с 16 ГБ до предупреждений о серьёзных компромиссах по скорости и качеству у плотного агента с малым объёмом VRAM. Обсуждение в LocalLLaMA.
У Qwen3.8-27B есть контекстное окно на 1M токенов?
Нативный контекст модели составляет 262 144 токена. В карточке модели описан контекст 1M через масштабирование YaRN/RoPE, а также указано, что статический YaRN может снизить качество на коротких текстах. Официальная документация по контексту.
Как отключить рассуждения в Qwen3.8-27B?
Передайте enable_thinking=False в API-запросе — так показано в карточке модели Qwen. Для задач, где рассуждения нужны, начните с low или medium, а не считайте xhigh подходящим по умолчанию. Официальный пример режима без рассуждений.
Стоит ли пользователям Qwen3.6-27B обновляться?
Обновление оправдано, если имеющееся железо уже подходит для того же класса развёртывания, а рабочая нагрузка выигрывает от улучшений в программировании, работе за компьютером или мультимодальности. Оставайтесь на Qwen3.6-27B, если текущий стек стабилен, а новый рантайм, квантизация или поведение режима рассуждений ещё не проверены в реальном сценарии.
Выбирайте по ограничению, которое нельзя обойти
| Ограничение | Лучший следующий шаг |
|---|---|
| Нужна локальная обработка данных, доступно 24 ГБ | Запускайте Qwen3.8-27B в Q4, начиная с низкого уровня рассуждений или без них |
| Есть только 12–16 ГБ | Проверьте Q3-сборку для коротких задач под контролем пользователя либо выберите модель меньшего размера |
| Длинные агентные сессии с репозиториями | Закладывайте запас 32 ГБ+ и проверьте поведение KV-кеша перед внедрением |
| Нужны быстрые интерактивные ответы | Выберите облачный API или более компактную локальную модель |
| Строгий формат при автономной публикации или выполнении | Оставьте слой валидации и проверку человеком; не полагайтесь только на соблюдение инструкций моделью |
Qwen3.8-27B расширяет круг задач, за которые может взяться локально развёртываемая 27B-модель. Но инженерная часть никуда не исчезает: подбирайте квантизацию под железо, сознательно управляйте рассуждениями и оценивайте модель на репрезентативном рабочем сценарии, а не по размеру скачиваемого файла.