 AIREITER
Многонодовая задача в Modal оплачивается по полной выделенной конфигурации — отдельной подписки на кластер нет. Modal Clusters уже доступен всем пользователям, но в счёт по-прежнему попадают GPU, CPU, память, хранилище и сетевой трафик, использованные каждым контейнером.
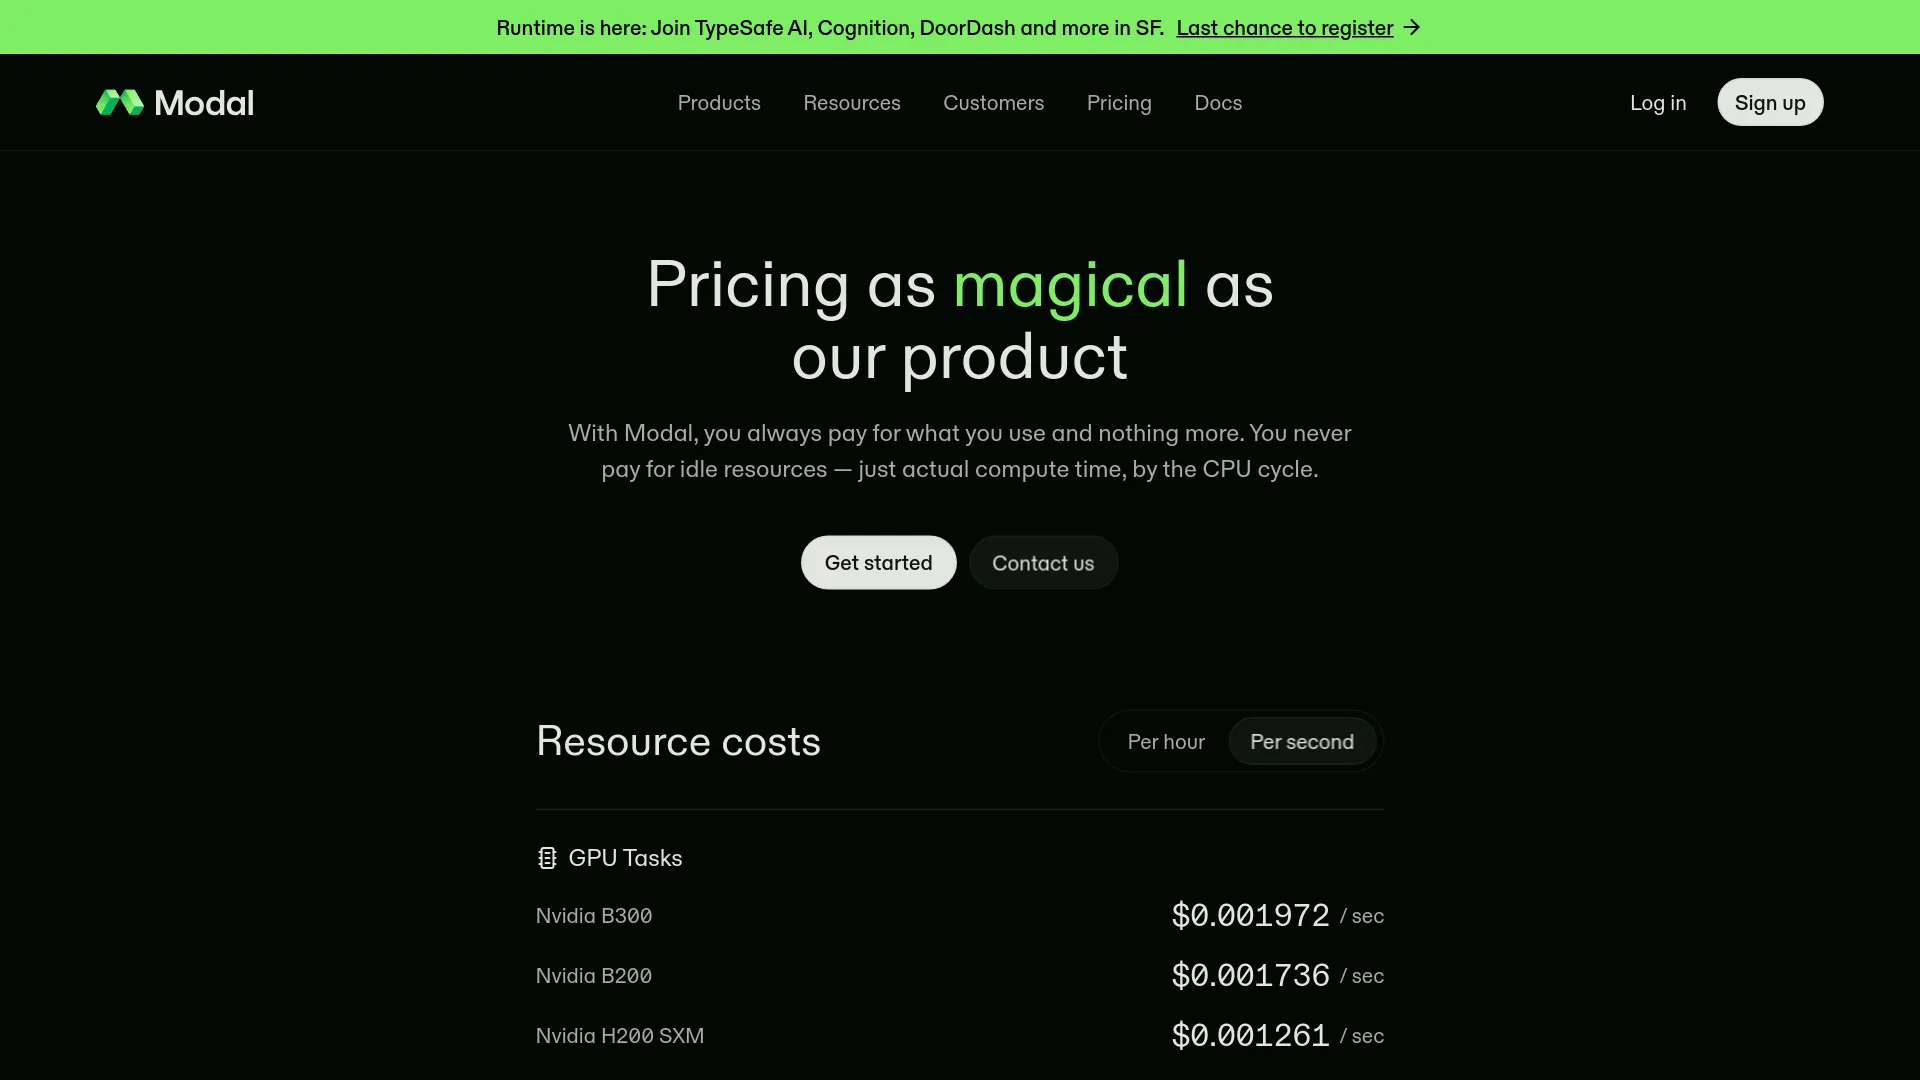
Цены Modal Clusters за минуту
На официальной странице с тарифами Modal и в объявлении о выходе из беты описана оплата по фактическому использованию, а также точка входа @modal.clustered для совместного запуска нескольких контейнеров. Опциональный RDMA меняет способ обмена данными, но не саму базовую формулу расчёта.
Количество GPU × секунды работы GPU × тариф GPU + секунды CPU + GiB-секунды памяти + хранилище + применимый исходящий трафик
Это важно, потому что кластер умножает полную конфигурацию узлов. Если задача запрашивает четыре узла с восемью H100 на каждом, тарификация идёт за 32 H100, а не за одного координатора с «бесплатными» воркерами.
Что Modal Clusters добавляет к тарифам
После релиза Modal Clusters в статусе GA 1 октября 2026 года многонодовый запуск стал управляемым примитивом платформы. Параметр size задаёт количество контейнеров, а rdma=True включает высокоскоростной канал связи там, где он поддерживается (анонс Modal).
В документации описано групповое планирование: Modal пытается разместить всю запрошенную группу целиком, вместо того чтобы запустить неполную задачу, которая всё равно не сможет продвигаться. Такой режим подходит для распределённого обучения, дообучения моделей, модельно-параллельного инференса, а также архитектур prefill/decode, где GPU должны обмениваться данными синхронно.
В документации по кластерам указаны и практические ограничения: GPU выделяются целыми узлами, кластеры только на CPU не поддерживаются, а сбой или вытеснение одного контейнера может завершить весь clustered call. Возвращается только вывод rank 0, поэтому для долгих задач чекпоинты нужно сохранять за пределами контейнера.
Тарифы на GPU, из которых складывается счёт Modal Clusters
Приведённые ниже публичные тарифы — удобная отправная точка для оценки. Почасовые значения рассчитаны из посекундных цен и не включают CPU, память, хранилище и возможные региональные коэффициенты.
| GPU | За секунду | Примерно за GPU-час |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Кроме того, Modal указывает цену CPU $0.0000131 за секунду работы физического ядра и $0.00000222 за GiB-секунду памяти. Том стоит $0.09 за GiB в месяц, при этом первые 1 TiB не тарифицируются. Исходящий сетевой трафик стоит $0.04 за GiB сверх включённого лимита. Перед запуском крупной задачи проверьте актуальные значения в официальной тарифной таблице.
Пример расчёта: четыре узла с восемью H100
Представим задачу распределённого обучения с параметрами size=4 и H100:8 на каждом узле.
- Четыре узла × восемь GPU = 32 GPU H100.
- 32 × $3.95 в час = примерно $126.40 в час только за GPU.
- $126.40 — это минимальная оценка исключительно GPU-затрат; CPU, память, хранилище и исходящий трафик оплачиваются отдельно.
Именно с этой цифрой стоит сравнивать резервируемую или выделенную инфраструктуру. Преимущество serverless в том, что кластер можно уменьшить после пикового запуска; это не делает полностью загруженный кластер дешёвым.
Ограничения тарифа могут оказаться важнее цены GPU
Статус GA не означает неограниченную доступность. В опубликованных тарифах рабочих пространств Modal есть лимиты параллелизма и платформенные ограничения, из-за которых крупный кластер может не запуститься ещё до того, как стоимость станет главным вопросом.
| Тариф | Плата за платформу | Включённый кредит на вычисления | Опубликованный лимит параллельных GPU |
|---|---|---|---|
| Starter | $0/month | $30/month | 10 GPU |
| Team | $250/month | $100/month | 50 GPU |
| Enterprise | Custom | Custom | Custom / higher limits |
Эксперимент с 32 H100 уже требует 32 GPU, поэтому тариф Starter не подходит для приведённого примера при лимите параллелизма в 10 GPU. Team формально позволяет разместить такое количество GPU, но на планирование всё равно влияют фактическая доступность, выбор региона и запрошенное оборудование.
Не путайте кредит Starter в $30 с 30 бесплатными GPU-часами. По указанному тарифу H100 это примерно 7.6 GPU-часа H100 — ещё до учёта остальных ресурсов задачи.
Когда Modal Clusters действительно выгоден
Modal Clusters особенно полезен для крупных, нерегулярных задач, которые слишком неудобно постоянно держать развёрнутыми. Обучение, которое занимает несколько часов и затем полностью останавливается, выигрывает от масштабирования до нуля сильнее, чем кластер, работающий непрерывно неделями.
Выбирайте его для:
- Распределённого дообучения, где все узлы должны стартовать одновременно.
- Коротких обучающих запусков на дорогих GPU.
- Многонодового инференса, которому нужны RDMA или модельный параллелизм.
- Python-команд, которым иначе пришлось бы самостоятельно администрировать Kubernetes, SLURM или настраивать RDMA.
Обычная функция Modal лучше подходит, если модель помещается на одной машине. Выделенную или резервируемую инфраструктуру стоит внимательно сравнить, когда загрузка предсказуема, рабочей нагрузке нужен фиксированный SLA или главная цель — минимальная стоимость GPU-часа при постоянной эксплуатации.
Полезную границу проводит и обсуждение реального пользователя. В треде о компьютерном зрении u/Substantial_Camel735 рекомендовал оставить векторный поиск на VPS, а не запускать эту часть на воркерах Modal (обсуждение на Reddit). Это мнение одного практика о конкретной архитектуре, а не общеотраслевой бенчмарк платформы.
«Мы собираемся отказаться от modal, но сама архитектура звучит разумно. Я бы не стал выполнять поиск на воркерах modal — лучше оставить его на VPS и обращаться оттуда к своей векторной БД». — u/Substantial_Camel735, r/computervision
Что проверить перед крупным запуском
- Умножьте полную конфигурацию. Проверьте расчёт
size × GPUs per node, а затем сравните итоговое число с лимитом параллелизма рабочего пространства. - Начните с минимального осмысленного кластера. Тест на двух узлах поможет обнаружить проблемы с образом, NCCL, rank и rendezvous ещё до запуска на 32 GPU, который многократно увеличит счёт.
- Отделите отладку приложения от проверки RDMA. Если рабочая нагрузка позволяет, сначала проверьте распределённую задачу без RDMA, затем включите
rdma=Trueи измерьте участок, чувствительный к скорости обмена данными. - Сохраняйте чекпоинты в надёжное хранилище. Сбой или вытеснение одного rank может завершить весь call; повторный запуск без чекпоинта способен повторить всю дорогую операцию.
- Заложите бюджет на CPU, память и исходящий трафик. Расчёт GPU — лишь первая строка счёта, особенно если датасеты или результаты пересекают границы регионов.
- Решите, нужна ли фиксация региона. Ограничение места размещения может изменить доступный пул ресурсов и ценовой коэффициент. Рассматривайте локальность как измеряемое требование и сверяйте её с актуальной документацией по региональным ценам.
Сам RDMA не указан как отдельная платная услуга в официальных тарифах Modal. Его ценность — в производительности: синхронное обучение и передача больших KV-кэшей могут упираться в сеть при использовании обычного TCP. Компромисс в том, что оборудование с поддержкой RDMA и доступные варианты размещения могут быть ограничены.
FAQ по Modal Clusters
Есть ли отдельная плата за API Modal Clusters?
Отдельная надбавка за кластер не публикуется. Modal тарифицирует ресурсы, использованные каждым контейнером: GPU, CPU, память, хранилище и применимый сетевой трафик.
Каков максимальный размер кластера?
В материалах GA указаны публичные кластеры размером до 32 узлов или 256 GPU; более крупные требования обсуждаются с Modal (анонс GA). При этом продолжают действовать лимиты параллелизма рабочего пространства и фактическая доступность ресурсов.
Можно ли запускать инференс в Modal Clusters?
Да, если рабочая нагрузка соответствует модели выполнения кластеров. Многонодовый или модельно-параллельный инференс — более подходящий сценарий, чем обычный HTTP-эндпоинт; у кластерных web-функций есть ограничения, в том числе весь трафик поступает на rank 0 (документация по кластерам).
Практический выбор
| Ваша рабочая нагрузка | С чего начать |
|---|---|
| Модель помещается на одном GPU или узле | Обычная функция Modal |
| Короткий синхронный многонодовый запуск обучения | Modal Clusters после небольшого теста |
| Долгая работа с предсказуемой полной загрузкой | Сравнить выделенные или резервируемые GPU |
| Поиск или работа с базой данных рядом с GPU-инференсом | Оставить сервис данных отдельно, если только измерения не оправдывают совместное размещение |
| Жёсткие требования к приватной сети или самостоятельному размещению | Рассмотреть другую модель развёртывания |
Modal Clusters упрощает старт многонодовой оркестрации GPU, но по определению не делает её дешевле. Бессерверное размещение и удобство Python могут сэкономить время инженеров, однако при постоянной загрузке основную часть счёта способны сформировать региональные ограничения и повторные запуски всего кластера. Сначала посчитайте общее количество узлов, а уже затем сравнивайте плату за удобство с выделенной инфраструктурой.