 AIREITER
Одной строки вроде «кинематографичное видео» MiniMax H3 недостаточно: модель сама заполняет пробелы, и без указаний по камере легко получить неподвижный кадр, а пропущенные параметры звука могут добавить нежелательную речь. Рабочий промпт для MiniMax H3 больше похож на короткий съёмочный сценарий. В официальной документации задан фиксированный формат из трёх полей, таймкоды сцен, стабильные ID говорящих и два отдельных поля для звука. При этом весь сценарий должен уложиться примерно в 7 000 символов (зависит от провайдера), а длительность ролика ограничена 15 секундами.
Два руководства и четыре режима: сначала выберите формат промпта H3
В репозитории MiniMax-H3 на Hugging Face опубликованы два отдельных руководства по написанию промптов, и предназначены они для разных сценариев. Базовое руководство описывает четыре задачи генерации без загруженных референсов. Руководство по референсам используется, если в работе участвует загруженное изображение, видео или аудиофайл. Четырём базовым задачам соответствуют такие режимы:
| Режим | Входные данные | Обязательная инструкция согласования в промпте |
|---|---|---|
| T2VA | Только текст | Не требуется; сразу начинайте с основных полей |
| I2VA | Одно изображение первого кадра | «Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]» |
| FL2VA | Первый и последний кадры | Picture 1 в 0.00 секунды, Picture 2 — точно в момент окончания ролика |
| L2VA | Одно изображение последнего кадра | Picture 1 соответствует времени окончания видео и финальной сцене |
Оба руководства заканчиваются подробными примерами. В публикации о запуске MiniMax модель описывается так же: пользователь задаёт связи между текстовыми, графическими, видео- и аудиовходами, а не выбирает задачу из меню. Хостинговые API сводят это к трём рабочим процессам — minimax/h3/text-to-video, image-to-video и reference-to-video на fal, — но внутренняя структура промпта остаётся той же.
Базовый промпт: разбираем по строкам
В базовом режиме после инструкции согласования идут ровно три обязательных поля, разделённых пустой строкой. Каркас выглядит так:
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_descriptionсодержит временную линию: визуальный стиль, композицию, действия, смену планов, говорящих, диалоги и внутрикадровые звуки — всё, что зритель видит или слышит.overall_soundscapeописывает атмосферу и физические звуки в одном абзаце из 1–4 предложений, без диалогов.non_diegetic_musicотвечает за музыку для зрителя, которую персонажи не слышат. Описание занимает 1–3 предложения; если музыки нет, укажитеN/A.
Ниже — заполненный пример, адаптированный из официального T2VA-примера с пекарней до рассвета:
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
Вот за что отвечает каждая строка согласно официальным правилам:
| Элемент промпта | За что отвечает | Правило |
|---|---|---|
[Shot 1] Live-action, cinematic. | Общий стиль | Метка стиля открывает Shot 1; среди примеров из руководства: Cinematic, live-action, 2D-animated, 3D CG, claymation, watercolor, vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | Идентичность говорящего | Сначала указываются признаки персонажа, затем его ID; ID должен оставаться неизменным в разных сценах |
The camera pushes in with small amplitude at slow speed | Камера | Тип движения, амплитуда и скорость описываются как естественное действие |
<d>[English] First batch of the day.</d> | Диалог | Тег языка и только точный текст реплики — без перевода |
At 00:05.000, the camera cuts to... | Момент склейки | Таймкоды должны идти строго по возрастанию; у самого [Shot 1] таймкод не ставится |
<scenetrans> continuing seamlessly across the cut | Непрерывность звука | Так отмечается реплика, которая продолжается через монтажный переход; тег ставится в обеих точках соединения |
Сцены, склейки и движения камеры
Синтаксис сцен в MiniMax H3 зависит от позиции. Для [Shot 1] таймкод не указывается, а каждая следующая сцена начинается со строго возрастающего времени склейки, например At 00:03.500,. Для переходов используйте короткие формулировки вроде «the camera cuts to», «the shot transitions to» или «the shot switches to». Наплывы, затемнения и шторки нужно указывать отдельно, если именно их вы хотите получить. Если меняется лишь кадрирование, лучше описать движение камеры, а не ставить склейку: монтажный переход должен добавлять новый объект, пространство, состояние или временной момент.
Движение камеры описывайте естественной фразой, используя до трёх параметров: тип движения, амплитуду и скорость.
| Параметр | Допустимые варианты |
|---|---|
| Тип движения | Zoom In/Out, Push In/Pull Out, Pan Left/Right, Truck Left/Right, Tilt Up/Down, Pedestal Up/Down, Arc Shot, Tracking Shot, Static Shot, Shake Slightly/Strongly, POV, Roll Clockwise/Counterclockwise |
| Амплитуда | «with small amplitude», «with large amplitude» |
| Скорость | «at slow speed», «at fast speed» |
Среднюю амплитуду и обычную скорость принято не указывать. Важно различать два похожих действия: «Zoom In» меняет фокусное расстояние с фиксированной позиции, а «Push In» означает физическое движение камеры вперёд. Руководство намеренно сохраняет эту разницу.
Диалоги и метки говорящих
Каждому персонажу, который говорит, назначается стабильный ID — (S1), (S2) или составной (S1,S2) для синхронной реплики. В следующих сценах этот ID не меняется. Молчащие персонажи ID не получают. При первом появлении говорящего нужно задать достаточно признаков для стабильной генерации: находится ли он в кадре, примерный возраст, пол, высоту и тембр голоса, темп речи и акцент.
Точный синтаксис одной реплики:
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
Четыре правила помогают избежать типичных ошибок. Идентичность, действие и манера произнесения остаются за пределами <d>; внутри тега должны быть только обозначение языка и точные слова реплики с сохранённой пунктуацией. Для закадрового голоса используется буквальная фраза «says in an off-screen voiceover», после которой нужно сразу уточнить, что губы персонажа в кадре остаются закрытыми. Если реплика переходит через склейку, в обеих точках ставится <scenetrans> и добавляется фраза вроде «continues seamlessly across the cut» или «carries over from the previous shot». Если речь обрывается вместе с окончанием ролика, используется <cutoff>.
Кавычки имеют только одну служебную функцию: ими выделяется текст, который виден в кадре — баннеры, вывески, этикетки, неоновые надписи и субтитры. Такой текст пишется в английских двойных кавычках и дословно, без перевода. Если заключить в кавычки обычную реплику, H3, согласно документации, может вывести её как встроенные субтитры, а не произнести.
Два поля для звука
В публикации MiniMax о запуске сказано, что весь аудиовыход H3 — нативное стерео, генерируемое вместе с видео. Поэтому звук вынесен в два специальных поля, а не задаётся случайными прилагательными в описании. overall_soundscape отвечает за атмосферу и физические звуки — ветер, дождь, транспорт, шаги, движение ткани, удары, дыхание и смех. Описание должно занимать 1–4 предложения, а значение N/A используется только при явном запросе на полную тишину. В non_diegetic_music описывается музыка, которую персонажи не слышат: инструменты, темп, ритм и изменения динамики. Абстрактные слова вроде «эпичная» или «эмоциональная» документация не рекомендует; если музыка не нужна, правильное значение — N/A.
Внутрикадровые звуки — например, пение, радио в сцене или уличный музыкант — не относятся ни к одному из этих полей. Их нужно описывать в integrated_multimodal_description, где задаётся временная линия. Такое разделение не формальность: в руководстве APIMODELS отмечается, что для стабильного результата звуковые ограничения нужно задавать явно, а пропущенное поле non_diegetic_music может привести к появлению незапрошенной музыки.
Промпты с референсами: метки и сохранение признаков
Руководство по референсам применяется, когда генерацию направляют загруженные материалы. В нём требуется шесть разделов в фиксированном порядке: subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape, non_diegetic_music. Для задач генерации раздел detailed_description обычно занимает 350–500 английских слов. В промптах с большим количеством диалогов важнее вместить всю произносимую временную линию, даже если из-за этого придётся отступить от указанного объёма.
Основную работу выполняют четыре типа меток:
| Метка | Назначение |
|---|---|
<Subject N> | Видимое содержимое, которое действительно должно попасть в результат: человек, продукт, сцена, одежда, стиль или действие, выделенные из любого референса |
<Picture N> | Изображение, выступающее конкретной опорой для кадра: первый кадр, ключевой кадр, последний кадр или композиционный ориентир |
<Video N> | Связь со всем видео: источник для монтажа, точка продолжения, структура камеры или склеек, ритм |
<Audio N> | Аудиосигнал, который копируется или используется как референс: тембр голоса, слова песни, биты и звуковые эффекты |
Нумерация у каждого типа независимая: загруженное видео может быть <Video 1>, а его аудиодорожка — <Audio 2>. Говорящий субъект объединяет метку с ID диктора: <Subject 3> (S1).
Раздел summary начинается с префикса задачи в квадратных скобках, например [reference generation] или [video editing + audio reuse]. Промпт для монтажа видео должен начинаться фразой «The target video is an edited version of <Video 1>.» Затем в retention_analysis для каждой метки указывается один маркер. Для визуальных элементов это fully_preserved, partially_preserved, attribute_transfer или weak_reference; для аудио — fully_copy, partially_copy, reference или weak_reference. Так H3 понимает, что лицо нужно сохранить, а одежду можно изменить.
Минимальный каркас режима с референсами в документированном порядке:
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
Если H3 ошибается: проблема и решение
| Симптом | Вероятная причина в промпте | Что исправить |
|---|---|---|
| Тарабарщина или выдуманный «язык симов» | Неструктурированный диалог, отсутствие ID говорящих или неописанные молчащие персонажи | Добавьте ID (S1)/(S2), оберните точные реплики в <d>[Language] ...</d> и явно укажите, что молчащие персонажи не говорят |
| Диалог превращается во встроенные субтитры | Произнесённые слова заключены в кавычки | Оставьте кавычки только для видимого текста в кадре, а диалог перенесите в теги <d> |
| Реплика достаётся не тому персонажу | ID говорящего не связан с описанным человеком | При первом появлении задайте признаки говорящего — возраст, положение в кадре и характеристики голоса — и сохраняйте ID во всех сценах |
| Появляется незапрошенная музыка | non_diegetic_music пропущено или описано слишком расплывчато | Если музыка не нужна, укажите non_diegetic_music: N/A: именно это исправление чаще всего рекомендуют в обсуждениях |
| Возникают незапланированные склейки | Смена сцены подразумевает монтажный переход, но таймкод не указан | Используйте [Shot N] At 00:03.500 с явной формулировкой склейки; для одного дубля отдельно напишите «no cuts» |
| Плывут лицо, одежда или продукт | Роль референса не определена | Добавьте в retention_analysis строку с fully_preserved для нужной метки и повторяйте эту метку при каждом появлении объекта |
Проблемы с тарабарщиной и субтитрами описаны непосредственно в официальных правилах синтаксиса. Участники r/StableDiffusion независимо подтверждают, что эти решения работают на практике. В частности, non_diegetic_music: N/A называют одним из самых эффективных способов убрать нежелательный звук.
Ограничения и стоимость тестирования промптов
Лимиты генерации важны по двум причинам: длина промпта конечна, а каждая попытка стоит денег. Ниже — документированные ограничения официального API и хостинговых провайдеров:
| Параметр | Значение | Примечание |
|---|---|---|
| Длительность ролика | До 15 с, целые секунды | На эндпоинтах fal/EvoLink минимум составляет 5 с; в некоторых документах V2 API указано 4 с |
| Разрешение | 768p и 2K, 24 FPS | Согласно MiniMax, разрешение 2K используется по умолчанию |
| Референсные файлы | До 9 изображений, 3 видео и 3 аудиофайлов | Всего 12 файлов; аудио не может быть единственным референсом |
| Длина промпта | ~7 000 символов | Так указано в документации fal и V2 API; APIMODELS приводит значение 20 480 — проверяйте лимит у своего провайдера |
| Соотношение сторон | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptive | В режиме image-to-video используется соотношение сторон исходного изображения |
Цены зависят от провайдера, поэтому воспринимайте их как зафиксированные на определённую дату значения, а не как постоянный прайс-лист. На fal генерация в 2K стоила $0.26 за секунду по состоянию на снимок цен от 1 августа ($1.30 за 5 секунд и $3.90 за 15 секунд). Первые пять референсных изображений включены в стоимость, каждое дополнительное стоит $0.08. На APIMODELS H3 стоит $0.088 за секунду ($1.32 за ролик длительностью 15 секунд), при этом оплачиваются только успешные запросы. Для сравнения — цены за секунду на той же площадке:
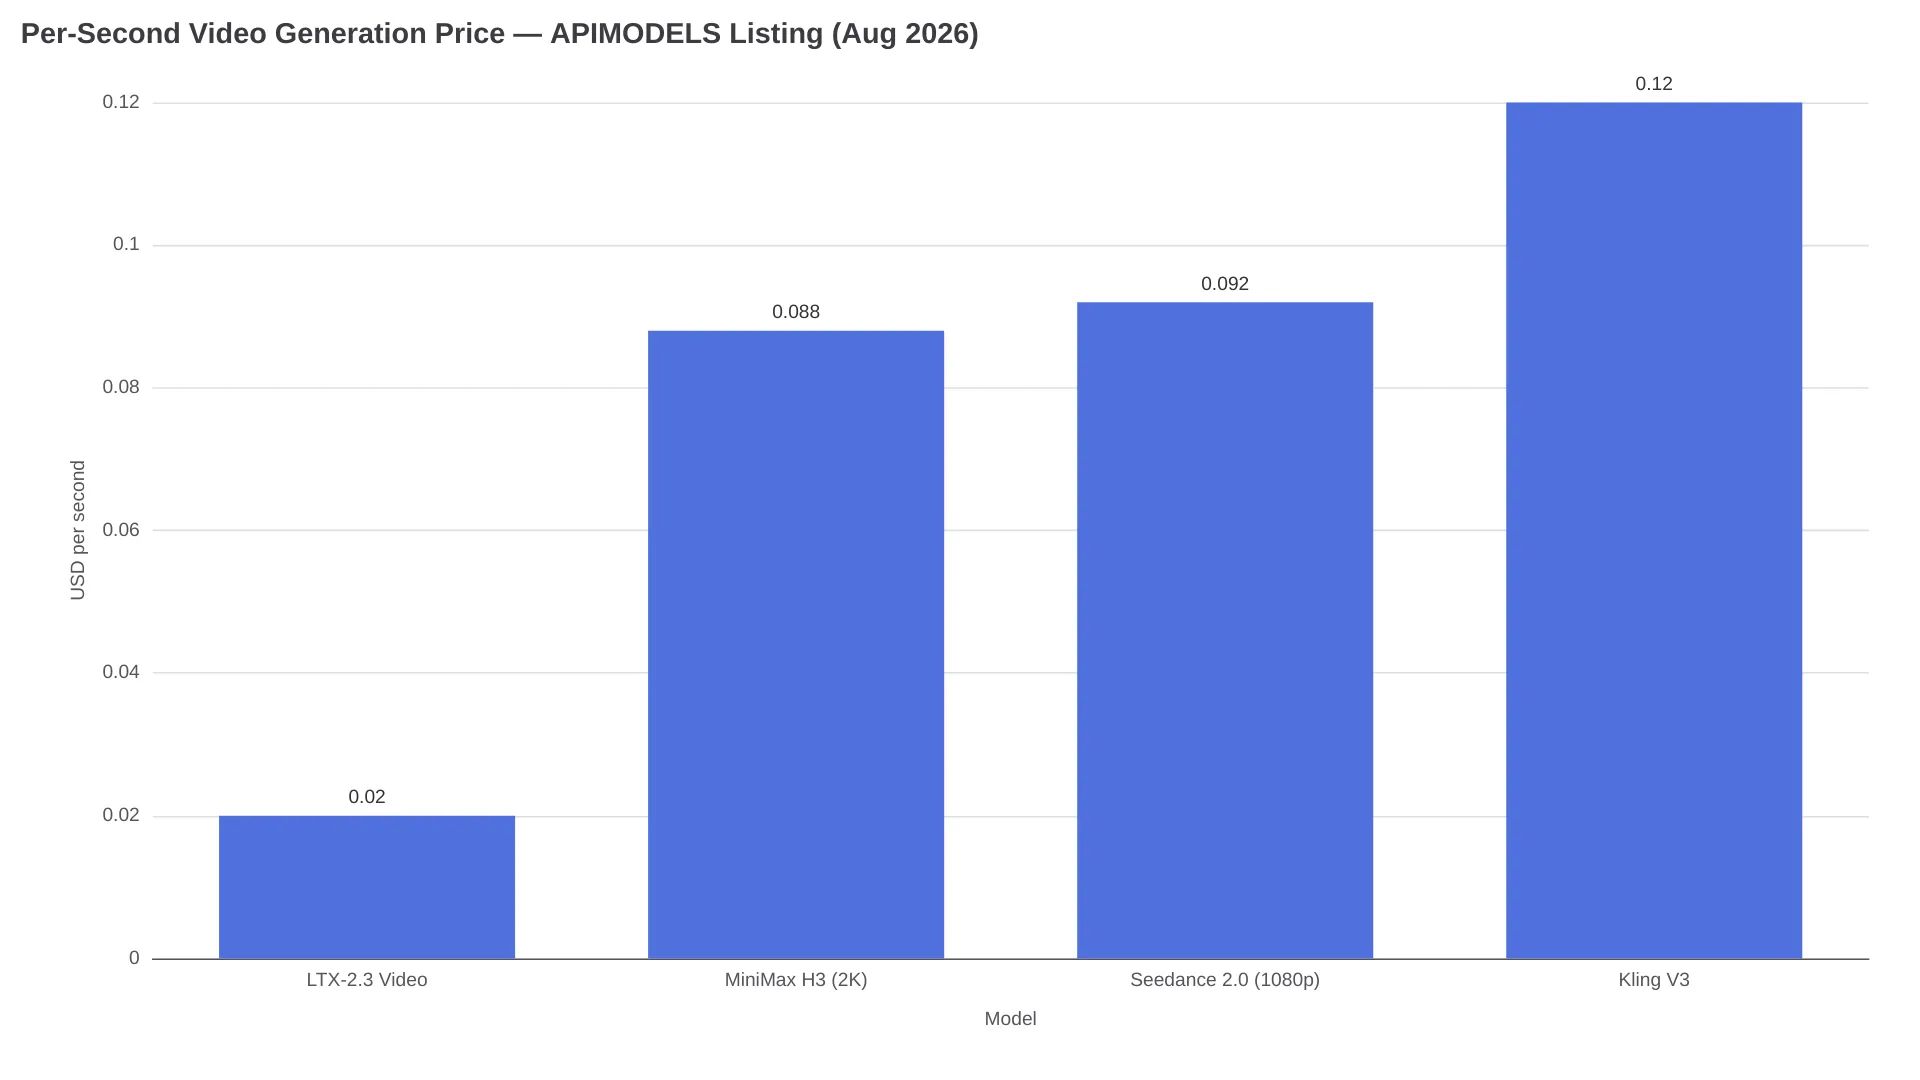
Но настоящий расход определяется количеством повторных попыток. Структурированный диалоговый промпт на 15 секунд, сработавший со второго раза, обойдётся на APIMODELS в $2.64. Неструктурированный промпт, которому понадобилось пять попыток для получения одного пригодного дубля, — уже в $6.60. Для итеративного тестирования промптов через хостинговый эндпоинт H3 можно использовать страницу AIReiter с API MiniMax H3, где указана актуальная цена.
Готовые каркасы для копирования
Для большинства коротких роликов достаточно двух базовых заготовок. Подставляйте значения в квадратных скобках, а названия полей и пустые строки оставляйте без изменений:
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/AЕсли нужны не заготовки, а проверенные примеры, пригодятся три библиотеки с исходными ссылками. ecomimagelab/awesome-minimax-h3-prompts: 58 промптов — 39 официальных и 19 протестированных сообществом. Каждый сопровождается видео результата, поскольку действует правило «No video, no entry». В imagineVid/Awesome-minimax-h3-prompts-and-skills собрано 28 проверенных примеров в шести рабочих сценариях — от сохранения идентичности через omni-reference до диалогов с нативным аудио. В галерее APIMODELS доступно 226 промптов с видео, которые можно фильтровать по задаче. Её главный принцип сформулирован так: «References carry identity, the prompt carries action».
Есть и два способа ускорить написание самих сценариев. Пользователи Reddit сообщают о хороших результатах, если вставить официальное руководство в LLM и указать нужный режим: «rewrite this idea as T2VA using the base guide». Для ComfyUI существует расширение MiniMax H3 Prompt Writer v0.3, которое собирает структурированный промпт внутри нодового рабочего процесса.
FAQ
Чем отличаются базовое руководство MiniMax H3 и руководство по референсам?
Базовое руководство описывает четыре режима без референсов — T2VA, I2VA, FL2VA и L2VA — и строится на трёх основных полях. Руководство по референсам добавляет шесть обязательных разделов и метки <Subject>/<Picture>/<Video>/<Audio>, если на генерацию влияют загруженные изображения, видео или аудио.
Как обозначать говорящих в промпте MiniMax H3?
Назначайте стабильные ID (S1), (S2) в порядке первого появления голоса, сохраняйте один и тот же ID во всех сценах, для одновременной речи используйте (S1,S2), а внутри тегов <d> оставляйте только обозначение языка и точные слова реплики.
Как убрать тарабарщину в аудио MiniMax H3?
Структурируйте диалог с помощью ID говорящих и дословных тегов <d>, явно описывайте молчащих персонажей как не говорящих и указывайте non_diegetic_music: N/A, если музыка не нужна. Это подтверждённые документацией и сообществом способы исправления проблемы.
Нужно ли заключать диалоги MiniMax H3 в кавычки?
Нет. Кавычки предназначены для текста, видимого в кадре. Произнесённую реплику нужно оформлять как <d>[Language] ...</d>, иначе H3 может вывести её на экран в виде субтитров.
Какой длины может быть промпт MiniMax H3?
Около 7 000 символов согласно документации fal и официального V2 API, хотя APIMODELS указывает 20 480. Перед тем как писать сценарий на 10 000 символов, проверьте лимит конкретного эндпоинта.
Что одним синтаксисом не исправить
Структурированный промпт повышает вероятность удачного результата, но не делает генерацию детерминированной. Точное сохранение лица, логотипа и характеристик продукта по-прежнему вероятностное: созданные сообществом API-обёртки прямо не обещают покадровую стабильность, а лучшие примеры из библиотек добиваются сохранения идентичности длинными блоками ограничений, а не измеримыми гарантиями. Встроенные <tags> для невербальных звуков остаются экспериментом сообщества, и их результат зависит от генерации. Оценивайте результат по стоимости одной одобренной секунды, а не одного запроса, и держите официальные базовое руководство и руководство по референсам открытыми в отдельной вкладке.
Читайте также: обзор релиза MiniMax H3 рассказывает, что это за модель, а материал MiniMax H3 vs LTX 2.3 сравнивает её с самой дешёвой альтернативой по цене секунды.