 AIREITER
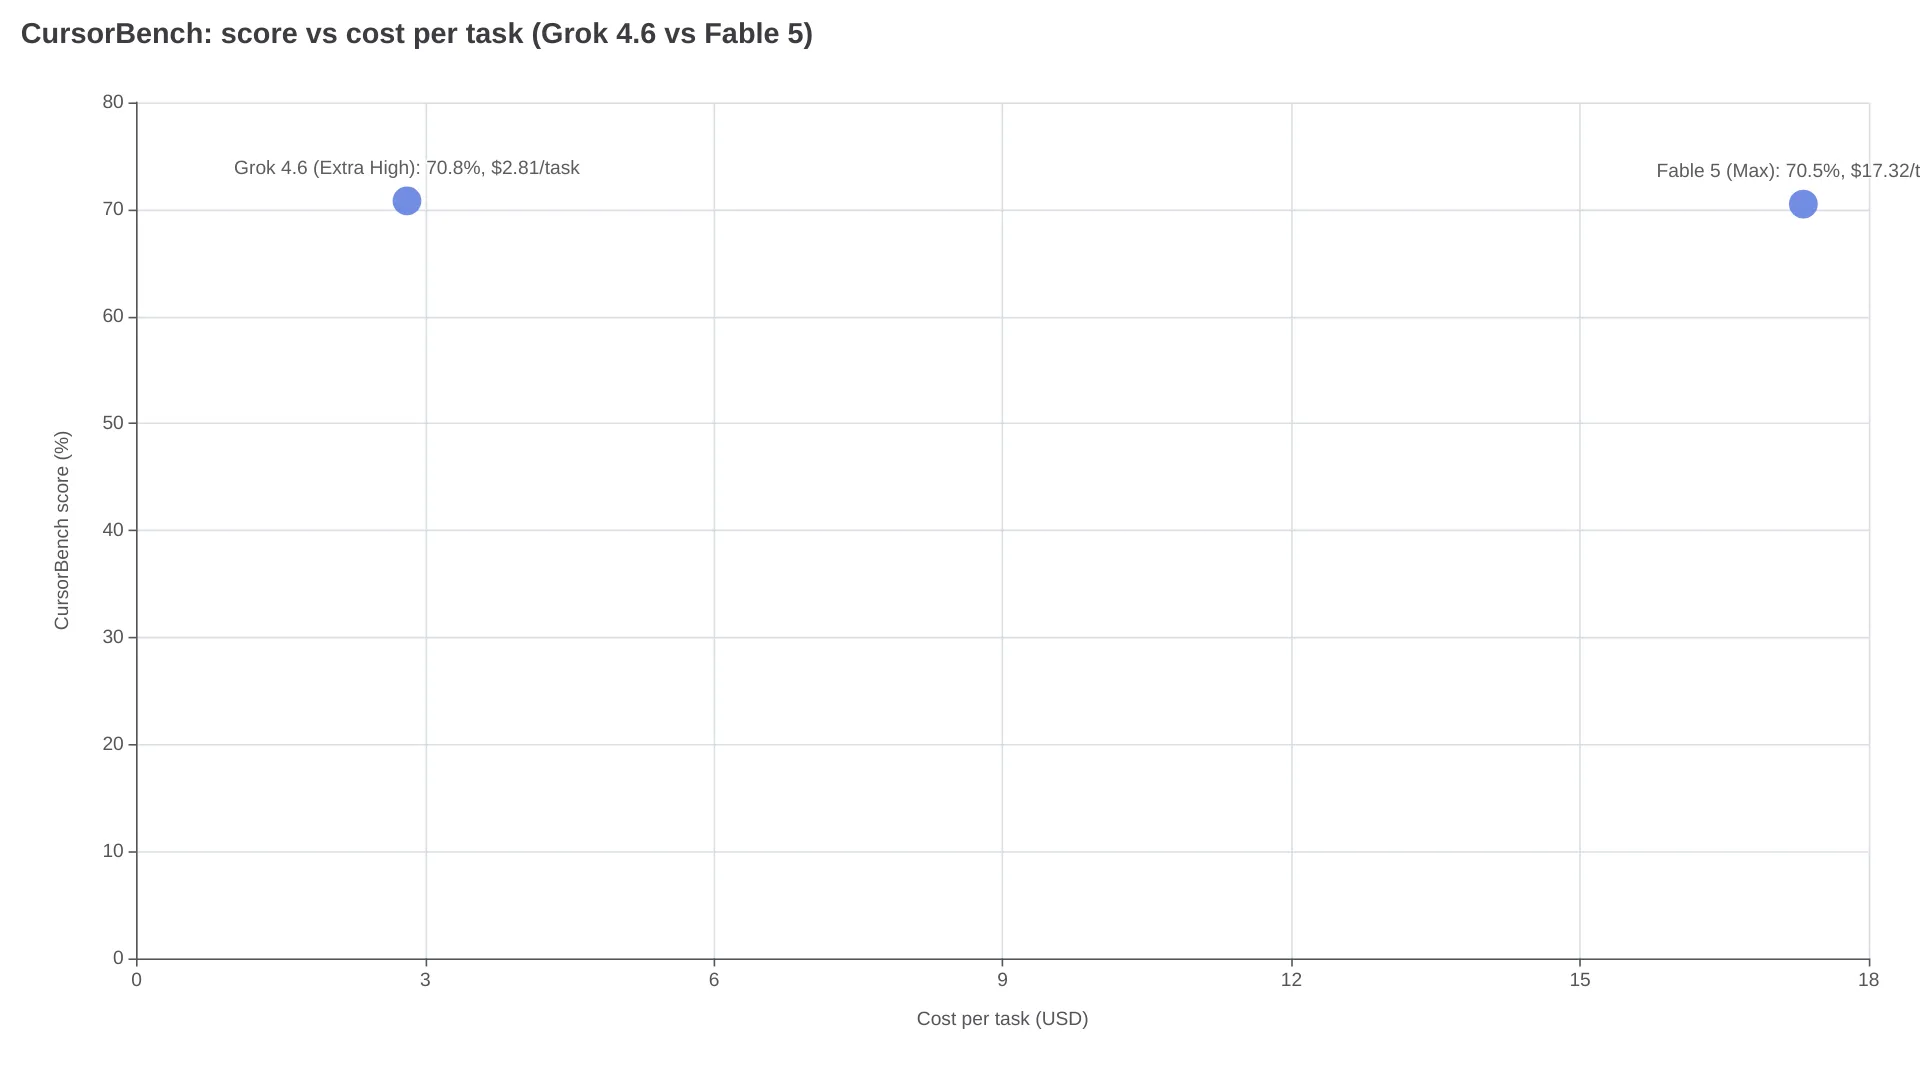
В тестах кодовых агентов Grok 4.6 Extra High и Fable 5 Max фактически пришли к ничьей: 70.8% и 70.5% на CursorBench. Но цена завершённой задачи отличается радикально — $2.81 у Grok против $17.32 у Fable, то есть примерно в 6 раз. Впрочем, у Fable 5 остаются два весомых козыря: первое место в более широком Artificial Analysis intelligence index и вдвое большее контекстное окно.
Почему Grok 4.6 почти догнал Fable 5
Ещё два месяца назад победитель в этом сравнении был очевиден. В июле 2026 года Artificial Analysis оценивал Grok 4.5 в 56 баллов по Intelligence Index, тогда как Fable 5 набирал 62 — разрыв составлял шесть пунктов. Вышедший в августе 2026 года Grok 4.6, судя по сообщаемым изменениям в бенчмарках, прибавил около пяти баллов и достиг ~59, примерно сравнявшись с GPT-5.6 Sol. Преимущество Fable 5 сократилось примерно до трёх пунктов.
В агентном программировании разрыв оказался ещё меньше. Когда Fable 5 появился в Cursor в июне 2026 года, он установил новый рекорд CursorBench — 72.9%, на 8 пунктов выше предыдущего результата (r/accelerate). Но в августовском прямом сравнении на r/cursor, опубликованном после релиза Grok 4.6, версия Grok 4.6 Extra High получила 70.8%, а Fable 5 Max — 70.5%. Оба результата получены в одном и том же агентном окружении, поэтому разницу можно считать статистически несущественной. При этом стоит помнить замечание пользователя Cursor, проводившего тест:
"Grok 4.6 заставил меня задуматься: какая доля CursorBench приходится на модель, а какая — на само окружение?" — обсуждение на r/cursor, август 2026 года
Бенчмарки измеряют всю агентную систему: шаблоны промптов, инструменты, повторные попытки, а не только базовую модель. Кроме того, рекордные 72.9% Fable 5 при запуске и августовские 70.5% были получены в разных конфигурациях. Оба результата разумнее воспринимать как ориентиры, а не как окончательный вердикт.
По стоимости задачи Grok 4.6 впереди безоговорочно
Главный результат августовского сравнения — стоимость одной выполненной задачи:
| Метрика (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| Результат | 70.8% | 70.5% |
| Стоимость задачи | $2.81 | $17.32 |
| Шагов на задачу | 46 | 72 |
Чтобы прийти к тому же результату, Fable 5 потребовалось на 57% больше агентных шагов. Дополнительные шаги означают больше reasoning-токенов — отсюда и существенная разница в цене. Поэтому разработчики, переключавшиеся между моделями, начали ставить под сомнение сам подход к сравнению по прайс-листу:
"$/token становится неправильным способом сравнивать AI-агентов." — заголовок темы на r/grok, август 2026 года
Часть разницы объясняют тарифы за токены. Fable 5 стоит $10 за входные и $50 за выходные токены на миллион через Anthropic API. Опубликованный тариф xAI API для Grok 4.5 составлял $2 / $6 за миллион токенов при промпте до 200K токенов. Отдельный прайс для 4.6 компания xAI пока не выпустила, а сообщество r/grok описывает модель как дающую "производительность уровня Sol за долю API-цены". Полный разбор тарифов Fable 5 для всех уровней есть в материале о ценах Fable 5 API.
На практике преимущество Grok уменьшают два фактора. При промптах свыше 200K токенов его цена примерно удваивается — до $4 / $12 за миллион, согласно опубликованным тарифам xAI. А если ваш процесс всё равно в значительной степени завязан на Fable 5, перед сменой модели можно структурно снизить расходы на токены Fable 5.
В чём Fable 5 всё ещё сильнее
| Область | Данные | Что это даёт на практике |
|---|---|---|
| Индекс интеллекта | Fable 5 остаётся №1 в AA Intelligence Index: 62 против примерно 59 у Grok 4.6 | После скачка версии 4.6 от прежнего преимущества в шесть баллов осталось три |
| Контекстное окно | Fable 5 предоставляет 1,000,000 токенов контекста, Grok — 500,000 | Крупный репозиторий вместе с историей задачи помещается за один проход, а ценовое преимущество Grok сокращается после порога в 200K |
| Надёжность на самых сложных задачах | В тесте сборки от TryAI Fable 5 с первой попытки отрисовал 3D-кубик Рубика и выдал лучший SVG, тогда как Grok 4.5 потребовался повторный запуск. В Goldie Bench Fable 5 выиграл 20-17 в 47 одношаговых задачах, опередив соперника в сборках с шейдерами и GPU-физикой на 0.8-1.6 балла | На неоднозначных задачах, где есть только одна попытка, заметнее верхняя граница рассуждений Fable 5 |
Скорость, задержки и пропускная способность
Замеры TryAI: одинаковая маршрутизация через провайдера, лимит 400 токенов, по три запуска для каждого типа промптов.
| Метрика | Grok 4.5 | Fable 5 |
|---|---|---|
| Время до первого токена | 0.44 s | 3.47 s |
| Пропускная способность | 110 tok/s | 28 tok/s |
| Стоимость ответа | $0.00002 | $0.00009 |
| Доля успешных запросов | 100% | 100% |
Grok генерировал 110 tok/s — примерно вдвое быстрее GPT-5.5 и Opus 4.8 и приблизительно вчетверо быстрее Fable 5 с его 28 tok/s. Artificial Analysis приводит ещё более жёсткий показатель Fable 5 в режиме максимальных усилий рассуждения: 113.68 секунды до первого токена ответа против 8.68 у Grok. После начала стриминга Fable 5, однако, декодирует чуть быстрее: 63.1 против 58.9 tok/s. На практике Grok ощущается быстрым в интерактивных циклах, тогда как Fable 5 долго думает в начале и расплачивается за это общим временем выполнения.
Доступ, подписки и агентные инструменты
Fable 5 доступен через Anthropic API, Claude Code и Cursor; подписки Claude Pro с фиксированной ставкой покрывают большую часть сценариев вне API. Экосистема Claude Code — CLAUDE.md, плагины, skills и MCP-серверы — развивалась годами.
Grok 4.6 доступен через xAI API и CLI-инструмент Grok Build (curl -fsSL https://x.ai/cli/install.sh | bash), а X Premium включает доступ к чату. По данным ClockedCode, Grok Build без настройки читает существующие файлы CLAUDE.md, плагины Claude Code, skills, MCP-серверы, агентов и hooks; умеет работать без интерфейса через флаг -p для CI и предоставляет Agent Client Protocol для встраивания. Экосистема пока моложе, но совместимость с Claude Code для подходящих конфигураций сводит стоимость миграции практически к нулю.
Есть и общая особенность биллинга: подписчики Claude Pro и X Premium платят фиксированную цену, поэтому важнее смотреть на лимиты при вашей реальной нагрузке, а не на тариф за токен.
Какую модель выбрать для разных сценариев
| Ваша ситуация | Выбор | Почему |
|---|---|---|
| Большой поток чётко сформулированных задач по коду | Grok 4.6 | $2.81 за задачу против $17.32 при равных результатах CursorBench |
| Работа в крупном репозитории, где критична корректность | Fable 5 | Контекст 1M токенов, первое место в индексе интеллекта и лучшая надёжность с первой попытки |
| Интерактивные сессии с агентом и быстрые итерации | Grok 4.6 | 0.44 s до первого токена, 110 tok/s |
| Неоднозначные одношаговые сборки и самые сложные рассуждения | Fable 5 | Победил в самой сложной задаче TryAI и в прямых сравнениях Goldie Bench |
| Жёстко ограниченный бюджет на API | Grok 4.6 | Выходные токены стоят примерно одну восьмую цены Fable 5 |
Мой вывод: Grok 4.6 стоит выбирать по умолчанию для ограниченных и повторяющихся задач, а Fable 5 оставлять для случаев, где цена неправильного ответа выше цены токенов. Командам с заметным объёмом работы разумно использовать обе модели и маршрутизировать задачи по их типичному размеру, частоте повторных попыток и стоимости завершённой задачи. Это дешевле, чем жёстко привязываться к одной модели.
FAQ
Grok 4.6 лучше Fable 5 для программирования?
На CursorBench они идут вровень: 70.8% у Grok 4.6 Extra High против 70.5% у Fable 5 Max в августовском сравнении. Fable 5 по-прежнему лидирует в более широком индексе Artificial Analysis (62 против ~59) и лучше справляется с наиболее сложными одношаговыми задачами. Поэтому ответ зависит от того, что для вас важнее: цена завершённой задачи или максимальная надёжность.
Grok 4.6 дешевле Fable 5?
Да, примерно в 6 раз в пересчёте на завершённую задачу CursorBench: $2.81 против $17.32. Сравнение по токенам опирается на опубликованный тариф Grok 4.5 — $6 за выходные токены против $50 у Fable 5 за миллион, — поскольку xAI ещё не выпустила отдельный прайс для 4.6. При объёме свыше 200K токенов разрыв сокращается: цена Grok примерно удваивается.
У какой модели больше контекстное окно?
У Fable 5: 1,000,000 токенов против 500,000 у Grok. Если в контекст нужно поместить весь код проекта, эта разница может перевесить ценовое преимущество Grok.
Может ли Grok Build использовать мою настройку Claude Code?
Да. Grok Build автоматически читает CLAUDE.md, плагины Claude Code, skills, MCP-серверы, агентов и hooks без переноса конфигурации, а для собственных настроек Grok добавляет каталог .grok/.
Можно ли считать бенчмарки Grok 4.5 хорошим ориентиром для Grok 4.6?
Не для оценки возможностей. По сравнению с 4.5 Grok 4.6 прибавил около пяти пунктов Intelligence Index: отставание от Fable 5 сократилось с шести примерно до трёх баллов. Кроме того, на CursorBench 4.6 сравнялся с Fable 5 Max, тогда как 4.5 заметно уступал. Данные о скорости и цене за токен в этой статье относятся к Grok 4.5, поскольку сопоставимые цифры для Grok 4.6 ещё не опубликованы.
Компромисс, который пока не исчезнет
Ни один из приведённых бенчмарков не отвечает окончательно, сохранится ли ценовое преимущество, когда репозиторий насчитывает 50,000 строк, задача сформулирована неоднозначно, а неудачная попытка отнимает час на отладку. Контекст в 1M токенов и более высокий потолок интеллекта Fable 5 как раз рассчитаны на такие случаи. Это выбор между дорогой уверенностью и дешёвыми шагами Grok 4.6 — разрыв достаточно велик, чтобы большинство команд держали активными обе модели.
Читайте также: Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5