 AIREITER
Недорогой coding-агент легко становится дорогим, когда контекст пересекает тарифный порог или бюджет на рассуждения съедает лимит ответа. Выбор между Grok 4.6 и Opus 5 сводится к этому: для задач с ограниченным бюджетом и промптами до 200K токенов берите Grok 4.6; Claude Opus 5 нужен там, где действительно необходимы окно в 1M токенов, вывод до 128K токенов или его документированные средства управления агентами.
Сначала определите границы своей нагрузки
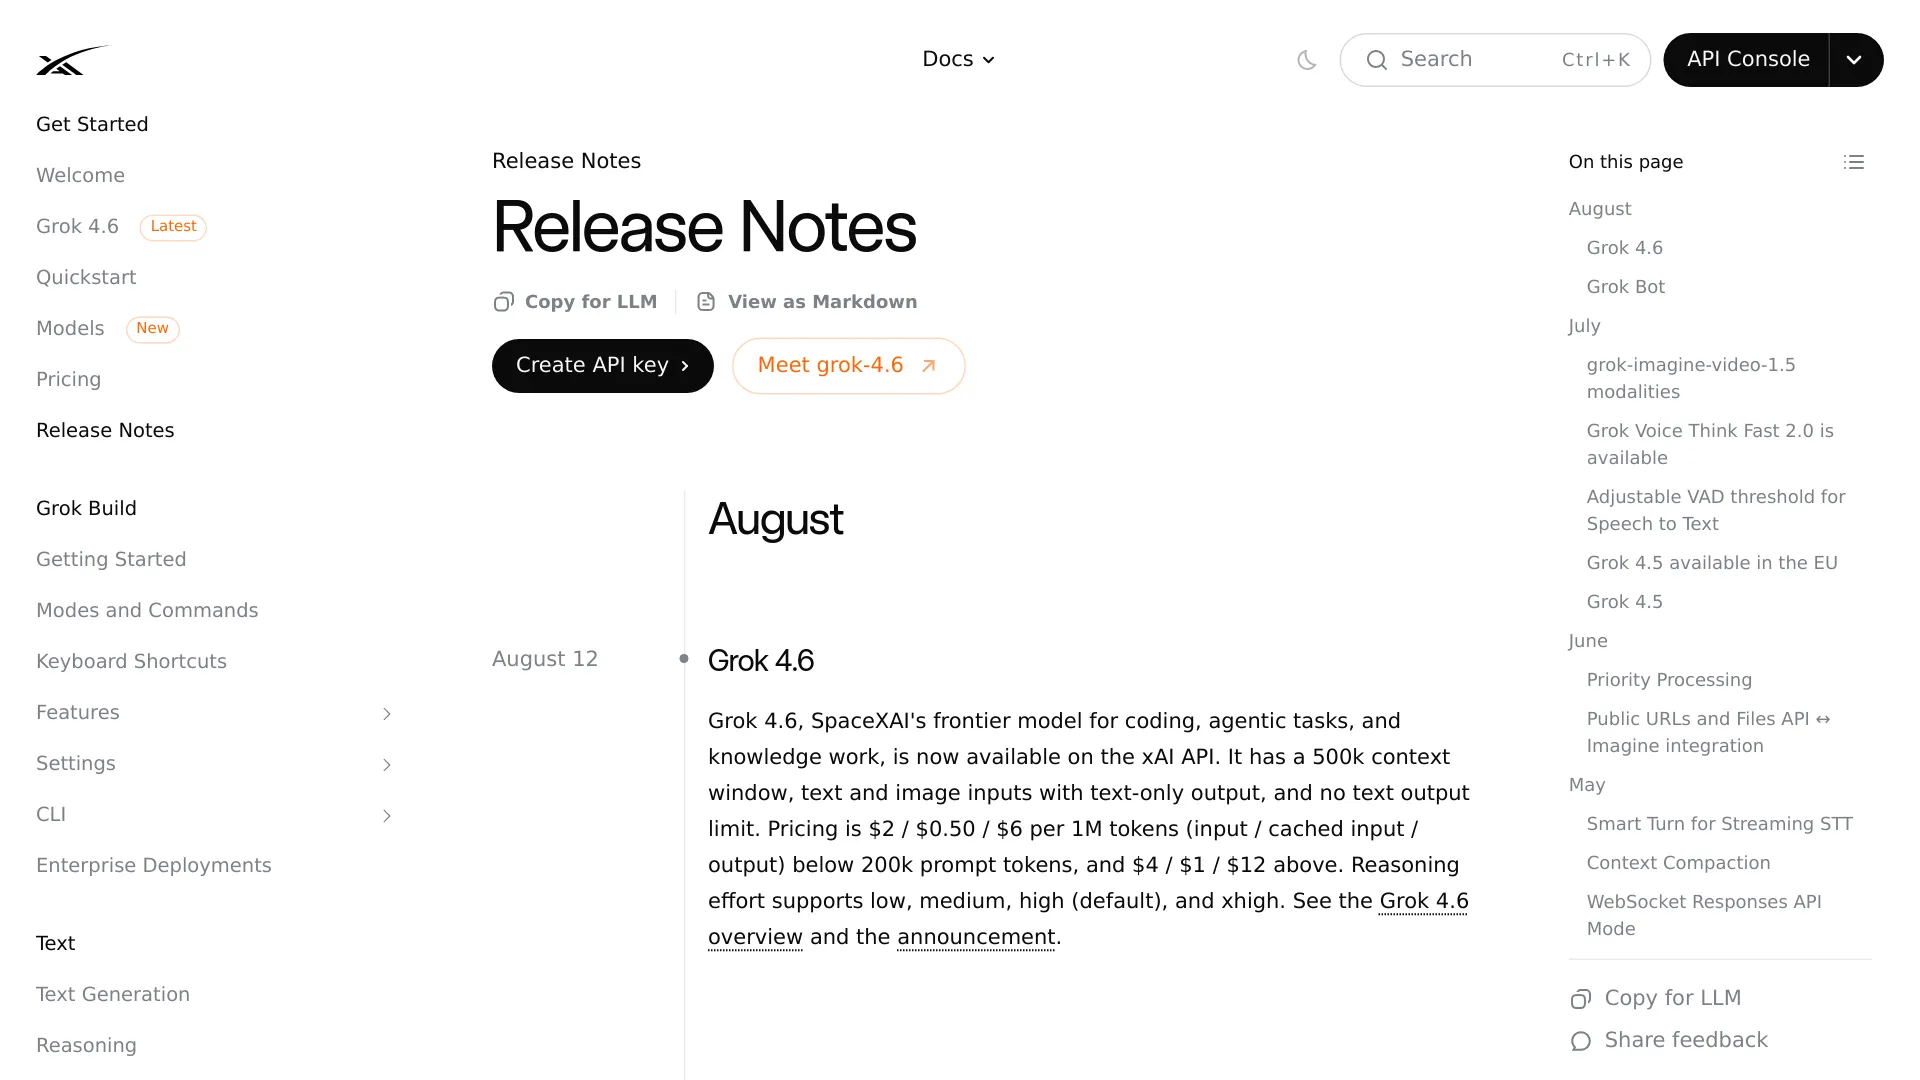
Grok 4.6 — практичный вариант по умолчанию для агентов, генерирующих текст: будь то код или задачи со знаниями, — если их промпт укладывается в порог xAI в 200K токенов. В примечаниях к релизу от 12 августа 2026 года xAI указывает контекстное окно 500K, входные данные в виде текста и изображений, текстовый вывод и четыре уровня усилий: от low до xhigh. Основной источник спецификаций — примечания к релизам для разработчиков xAI.
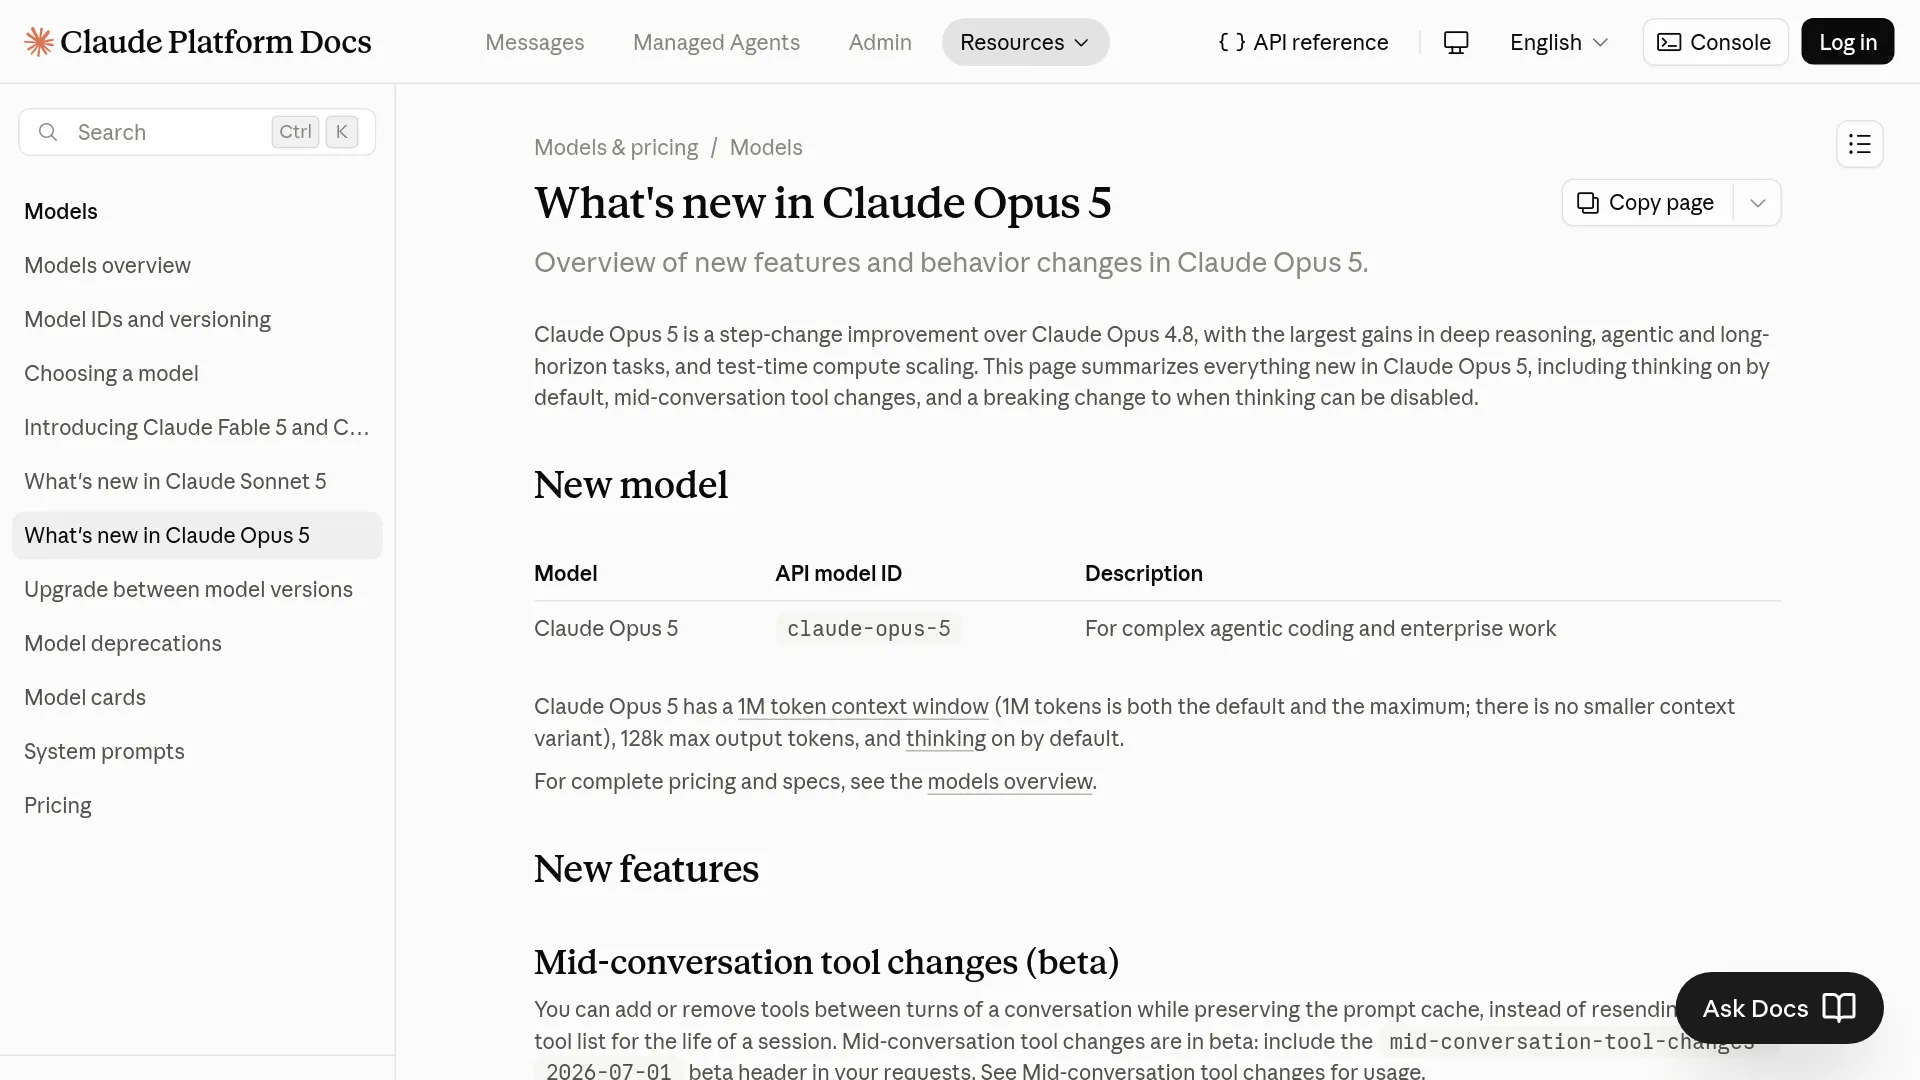
Claude Opus 5 уместнее, если 500K токенов недостаточно, процессу требуется до 128K выходных токенов либо интеграция завязана на механизмы fallbacks и динамические списки инструментов Anthropic. Anthropic документирует контекстное окно 1M токенов — одновременно стандартное и максимальное, — рассуждения, включённые по умолчанию, и доступность claude-opus-5 через API и крупных облачных партнёров. В этом случае документация Claude Platform по Opus 5 важнее небольшой разницы в лидербордах.
Приведённые источники не содержат единого бенчмарка, который определил бы победителя для всех задач программирования. Сначала оцените в собственном тестовом контуре максимальный размер промпта, нужную длину ответа, контракт инструментов и стоимость завершённой задачи.
Сведите ограничения API в одну таблицу, а потом сравнивайте результаты
Grok 4.6 и Claude Opus 5 принимают текст и изображения, а генерируют текст. Ключевые различия — объём контекста, тарификация длинных запросов, условия вывода и средства интеграции.
| Параметр API | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| Контекстное окно | 500K токенов | 1M токенов |
| Типы входных данных | Текст, изображения | Текст, изображения, PDF и сценарии работы с документами, описанные Anthropic |
| Тип вывода | Текст | Текст |
| Максимальный текстовый вывод | Числовой лимит в примечаниях к релизу xAI не указан | 128K токенов |
| Уровни усилий | low, medium, high, xhigh | low, medium, high, xhigh, max |
| Уровень по умолчанию | high | high |
| Стандартная цена входных токенов | $2/M токенов | $5/M токенов |
| Стандартная цена выходных токенов | $6/M токенов | $25/M токенов |
| Правило для длинных промптов | $4/M за вход и $12/M за выход при промпте свыше 200K токенов | В документации к релизу Opus 5 аналогичный порог не указан |
| Кэшированный вход | $0.50/M ниже 200K; $1/M выше 200K | Минимальный кэшируемый промпт — 512 токенов; стоимость кэша описана отдельно |
Заявленные ставки Grok 4.6 ниже, но после 200K токенов они удваиваются. Opus 5 дороже, зато его контекст в 1M токенов может избавить от разбиения данных на части или накладных расходов на retrieval в сценариях, где это необходимо.
Когда Grok 4.6 меняет экономику задачи
Для промптов до 200K токенов Grok 4.6 стоит $2 за миллион входных и $6 за миллион выходных токенов. При превышении 200K xAI указывает $4/M за вход и $12/M за выход; кэшированный вход стоит соответственно $0.50/M и $1/M. Поэтому важна именно эта граница, а не только привлекательная базовая ставка. Оба тарифа зафиксированы в примечаниях к релизу xAI.
По опубликованным ставкам запрос с 100K некэшированных входных токенов и 20K выходных обойдётся в $0.32. Для 250K входных и 20K выходных токенов стоимость составит $1.24 после применения повышенного тарифа. Это расчёты одного запроса, а не оценка стоимости запуска агента: на итоговый счёт могут сильнее влиять повторы, вызовы инструментов, кэшированные префиксы и накапливающийся контекст.
В недавнем обсуждении на r/grok приведены зависящие от конфигурации результаты CursorBench 3.2: $2.81 за задачу и 46 шагов для Grok 4.6 Extra High против $8.23 и 78 шагов для Opus 5 Max. Считайте эти цифры результатами тестового контура автора, а не независимой гарантией: в той же публикации Grok 4.6 набирает 26.0% на Terminal-Bench 3.0, уступая другим упомянутым моделям.
Когда Opus 5 меняет архитектуру интеграции
В Claude Opus 5 рассуждения включены по умолчанию. max_tokens задаёт жёсткий общий лимит для скрытых рассуждений и видимого ответа, поэтому при миграции с запросов Opus 4.8 без рассуждений может потребоваться увеличить бюджет вывода. Anthropic также предупреждает: сочетание thinking: {"type":"disabled"} с xhigh или max вернёт HTTP 400. В примечаниях по миграции предложены два варианта: снизить уровень усилий при отключённых рассуждениях либо убрать настройку, отключающую рассуждения.
Claude Opus 5 также снижает минимальный размер кэшируемого промпта с 1,024 токенов в Opus 4.8 до 512 токенов. Его бета-механизмы позволяют менять инструменты в середине диалога без сброса кэша промпта и предлагают управляемый режим fallbacks: "default". Это полезно агентам с меняющимися правами или наборами инструментов, но для простого stateless endpoint генерации текста значения не имеет.
Fast mode — исследовательское превью, доступное только через API, — стоит $10/M за вход и $50/M за выход: вдвое дороже стандартного Opus 5. Anthropic указывает, что режим недоступен через Amazon Bedrock, Google Cloud и Microsoft Foundry, поэтому нельзя автоматически рассчитывать и на переносимость, и на скорость. В анонсе запуска Anthropic стандартные цены указаны как $5/M за вход и $25/M за выход.
Данные о coding-агентах задают направление, но не называют абсолютного победителя
По данным Anthropic, Opus 5 на максимальном уровне усилий достигает около 70.0% в CursorBench 3.2 при стоимости примерно $8.50 за задачу. Это в пределах 0.5 процентного пункта от заявленного лучшего результата Fable 5 и примерно вдвое дешевле. Перед нами графики Anthropic, то есть данные оценки поставщика, а не межплатформенный аудит. В анонсе Opus 5 метод Frontier-Bench описан как пять попыток на задачу во внутреннем запуске Anthropic.
Для code review полезнее более узкое, но внешнее измерение. CodeRabbit протестировал около 100 подтверждённых типов ошибок из реальных pull request в open-source-проектах, запускал каждую конфигурацию трижды и оценивал комментарии ревью после фильтрации. При уровне xhigh конфигурация Opus 5 выявила 55.2% известных проблем против 61.1% у production-базлайна, а точность полезных замечаний составила 39.3% против 35.2%. При этом она выдала 92 придирки к стилю против 23. В оценке Opus 5 от CodeRabbit рекомендуется выделить модели конкретную роль с фокусом на точность, а не использовать Opus 5 как единственную линию защиты.
Из этих данных следует практическое правило: тестируйте Opus 5 на нескольких уровнях усилий и измеряйте recall, precision, расход токенов и шум ревью на собственных pull request. Для Grok 4.6 текущие примечания к релизу xAI дают контракт API и цены, но не публикуют сопоставимого исследования code review. Не делайте вывод о преимуществе в ревью кода по результату coding-агента.
Выбирайте модель по этой матрице внедрения
Grok 4.6 рекомендуется для агентов, чьи обычные промпты остаются меньше 200K токенов и для которых приоритетна более низкая заявленная стоимость API. Заложите бюджет на оценку около порога: репозиторный агент может пересечь его из-за вывода инструментов и повторов, даже если первый промпт был небольшим.
Claude Opus 5 рекомендуется для сессий с репозиторием, документами или агентом, которым требуется свыше 500K токенов активного контекста, до 128K токенов вывода либо документированные Anthropic механизмы смены инструментов и fallback. Начните с high, а затем проверьте более низкие уровни, прежде чем считать, что max окупается.
Для автоматизированного code review не выбирайте ни одну из моделей по общему лидерборду программирования. Возьмите размеченный набор pull request, зафиксируйте recall проблем и нагрузку от ложных срабатываний, а также сохраните второй путь проверки для дефектов конкурентности, использования API и валидации. В протестированных конфигурациях Opus 5 CodeRabbit назвал эти категории более слабыми. Выводы по категориям — повод проверить соответствие задаче, а не утверждение обо всех развёртываниях Claude.
| Сценарий внедрения | Выбор по умолчанию | Что определяет решение |
|---|---|---|
| Чувствительный к цене coding-агент с промптами до 200K токенов | Grok 4.6 | Заявленные ставки $2/M за вход и $6/M за выход |
| Длинная сессия с репозиторием или документами, превышающая 500K контекста | Claude Opus 5 | Контекстное окно 1M и лимит вывода 128K |
| Агент с динамически меняющимися инструментами | Claude Opus 5 | Бета-изменение инструментов в ходе диалога сохраняет кэш |
| Задача с частыми промптами свыше 200K токенов | Оцените обе модели | У Grok 4.6 на этом пороге удваиваются заявленные ставки за токены |
| Конвейер code review | Оцените обе модели на размеченных PR | Recall, precision, повторы и шум ревью важнее громкого результата в бенчмарке |
FAQ
Grok 4.6 дешевле Opus 5?
При промптах до 200K токенов xAI заявляет для Grok 4.6 $2/M за вход и $6/M за выход, тогда как Opus 5 стоит $5/M и $25/M соответственно. После 200K токенов заявленные цены Grok 4.6 удваиваются, поэтому сравнивайте стоимость завершённой задачи, а не только первого запроса.
Какую модель выбрать для программирования?
Выбирайте Grok 4.6 ради более низких заявленных ставок API, если ваш агент обычно не выходит за 200K токенов в промпте. Opus 5 нужен, когда требуются контекст 1M, вывод 128K или агентные средства Anthropic. Любой выбор стоит проверить на используемом вами языке, структуре репозитория и цикле работы с инструментами.
Следующий шаг перед внедрением
Прогоните через каждого кандидата одни и те же 20–50 репрезентативных задач с фиксированными инструментами, фиксированным лимитом повторов и логированием токенов. Выберите модель, которая достигает нужного pass rate при меньшей стоимости завершённой задачи, а вторую сохраните как вариант с маршрутизацией для нагрузок, где решающим оказывается её преимущество в контексте или управляющем слое.
Читайте также: гид по ценам Claude Opus 5 API, подробности релиза Grok 4.6 и Grok 4.6 vs GPT-5.6.