 AIREITER
По Artificial Analysis Intelligence Index Grok 4.6 практически сравнялся с GPT-5.6 Sol: около 61 балла против 58,9. При этом выходные токены Sol обходятся в пять раз дороже. Однако выбор не сводится к прайс-листу: у Sol контекстное окно вдвое больше, а в агентных тестах он показывает более высокую эффективность.
Почти равны в общем рейтинге — но не во всём
Artificial Analysis Intelligence Index v4.1 объединяет в одну оценку задания на рассуждение, программирование и работу со знаниями. Согласно данным OpenAI, GPT-5.6 Sol набирает 58,9 балла. Для Grok 4.6 приводится результат около 61 — его сообщают участники сообщества со ссылкой на данные арены Artificial Analysis в публичных обсуждениях. Независимого подтверждения этой цифры пока нет, хотя она согласуется с тем, что Artificial Analysis относит Grok 4.6 к классу моделей, сопоставимых с Sol.
Единый композитный балл скрывает важные различия: размер контекстного окна, эффективность агентов и разброс результатов между бенчмарками. По опубликованным результатам OpenAI, Sol уверенно лидирует в агентных проверках — например, набирает 88,8% в Terminal-Bench 2.1 и 72,7% в DeepSWE v1.1. Независимых результатов Grok 4.6 в этих тестах пока нет. Intelligence Index говорит о близком общем уровне моделей, но в агентной работе картина может оказаться иной.
| Параметр | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Разработчик | xAI | OpenAI |
| Контекстное окно | 500K токенов (x.ai/api) | ~1 050 000 токенов (openai.com) |
| API: входные токены (за 1M) | $2.00 (x.ai/api) | $5.00 (openai.com) |
| API: выходные токены (за 1M) | $6.00 (x.ai/api) | $30.00 (openai.com) |
| Intelligence Index v4.1 | ~61 (по данным сообщества) | 58,9 (официально) |
| Доступность в облаках | Azure AI Foundry, Oracle OCI, Google Vertex (x.ai/api) | Azure, AWS Bedrock (openai.com) |
Цены API: вход дешевле в 2,5 раза, выход — в 5 раз
На странице API xAI для Grok 4.6 указаны $2.00 за миллион входных и $6.00 за миллион выходных токенов. На странице GPT-5.6 от OpenAI для Sol заявлены $5.00 за входные и $30.00 за выходные токены на миллион.
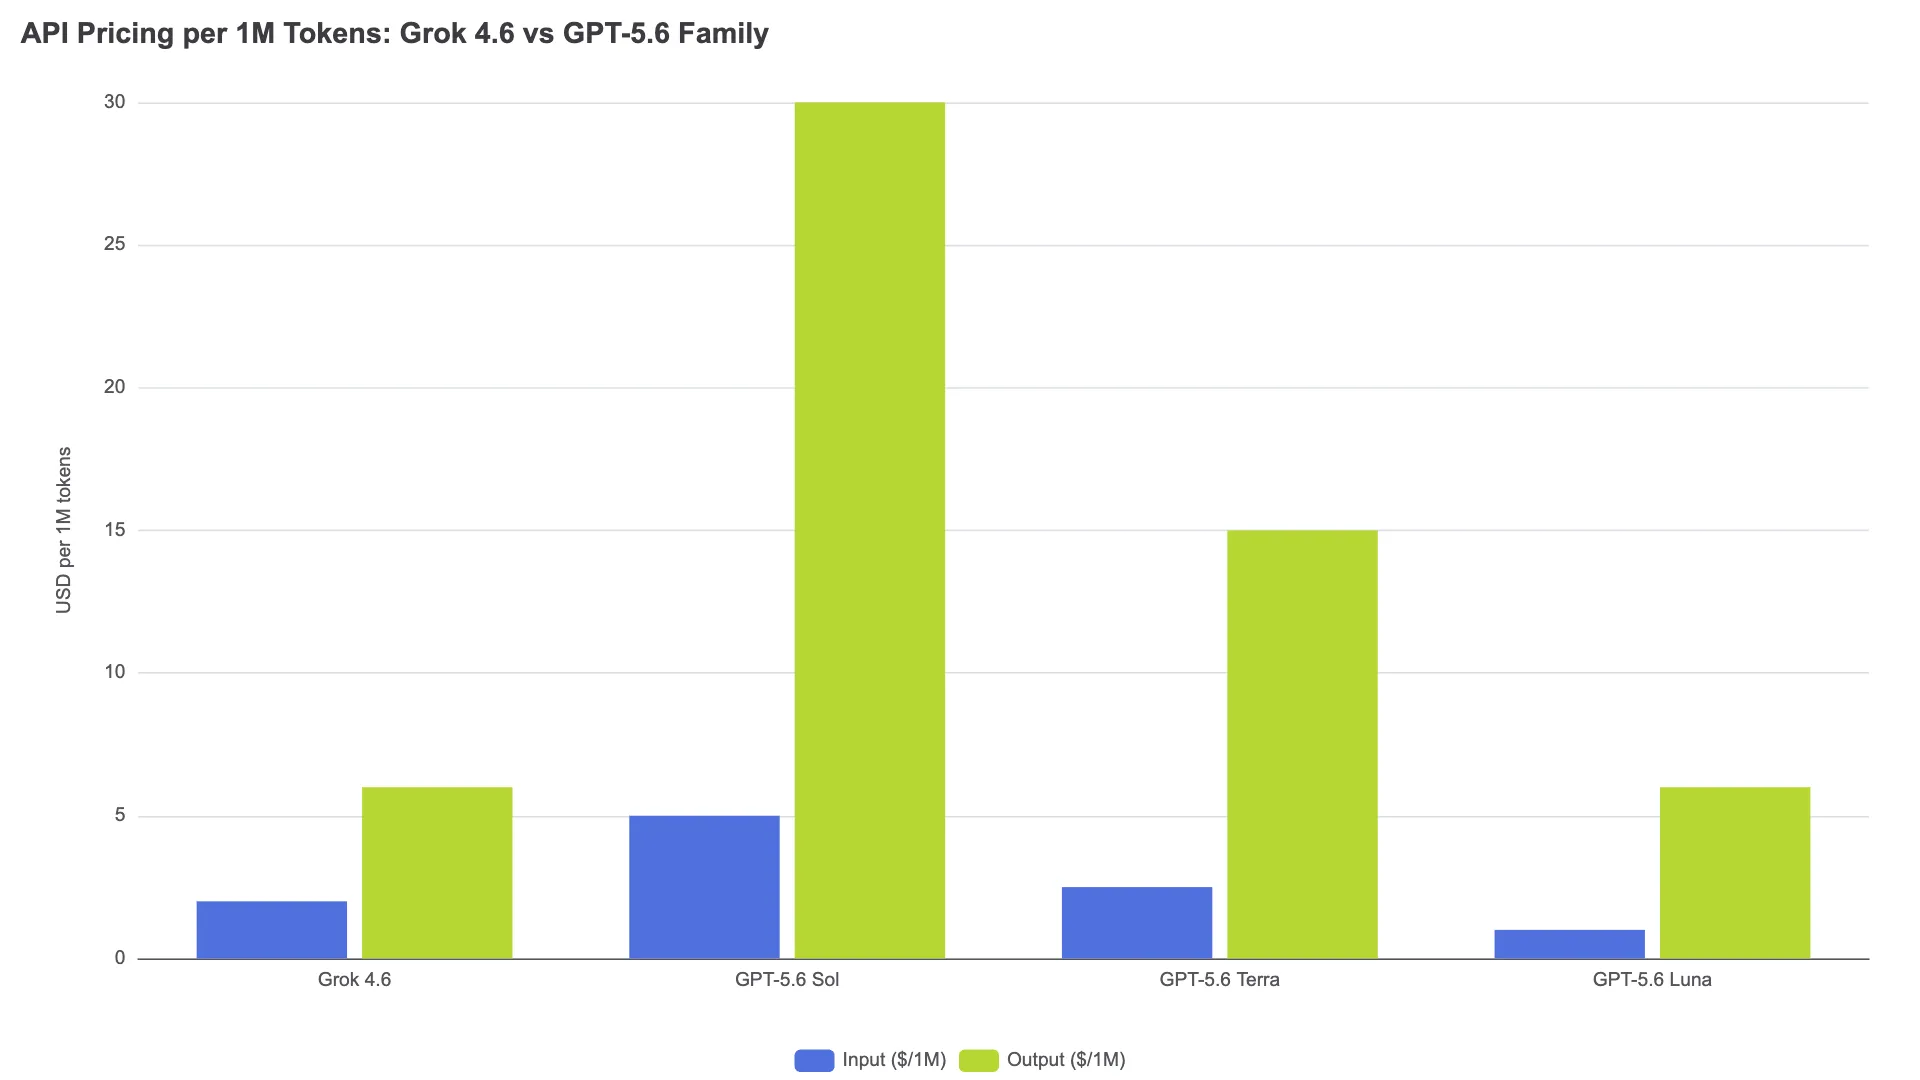
Если ежемесячная нагрузка составляет 50M входных и 10M выходных токенов, Grok 4.6 обойдётся в $160, а Sol — в $550. Разница составляет 3,4 раза ещё до учёта того, что режимы рассуждений Sol могут расходовать больше токенов на задачу.
У OpenAI есть и более доступные версии: GPT-5.6 Terra за $2.50/$15.00 и GPT-5.6 Luna за $1.00/$6.00 (30 июля 2026 года цена Luna была снижена на 80%). Luna стоит столько же, сколько Grok 4.6, по выходным токенам и дешевле по входным, но это меньшая модель с более низкими результатами во всех бенчмарках. Если сравнивать модели близкого интеллектуального уровня, корректная пара — Grok 4.6 и Sol. В ней преимущество Grok по стоимости весьма заметно.
Контекст: 500K токенов против 1M
Согласно странице API xAI, контекстное окно Grok 4.6 составляет 500K токенов. У Sol — около 1,05 миллиона, как указано в документации OpenAI. 500K токенов достаточно для обычной работы с компонентами, модулями и большинством задач на уровне сервиса. Окно в 1M становится важным, когда в один запрос нужно загрузить весь монорепозиторий, несколько крупных документов или длинную историю диалога. Если агенту требуется за один проход проанализировать 800K токенов кодовой базы, Sol справится, а Grok 4.6 — нет.
Важен и вопрос надёжности извлечения информации из длинного контекста. OpenAI сообщает, что Sol набирает 77,1% в GraphWalks BFS при контексте 1M токенов. Эквивалентных результатов Grok в тестах на извлечение из длинного контекста пока не опубликовано. Для сценария вроде «найти баг в кодовой базе на 600K токенов» преимущество Sol не ограничивается ёмкостью окна: имеет значение и способность модели действительно находить нужную информацию на такой глубине.
Кодинг и агенты: где модели действительно расходятся
Близость в Intelligence Index не повторяется во всех специализированных бенчмарках для программирования. Ниже приведены официальные результаты GPT-5.6 Sol от OpenAI и данные по Grok 4.5, опубликованные Fritz.ai, которые используются как ориентир. Независимые кодовые бенчмарки именно для Grok 4.6 ещё не опубликованы, поэтому колонку Grok следует воспринимать как данные предшественника, а не как прямое сравнение с Grok 4.6:
| Бенчмарк | GPT-5.6 Sol (официально) | Grok 4.5 (ориентир) | Разница |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58,9 | - | Grok 4.6: ~61 (почти равны) |
| Coding Agent Index v1.1 | 80,0 | - | Нет данных по Grok 4.6 |
| Terminal-Bench 2.1 | 88,8% | 83,3% | Sol +5,5 п. п. |
| DeepSWE v1.1 | 72,7% | 53,0% | Sol +19,7 п. п. |
| SWE-Bench Pro | 64,6% | 64,7% | Практически ничья |
| GPQA Diamond | 94,6% | 93,1% | Sol +1,5 п. п. |
Наиболее показательны отрывы Sol в Terminal-Bench и DeepSWE. Terminal-Bench проверяет, способен ли агент завершать реальные задачи в терминале: устанавливать пакеты, запускать тесты, отлаживать сбои. DeepSWE оценивает полный цикл разработки по реальным задачам из GitHub. Преимущество Sol над Grok 4.5 в DeepSWE на 19,7 пункта указывает, что он существенно сильнее в сложных многошаговых задачах, где модели нужно планировать действия, выполнять их и восстанавливаться после ошибок. Насколько посттренировочные улучшения Grok 4.6 сократили этот разрыв, ещё предстоит выяснить.
Результаты бенчмарков показывают направление, но не выносят окончательный вердикт. На итог влияют агентная обвязка, инструменты, промпты и среда выполнения: модель с меньшим баллом в одном окружении может показать лучший результат в другом.
Не цена токена, а стоимость выполненной задачи
По тарифам преимущество Grok 4.6 выглядит убедительно, но агентные системы покупают не токены, а завершённые задачи. Если Sol решает задачу программирования за 3 000 выходных токенов, а Grok 4.6 требуется 6 000 токенов на ту же работу из-за повторных попыток, более длинных цепочек рассуждений или менее эффективного использования инструментов, разница в стоимости сокращается.
Диапазон хорошо показывает расчёт чувствительности по текущим ценам. Предположим, для кодовой задачи Sol нужны 10K входных и 4K выходных токенов, а Grok 4.6 — 12K входных и 8K выходных токенов. Это означает двукратное преимущество Sol по эффективности расхода токенов:
| Статья затрат | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| Стоимость входа | $0.05 | $0.024 |
| Стоимость выхода | $0.12 | $0.048 |
| Итого на задачу | $0.17 | $0.072 |
Даже при таком двукратном проигрыше по эффективности Grok 4.6 остаётся в 2,4 раза дешевле на одну задачу. Пользователи Reddit, ссылающиеся на Artificial Analysis в обсуждении, оценили стоимость одной задачи Intelligence Index для Grok 4.6 примерно в $0.86. Сохранится ли ценовое преимущество Grok при эффективности уровня Sol в вашей конкретной нагрузке, зависит от сложности задач и агентной обвязки.
Главный риск — не экономика токенов, а успешное завершение работы. Более высокие баллы Sol в Terminal-Bench и DeepSWE означают, что он справляется со сложными агентными задачами, где Grok может полностью провалиться и потребовать повторного запуска или вмешательства человека. Невыполненная задача при любой цене обходится дороже успешно выполненной.
Доступность и экосистема
Обе модели уже доступны не только через API собственного провайдера. Основные источники информации — страница API xAI и документация OpenAI:
| Канал доступа | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry (x.ai) | Azure OpenAI (openai.com) |
| AWS | Не указан | Bedrock (openai.com) |
| Google Cloud | Vertex Model Garden (x.ai) | Не указан |
| Oracle | OCI Generative AI (x.ai) | Не указан |
| Интеграции с IDE | Cursor, Devin | Cursor, Codex |
| Совместимость SDK | OpenAI + Anthropic SDKs (x.ai) | OpenAI SDK |
| Потребительский чат | SuperGrok ($30/mo), X Premium+ | ChatGPT Plus ($20/mo) (fritz.ai) |
| Обучение на пользовательских данных | Подключено по умолчанию; требуется отказаться вручную | Данные API/Business по умолчанию исключены |
Согласно документации xAI, Grok поддерживает и OpenAI, и Anthropic SDK: для миграции достаточно сменить API-ключ и endpoint. Для чувствительного или проприетарного кода политика OpenAI, при которой данные API и Business по умолчанию не используются для обучения, упрощает закупочные согласования. Пользователям Grok нужно самостоятельно отказаться от обучения на данных — об этом говорится в анализе конфиденциальности Fritz.ai.
Какую модель выбрать?
| Нагрузка | Выбор | Причина |
|---|---|---|
| Высоконагруженные кодовые агенты | Grok 4.6 | Стоимость токенов ниже в 2,5–5 раз при масштабировании |
| Сложные многошаговые агентные задачи | GPT-5.6 Sol (предварительно) | Преимущество в агентных бенчмарках показано относительно Grok 4.5, а не 4.6 |
| Анализ крупных кодовых баз (>500K токенов) | GPT-5.6 Sol | Контекстное окно вдвое больше |
| Пакетная обработка с жёстким бюджетом | Grok 4.6 | Почти сопоставимый интеллект при меньшей цене токена |
| Исследование соцсетей и веба в реальном времени | Grok 4.6 | Нативный поиск по X и вебу (x.ai) |
| Чувствительный / проприетарный код | GPT-5.6 Sol | Данные API по умолчанию не используются для обучения |
| Корпоративное развёртывание в Azure | Любая из моделей | Обе доступны в Azure AI Foundry |
Самый надёжный способ выбрать модель — прогнать через оба API репрезентативную выборку ваших реальных задач. Сравнивайте долю успешно завершённых задач, медианную стоимость успешной задачи, число повторных попыток и задержку.
FAQ
Может, вместо Sol стоит сравнивать Grok 4.6 с GPT-5.6 Terra?
Terra ($2.50/$15.00) ближе к Grok 4.6 по цене, но уступает Sol во всех опубликованных бенчмарках: Intelligence Index — 55,0, Coding Agent Index — 77,4, Terminal-Bench — 87,4% (по данным OpenAI). Если сопоставлять модели по интеллектуальному уровню, честнее сравнивать Grok 4.6 с Sol. Если ориентироваться на цену, пара Grok 4.6 и Terra складывается в пользу Grok и по стоимости, и по бенчмаркам. Luna ($1.00/$6.00) дешевле обеих, но заметно жертвует качеством.
Подробный разбор характеристик и возможностей Grok 4.6 читайте в нашем гайде по Grok 4.6. А если вас интересует сравнение GPT-5.6 с более ранней версией Grok, в материале GPT-5.6 Sol vs. Grok 4.5 разобрана предыдущая пара моделей.