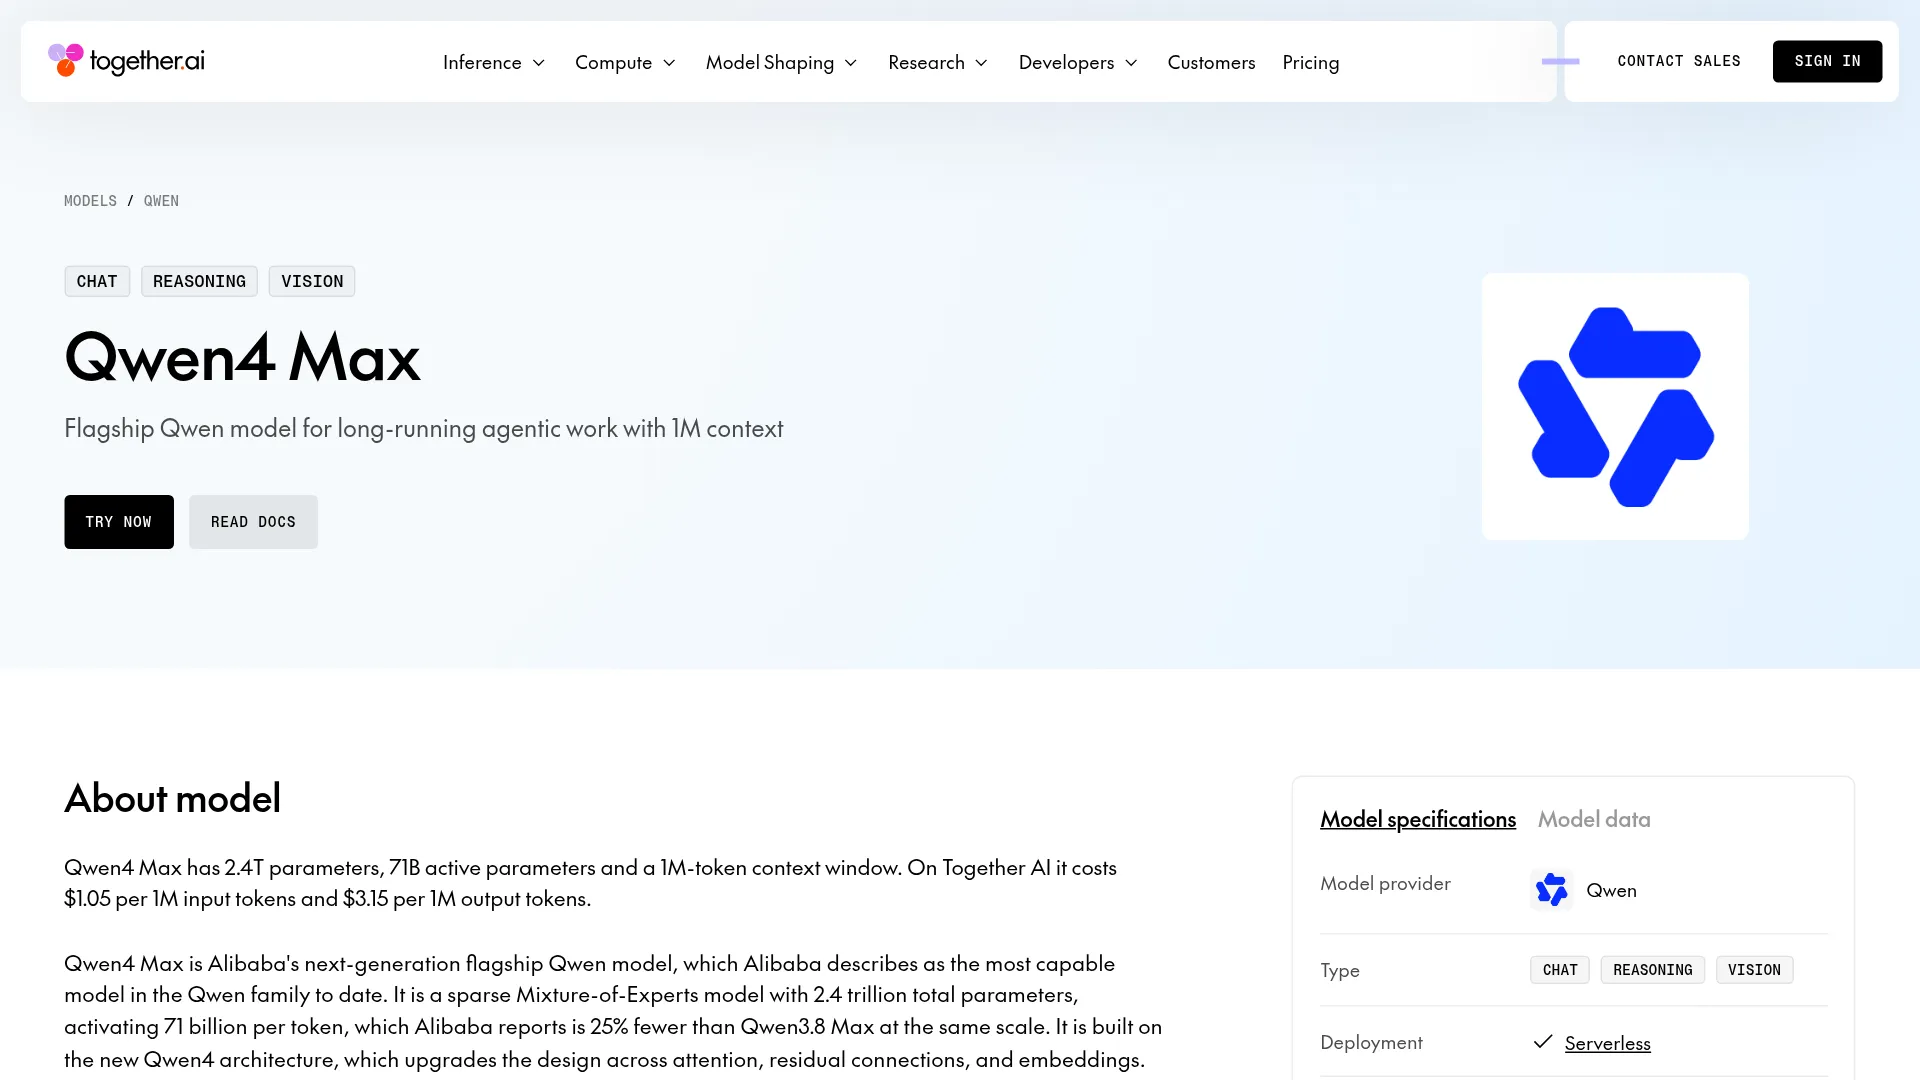
Together AI에서 Qwen4 Max는 입력 100만 토큰당 $1.05, 출력 100만 토큰당 $3.15입니다. 이 프로모션은 2026년 11월 22일까지 진행되며, 종료 시점의 정확한 기준은 실시간 가격 페이지에서 확인해야 합니다. 프로모션 이후 정가는 $1.50/$4.50입니다. 프로모션 기간에는 Together AI가 가장 저렴하지만, 정가로 전환되면 캐시 동작과 지연 시간, 라우팅이 선택을 좌우합니다.
엔드포인트 Qwen/Qwen4-Max, 1M 컨텍스트, 프로모션 가격은 Together AI의 모델 페이지와 2026년 11월 21일 게시된 출시 글에 명시돼 있습니다.
$0.69로 344개 파일을 한 번에 처리한 테스트
Together AI는 검색이나 도구 호출 없이 Tornado의 파일 344개(입력 토큰 652,519개)와 WebSocket 버그 리포트를 한 요청에 담았습니다(Together AI 출시 글). Qwen4 Max는 문제를 찾아 패치를 제안했고, 새 테스트와 기존 테스트 1,673개를 모두 통과했습니다. 첫 토큰까지 54초, 전체 응답 완료까지 72초가 걸렸습니다(Together AI 출시 글).
비용은 프로모션 기준 약 $0.69, 정가 기준 약 $0.98이었으며 거의 전부 입력 비용이었습니다. 약 630k 토큰을 반복 캐시하자 입력 비용은 약 $0.66에서 $0.03으로, 첫 토큰까지의 시간은 54초에서 8초로 줄었습니다. 다만 캐시 적용은 최선 노력(best-effort) 방식입니다(Together AI 출시 글).
"Alibaba의 Token Plan으로 테스트해 봤는데, DeepSeek 4.1Flash보다 성능이 좋았습니다(코딩 작업 몇 가지와 원격 인스턴스 작업에서). 다만 끝날 때까지 정말 오래 걸렸습니다." — r/Qwen_AI의 u/FlounderRecent
표 하나로 정리한 Together AI 가격
Together AI는 프로모션 종료일만 공개하고 종료 시각이나 시간대는 밝히지 않았습니다(모델 페이지). 대규모 작업을 실행하기 전에 반드시 확인하세요. 비용은 입력 토큰 수 / 100만 x 입력 단가 + 출력 및 추론 토큰 수 / 100만 x 출력 단가로 계산하며, 캐시된 입력에는 캐시 단가가 적용됩니다.
| 가격 구간 | 입력 / 1M | 캐시 입력 / 1M | 출력 / 1M |
|---|---|---|---|
| Together AI 프로모션(2026년 11월 22일까지) | $1.05 | $0.0525 | $3.15 |
| Together AI 정가 | $1.50 | $0.075 | $4.50 |
캐시 입력 단가는 일반 입력 단가의 5%입니다. 사고 토큰은 출력 토큰으로 계산됩니다(Together AI 출시 글).
| 작업 | 입력 | 출력 | 프로모션 비용 | 정가 비용 |
|---|---|---|---|---|
| 에이전트 코딩 세션 | 60,000 | 4,000 | $0.0756 | $0.108 |
| Tornado 전체 저장소 요청 | 652,519 | 약 2,000 추정 | 약 $0.69 | 약 $0.98 |
| 약 630k 프롬프트의 캐시 반복 요청 | 약 630,000 캐시 | 소량 | 입력 약 $0.03 | 입력 약 $0.047 |
Tornado 항목의 출력량은 추정치입니다. 추론 강도에 따라 과금되는 추론 토큰 수가 달라지기 때문입니다.
Together AI의 1M 컨텍스트, 실제로는 얼마나 쓸 수 있을까
Qwen4 Max는 프롬프트와 추론, 출력을 합쳐 1M 토큰을 지원한다고 안내합니다. 한 게이트웨이 스냅샷에서는 실제 입력에 사용할 수 있는 양을 약 984k로 제시하고(Sovyron), Vercel은 추론 토큰을 포함한 출력 한도를 384k로 제한합니다. 입력이 900k를 넘는다면 약 100k 정도의 여유를 남겨두는 편이 안전합니다.
첫 요청에서 막히기 쉬운 Together AI의 세 가지 제약
1. 스트리밍하지 않으면 streaming_required 오류가 납니다. Together AI는 스트리밍 요청만 받습니다(출시 글). 스트리밍을 끄면 HTTP 400이 반환됩니다. "stream": true 또는 stream=True를 지정하세요.
2. 사고 모드가 기본 활성화되고 출력 비용으로 청구됩니다. 스트림에서는 delta.reasoning과 delta.content가 분리됩니다(출시 글). 단순 추출 작업처럼 비용을 아끼고 싶다면 사고 모드를 끌 수 있습니다.
response = client.chat.completions.create(
    model="Qwen/Qwen4-Max",
    messages=messages,
    stream=True,
    reasoning={"enabled": False},
)
"reasoning_effort": "max"를 지정하면 더 어려운 작업에서 추론 강도를 높일 수 있습니다(출시 글).
3. 서버리스 전용이며 캐시는 보장되지 않습니다. 프롬프트에 비밀 정보를 넣지 마세요. 파인튜닝이나 전용 엔드포인트는 제공되지 않습니다(출시 글). 캐싱은 자동으로 처리되지만 최선 노력 방식입니다. 예제는 git ls-files로 추적 중인 모든 파일을 나열합니다(출시 글). 전체 저장소를 전송하기 전에는 비밀 정보부터 제거해야 합니다.
Together AI, QwenCloud, OpenRouter 중 어디에서 호출할까
| 제공업체 | 입력 / 1M | 출력 / 1M | 캐시 읽기 / 1M | 비고 |
|---|---|---|---|---|
| Together AI 프로모션 | $1.05 | $3.15 | $0.0525 | 11월 22일까지; Qwen/Qwen4-Max, 서버리스 전용, 스트리밍 전용 |
| Together AI 정가 | $1.50 | $4.50 | $0.075 | 프로모션 이후에도 같은 엔드포인트 사용 |
| QwenCloud | $1.50 | $4.50 | $0.075 | 인용된 싱가포르 요금 기준의 Qwen 직접 경로 |
| OpenRouter(Ailyre / CloudTweaks 경유) | $1.425 | $4.275 | 약 $0.071 | 글로벌 라우팅; 11월 20~22일 스냅샷 |
| Deep Infra / Novita AI(Sovyron 경유) | $1.413 | $4.24 | 약 $0.071 | Sovyron 11월 17일 스냅샷에서 프로모션이 아닌 요금 중 최저 |
| Vercel AI Gateway | $1.50 | $4.50 | 읽기 $0.08 / 쓰기 $1.88 | 보고된 스냅샷: 지연 시간 3.3초, 52 tok/s, 캐시 적중률 93%; $5 크레딧 |
프로모션 기간에는 반복 프롬프트를 Together AI로 처리하는 것이 가장 저렴합니다. 프로모션이 끝난 뒤에는 인용된 스냅샷 기준으로 Deep Infra나 Novita AI가 가장 저렴한 비프로모션 선택지에 속하고, OpenRouter와 Vercel은 라우팅 및 도구 기능을 위해 소폭의 추가 비용을 받습니다.
Together AI에서 스트리밍 요청 시작하기
curl -X POST "https://api.together.ai/v1/chat/completions" \
  -H "Authorization: Bearer $TOGETHER_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "Qwen/Qwen4-Max", "messages": [{"role": "user", "content": "Hi"}], "stream": true}'from together import Together
client = Together()
response = client.chat.completions.create(
model="Qwen/Qwen4-Max",
messages=[{"role": "user", "content": "Explain this diff in 3 bullets."}],
stream=True,
)
for chunk in response:
print(chunk.choices[0].delta.content or "", end="")전체 저장소를 넘길 때는 시스템 메시지에 === FILE: path === 형식으로 저장소 파일을 넣고, 사용자 메시지에 버그 리포트를 담은 뒤 패치를 스트리밍하면 됩니다(출시 글).
Qwen4 Max를 Together AI로 라우팅해야 할까
| 작업 | 이번 주 추천 경로 | 이유 |
|---|---|---|
| 전체 저장소 분류(입력 300~650k) | Together AI 프로모션 | $0.69 수준의 실행 비용; 검색 파이프라인 불필요 |
| 같은 코드베이스를 반복 처리 | Together AI(어느 가격 구간이든) | 반복 요청 비용이 약 $0.66에서 약 $0.03으로 감소; TTFT는 54초에서 8초로 단축 |
| 출력 중심의 추론 기록 | 검증된 출력 단가가 가장 낮은 경로; 품질을 유지할 수 있다면 추론 비활성화 | 사고 토큰은 출력으로 계산되어 $3.15~$4.50이 부과됨 |
| 지역에 민감한 작업 | 라우팅 전에 QwenCloud의 지역별 문서 확인 | Together AI에는 전용 엔드포인트나 파인튜닝이 없음 |
| 장애 대응 및 플레이그라운드 테스트 | OpenRouter / Vercel AI Gateway | 라우팅, 재시도, Vercel의 $5 크레딧 |
인용된 Tornado 테스트에서는 입력 650k의 콜드 프롬프트가 첫 토큰까지 54초 걸렸습니다. 따라서 대화형 IDE 작업보다는 배치 처리나 야간 분류에 더 잘 맞습니다. 캐시는 반복 요청에는 도움이 됐지만 첫 요청에는 적용되지 않았으므로, 최초 실행 시간과 비용을 별도로 고려해야 합니다.
FAQ
Together AI의 정확한 모델 ID는 무엇인가요?
https://api.together.ai/v1/chat/completions에서 사용하는 모델 ID는 Qwen/Qwen4-Max입니다.
Together AI에서 Qwen4 Max를 파인튜닝할 수 있나요?
아니요. 게시 시점 기준으로 서버리스 전용이며 파인튜닝이나 전용 엔드포인트는 제공되지 않습니다(출시 글).
Together AI의 프로모션 가격은 언제 끝나나요?
2026년 11월 22일까지입니다. 정확한 종료 시각은 공개되지 않았으므로 대규모 작업 전에 모델 페이지를 확인하세요.
Together AI가 QwenCloud Singapore보다 저렴한가요?
프로모션 기간에는 그렇습니다($1.05/$3.15 대 $1.50/$4.50). 프로모션 이후에는 표시 가격이 같아지므로 캐시, 지연 시간, 라우팅을 기준으로 선택해야 합니다.