 AIREITER
Qwen-UI-Agent는 공개 비교 결과에서 모바일 에이전트 성능이 특히 두드러진다. 실제 기기 기반 MobileWorld-Real에서 92.2%, AndroidDaily에서 97.5%를 기록했다. 다만 이 수치의 주인공인 27B 모델은 공개 가중치나 API가 확인되지 않았다. 지금은 기술 보고서를 읽고 데모를 보거나, 이전 세대인 소형 MAI-UI 모델만 내려받을 수 있다. 리더보드 성과와 실제 이용 가능성 사이의 간극이 이번 공개를 이해하는 핵심이다. 아래에서 공식 점수를 모두 정리하고, 현재 손에 넣을 수 있는 자료를 정확히 확인해 본다.
Qwen-UI-Agent 공식 성적표 한눈에 보기
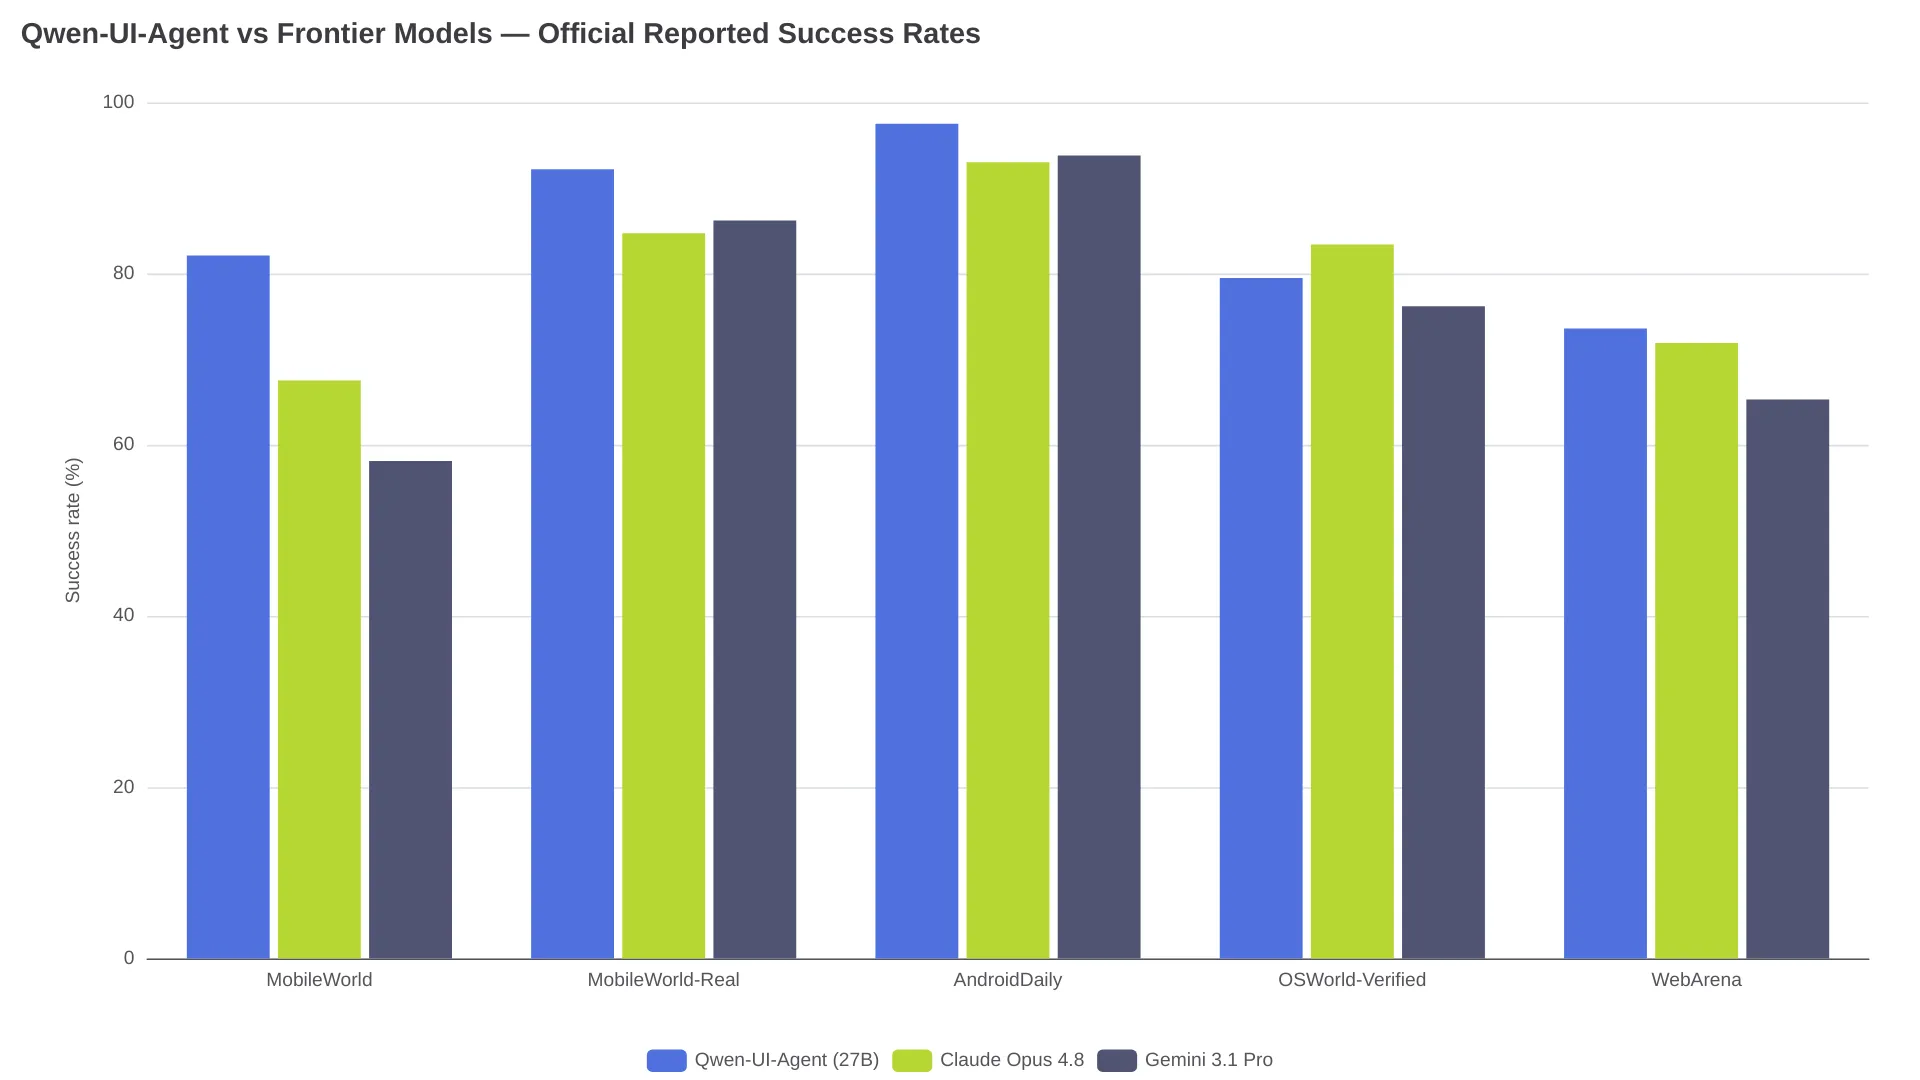
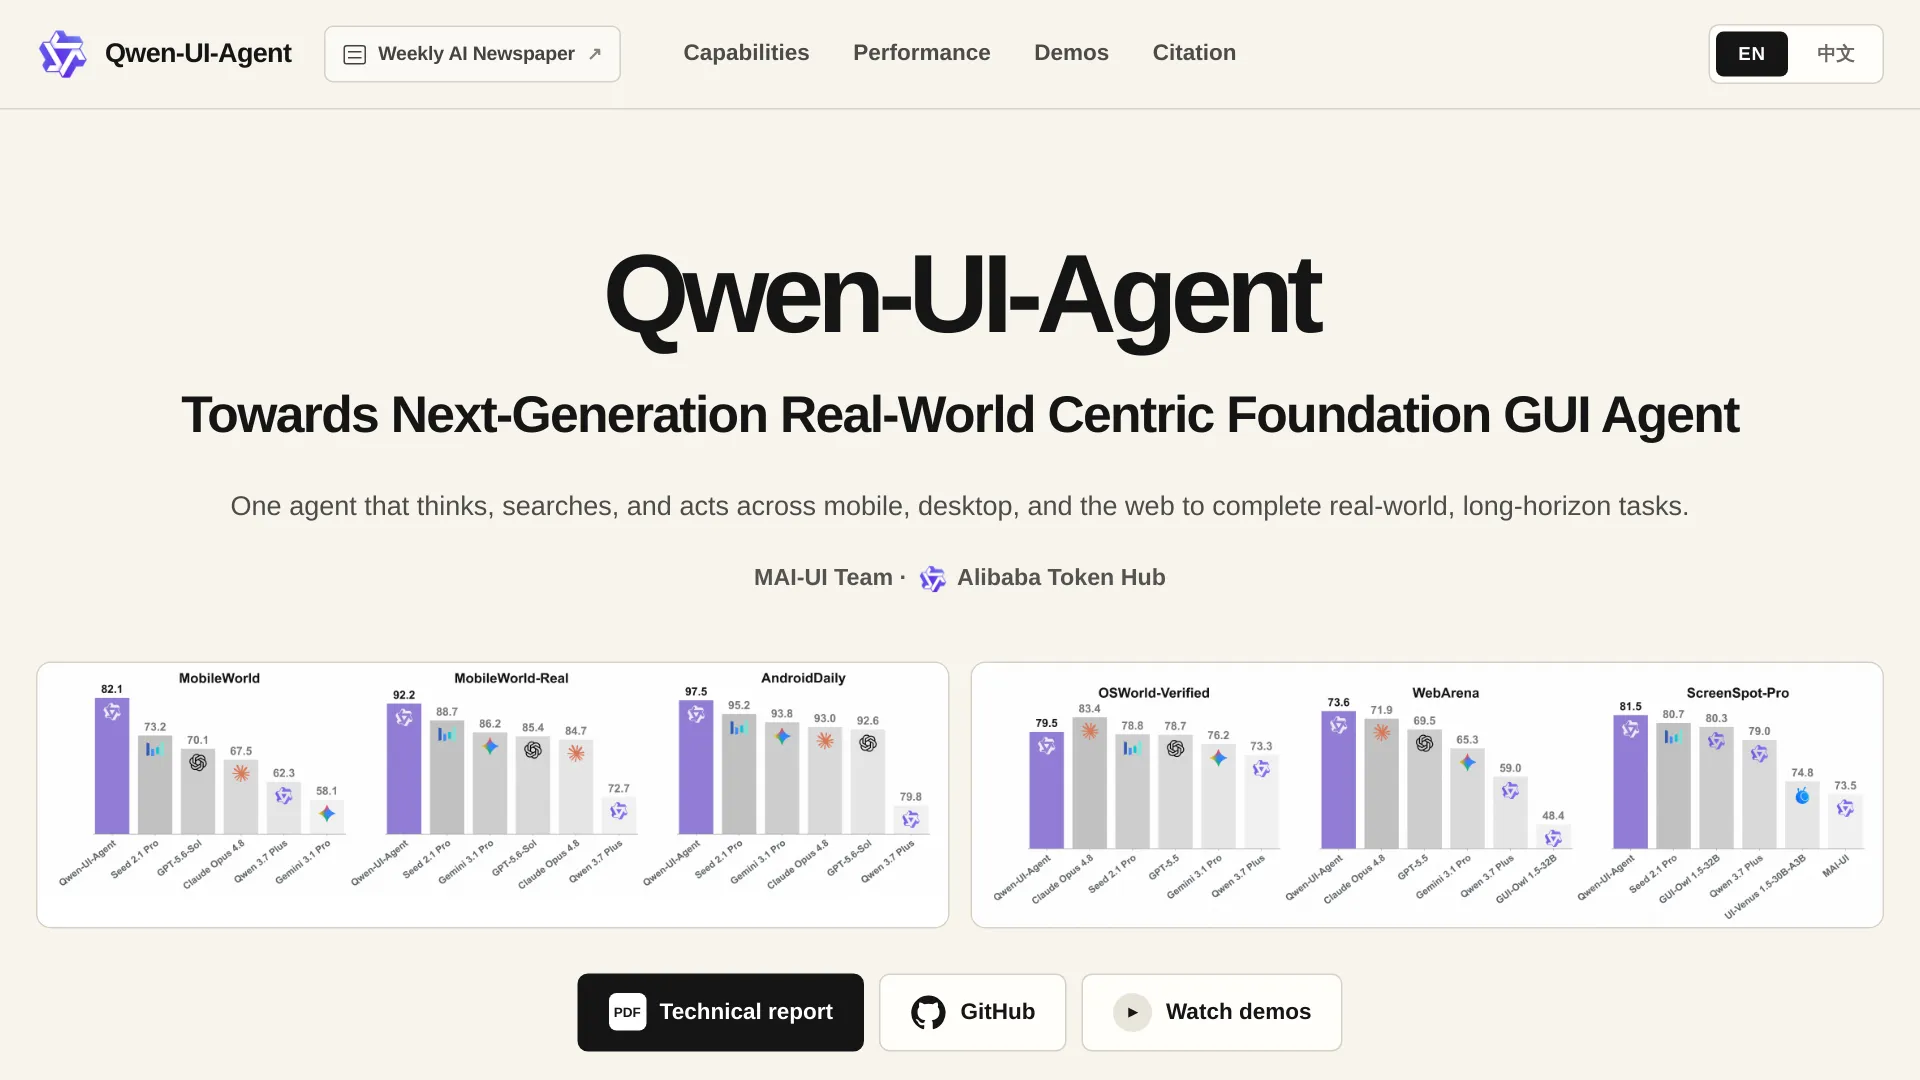
Qwen-UI-Agent는 Alibaba Tongyi-MAI 팀이 2026년 7월 30일 기술 보고서로 발표한 기반 GUI 에이전트다(arXiv 2607.28227). 하나의 모델이 모바일, 컴퓨터 사용, 웹, DeepSearch 환경을 아우르며 GUI 조작, CLI 실행, 배치형 액션 시퀀스를 통합 액션 공간으로 사용한다. 공식 결과 페이지 기준으로 Qwen-UI-Agent는 제시된 모든 모바일 및 그라운딩 벤치마크에서 선두를 차지했고, OSWorld-Verified에서는 2위, 장기 작업 평가인 OSWorld-v2에서는 3위다. 보고서는 27B, 35B-A3B, 4B 변형을 평가했으며, 아래 점수는 플래그십 27B 모델 기준이다.
모바일: 압도적인 선두를 주장하는 영역
보고서가 최신 최고 성능을 내세우는 곳은 모바일이며, 격차도 작지 않다. MobileWorld의 GUI 전용 분할에서 Qwen-UI-Agent는 82.1%를 기록했다. 차기 범용 모델인 Seed 2.1 Pro의 73.2%보다 8.9포인트 높고, 최고 성능의 특화 GUI 에이전트인 GUI-Owl-1.5-32B-Instruct의 43.9%와는 38.2포인트 차이다.
| 모델 | MobileWorld (GUI 전용) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
공식 표에서 모바일 행의 GPT 모델은 GPT-5.6 Sol(70.1 / 85.4 / 92.6)이며, 데스크톱 행에는 GPT-5.5를 사용했다. 단일 "GPT" 수치를 인용하기 전에는 이 차이를 알아둘 필요가 있다.
가장 주목할 벤치마크인 MobileWorld-Real은 저자들이 직접 만든 평가다. 7개 일상 사용 분야의 실제 Android 앱 104개를 대상으로, 실제 계정과 현실적인 방해 요인이 존재하는 라이브 기기에서 409개의 엔드투엔드 작업을 수행한다. 평가는 5개 VLM의 다수결 판정으로 이뤄진다.
컴퓨터 사용: 강력하지만 1위는 아니다
데스크톱 결과에서는 보고서의 "경쟁력 있는"이라는 표현을 조금 더 신중하게 볼 필요가 있다. Qwen-UI-Agent는 OSWorld-Verified에서 79.5%로 2위이며, Claude Opus 4.8보다 3.9포인트 낮다. 장기 작업 평가 OSWorld-v2의 40.0%는 부분 진행도 점수다. 이진 완료율은 13.9%이며, Claude Opus 4.8(54.8)과 GPT-5.5(49.5)는 모두 이보다 크게 앞선다.
| 모델 | OSWorld-Verified | OSWorld-v2 (부분 진행도) | OSWorld-v2 (이진) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | 보고되지 않음 |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | 보고되지 않음 | 보고되지 않음 |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | 보고되지 않음 | 22.3 | 보고되지 않음 |
효율성 측면의 장점은 분명하다. 배치 액션을 사용하면 작업당 평균 단계 수는 135.8회로, MiniMax M3의 326.7회와 Qwen 3.7 Plus의 173.5회보다 적다. 동시에 부분 진행도에서는 모든 공개 가중치 모델을 17포인트 이상 앞선다. OSWorld-v2에서 CLI 명령은 에이전트 전체 작업의 50%를 넘는다. GUI+CLI 하이브리드 설계가 이 평가에서 실질적으로 기여하고 있다는 뜻이다.
브라우저와 DeepSearch 성능
WebArena에서는 Qwen-UI-Agent가 73.6%로 Claude Opus 4.8(71.9), GPT-5.5(69.5), Gemini 3.1 Pro(65.3)를 앞섰다. 리서치 작업에서는 BrowseComp가 Qwen3.5-27B 베이스라인의 61.0 대비 64.1, BrowseComp-ZH가 62.1 대비 75.0을 기록했다. DeepSearch 학습 효과가 단순한 화면 클릭을 넘어 탐색 능력에도 이어진 것으로 보인다.
GUI 그라운딩: 전 항목 1위
시각적 지시를 보고 정확한 픽셀을 클릭하는 능력인 그라운딩에서는 완승이다. 공식 결과 페이지에 따르면 Qwen-UI-Agent는 제시된 모든 그라운딩 벤치마크에서 1위를 기록했다.
| 벤치마크 | Qwen-UI-Agent | 최고 경쟁 모델 |
|---|---|---|
| ScreenSpot-Pro (확대 없음) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (확대) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
범용성의 대가는 작다
GUI에 특화된 모델은 일반 언어 모델 능력을 잃는 경우가 많다. Qwen-UI-Agent는 대체로 그렇지 않다. MMLU-Pro는 Qwen3.5-27B의 86.0에 비해 86.5, IFEval은 90.4에 비해 90.2를 기록했다. 반면 특화 모델군과의 격차는 매우 크다.
| 벤치마크 | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | 보고되지 않음 | 보고되지 않음 | 보고되지 않음 |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
자체 베이스라인에 뒤진 것이 눈에 보이는 항목은 QwenClawBench 하나다(44.2 대 48.5). 또한 공식 페이지는 이 범용 역량 점수들이 저자들의 평가 환경에서 재현된 결과임을 명시한다.
Qwen-UI-Agent의 학습 방식
기술 보고서에 따르면 Qwen-UI-Agent의 학습 데이터는 실제 기기 플릿에서 수집된다. 150개 이상의 앱을 다루는 물리적 스마트폰 100대 이상이 에이전트 주도 데이터 플라이휠에 연결되며, 이 시스템은 자체적으로 작업을 구성하고 진단한다. 지도 미세 조정 뒤에는 100턴을 넘는 궤적을 대상으로 한 다단계 RL을 수행하고, 롤아웃은 10,000개가 넘는 동시 환경에서 진행된다.
이 성적표를 얼마나 신뢰해야 할까
공식 페이지에는 수치를 인용할 때 함께 언급해야 할 세 가지 주의점이 있다. 첫째, MobileWorld-Real은 저자들이 만든 자체 벤치마크다. 둘째, 단검 기호가 붙은 베이스라인 점수는 저자들이 자신들의 환경에서 재현한 결과다. 하네스, 판정기, 시뮬레이터, 작업 하위 집합이 각 벤더의 공식 평가와 다를 수 있다. 셋째, OSWorld-v2의 40.0%는 성공률이 아니라 부분 진행도다. (출처: 공식 결과 페이지의 주석 및 기술 보고서)
"Alibaba의 새 GUI 에이전트는 스마트폰에서는 이기지만 데스크톱에서는 주춤한다." - X의 @Daily_AI_Brief. 이 계정은 "Alibaba가 모든 베이스라인을 자체 환경에서 평가했다"는 점도 지적했다.
X의 독립적인 해석도 대체로 같은 결론에 도달했다. @itarutomy의 일본어 해설은 실제 기기 모바일 선두를 짚으면서도 데스크톱 성적은 2위라는 점을 강조했다. 공개 자체에 관한 1차 출처는 Tongyi Lab의 Pengxiang Li(@oliverlee1999)가 올린 공식 발표 스레드다. 정리하면 MobileWorld-Real은 독립 재현을 기다리는 강력한 주장으로 봐야 하며, 저자들이 새로 만든 벤치마크가 아닌 OSWorld-Verified가 더 이식성 높은 비교 기준이다.
지금 Qwen-UI-Agent에 접근하는 방법
현재 Qwen-UI-Agent는 논문, 프로젝트 페이지, 코드 리포지토리 형태의 연구 공개에 가깝다. 모델 자체의 공개 체크포인트는 확인되지 않았다. 공개된 각 자료에 무엇이 들어 있는지 살펴보자.
공개 자료별 구성
| 자료 | 링크 | 포함 내용 |
|---|---|---|
| 기술 보고서 | arxiv.org/abs/2607.28227 | 2026년 7월 30일 제출된 전체 논문, PDF, HTML, TeX 소스 |
| 프로젝트 페이지 | tongyi-mai.github.io/Qwen-UI-Agent | 기능 데모, 전체 벤치마크 차트, 인용 정보 |
| MAI-UI 리포지토리 | github.com/Tongyi-MAI/MAI-UI | Apache-2.0 리포지토리. Qwen-UI-Agent에 맞춰 제목이 변경됐으며, 2025년 12월 공개된 MAI-UI-8B 및 MAI-UI-2B Hugging Face 체크포인트로 연결 |
| Qwen-UI-Agent 리포지토리 | github.com/Tongyi-MAI/Qwen-UI-Agent | 웹사이트 소스만 포함. 리포지토리 설명에서 모델, 학습 코드, 에이전트 구현은 포함하지 않는다고 명시 |
MAI-UI 리포지토리가 공식 계보의 후속 거점이다. 2026년 7월 30일 Qwen-UI-Agent를 발표했으며, 현재 이 계열에서 내려받을 수 있는 유일한 체크포인트로 연결된다.
가중치 공개 현황
실제로 내려받을 수 있는 체크포인트는 2025년 12월의 이전 세대 모델인 MAI-UI-8B와 MAI-UI-2B뿐이다. MAI-UI 리포지토리의 Hugging Face 참조 링크에서 제공된다. Qwen-UI-Agent 27B, 35B-A3B, 4B 체크포인트는 공개가 확인되지 않았다. 여기의 제공 상태는 2026년 8월 말 공식 리포지토리와 프로젝트 페이지를 기준으로 확인했으며, 어느 곳에서도 공개 릴리스를 찾을 수 없었다. MAI-UI 체크포인트 링크나 웹사이트 소스 리포지토리를 Qwen-UI-Agent 모델 가중치로 오해해서는 안 된다.
API도 셀프 호스팅도 아직 없다
공식 채널에서는 공개 Qwen-UI-Agent API 엔드포인트, 호스팅 제품, vLLM/Ollama 패키지를 찾을 수 없다. 당장 배포해야 하는 데스크톱 워크플로라면 보고된 OSWorld 결과는 Claude Opus 4.8 쪽을 지지한다. 공개 가중치 GUI 실험이 목적이라면 MAI-UI 2B/8B와 자체 하네스를 조합하는 것이 현재 가능한 경로다. 단, 이는 Qwen-UI-Agent가 아니라 MAI-UI다. 출시 소식은 공식 Tongyi-MAI 리포지토리와 Qwen 채널을 확인하는 것이 좋다. API를 사용할 수 있는 범용 Qwen 계열은 AIReiter Qwen model catalog에서 현재 엔드포인트와 가격을 추적한다.
Qwen GUI 에이전트 계보에서의 위치
Qwen-UI-Agent는 Alibaba GUI 에이전트 계열의 3세대다. UI-TARS는 2025년 Qwen 기반 GUI 접근법을 개척했고, MAI-UI(arXiv 2512.22047, 2025년 12월)는 현실 중심 데이터 플라이휠을 도입하면서 2B/8B 가중치를 오픈소스로 공개했다. Qwen-UI-Agent는 이 방식을 27B 규모로 확장하고 GUI+CLI 하이브리드 실행을 적용했다. 위 표의 두 OSWorld 지표에서는 Claude Opus 4.8이 모두 선두다.
Qwen-UI-Agent FAQ
Qwen-UI-Agent는 오픈소스인가?
코드 리포지토리는 Apache-2.0 라이선스이며 보고서도 공개돼 있지만, 모델 자체가 공개 가중치라는 확인은 없다. 내려받을 수 있는 것은 이전 세대 MAI-UI-8B 및 MAI-UI-2B 체크포인트뿐이다(Hugging Face, 2025년 12월). 이 글 작성 시점까지 27B, 35B-A3B, 4B Qwen-UI-Agent 체크포인트의 공개 릴리스는 확인되지 않았다.
지금 Qwen-UI-Agent를 로컬에서 실행할 수 있나?
아니다. 검증된 로컬 실행 구성은 없다. 체크포인트, GGUF 또는 Ollama 패키지, vLLM 레시피 모두 제공되지 않는다. 로컬 실험은 자체 하네스를 구성한 MAI-UI 2B/8B로 제한된다.
Qwen-UI-Agent API가 있나?
공개 엔드포인트나 호스팅 제품은 발표되지 않았다. 출시 공지는 공식 Tongyi-MAI GitHub 리포지토리와 Qwen 팀 채널에서 확인해야 한다.
컴퓨터 사용에서 Qwen-UI-Agent와 Claude Opus 4.8은 어떻게 비교되나?
Claude Opus 4.8은 OSWorld-Verified에서 83.4 대 79.5, OSWorld-v2 부분 진행도에서 54.8 대 40.0으로 앞선다. 반면 Qwen-UI-Agent는 WebArena에서 73.6 대 71.9로 앞서며, 제시된 모든 모바일 벤치마크에서도 선두다. 현재 장기 데스크톱 작업은 Claude 쪽이 유리하고, 모바일 우선 작업은 Qwen-UI-Agent의 보고 수치가 가장 강한 영역이다.
MobileWorld-Real이란 무엇인가?
Qwen-UI-Agent 저자들이 만든 실제 기기 Android 벤치마크다. 7개 일상 사용 분야의 라이브 앱 104개에서 409개 작업을 수행하며, 5개 VLM의 다수결 판정으로 채점한다. 결과는 자체 보고된 것이며 독립 재현을 기다리고 있다.
판단을 바꿀 수 있는 신호들
다음 세 가지 신호가 나오면 이 평가를 실질적으로 바꿀 수 있다.
| 신호 | 중요한 이유 |
|---|---|
| Tongyi-MAI Hugging Face 계정에서 Qwen-UI-Agent 체크포인트 공개 | 연구 공개가 직접 구축 가능한 선택지로 전환되고, 제3자 성능 수치가 나오기 시작한다 |
| Alibaba 하네스 외부에서 이뤄진 OSWorld-Verified 재현 | 79.5%가 저자들의 환경 밖에서도 유지되는지 확인할 수 있다 |
| API, Qwen 앱 통합 또는 프리뷰 등 제품 형태의 제공 | 논문 표의 비교가 실제 운영 환경의 선택지 비교로 옮겨간다 |
그때까지는 해결되지 않은 균형점이 남는다. 지금까지 발표된 비교에서 모바일 사용 성능의 선두는 같은 팀이 만든 벤치마크에서 나온 자체 보고 결과다.
관련 글: Alibaba의 최신 범용 플래그십과 공개 가중치 상태는 Qwen3.8-Max open weights에서, 엔드포인트 비용은 Qwen3.8-Max API pricing guide에서 다룹니다.