 AIREITER
2.4조 파라미터 모델이라고 해서 토큰마다 2.4조 개가 모두 동작하는 것은 아니다. 8월 12일 2026년, ModelScope에 공개된 Qwen3.8-2.4T-A95B는 토큰당 활성 파라미터가 95B인 MoE 모델이다. 다만 4비트 양자화를 해도 웨이트만 약 1.2TB의 VRAM을 차지한다. 데이터센터 밖에서 로컬 구동하기는 사실상 어렵다는 뜻이다. 이번 공개에 포함된 내용과 실제 이용 비용, API가 현실적인 선택이 되는 이유를 정리했다.
Qwen3.8-2.4T-A95B, 첫 Qwen-Max 오픈 웨이트로 공개
웨이트는 이미 공개됐다. Alibaba Qwen 팀은 8월 12일 늦게 커뮤니티 ModelScope 계정을 통해 Qwen3.8-2.4T-A95B 체크포인트를 배포했다. Qwen-Max 계열에서 오픈 웨이트로 나온 첫 모델이다. 앞선 Qwen3.5-Max, Qwen3.6-Max, Qwen3.7-Max는 모두 API로만 제공됐다.
먼저 이름부터 구분할 필요가 있다. "Qwen3.8"이라는 이름은 두 가지를 가리킨다.
| 이름 | 정체 | 이용 경로 |
|---|---|---|
| Qwen3.8-2.4T-A95B | 오픈 웨이트 기반 모델 | ModelScope(다운로드 가능한 체크포인트) |
| Qwen3.8-Max | 추가 프로덕션 기능을 갖춘 클라우드 호스팅 버전 | Alibaba Token Plan, Qoder, QoderWork |
Qwen3.8-Max는 오픈 웨이트 A95B 모델을 기반으로 하지만, 추가적인 포스트 트레이닝이 적용됐다. Alibaba는 실제 환경 스케일링, 통합 보상 신호, 온라인 데이터 밸런싱의 3단계 시스템이라고 설명한다. 공개된 웨이트로 얻는 것은 기반 모델이며, Max의 전체 프로덕션 스택은 아니다.
웨이트가 "공개 예정이지만 아직 사용할 수 없다"고 설명한 가이드는 이제 최신 정보가 아니다. Alibaba가 예고한 "8월 10일이 포함된 주" 일정 안에 배포가 이뤄졌다.
확정 사양: 활성 95B, 네이티브 컨텍스트 256K
7월 19일 프리뷰 공개 후 몇 주 동안 가장 많이 요청된 미공개 사양은 활성 파라미터 수였다. 여러 서드파티 가이드도 이를 "공개되지 않음"으로 표기했다. 이제 확인됐다. 총 2.4조 파라미터 가운데 토큰당 활성화되는 파라미터는 95B다.
| 사양 | 확인된 값 |
|---|---|
| 총 파라미터 | 2.4T |
| 토큰당 활성 파라미터 | 95B |
| 아키텍처 | MoE(Qwen3.5의 하이브리드 설계 계승) |
| MoE 레이어당 전문가 수 | 512 |
| 토큰당 라우팅 전문가 수 | 10 |
| 토큰당 공유 전문가 수 | 1 |
| 네이티브 컨텍스트 윈도우 | 262,144 tokens (256K) |
| 확장 가능 컨텍스트 | 1,010,000 tokens (1.01M) |
| 학습 방식 | Multi-Token Prediction (MTP) |
| 첫 오픈 웨이트 Qwen-Max 릴리스 | 예(8월 12일, 2026년) |
두 가지는 특히 짚어볼 만하다. 우선 네이티브 컨텍스트 윈도우는 널리 알려졌던 100만 토큰이 아니라 256K다. 1.01M은 확장 모드의 수치이며, Alibaba는 이 모드의 품질 트레이드오프를 아직 설명하지 않았다. 또 MoE 라우팅은 매우 희소하다. 토큰마다 512개 전문가 중 11개만 활성화된다. 라우팅 전문가 10개와 공유 전문가 1개다. 2.4T 중 95B, 약 4%만 활성화되는 구조가 전체 모델 규모가 2.4T임에도 $2/M 입력 가격을 가능하게 하는 배경이다.
MTP(Multi-Token Prediction) 학습은 호환되는 추론 엔진에서 한 번의 포워드 패스로 여러 토큰을 예측할 수 있다는 의미다. 처리량 향상 가능성은 있지만, Alibaba는 지원 엔진을 구체적으로 밝히지 않았다.
셀프 호스팅의 현실: 2.4T 모델을 올리려면
사양은 인상적이지만, 실제로 메모리에 올리려면 계산이 달라진다.
2.4조 파라미터는 4비트 양자화 기준으로 약 1.2TB의 저장 공간을 쓴다. KV 캐시, 활성화 메모리, 런타임 오버헤드는 포함하지 않은 수치다. NVIDIA H200 GPU의 메모리는 141GB다. H200 8장을 합쳐도 1,128GB에 그쳐 웨이트를 올리고 의미 있는 컨텍스트 윈도우까지 서비스하기에는 부족하다.
| 배포 시나리오 | 필요 VRAM(추정) | 하드웨어 | 현실성 |
|---|---|---|---|
| 풀 프리시전(16비트) | ~4.8 TB | H200 GPU 34장 이상 | 데이터센터 전용 |
| 4비트 양자화 | ~1.2 TB | H200 GPU 9장 이상 | 데이터센터 전용 |
| 1.5비트 양자화 | ~450 GB | H200 GPU 4장 이상 | 여유가 거의 없고 품질 저하 불확실 |
| Qwen3.8-27B(대안) | 4비트에서 ~27 GB | 소비자용 GPU 1장 | 가능 |
활성 파라미터 95B라는 점은 토큰당 추론 처리량에는 도움이 된다. 매 포워드 패스에서 일부 전문가만 거치기 때문이다. 하지만 512개 전문가 네트워크 전체를 저장하는 데 필요한 메모리까지 줄여주지는 않는다. GEO Toolbox의 표현처럼, "희소 활성화는 대규모 운영 비용을 낮출 뿐, 소유 비용을 낮추지는 않는다."
로컬 또는 단일 서버 배포라면 Qwen3.8-27B variant가 현실적인 선택지다. Qwen3.8 계열의 학습 계보를 공유하면서도 4비트 기준 소비자용 GPU 한 장에 들어간다. 2.4T 모델은 연구 및 데이터센터를 위한 모델에 가깝다.
대부분의 팀에는 API가 더 합리적이다
2.4T MoE 모델을 자체 호스팅하는 일은 거의 모든 팀의 범위를 벗어난다. 실질적인 접근 경로는 API다. Alibaba Model Studio에서 Qwen3.8 Max는 입력 100만 토큰당 $2, 출력 100만 토큰당 $6로 책정됐다. 전작과 가장 가까운 중국 경쟁 모델보다 모두 저렴하다.
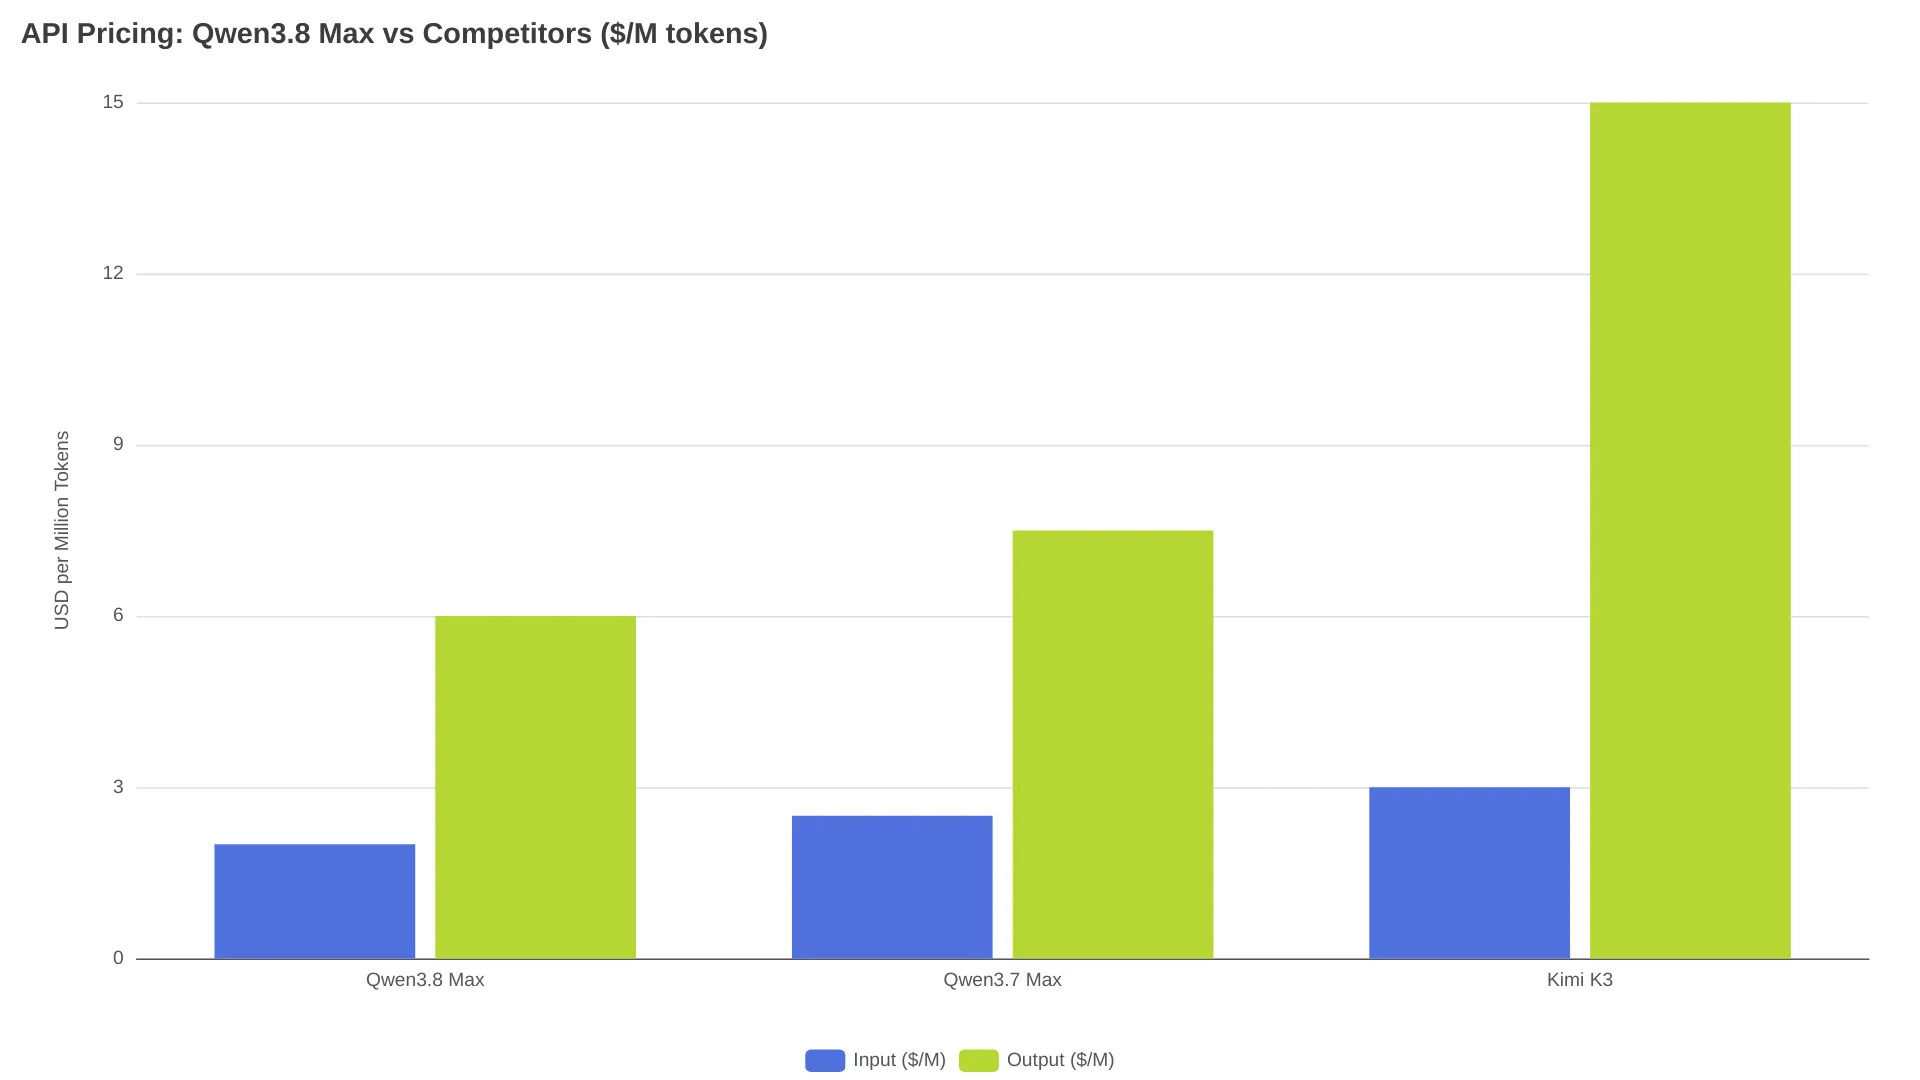
| 모델 | 입력($/M) | 출력($/M) | 컨텍스트 |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K 네이티브(1.01M 확장 가능) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
토큰 단위 API 외에 Alibaba는 세 가지 구독 요금제도 제공한다.
- Lite: 월 $6(~10,000 credits)
- Standard: 월 $18(~40,000 credits)
- Pro: 월 $68(~160,000 credits)
Token Plan 엔드포인트는 OpenAI 호환 및 Anthropic 호환 API 형식을 모두 지원한다. 따라서 Claude Code, Cursor, OpenCode 같은 도구를 클라이언트 측 변경 없이 쓸 수 있다. Alibaba의 코딩 제품 Qoder는 비혼잡 시간대(14:00-00:00 UTC)에 표준 대비 최저 0.01x의 프로모션 크레딧 요금을 제공한다. 다만 이는 출시 할인일 뿐, 지속적인 가격으로 볼 수는 없다.
구독 모델에는 분명한 주의점도 있다. Qwen3.8 Max의 추론 모드는 출력이 길어지는 경향이 있고, 크레딧이 빠르게 소진된다는 커뮤니티 보고도 일관적이다.
"Qwen은 생각을 정말 과하게 많이 하는 경향이 있다." - u/darko, r/Qwen_AI
같은 Reddit thread에서 Lite 구독자 한 명은 약 5,000만 토큰 사용으로 주간 할당량을 이틀도 되기 전에 소진했다고 전했다. Pro 요금제 사용자는 캐시 히트율 94% 상태에서 병렬 에이전트 7개를 돌려 하루 만에 5억 토큰을 썼다고 설명했다. reasoning_effort 파라미터는 low, medium, xhigh로 설정할 수 있으며, 모델이 생성하는 추론 출력량과 크레딧 소진 속도를 직접 좌우한다. 한 사용자의 테스트에서는 이를 low로 설정했을 때 요청당 사고 시간이 약 10초까지 줄었다.
비용을 더 자세히 확인하려면 Qwen3.8 Max API pricing guide를 참고하면 된다.
벤치마크 성적: 강점과 한계가 뚜렷하다
Alibaba는 Qwen3.8 Max를 Fable 5, GPT-5.6 Sol과 비교한 벤치마크 수치를 공개했다. 결과는 엇갈린다. 특히 벤더 발표 수치와 독립 평가 수치의 격차가 작지 않다.
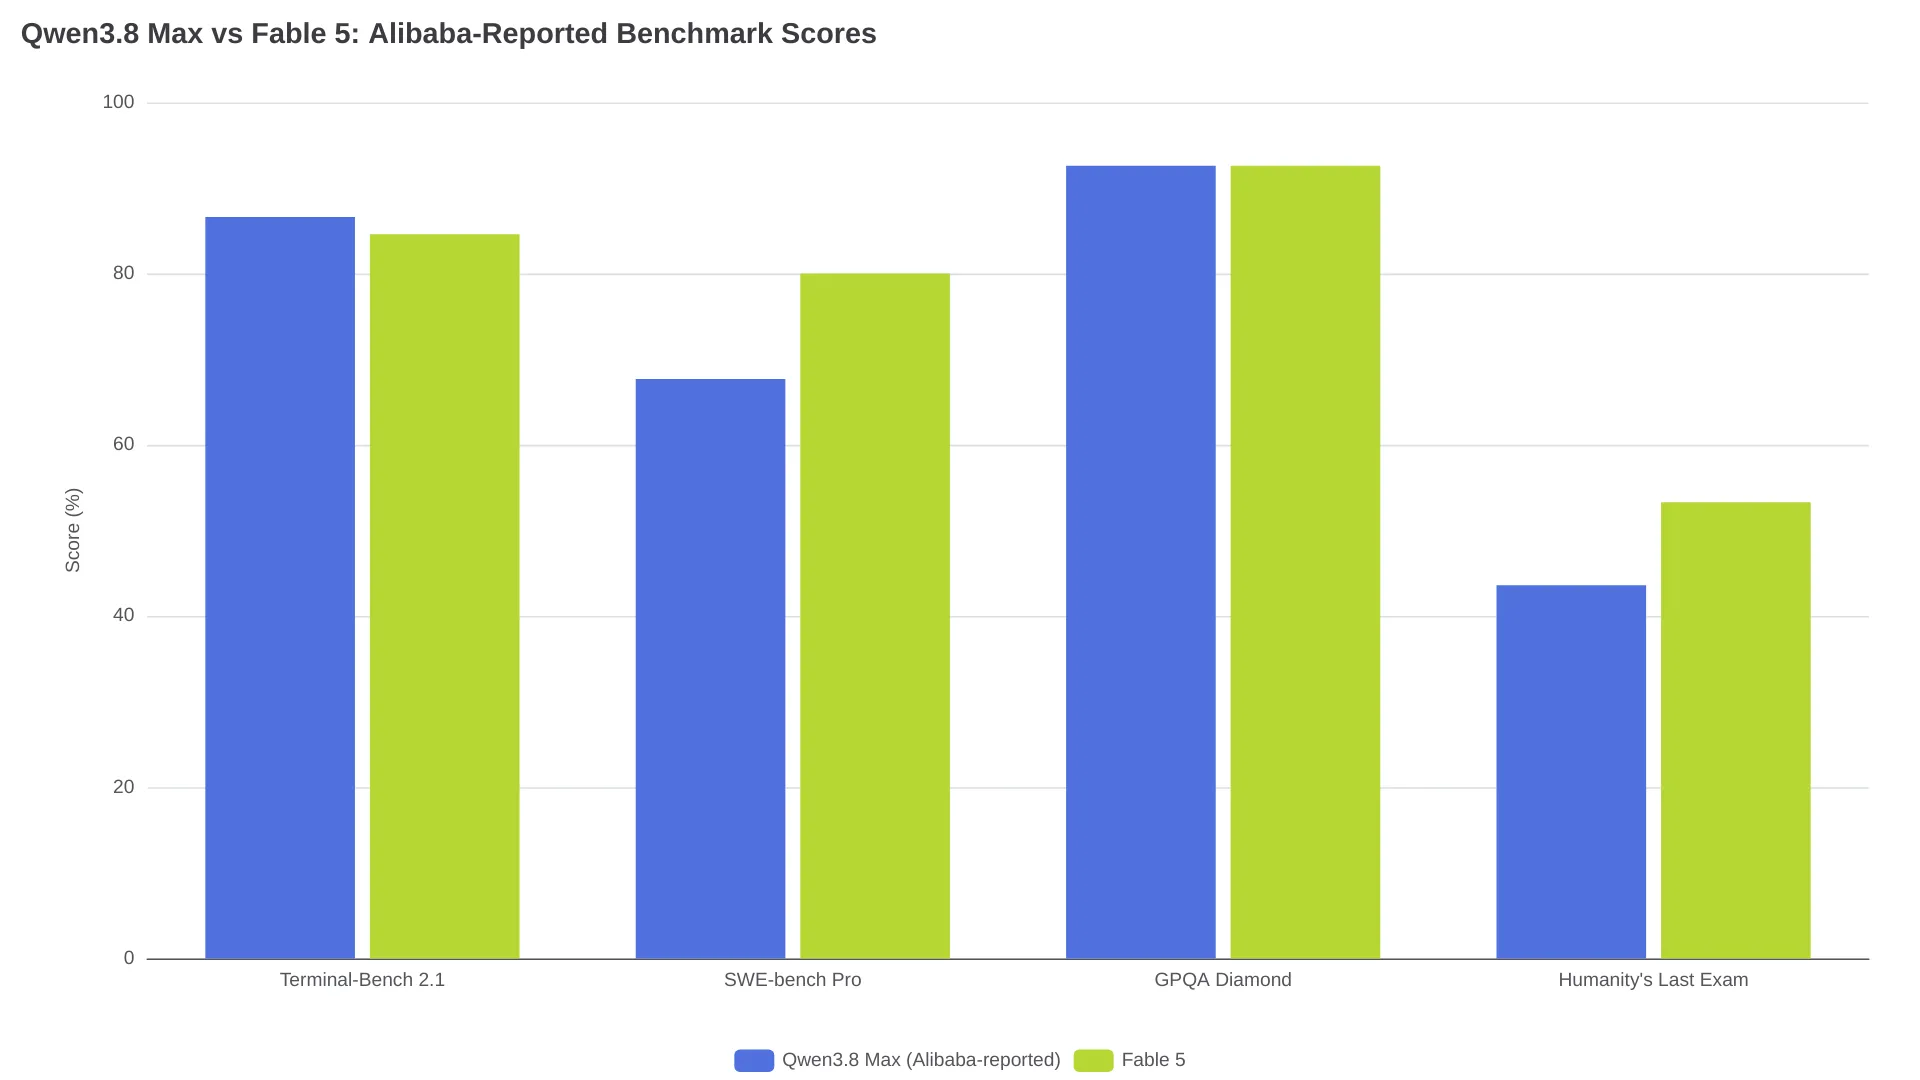
| 벤치마크 | Qwen3.8 Max(Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Qwen보다 높음(정확한 점수 미공개) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Qwen보다 높음 |
| Humanity's Last Exam | 43.6 | 53.3 | 미공개 |
독립 평가는 다른 모습을 보인다. Artificial Analysis는 Qwen3.8 Max의 Terminal-Bench 2.1 점수를 81.3%로 측정했다. Alibaba 발표치 86.6%보다 5.3포인트 낮다. 이 독립 평가 점수 기준으로 Qwen은 전체 약 10위이며, Fable 5(84.6%)와 Kimi K3(85.0%)에 뒤처진다.
Qwen3.8 Max가 우위를 보이는 영역도 있다. SWE-bench Pro 67.7%는 GPT-5.6 Sol의 64.6%를 앞섰고, 멀티모달 점수도 강하다. MathVision은 Fable 5의 92.7 대비 95.2, LogicVista는 85.7 대비 91.9다. DeepSWE 1.1에서는 Qwen3.7 Max 대비 21.6에서 56.6으로 크게 올랐는데, 소프트웨어 엔지니어링 에이전트 작업에서 실질적인 개선이 있었음을 시사한다.
커뮤니티 반응도 이 양면성을 닮았다. 과도한 추론을 지적한 동일한 Reddit 스레드에는 다음 같은 평가도 있었다.
"그래도 결과물은 신의 경지였다." - u/TangerineLogical9779, r/Qwen_AI
속도는 부하와 시간대에 따라 초당 8 tokens에서 60 tokens까지 오가는 것으로 알려져 안정적이지 않다. Kimi K3와의 정면 비교는 Qwen3.8 Max vs Kimi K3 comparison에서 확인할 수 있다.
FAQ
Qwen3.8-Max 웨이트를 다운로드할 수 있나?
그렇다. Alibaba는 8월 12일 2026년 ModelScope에 Qwen3.8-2.4T-A95B 체크포인트를 공개했다. 오픈 웨이트가 제공되는 첫 Qwen-Max 계열 모델이다. 클라우드 호스팅 버전인 Qwen3.8-Max에는 이 기반 모델 위로 추가 프로덕션 기능이 적용돼 있다.
공개 웨이트의 라이선스는 무엇인가?
작성 시점 기준 정확한 라이선스는 확인되지 않았다. Qwen3.6이 Apache 2.0으로 배포된 전례를 보면 Apache 2.0일 가능성이 있지만, Qwen3.7 Max는 비공개로 유지됐다. 상업적 용도로 사용하기 전에는 ModelScope 저장소의 실제 라이선스 파일을 확인해야 한다.
Qwen3.8-2.4T-A95B와 Qwen3.8-Max는 어떻게 다른가?
Qwen3.8-2.4T-A95B는 2.4T 파라미터, 활성 95B, MoE 아키텍처, 256K 네이티브 컨텍스트를 갖춘 오픈 웨이트 기반 모델이다. Qwen3.8-Max는 이 모델을 토대로 Alibaba가 클라우드에서 제공하는 버전으로, 통합 보상 시스템과 온라인 데이터 밸런싱 등을 포함한 프로덕션 환경 포스트 트레이닝이 더해졌다. 오픈 웨이트는 기반 모델을, API는 강화된 버전을 제공한다.
Qwen3.8-Max를 로컬에서 실행할 수 있나?
현실적으로 어렵다. 4비트 양자화에서도 이 모델은 약 1.2TB의 VRAM을 요구한다. 웨이트만 올리는 데 H200 GPU가 9장 이상 필요하며 컨텍스트 캐시를 위한 공간은 남지 않는다. 1.5비트 양자화에서도 수백 GB가 필요하다. Qwen3.8-27B variant가 소비자용 GPU 한 장에 들어가는 현실적인 로컬 대안이다.
Qwen3.8 Max API 가격은 얼마인가?
Model Studio API 가격은 입력 100만 토큰당 $2, 출력 100만 토큰당 $6다. 구독 요금제는 Lite 월 $6부터 Pro 월 $68까지다. Qoder는 비혼잡 시간대에 최대 98% 할인된 프로모션 크레딧을 제공하지만, 이는 출시 가격으로 변경될 수 있다.