 AIREITER
‘시네마틱한 영상’처럼 한 줄로 적는 프롬프트는 모델이 빈칸을 제멋대로 채우게 만든다. 카메라 지시를 빼면 고정 샷이 나올 수 있고, 사운드 필드를 비워 두면 원치 않은 대사나 음악이 끼어들기도 한다. MiniMax H3 프롬프트는 짧은 촬영 대본에 가깝다. 공식 가이드는 고정된 세 개의 필드, 샷 타임스탬프, 일관된 화자 ID, 별도의 두 가지 사운드 필드를 요구한다. 전체 스크립트는 약 7,000자 수준의 프롬프트 한도(제공업체별 상이)와 최대 15초 클립 길이 안에 들어와야 한다.
먼저 정할 것: H3 프롬프트 형식과 입력 모드
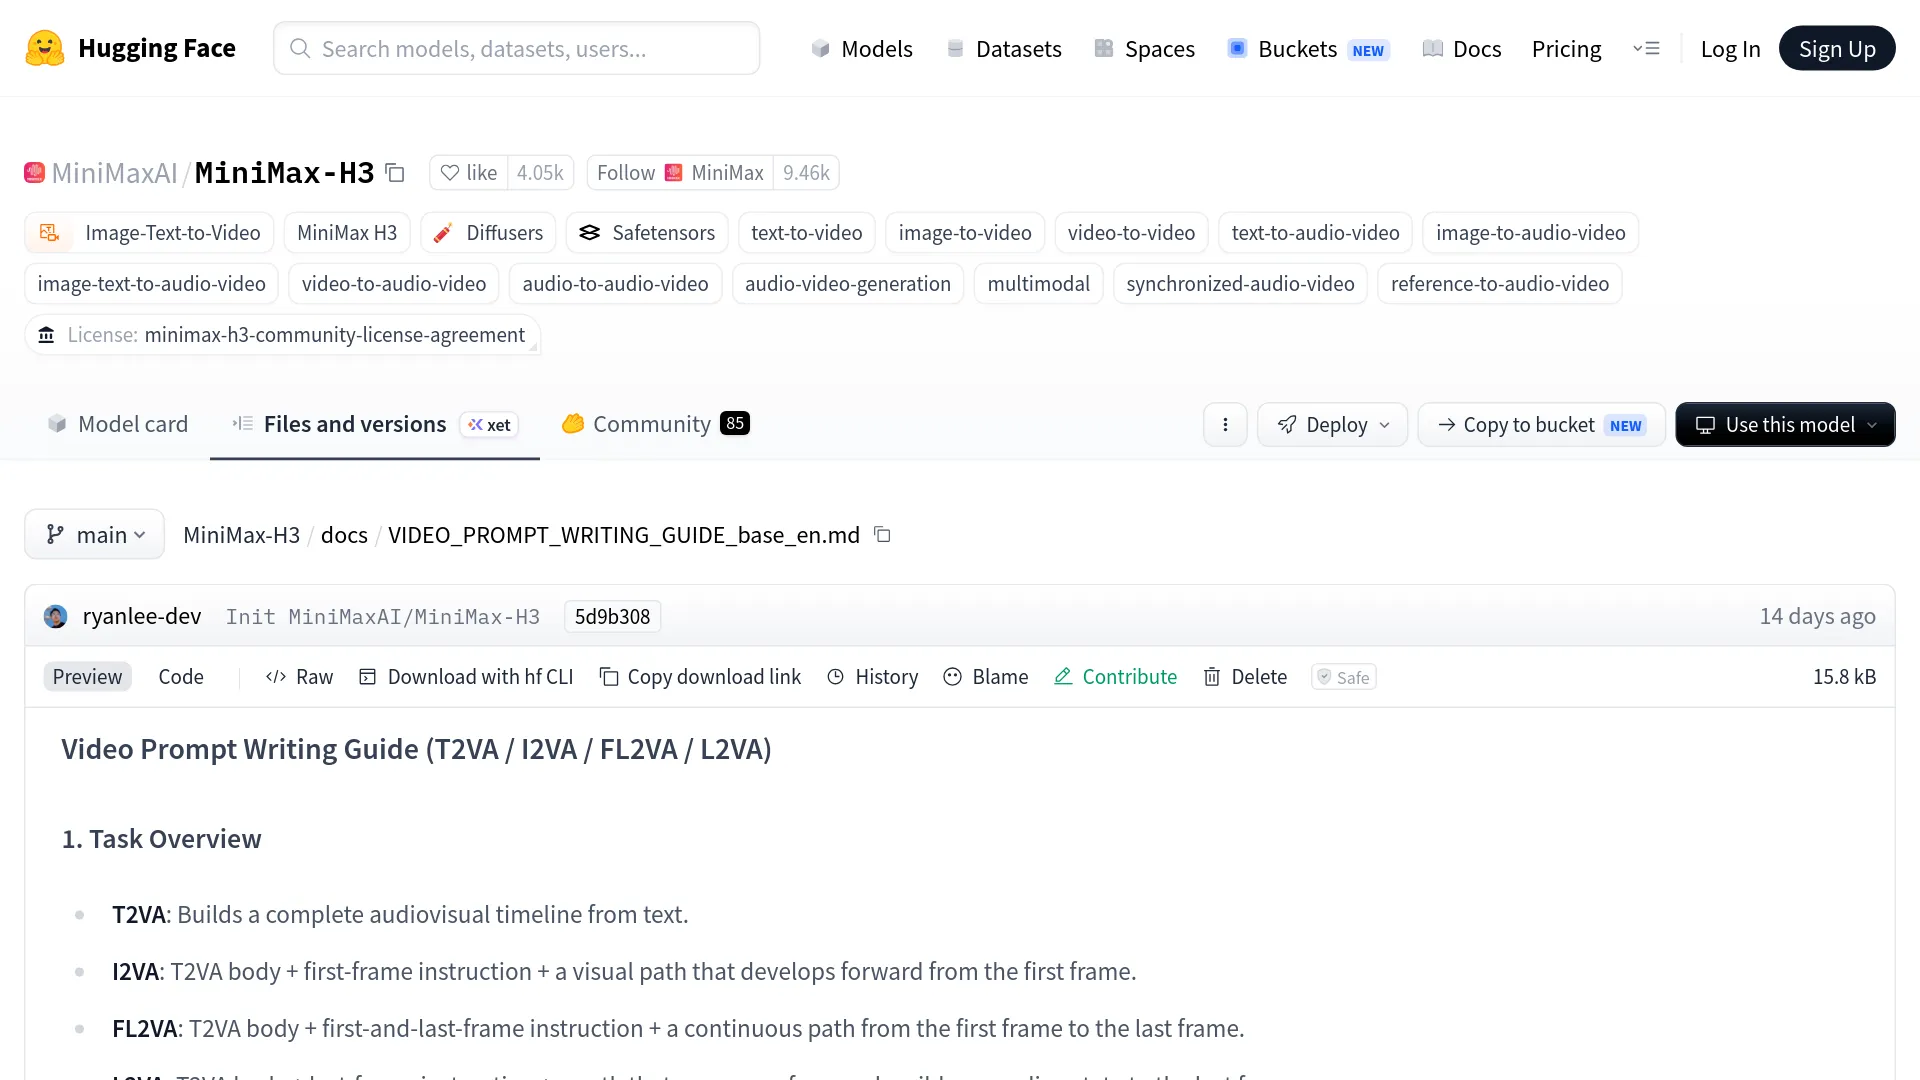
MiniMax는 Hugging Face의 MiniMax-H3 리포지터리에서 서로 다른 두 가지 프롬프트 작성 가이드를 제공한다. base guide는 업로드한 레퍼런스 없이 생성하는 네 가지 작업을 다루며, 이미지·영상·오디오 클립이 생성에 개입하는 순간부터는 reference guide를 사용한다. base guide의 네 가지 작업과 모드는 다음과 같다.
| 모드 | 입력 | 프롬프트에 필요한 정렬 지시문 |
|---|---|---|
| T2VA | 텍스트만 | 없음. 핵심 필드부터 바로 시작 |
| I2VA | 첫 프레임 이미지 1장 | "Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]" |
| FL2VA | 첫 프레임 + 마지막 프레임 | Picture 1은 0.00초, Picture 2는 정확한 종료 시점에 배치 |
| L2VA | 마지막 프레임 이미지 1장 | Picture 1을 영상 종료 시점 및 마지막 샷에 정렬 |
두 가이드 모두 완성된 예시로 끝나며, MiniMax 출시 글도 같은 접근을 설명한다. 메뉴에서 작업을 고르는 방식이 아니라 텍스트·이미지·영상·오디오 입력 간의 관계를 프롬프트로 표현하는 모델이다. 호스팅 엔드포인트에서는 이를 세 가지 워크플로로 단순화한다. fal에서는 minimax/h3/text-to-video, image-to-video, reference-to-video로 나뉘지만, 그 아래의 프롬프트 구조는 동일하다.
Base 프롬프트의 세 가지 필드
base 모드의 MiniMax H3 프롬프트는 정렬 지시문 뒤에 정확히 세 개의 필수 필드를 둔다. 각 필드 사이는 빈 줄로 구분한다.
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_description에는 시간 흐름을 담는다. 시각 스타일, 구도, 동작, 샷 전환, 화자, 대사, 다이에제틱 사운드처럼 화면에 보이거나 들리는 모든 요소가 여기 들어간다.overall_soundscape는 대사를 제외한 주변 환경음과 물리적 소리를 1~4문장, 하나의 문단으로 요약한다.non_diegetic_music는 등장인물에게 들리지 않는 배경음악을 1~3문장으로 적는다. 음악이 없다면N/A를 사용한다.
아래는 공식 가이드의 T2VA 사례를 바탕으로 재구성한 예시다. 해 뜨기 전 빵집을 배경으로 한다.
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
공식 규칙을 기준으로 각 요소가 제어하는 대상은 다음과 같다.
| 프롬프트 요소 | 제어 대상 | 규칙 |
|---|---|---|
[Shot 1] Live-action, cinematic. | 전체 스타일 | Shot 1은 스타일 레이블로 시작한다. 가이드에 제시된 예시는 일부만 보면 Cinematic, live-action, 2D-animated, 3D CG, claymation, watercolor, vintage film 등이 있다. |
A middle-aged baker (S1), grey apron, rolled sleeves | 화자 정체성 | 인물 특성을 ID보다 먼저 적고, ID는 모든 샷에서 유지한다. |
The camera pushes in with small amplitude at slow speed | 카메라 | 움직임 유형 + 진폭 + 속도를 자연스러운 동작 문장으로 작성한다. |
<d>[English] First batch of the day.</d> | 대사 | 언어 태그와 정확한 대사만 넣는다. 대사는 그대로 작성하며 번역하지 않는다. |
At 00:05.000, the camera cuts to... | 컷 시점 | 시간은 반드시 오름차순이어야 하며, [Shot 1] 자체에는 타임스탬프를 붙이지 않는다. |
<scenetrans> continuing seamlessly across the cut | 오디오 연속성 | 컷을 넘어 이어지는 대사를 표시하며, 이어지는 양쪽 지점에 모두 사용한다. |
샷 전환과 카메라 무브먼트 작성법
MiniMax H3의 샷 문법은 위치 규칙이 분명하다. [Shot 1]에는 타임스탬프를 붙이지 않고, 이후 샷은 모두 At 00:03.500,처럼 앞보다 큰 컷 시점으로 시작한다. 허용되는 컷 표현은 "the camera cuts to", "the shot transitions to", "the shot switches to"처럼 짧다. 크로스 디졸브, 페이드, 와이프는 필요할 때만 명시적으로 요청해야 한다. 프레이밍만 조금 바뀌는 정도라면 컷 대신 카메라 움직임을 쓰는 편이 맞다. 컷은 새로운 피사체, 공간, 상태 또는 시간 정보를 도입할 때 사용해야 한다는 것이 가이드의 원칙이다.
카메라 움직임은 자연스러운 영어 동작문으로 작성하며, 최대 세 가지 차원을 조합할 수 있다. 움직임 유형, 진폭, 속도다.
| 차원 | 허용 표현 |
|---|---|
| 움직임 유형 | Zoom In/Out, Push In/Pull Out, Pan Left/Right, Truck Left/Right, Tilt Up/Down, Pedestal Up/Down, Arc Shot, Tracking Shot, Static Shot, Shake Slightly/Strongly, POV, Roll Clockwise/Counterclockwise |
| 진폭 | "with small amplitude", "with large amplitude" |
| 속도 | "at slow speed", "at fast speed" |
중간 진폭과 보통 속도는 관례상 생략한다. 또 "Zoom In"과 "Push In"은 의도적으로 구분해야 한다. Zoom In은 카메라 위치를 고정한 채 초점거리를 바꾸는 움직임이고, Push In은 카메라가 실제로 앞으로 이동하는 움직임이다.
대사와 화자 ID 규칙
MiniMax H3 프롬프트에서 목소리를 내는 인물은 모두 고정 ID를 갖는다. (S1), (S2)를 쓰고, 동시 발화라면 (S1,S2)처럼 복합 ID를 사용한다. 같은 인물은 모든 샷에서 같은 ID를 유지해야 하며, 말을 하지 않는 인물에게는 ID를 붙이지 않는다. 화자가 처음 등장할 때는 생성 안정성을 위해 화면 안팎 여부, 연령대, 성별, 음성 높이, 음색, 말하는 속도, 억양 등 정체성 정보를 충분히 지정하는 것이 좋다.
한 줄의 정확한 문법은 아래와 같다.
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
대표적인 실패를 막는 문서화된 규칙은 네 가지다. 인물 정체성, 행동, 말투는 <d> 바깥에 두고, 태그 안에는 언어 태그와 정확한 대사만 넣는다. 문장부호도 그대로 유지한다. 내레이션은 반드시 "says in an off-screen voiceover"라는 문구를 사용하고, 바로 뒤에 화면 속 인물의 입이 다물려 있다는 설명을 붙인다. 컷을 넘는 대사에는 연결되는 양쪽 지점에 <scenetrans>를 넣고 "continues seamlessly across the cut" 또는 "carries over from the previous shot" 같은 연속성 문구를 쓴다. 영상 종료 시점에서 대사가 끊기면 <cutoff>를 사용한다.
따옴표에는 예약된 용도가 하나뿐이다. 배너, 간판, 라벨, 네온, 자막처럼 영상에 보이는 텍스트는 영어 큰따옴표 안에 원문 그대로 쓴다. 번역해서는 안 된다. 반대로 말하는 대사를 따옴표에 넣으면 H3가 음성이 아니라 번인 자막으로 렌더링할 수 있다. 이는 공식 문서에 명시된 원인이다.
사운드 필드는 두 개로 분리한다
MiniMax 출시 글에 따르면 H3의 오디오는 영상과 함께 생성되는 네이티브 스테레오 출력이다. 그래서 설명문 안에 막연한 형용사를 더하는 대신, 사운드를 위한 필드가 두 개로 분리돼 있다. overall_soundscape에는 바람, 비, 교통, 발소리, 옷감 마찰, 충격음, 호흡, 웃음 같은 주변음과 물리적 소리를 1~4문장으로 적는다. 완전한 무음을 명시적으로 요청할 때만 N/A를 쓴다. non_diegetic_music는 등장인물이 들을 수 없는 스코어를 위한 필드다. 악기 구성, 속도, 리듬, 다이내믹 변화를 설명하며, "epic", "emotional" 같은 추상적 분위기 단어는 명시적으로 권장되지 않는다. 음악을 원하지 않으면 정확한 값은 N/A다.
노래, 장면 안의 라디오, 거리 음악가처럼 다이에제틱 오디오는 어느 필드에도 넣지 않는다. 타임라인을 다루는 integrated_multimodal_description에 적어야 한다. 이 구분은 형식적인 문제가 아니다. APIMODELS 사용 가이드는 안정적인 결과를 위해 명시적인 사운드 제약이 필요하다고 설명한다. non_diegetic_music를 비워 두면 요청하지 않은 음악이 들어올 수 있다.
레퍼런스 프롬프트: 레이블과 유지 설정
업로드한 에셋이 생성 결과를 이끌기 시작하면 reference guide를 사용한다. 이 형식은 정해진 순서대로 여섯 섹션을 요구한다. subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape, non_diegetic_music 순서다. 생성 작업에서 detailed_description 본문은 일반적으로 영어 350~500단어를 권장한다. 대사가 많은 프롬프트라면 전체 발화 타임라인을 담기 위해 이 분량을 벗어날 수 있다.
핵심은 다음 네 가지 레이블이다.
| 레이블 | 용도 |
|---|---|
<Subject N> | 출력에 실제로 활용되는 보이는 콘텐츠. 인물, 제품, 장면, 의상, 스타일 또는 에셋에서 추상화한 동작을 뜻한다. |
<Picture N> | 첫 프레임, 키프레임, 마지막 프레임, 구도 기준점처럼 구체적인 프레임 앵커 역할을 하는 이미지다. |
<Video N> | 편집 소스, 이어지는 지점, 카메라·컷 구조, 리듬처럼 영상 전체와의 관계를 나타낸다. |
<Audio N> | 음색, 가사, 비트, 효과음처럼 복사하거나 참조할 오디오 신호다. |
번호는 레이블 유형별로 독립적이다. 따라서 업로드한 하나의 영상은 <Video 1>이고, 그 오디오 트랙은 <Audio 2>일 수 있다. 말하는 대상에는 레이블과 화자 ID를 결합해 <Subject 3> (S1)처럼 표기한다.
summary 섹션은 [reference generation] 또는 [video editing + audio reuse] 같은 대괄호 작업 접두사로 시작한다. 영상 편집 작업이라면 반드시 "The target video is an edited version of <Video 1>."으로 시작해야 한다. 이어서 retention_analysis에서 레이블마다 유지 마커를 지정한다. 시각 요소에는 fully_preserved, partially_preserved, attribute_transfer, weak_reference를 쓰며, 오디오에는 fully_copy, partially_copy, reference, weak_reference를 사용한다. 얼굴은 유지하되 의상은 바꿔도 된다는 식의 지시는 이 마커로 전달한다.
문서에 나온 순서를 따른 최소 레퍼런스 모드 골격은 다음과 같다.
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
H3가 기대와 다르게 나올 때: 증상별 해결표
| 증상 | 가능성이 높은 프롬프트 원인 | 해결 방법 |
|---|---|---|
| 횡설수설한 음성 또는 지어낸 "Sims-speak" | 구조화되지 않은 대사, 화자 ID 부재, 말하지 않는 인물에 대한 설명 부족 | (S1)/(S2) ID를 추가하고, 정확한 대사를 <d>[Language] ...</d>로 감싼다. 말하지 않는 인물은 발화하지 않는다고 명시한다. |
| 대사가 번인 자막으로 출력됨 | 말하는 대사를 따옴표로 작성함 | 따옴표는 화면에 보이는 텍스트에만 사용하고, 대사는 <d> 태그로 옮긴다. |
| 대사를 엉뚱한 인물이 말함 | 화자 ID가 묘사된 인물과 연결되지 않음 | 화자가 처음 등장할 때 나이, 화면 안팎 여부, 음성 등 정체성 정보를 지정하고, 샷이 바뀌어도 ID를 유지한다. |
| 요청하지 않은 스코어 또는 음악 | non_diegetic_music가 모호하거나 누락됨 | 음악이 필요 없으면 non_diegetic_music: N/A를 쓴다. 커뮤니티에서는 이 방법이 원치 않는 오디오를 없애는 데 효과적이라고 보고한다. |
| 계획하지 않은 컷 | 장면 변화가 타임스탬프 없이 암시됨 | [Shot N] At 00:03.500과 명시적인 컷 문구를 사용한다. 원테이크라면 "no cuts" 문구를 요청한다. |
| 얼굴, 의상 또는 제품이 흔들림 | 레퍼런스 역할을 선언하지 않음 | 해당 레이블에 fully_preserved를 지정한 retention_analysis 행을 추가하고, 매 등장 시 레이블을 반복한다. |
횡설수설 음성과 자막 문제는 공식 문법 규칙에서 직접 다루는 항목이다. r/StableDiffusion의 커뮤니티 스레드도 실제로 같은 해결책이 통한다고 독립적으로 보고한다. 특히 원치 않는 오디오를 막기 위한 non_diegetic_music: N/A가 자주 언급된다.
한도와 테스트 비용
프롬프트 길이는 제한돼 있고, 반복 생성에는 비용이 든다. 따라서 모델의 생성 한도를 먼저 알아둘 필요가 있다. 공식 API와 호스팅 제공업체 문서에서 확인되는 한도는 다음과 같다.
| 파라미터 | 값 | 참고 |
|---|---|---|
| 클립 길이 | 최대 15초, 정수 초 단위 | fal/EvoLink 엔드포인트의 최소 길이는 5초이며, 일부 V2 API 문서는 4초를 표기한다. |
| 해상도 | 768p 및 2K, 24 FPS | MiniMax 기준 기본 출력 해상도는 2K다. |
| 레퍼런스 파일 | 이미지 최대 9개, 영상 3개, 오디오 3개 | 총 12개 파일이며, 오디오만 단독 레퍼런스로 쓰는 것은 불가능하다. |
| 프롬프트 길이 | 약 7,000자 | fal 및 V2 API 문서 기준이다. APIMODELS는 20,480자를 표기하므로 제공업체별 확인이 필요하다. |
| 화면비 | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptive | image-to-video는 입력 이미지의 화면비를 따른다. |
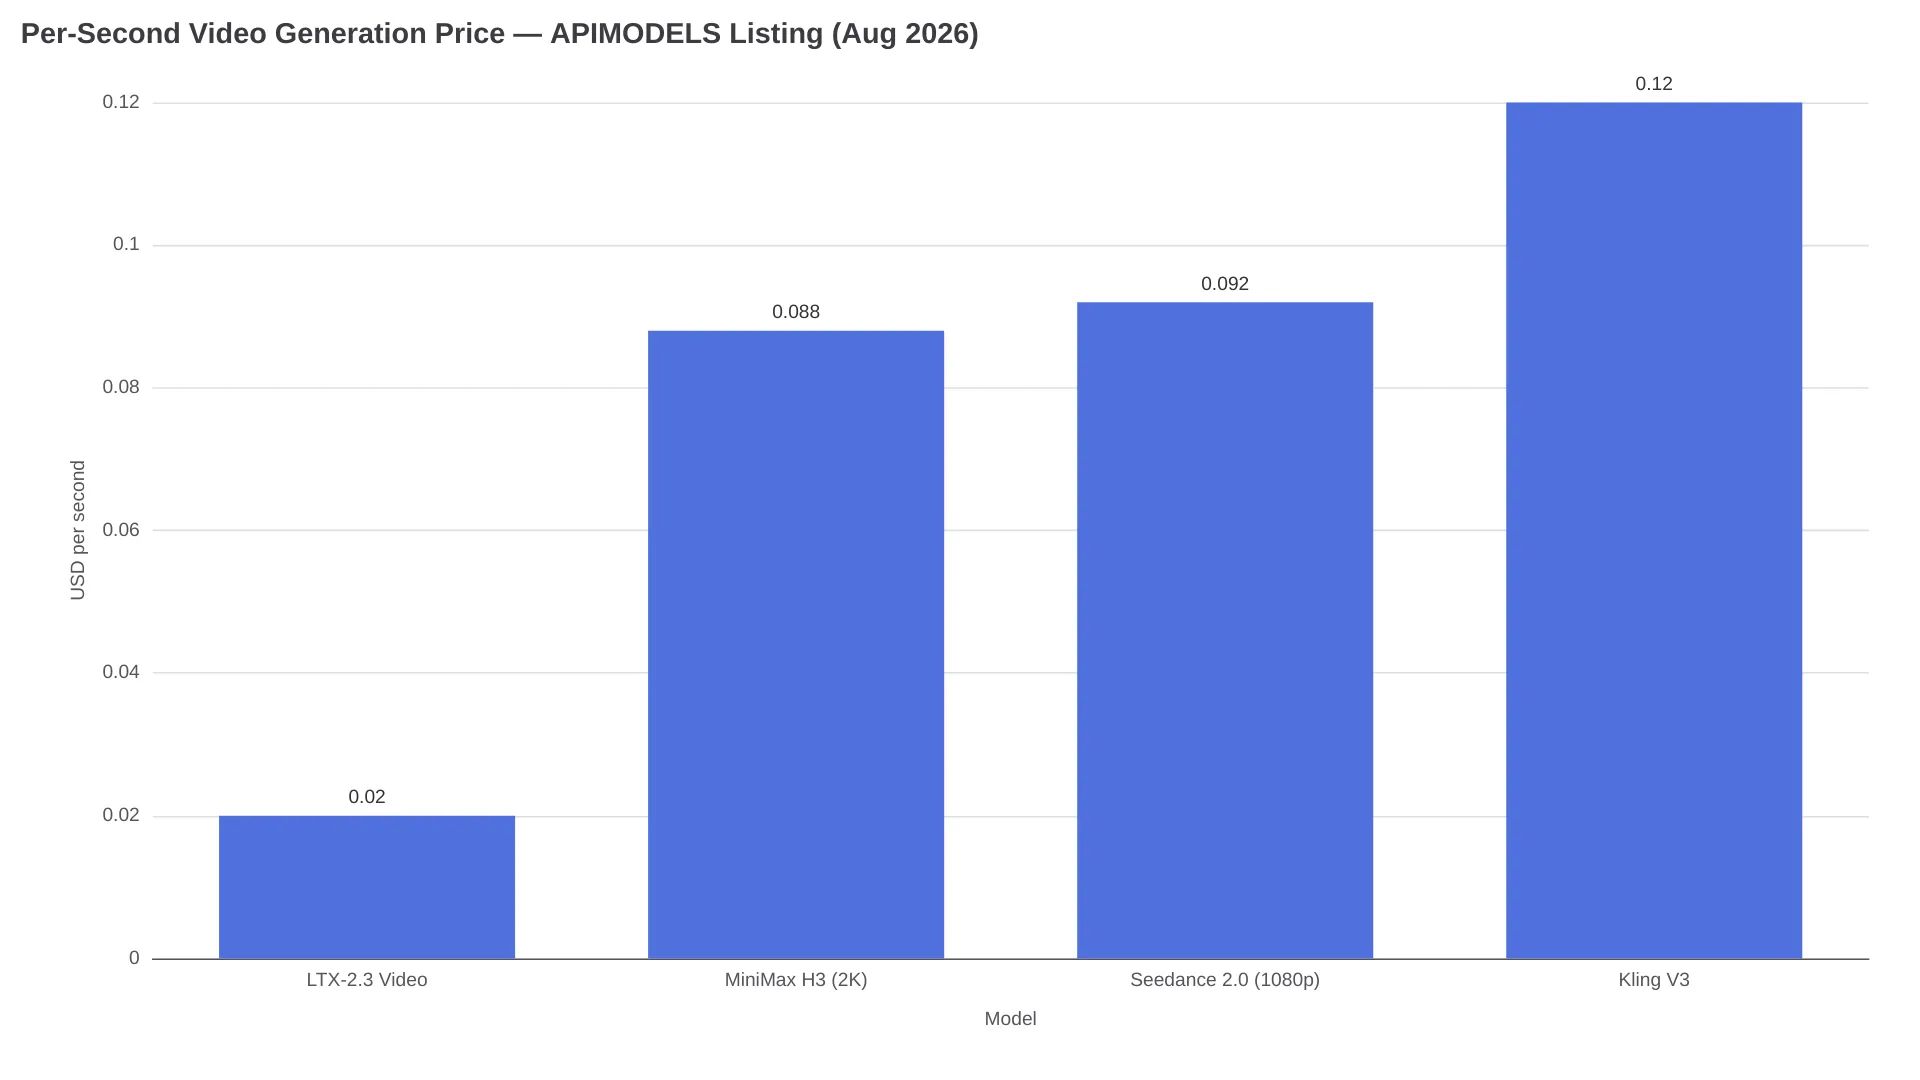
가격은 제공업체에 따라 바뀌므로, 아래 수치는 정가가 아니라 특정 시점의 스냅샷으로 봐야 한다. fal에서는 8월 1일 가격 스냅샷 기준 2K 생성 비용이 초당 $0.26였다. 5초는 $1.30, 15초는 $3.90이며, 처음 다섯 장의 레퍼런스 이미지는 무료이고 추가 이미지는 장당 $0.08이다. APIMODELS에서 H3는 초당 $0.088이며, 15초 클립은 $1.32다. 성공한 요청에만 비용을 청구한다. 같은 마켓플레이스의 초당 가격을 비교하면 다음과 같다.
실제 예산을 좌우하는 것은 재시도 비용이다. 구조화한 15초 대사 프롬프트가 두 번째 시도에 성공하면 APIMODELS에서 $2.64가 든다. 반면 구조화되지 않은 프롬프트로 쓸 만한 결과 하나를 얻기까지 다섯 번 시도하면 $6.60이 든다. 호스팅 H3 엔드포인트로 프롬프트를 반복 테스트하려면 AIReiter의 MiniMax H3 API 페이지에서 현재 페이지에 표시된 가격으로 모델을 실행할 수 있다.
바로 복사해 쓸 수 있는 시작 템플릿
짧은 영상 작업은 아래 두 가지 base 템플릿으로 대부분 시작할 수 있다. 대괄호 안만 채우고, 필드명과 빈 줄은 그대로 유지한다.
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/A빈 템플릿보다 검증된 프롬프트가 필요하다면, 소스 링크를 유지하는 세 라이브러리를 참고할 만하다. ecomimagelab/awesome-minimax-h3-prompts에는 58개 프롬프트가 있다. 공식 예시 39개와 커뮤니티 테스트 예시 19개로 구성되며, "No video, no entry." 원칙 아래 모든 항목에 결과 영상 다운로드 파일을 제공한다. imagineVid/Awesome-minimax-h3-prompts-and-skills에는 옴니 레퍼런스 기반 인물 일관성부터 네이티브 오디오 대사까지 여섯 가지 워크플로의 검증 사례 28개가 있다. APIMODELS 갤러리는 클립이 첨부된 226개 프롬프트를 용도별로 탐색할 수 있다. 이곳의 한 줄 원칙은 "References carry identity, the prompt carries action."이다.
스크립트 작성 자체를 줄여 주는 방법도 두 가지가 있다. Reddit 사용자들은 공식 가이드를 LLM에 붙여 넣고 목표 모드를 지정하는 방식으로 좋은 결과를 얻었다고 말한다. 예를 들어 "rewrite this idea as T2VA using the base guide"처럼 요청하면 된다. ComfyUI 확장인 MiniMax H3 Prompt Writer v0.3는 노드 워크플로 안에서 이 구조화된 형식을 만들어 준다.
FAQ
MiniMax H3 base guide와 reference guide는 무엇이 다른가?
base guide는 세 가지 핵심 필드를 기반으로 하는 무레퍼런스 모드 네 가지(T2VA, I2VA, FL2VA, L2VA)를 다룬다. reference guide는 업로드한 이미지·영상·오디오가 생성에 관여할 때 사용하며, 여섯 개의 필수 섹션과 <Subject>/<Picture>/<Video>/<Audio> 레이블을 추가한다.
MiniMax H3 프롬프트에서 화자는 어떻게 표기하나?
첫 발화 순서에 따라 (S1), (S2)처럼 고정 ID를 할당하고, 샷이 바뀌어도 같은 ID를 유지한다. 동시 발화에는 (S1,S2)를 사용하며, <d> 태그 안에는 언어 태그와 정확한 대사만 넣는다.
MiniMax H3에서 횡설수설한 오디오를 막으려면?
화자 ID와 원문 그대로의 <d> 태그로 대사를 구조화하고, 발화하지 않는 인물은 침묵한다고 설명한다. 스코어가 필요 없다면 non_diegetic_music: N/A로 설정한다. 이는 문서와 커뮤니티 모두에서 확인된 해결책이다.
MiniMax H3 대사를 따옴표로 감싸야 하나?
아니다. 따옴표는 영상 안에 보이는 텍스트 전용이다. 말하는 대사는 <d>[Language] ...</d>에 넣어야 하며, 그렇지 않으면 H3가 화면 자막으로 렌더링할 수 있다.
MiniMax H3 프롬프트는 얼마나 길게 쓸 수 있나?
fal과 공식 V2 API 문서는 약 7,000자를 제시한다. 다만 APIMODELS는 20,480자를 표기하므로, 10,000자 스크립트를 작성하기 전에는 사용 중인 엔드포인트의 한도를 확인해야 한다.
문법만으로 해결되지 않는 영역
구조화는 성공률을 높이지만 생성을 결정론적으로 바꾸지는 못한다. 정확한 인물 정체성, 로고, 제품 충실도는 여전히 확률적이다. 커뮤니티 API 래퍼도 프레임 단위의 일관성을 보장하지 않는다고 명시한다. 가장 강력한 프롬프트 라이브러리 사례도 측정 가능한 보장 대신, 긴 제약 블록으로 정체성을 유지한다. 비언어적 소리를 위한 인라인 <tags>는 커뮤니티 실험 단계이며 생성마다 결과가 달라질 수 있다. 요청 건당 비용이 아니라 승인된 결과물 1초당 비용으로 결과를 평가하고, 작성 중에는 공식 base guide와 reference guide를 탭에 열어 두는 편이 좋다.
관련 글: MiniMax H3 출시 개요에서는 모델의 기본 성격을 다루며, MiniMax H3 vs LTX 2.3에서는 초당 비용이 가장 저렴한 대안과 비교한다.