 AIREITER
DeepSeek가 2026년 8월 13일 V4 Pro GA를 공식 출시했습니다. 전체 벤치마크 결과와 MIT 라이선스 오픈 웨이트, 세 단계의 추론 강도를 함께 공개했죠. API 사용자라면 요금 변경이 가장 중요합니다. 공식 가격표에 따르면 2026년 8월 16일 16:00 UTC부터 피크·오프피크 요금제가 시작됩니다. V4 Pro의 출력 토큰 가격은 100만 토큰당 기존 $0.87에서 오프피크 $1.98, 피크 $3.96으로 인상됩니다.
이번에 공개된 것: 벤치마크와 오픈 웨이트를 갖춘 V4-Pro-0813
deepseek-v4-pro API 별칭이 가리키는 모델이 이제 DeepSeek-V4-Pro-0813으로 바뀌었습니다. DeepSeek 앱과 웹, API에서 모두 사용할 수 있습니다. DeepSeek는 출시 소식을 8월 13일 전하며, 4월 24일 프리뷰 빌드보다 “에이전트 기능이 크게 향상됐다”고 설명했습니다.
모델 구조와 주요 사양
| 항목 | DeepSeek-V4-Pro-0813 |
|---|---|
| 공개 모델 규모 | 1.7T 파라미터 (모델 카드; 프리뷰는 1.6T) |
| 컨텍스트 길이 | 100만 토큰 |
| 최대 출력 | 384K 토큰 |
| 사고 모드 | 비사고 모드 및 사고 모드(기본값은 사고 모드) |
| 추론 강도 | low, high, max |
| 새 디코딩 모듈 | DSpark 추측 디코딩(추측 토큰 7개) |
| API 호환성 | OpenAI ChatCompletions, Responses API, Anthropic API, Codex |
| 동시성 한도 | 500 |
| 라이선스 | MIT |
모델 카드는 에이전트 작업에서 temperature = 1.0, top_p = 0.95를 권장합니다. high와 max 추론 강도에서는 최대 출력 길이가 384K 토큰입니다.
공식 GA 벤치마크
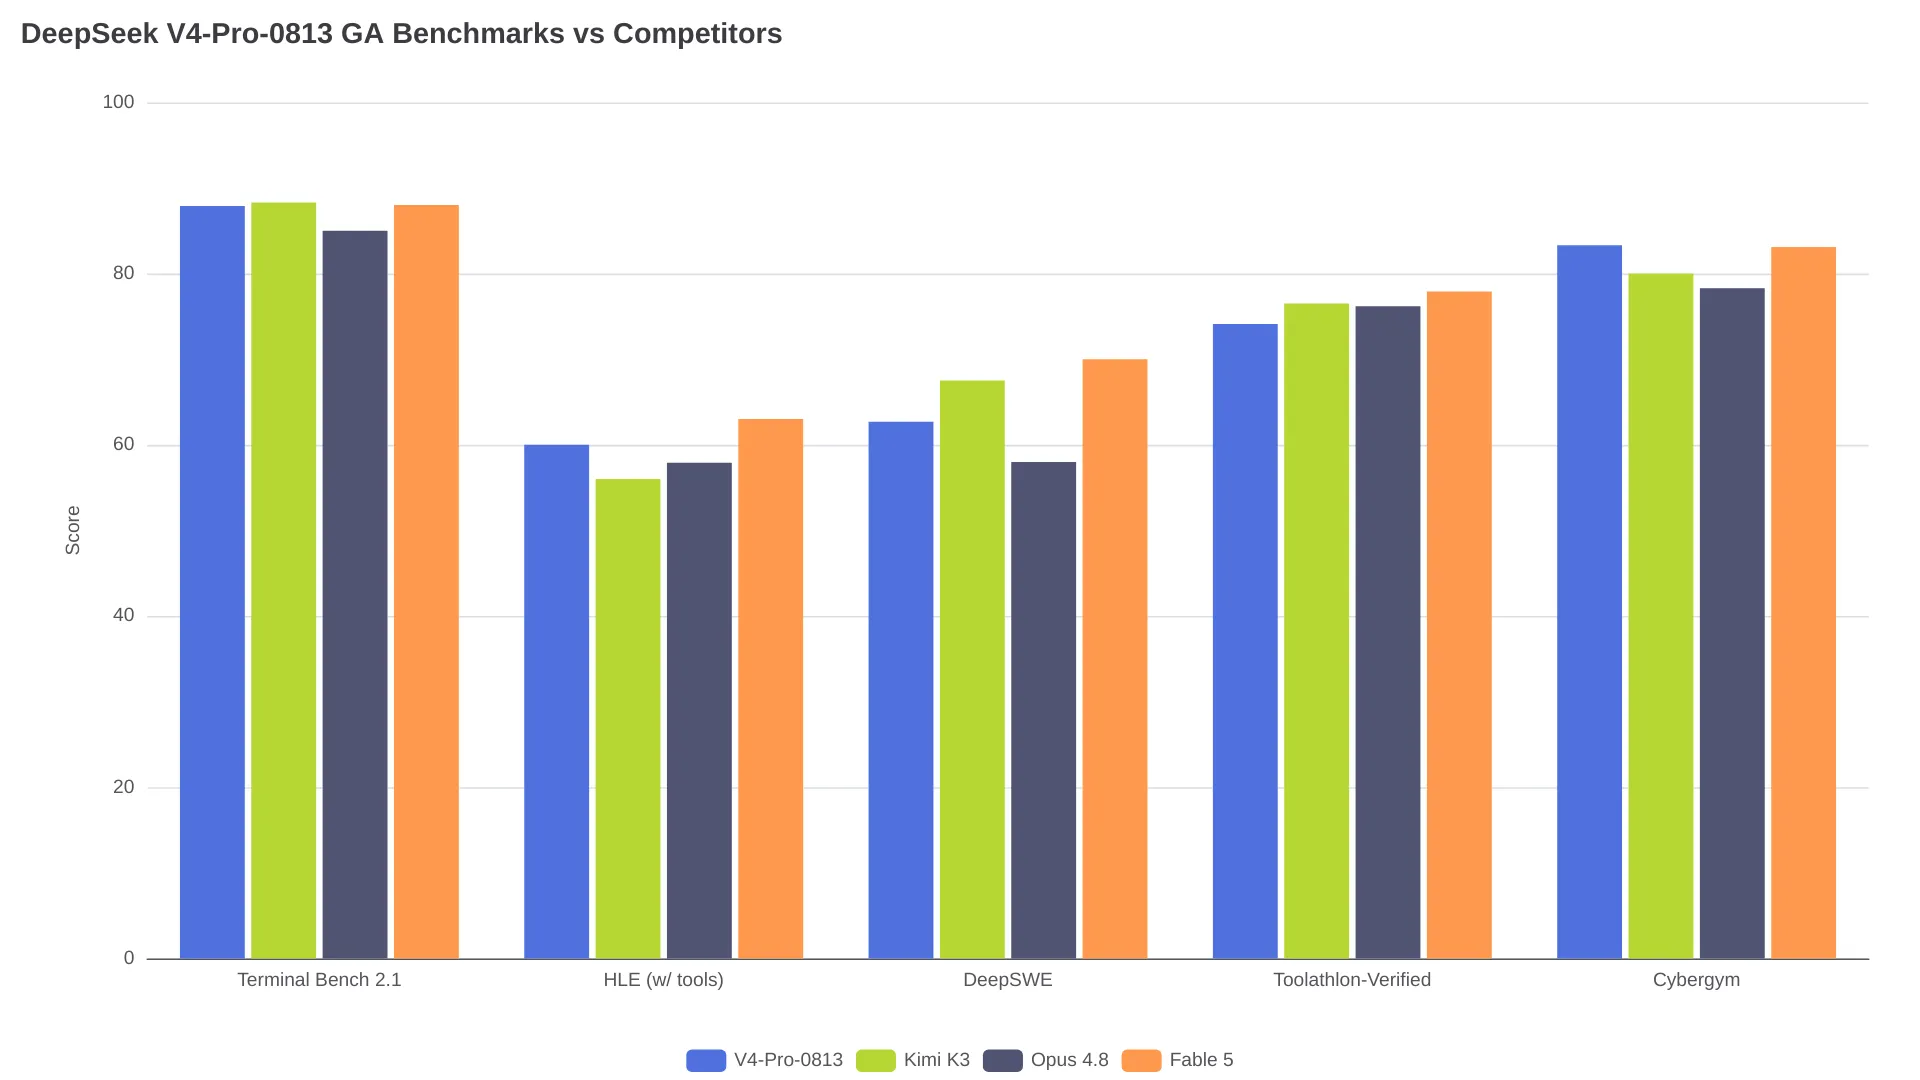
DeepSeek는 모델 카드에 10개 벤치마크 비교 결과를 공개했습니다. 코드 에이전트 작업은 DeepSeek Harness 미니멀 모드와 max 추론 강도로 테스트했습니다. 마지막 두 항목인 DSBench는 DeepSeek 내부 테스트 세트입니다. 아래 수치는 모두 해당 모델 카드에서 가져왔습니다.
| 벤치마크 | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE(도구 없음 / 도구 사용) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench (Public) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack (internal) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard (internal) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
프리뷰에서 GA로 넘어오며 점수가 크게 뛰었습니다. DeepSWE는 12.8에서 62.7로, AutomationBench는 12.8에서 31.8로 상승했습니다. 경쟁 모델과 비교하면 Pro-0813은 도구를 사용한 HLE에서 60.0점으로 Kimi K3의 56.0점과 Opus 4.8의 57.9점을 앞섭니다. 반면 DeepSWE, Terminal Bench, Toolathlon-Verified에서는 Kimi K3와 Fable 5에 뒤집니다. DSBench 두 항목은 공급사 내부 테스트이므로 독립적으로 운영되는 벤치마크와 같은 비중으로 해석해서는 안 됩니다.
오픈 웨이트
0813 웨이트는 Hugging Face에 공개됐으며 MIT 라이선스를 따릅니다. vLLM과 SGLang을 통한 배포도 지원합니다. 모델 카드에는 DSpark 추측 디코딩, FP8 KV 캐시, 단일 4x GB300 노드를 사용하는 vLLM 서빙 예제가 포함돼 있습니다.
“현재 이용 가능한 가장 강력한 독점 모델들과 전반적으로 경쟁할 수 있다.” — DeepSeek V4-Pro 모델 카드, Hugging Face
전체 가격표: 8월 16일 전후로 얼마나 달라지나
가격표에는 현재 적용 중인 단일 요금과 2026년 8월 16일 16:00 UTC부터 시행되는 피크·오프피크 요금이 함께 나와 있습니다. 피크 시간은 UTC 01:00~04:00 및 06:00~10:00이며, 베이징 시간으로는 09:00~12:00 및 14:00~18:00입니다. 나머지 시간은 오프피크로 분류됩니다. 오프피크 요금은 피크 요금의 정확히 절반입니다.
DeepSeek V4 Pro (DeepSeek-V4-Pro-0813)
| 과금 항목 | 현재 단일 요금 | 오프피크(8월 16일) | 피크(8월 16일) | 피크 기준 변동 |
|---|---|---|---|---|
| 입력, 캐시 적중 | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| 입력, 캐시 미적중 | $0.435/M | $0.66/M | $1.32/M | +203% |
| 출력 | $0.87/M | $1.98/M | $3.96/M | +355% |
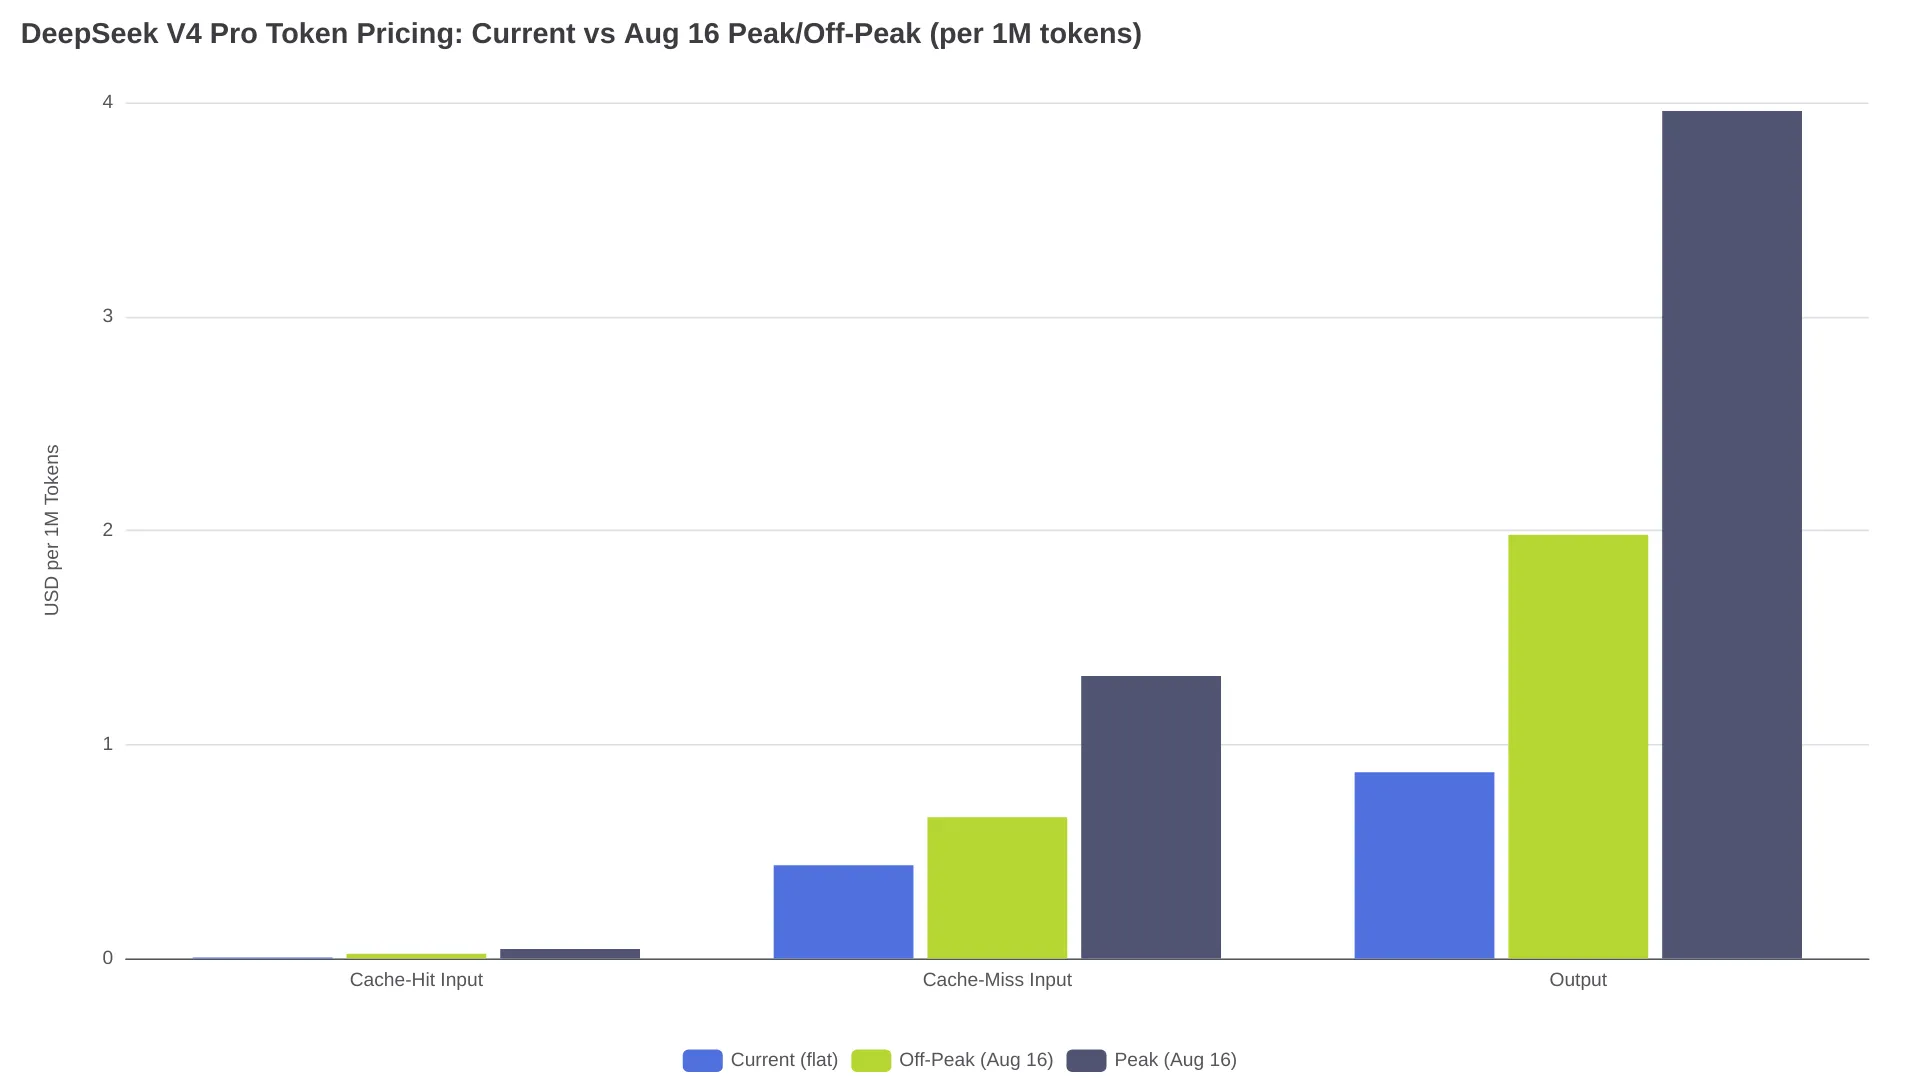
피크 시간대 출력 요금은 4.6배 높아집니다. 특히 운영 환경의 에이전트 워크플로에서는 캐시 적중 요금 변화가 더 큽니다. 기존 $0.003625/M 요금은 캐시 미적중보다 약 120배 저렴했지만, 8월 16일 이후에는 두 구간 모두 그 차이가 30배로 줄어듭니다(오프피크 0.022 대 0.66, 피크 0.044 대 1.32). 대신 캐시 적중의 절대 비용은 6배에서 12배까지 오릅니다.
DeepSeek V4 Flash (DeepSeek-V4-Flash-0731)
| 과금 항목 | 현재 단일 요금 | 오프피크(8월 16일) | 피크(8월 16일) | 피크 기준 변동 |
|---|---|---|---|---|
| 입력, 캐시 적중 | $0.0028/M | $0.007/M | $0.014/M | +400% |
| 입력, 캐시 미적중 | $0.14/M | $0.22/M | $0.44/M | +214% |
| 출력 | $0.28/M | $0.66/M | $1.32/M | +371% |
동시성 한도는 동시 요청 2,500개로, Pro의 5배입니다.
내 시간대의 피크 시간은 언제인가
| 시간대 | 피크 구간 1 | 피크 구간 2 |
|---|---|---|
| 베이징(UTC+8) | 09:00~12:00 | 14:00~18:00 |
| 런던(UTC+1) | 02:00~05:00 | 07:00~11:00 |
| 뉴욕(UTC-4) | 21:00~00:00(전날) | 02:00~06:00 |
| 샌프란시스코(UTC-7) | 18:00~21:00 | 23:00~03:00 |
미국 팀이라면 피크 구간 대부분이 밤이나 저녁에 걸립니다. 중국 및 동아시아 팀에는 일반적인 업무 시간이 피크 시간대와 겹칩니다.
실제 비용 계산: 하루 10,000번 호출하는 Pro
호출마다 50K 토큰의 캐시된 프리픽스를 보내고 2K 토큰을 응답받는 운영 에이전트를 가정해 보겠습니다.
| 비용 항목 | 현재 단일 요금 | 오프피크 | 피크 |
|---|---|---|---|
| 캐시 적중 입력(500M 토큰) | $1.81 | $11.00 | $22.00 |
| 출력(20M 토큰) | $17.40 | $39.60 | $79.20 |
| 하루 합계 | $19.21 | $50.60 | $101.20 |
| 30일 합계 | $576 | $1,518 | $3,036 |
실제 워크로드는 피크와 오프피크 호출이 섞이므로 최종 비용은 이 두 범위 사이에 형성됩니다. 같은 작업을 Flash로 처리하면 현재 단일 요금 기준 하루 $7.00, 오프피크 약 $16.70, 피크 약 $33.40입니다. Flash 피크 요금인 하루 $33.40은 Pro의 현재 단일 요금인 $19.21보다 높지만, Flash 오프피크 요금인 $16.70은 더 저렴합니다.
마이그레이션 체크포인트: 모델 ID, 추론 제어, 버전 고정
종료되는 엔드포인트와 교체할 ID
4월 24일 프리뷰 발표에서 deepseek-chat과 deepseek-reasoner는 “2026년 7월 24일 15:59(UTC) 이후 완전히 종료되며 접근할 수 없다”고 안내했습니다. 코드에 해당 문자열이 남아 있다면 수정해야 합니다.
| 기존 엔드포인트 | 연결되던 모델 | 교체 대상 |
|---|---|---|
deepseek-chat | V4 Flash, 비사고 모드 | deepseek-v4-flash |
deepseek-reasoner | V4 Flash, 사고 모드 | deepseek-v4-flash(사고 모드) 또는 deepseek-v4-pro |
많은 팀이 deepseek-reasoner를 Pro급 추론 모델로 생각했지만, 실제로 연결된 모델은 사고 모드의 Flash였습니다. deepseek-v4-pro로 바꾸면 출력 품질뿐 아니라 비용도 달라집니다.
// 이전(종료됨 — 작동하지 않음)
{"model": "deepseek-reasoner", "messages": [...]}

// 변경 후
{"model": "deepseek-v4-pro", "messages": [...]}
기본 URL인 https://api.deepseek.com은 그대로 유지됩니다. 그 밖의 요청 구조를 바꿀 필요는 없습니다.
추론 강도 설정
V4-Pro-0813에는 세 가지 추론 강도가 들어갔습니다. 간단한 작업은 low, 일반적인 에이전트 작업은 high, 복잡한 문제는 max를 사용하면 됩니다. 사고 모드는 기본적으로 켜져 있으며, 사고 토큰도 출력 요금에 포함됩니다. 예를 들어 200토큰 답변을 내기 전에 사고 토큰 3,000개를 생성하면 피크 요금 기준 출력 3,200토큰에 해당하는 호출 비용이 청구됩니다. 답변만 200토큰일 때의 $0.0008과 비교하면 호출당 $0.0127입니다. 단순한 작업에서 긴 사고 과정이 비용만 늘리고 실질적인 이득이 없다면 DeepSeek가 지정한 low를 선택하는 편이 낫습니다.
버전 고정
deepseek-v4-pro 별칭은 현재 빌드를 가리키며, DeepSeek가 향후 버전을 내놓으면 바뀔 수 있습니다. 운영 환경에서 재현 가능한 동작이 중요하다면 공급자가 날짜가 포함된 모델 ID를 지원하는지 확인하세요. 일부 서드파티 게이트웨이는 버전 고정 라우트를 제공하지만, 실제 운영에 사용하기 전 각 라우트가 어떤 빌드를 제공하는지 공급자 문서에서 확인해야 합니다.
API 프로토콜 호환성
두 모델 모두 OpenAI ChatCompletions와 Anthropic API 형식을 지원합니다. Anthropic 엔드포인트는 https://api.deepseek.com/anthropic입니다. Responses API와 Codex 호환성은 GA 빌드에서 새롭게 추가됐습니다. 마이그레이션 후 오류가 발생한다면 두 프로토콜 경로를 모두 테스트해 보세요.
가격 인상 후 Pro와 Flash, 무엇을 선택할까
V4-Pro-0813은 공개된 10개 지표 모두에서 V4-Flash-0731을 앞섭니다. 다만 작업 복잡도에 따라 격차는 달라집니다.
| 벤치마크 | Pro 0813 | Flash 0731 | 차이 |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2점 |
| DeepSWE | 62.7 | 54.4 | 8.3점 |
| AutomationBench | 31.8 | 25.1 | 6.7점 |
| Cybergym | 83.3 | 76.7 | 6.6점 |
V4 Pro가 맞는 경우
- 크고 일정한 프리픽스를 반복해서 보내는 에이전트 루프를 운영할 때. 기본 요금은 올라도 캐시 적중에 따른 절감 효과를 활용할 수 있습니다
- 복잡한 추론, 여러 단계의 도구 사용, 대규모 코드 생성에 Pro의 더 큰 파라미터 규모가 필요할 때
- 동시 요청 500개 제한을 감당할 수 있을 때
V4 Flash가 맞는 경우
- 작업이 단순하거나 호출량이 많고 지연 시간에 민감할 때
- 팬아웃 작업에 동시 요청 2,500개 한도가 필요할 때
- 품질 차이가 출력 요금 3배를 정당화하지 못할 때
모델별 차이를 더 자세히 비교하려면 DeepSeek V4 Flash와 Pro 비교를 참고하세요. API 키를 직접 관리하지 않고 모델을 테스트하려면 V4 Pro 채팅 페이지와 V4 Flash 채팅 페이지에서 바로 사용할 수 있습니다.
FAQ
V4-Pro-0813 웨이트를 직접 호스팅할 수 있나요?
가능합니다. Hugging Face에서 MIT 라이선스로 공개됐으며, vLLM과 SGLang 배포 경로를 제공합니다. 배포 세부 내용은 위의 오픈 웨이트 항목을 참고하세요.
GA 출시를 계기로 V4 Flash에서 V4 Pro로 옮겨야 할까요?
비용을 중시하는 대부분의 워크로드에서는 여전히 Flash가 더 나은 선택입니다. 벤치마크별로 Flash는 Pro보다 0.5점(Agents' Last Exam)에서 8.5점(HLE 도구 사용)까지 낮지만, 출력 비용은 3배 저렴합니다. 복잡한 다단계 추론이나 대규모 코드 생성에서 전체 파라미터 규모가 필요하다면 Pro로 전환하세요.
가격 인상 영향을 줄이는 방법은 무엇인가요?
방법은 세 가지입니다. 배치 작업과 시간을 조정할 수 있는 에이전트를 피크 시간인 UTC 01:00~04:00 및 06:00~10:00 외 시간에 실행하세요. 프롬프트 프리픽스를 안정적으로 유지해 캐시 적중률을 높이고, 단순한 작업은 Flash로 보내거나 Pro에서 low 추론 강도를 사용하면 됩니다.
피크·오프피크 요금은 DeepSeek 앱과 웹사이트에도 적용되나요?
공식 가격표가 문서화한 대상은 API 토큰 과금뿐입니다. 명시된 일정은 직접 API를 호출할 때 적용되며, 게이트웨이 제공업체는 이를 그대로 반영하거나 추가 수수료를 붙일 수 있고 별도 요금을 사용할 수도 있습니다. 최신 내용은 가격표에서 확인하세요.