 AIREITER
Una descrizione "cinematografica" di una riga lascia al modello troppi vuoti da riempire. Se non specifichi la macchina da presa, le note di prompting del provider indicano che il risultato tende a essere un'inquadratura fissa; se trascuri i campi audio, può comparire parlato indesiderato. Con MiniMax H3, un prompt efficace assomiglia molto di più a una sceneggiatura tecnica compatta: le guide ufficiali definiscono un formato fisso a tre campi, con timestamp delle inquadrature, ID coerenti per i parlanti e due sezioni dedicate al suono. Il tutto deve rientrare in un budget di circa 7.000 caratteri, variabile in base al provider, e in clip della durata massima di 15 secondi.
Prima scegli il formato: due guide ufficiali e quattro modalità H3
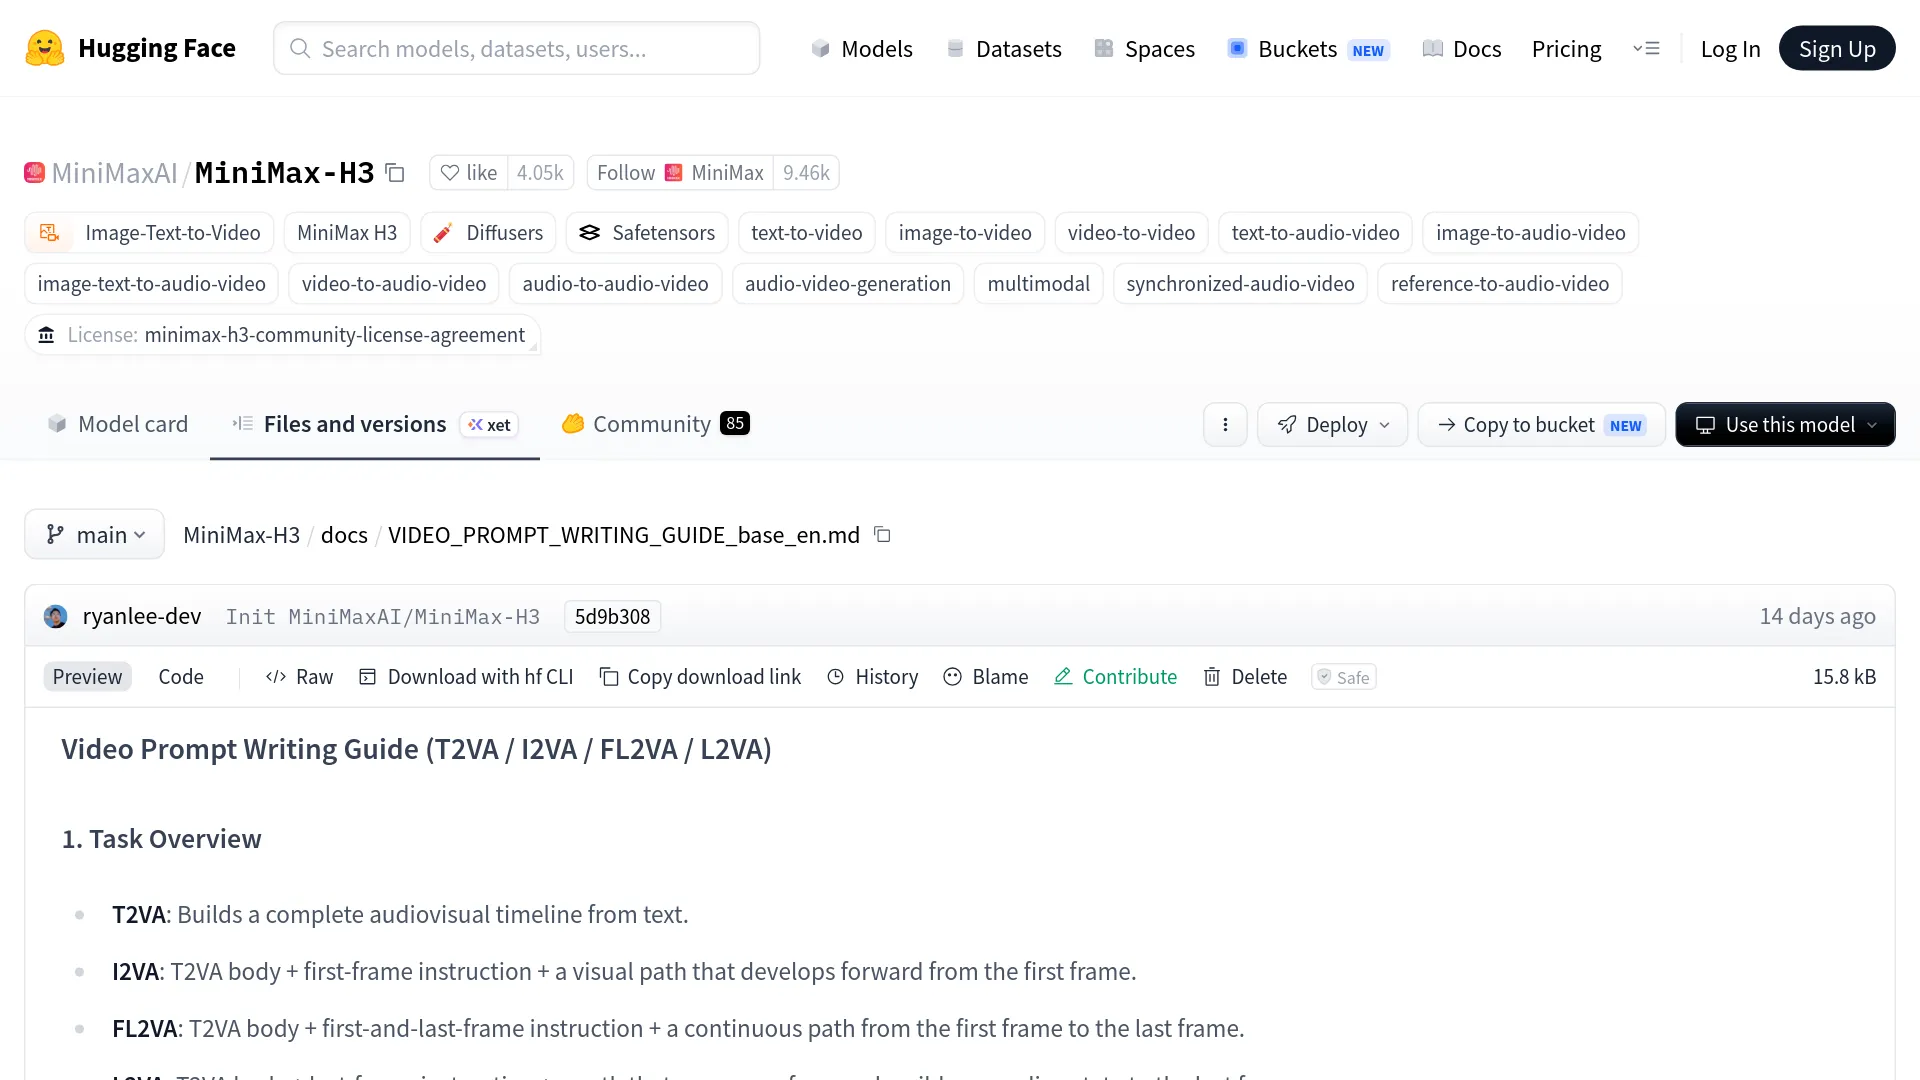
MiniMax pubblica due guide distinte per la scrittura dei prompt nel repository MiniMax-H3 su Hugging Face, dedicate a flussi di lavoro differenti. La guida base riguarda quattro attività di generazione senza riferimenti caricati; la guida reference entra in gioco non appena un'immagine, un video o una clip audio caricata influenza il risultato. Le quattro attività base corrispondono a queste modalità:
| Modalità | Input | Istruzione di allineamento richiesta nel prompt |
|---|---|---|
| T2VA | Solo testo | Nessuna; inizia direttamente dai campi principali |
| I2VA | Una sola immagine come primo frame | "Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]" |
| FL2VA | Primo frame + ultimo frame | Picture 1 a 0.00 secondi, Picture 2 all'esatto tempo finale |
| L2VA | Una sola immagine come ultimo frame | Picture 1 si allinea al tempo finale del video e all'ultima inquadratura |
Entrambe le guide si chiudono con esempi completi. Anche il post di lancio di MiniMax presenta il modello nello stesso modo: non si seleziona un'attività da un menu, ma si descrivono le relazioni tra input testuali, immagini, video e audio. Gli endpoint ospitati semplificano il tutto in tre workflow — minimax/h3/text-to-video, image-to-video e reference-to-video su fal — ma la struttura del prompt resta invariata.
Anatomia del prompt base
Dopo l'eventuale istruzione di allineamento, un prompt MiniMax H3 in modalità base richiede esattamente tre campi separati da una riga vuota. Questa è la struttura:
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_descriptioncontiene la timeline: stile visivo, composizione, azioni, cambi di inquadratura, parlanti, dialoghi e suoni diegetici, cioè tutto ciò che si vede o si sente nella scena.overall_soundscaperiassume ambiente e suoni fisici in 1–4 frasi, in un unico paragrafo e senza dialoghi.non_diegetic_musicdescrive la colonna sonora udibile soltanto dallo spettatore in 1–3 frasi, oppure usaN/Aquando non deve esserci.
Ecco un esempio compilato, adattato dal caso T2VA della guida ufficiale, ambientato in una panetteria prima dell'alba:
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
Ecco cosa controlla ogni elemento, secondo le regole ufficiali:
| Elemento del prompt | Controlla | Regola |
|---|---|---|
[Shot 1] Live-action, cinematic. | Stile globale | L'etichetta di stile apre Shot 1; tra gli esempi presenti nella guida: Cinematic, live-action, 2D-animated, 3D CG, claymation, watercolor, vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | Identità del parlante | Gli attributi identitari precedono l'ID; l'ID deve restare stabile tra le inquadrature |
The camera pushes in with small amplitude at slow speed | Macchina da presa | Tipo di movimento + ampiezza + velocità, formulati come un'azione naturale |
<d>[English] First batch of the day.</d> | Dialogo | Solo tag della lingua e parole esatte, riportate fedelmente e mai tradotte |
At 00:05.000, the camera cuts to... | Tempo del taglio | Deve aumentare in modo strettamente progressivo; [Shot 1] non riceve mai un timestamp |
<scenetrans> continuing seamlessly across the cut | Continuità audio | Indica un dialogo che prosegue oltre un taglio, in entrambi i punti di connessione |
Inquadrature, stacchi e movimenti di camera
In MiniMax H3 la sintassi delle inquadrature segue una regola posizionale: [Shot 1] non ha mai timestamp, mentre ogni inquadratura successiva inizia con un tempo di stacco strettamente crescente, come At 00:03.500,. Il linguaggio consigliato per il taglio è breve — "the camera cuts to", "the shot transitions to", "the shot switches to" — mentre dissolvenze incrociate, fade e wipe vanno indicati soltanto se li vuoi esplicitamente. Se cambia solo leggermente l'inquadratura, la guida consiglia di usare il movimento della camera invece di un taglio: uno stacco dovrebbe introdurre nuove informazioni su soggetto, spazio, stato o tempo.
Il movimento di macchina va scritto come un'azione naturale in inglese, combinando fino a tre dimensioni: tipo di movimento, ampiezza e velocità.
| Dimensione | Espressioni accettate |
|---|---|
| Tipo di movimento | Zoom In/Out, Push In/Pull Out, Pan Left/Right, Truck Left/Right, Tilt Up/Down, Pedestal Up/Down, Arc Shot, Tracking Shot, Static Shot, Shake Slightly/Strongly, POV, Roll Clockwise/Counterclockwise |
| Ampiezza | "with small amplitude", "with large amplitude" |
| Velocità | "at slow speed", "at fast speed" |
Per convenzione, ampiezza media e velocità normale non vengono esplicitate. La distinzione tra "Zoom In" e "Push In" è importante: il primo modifica la lunghezza focale da una posizione fissa, il secondo porta fisicamente la camera in avanti. La guida mantiene volutamente questa differenza.
Dialoghi e ID dei parlanti
Ogni personaggio che parla in un prompt MiniMax H3 riceve un ID stabile — (S1), (S2), oppure una forma composta come (S1,S2) per battute sincronizzate — e conserva lo stesso ID in tutte le inquadrature. I personaggi che non parlano non ricevono alcun ID. Alla prima apparizione del parlante, conviene definirne abbastanza bene l'identità per una generazione coerente: presenza in o fuori campo, fascia d'età, genere, altezza della voce, timbro, ritmo del parlato e accento.
La sintassi esatta per una battuta è questa:
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
Quattro regole documentate evitano gli errori più comuni. Identità, azione e modalità espressiva restano fuori da <d>; all'interno di <d> vanno esclusivamente il tag della lingua e le parole esatte, con la punteggiatura originale. Per il voiceover bisogna usare letteralmente la frase "says in an off-screen voiceover", seguita subito dall'indicazione che le labbra del personaggio in scena rimangono chiuse. Se un dialogo attraversa un taglio, inserisci <scenetrans> nei due punti di raccordo insieme a una frase di continuità, come "continues seamlessly across the cut" oppure "carries over from the previous shot". Se la battuta viene interrotta dalla fine del video, usa <cutoff>.
Le virgolette hanno un solo uso riservato: qualsiasi testo visibile nel video — banner, cartelli, etichette, insegne al neon o sottotitoli — va scritto tra doppie virgolette inglesi, fedelmente e senza tradurlo. Inserire il dialogo parlato tra virgolette è il motivo documentato per cui H3 lo può rendere come sottotitolo impresso nel video anziché come voce.
I due campi dedicati all'audio
Il post di lancio di MiniMax afferma che tutto l'audio prodotto da H3 è stereo nativo e viene generato insieme al video. Per questo il suono ha due campi dedicati, anziché ridursi a qualche aggettivo nella descrizione. overall_soundscape copre atmosfera e suoni fisici — vento, pioggia, traffico, passi, tessuti in movimento, impatti, respiro, risate — in 1–4 frasi; N/A è riservato alla richiesta esplicita di silenzio completo. non_diegetic_music riguarda invece la musica che i personaggi non possono sentire, da descrivere tramite strumentazione, velocità, ritmo e variazioni dinamiche. Le parole astratte di atmosfera, come "epic" o "emotional", sono esplicitamente sconsigliate; se non vuoi musica, il valore corretto è N/A.
L'audio diegetico, come canto, una radio nella scena o un musicista di strada, non appartiene a nessuno di questi due campi. Va inserito in integrated_multimodal_description, dove vive la timeline. La separazione non è solo formale: la guida di APIMODELS osserva che per risultati affidabili servono vincoli sonori espliciti, e lasciare non_diegetic_music non specificato può introdurre musica mai richiesta.
Prompt con riferimenti: etichette e conservazione degli attributi
La guida reference si applica quando asset caricati guidano la generazione e richiede sei sezioni in ordine fisso: subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape, non_diegetic_music. Per le attività di generazione, il corpo di detailed_description è normalmente lungo 350–500 parole inglesi; i prompt ricchi di dialoghi devono comunque contenere tutta la timeline parlata, anche se questo porta oltre il conteggio indicato.
Il sistema si basa su quattro tipi di etichette:
| Etichetta | Uso |
|---|---|
<Subject N> | Contenuto visibile effettivamente usato nell'output: persona, prodotto, scena, outfit, stile o azione estratti da qualsiasi asset |
<Picture N> | Immagine usata come ancoraggio concreto di un frame: primo frame, keyframe, ultimo frame o riferimento compositivo |
<Video N> | Relazione con un video completo: sorgente di editing, punto di continuazione, struttura della camera o dei tagli, ritmo |
<Audio N> | Segnale audio copiato o preso come riferimento: timbro vocale, testo cantato, beat o effetti sonori |
La numerazione è indipendente per ciascun tipo. Un video caricato può quindi essere <Video 1>, mentre la sua traccia audio può essere <Audio 2>. Per un soggetto che parla, le etichette si combinano con gli ID del parlante: <Subject 3> (S1).
La sezione summary si apre con un prefisso dell'attività tra parentesi quadre, come [reference generation] oppure [video editing + audio reuse]. Un edit video deve iniziare con "The target video is an edited version of <Video 1>." Nella sezione retention_analysis, assegna poi un marcatore a ogni etichetta: per gli elementi visivi, fully_preserved, partially_preserved, attribute_transfer o weak_reference; per l'audio, fully_copy, partially_copy, reference o weak_reference. Questi marcatori comunicano a H3, per esempio, che il volto deve restare invariato mentre l'outfit può cambiare.
Uno scheletro minimo per la modalità reference, nell'ordine documentato:
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
Quando H3 sbaglia: problema, causa e correzione
| Sintomo | Probabile causa nel prompt | Correzione |
|---|---|---|
| Audio incomprensibile o "Sims-speak" inventato | Dialogo non strutturato, assenza di ID dei parlanti o personaggi non parlanti non descritti | Aggiungi ID (S1)/(S2), racchiudi le parole esatte in <d>[Language] ...</d> e specifica esplicitamente che i personaggi silenziosi non parlano |
| Sottotitoli impressi sul dialogo | Parole pronunciate scritte tra virgolette | Riserva le virgolette al testo visibile sullo schermo e sposta il dialogo nei tag <d> |
| Dialogo assegnato al personaggio sbagliato | L'ID del parlante non è collegato a una persona descritta | Alla prima apparizione, definisci gli attributi del parlante — età, presenza in campo, voce — e mantieni l'ID stabile tra le inquadrature |
| Colonna sonora o musica mai richiesta | non_diegetic_music assente o troppo vago | Quando non vuoi musica, scrivi non_diegetic_music: N/A: una soluzione che le discussioni della community indicano come efficace per eliminare l'audio indesiderato |
| Tagli non pianificati | I cambi di scena implicano tagli senza timestamp | Usa [Shot N] At 00:03.500 con frasi di taglio esplicite; per un piano sequenza, richiedi esplicitamente "no cuts" |
| Volto, outfit o prodotto cambiano nel corso del video | Il ruolo del riferimento non è stato dichiarato | Aggiungi una riga in retention_analysis con fully_preserved per quell'etichetta e ripeti l'etichetta a ogni apparizione |
Le righe su audio incomprensibile e sottotitoli derivano direttamente dalle regole sintattiche ufficiali. Le discussioni della community su r/StableDiffusion riportano indipendentemente che le stesse correzioni funzionano anche nella pratica, incluso non_diegetic_music: N/A, tra le soluzioni più citate contro l'audio indesiderato.
Limiti operativi e costo dei test
I limiti di generazione contano, perché la lunghezza del prompt è finita e ogni iterazione ha un costo. Questi sono i limiti documentati nell'API ufficiale e presso i provider ospitati:
| Parametro | Valore | Nota |
|---|---|---|
| Durata clip | Fino a 15 s, in secondi interi | Il minimo è 5 s sugli endpoint fal/EvoLink; alcuni documenti API V2 indicano 4 s |
| Risoluzione | 768p e 2K, 24 FPS | Secondo MiniMax, 2K è la risoluzione di output predefinita |
| File di riferimento | Fino a 9 immagini, 3 video, 3 audio | 12 file in totale; l'audio non può mai essere l'unico riferimento |
| Lunghezza prompt | ~7.000 caratteri | Documentazione fal e API V2; APIMODELS indica 20.480 — verifica il tuo provider |
| Rapporti d'aspetto | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptive | Image-to-video segue il rapporto dell'immagine di input |
I prezzi variano in base al provider: considerali quindi istantanee datate, non listini permanenti. Su fal, una generazione 2K costava $0.26 al secondo secondo una rilevazione prezzi del 1 agosto ($1.30 per 5 secondi, $3.90 per 15), con le prime cinque immagini di riferimento gratuite e immagini aggiuntive a $0.08 ciascuna. Su APIMODELS, H3 costa $0.088 al secondo ($1.32 per una clip di 15 secondi) e vengono addebitate soltanto le richieste riuscite. Per confronto, ecco i prezzi al secondo sullo stesso marketplace:
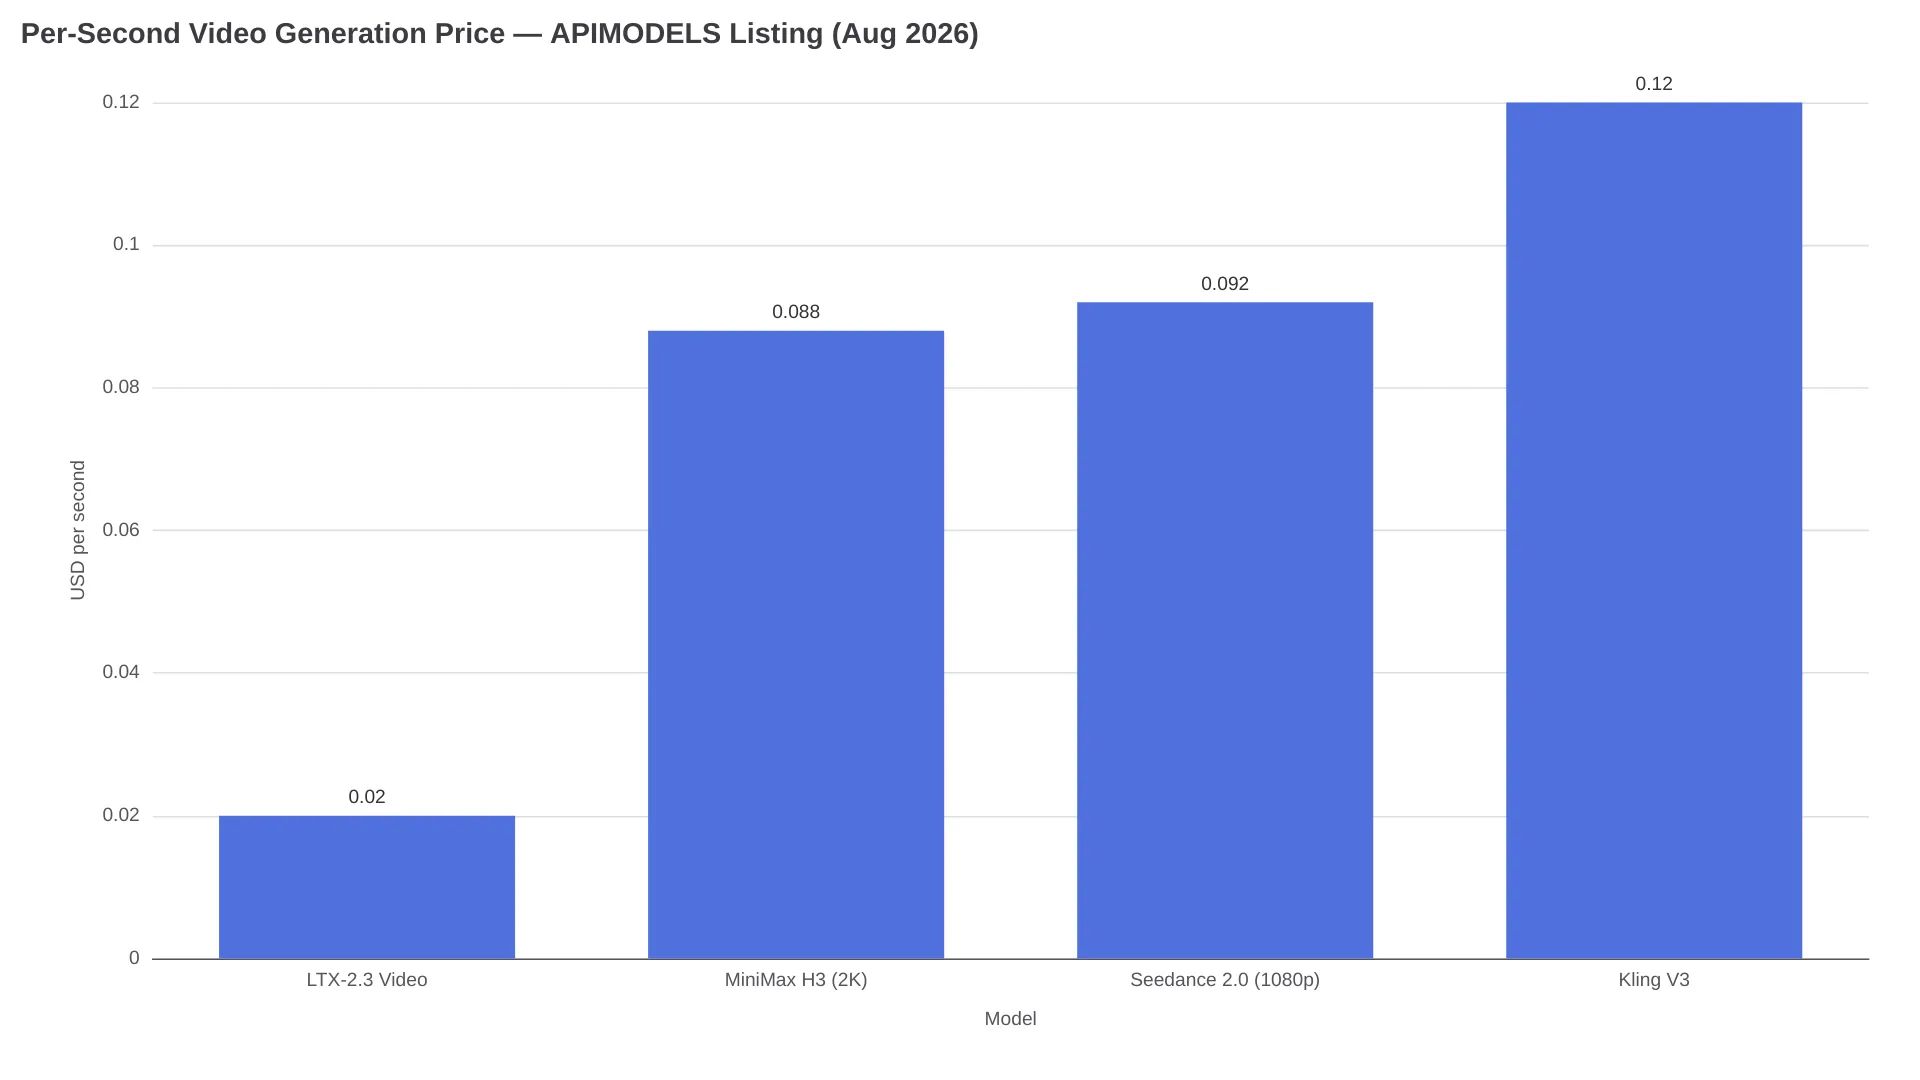
Il vero costo è quello dei tentativi. Un prompt strutturato per un dialogo di 15 secondi che funziona al secondo tentativo costa $2.64 su APIMODELS; un prompt non strutturato che richiede cinque tentativi per ottenere una clip utilizzabile costa $6.60. Per iterare prompt su un endpoint H3 ospitato, la pagina API MiniMax H3 di AIReiter offre il modello con i prezzi aggiornati mostrati direttamente nella pagina.
Template pronti da copiare e incollare
Questi due scheletri base coprono la maggior parte dei lavori brevi. Compila le parti tra parentesi, mantenendo esattamente invariati i nomi dei campi e le righe vuote:
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/APer prompt già testati, anziché campi vuoti, ci sono tre raccolte con link alle fonti. ecomimagelab/awesome-minimax-h3-prompts: 58 prompt, di cui 39 ufficiali e 19 testati dalla community, ciascuno accompagnato dal video risultante scaricabile secondo la regola "No video, no entry." imagineVid/Awesome-minimax-h3-prompts-and-skills: 28 casi verificati in sei workflow, dalla continuità dell'identità con omni-reference ai dialoghi con audio nativo. La galleria APIMODELS: 226 prompt consultabili per caso d'uso, ciascuno con clip allegata; la sua regola in una riga è "References carry identity, the prompt carries action."
Esistono anche due scorciatoie per scrivere gli script. Alcuni utenti Reddit riportano buoni risultati incollando una guida ufficiale in un LLM e indicando la modalità desiderata — per esempio "rewrite this idea as T2VA using the base guide" — mentre un'estensione ComfyUI, MiniMax H3 Prompt Writer v0.3, genera il formato strutturato all'interno di un workflow a nodi.
FAQ
Qual è la differenza tra le guide prompt base e reference di MiniMax H3?
La guida base copre quattro modalità senza riferimenti — T2VA, I2VA, FL2VA e L2VA — costruite sui tre campi fondamentali. La guida reference aggiunge sei sezioni obbligatorie e le etichette <Subject>/<Picture>/<Video>/<Audio> quando immagini, video o audio caricati guidano la generazione.
Come si etichettano i parlanti in un prompt MiniMax H3?
Assegna ID stabili (S1), (S2) seguendo l'ordine del primo evento vocale, mantieni lo stesso ID tra le inquadrature, usa (S1,S2) per il parlato simultaneo e inserisci nei tag <d> soltanto il tag della lingua e le parole esatte.
Come posso eliminare l'audio incomprensibile in MiniMax H3?
Struttura il dialogo con ID dei parlanti e tag <d> fedeli alla battuta, descrivi come silenziosi i personaggi che non parlano e imposta non_diegetic_music: N/A quando non vuoi una colonna sonora: sono soluzioni sia documentate sia confermate dalla community.
I dialoghi di MiniMax H3 vanno messi tra virgolette?
No. Le virgolette sono riservate al testo visibile nel video; il dialogo parlato va inserito in <d>[Language] ...</d>, altrimenti H3 può trasformarlo in sottotitoli sullo schermo.
Quanto può essere lungo un prompt MiniMax H3?
Circa 7.000 caratteri su fal e nella documentazione dell'API V2 ufficiale, anche se APIMODELS indica 20.480. Verifica il limite del tuo endpoint specifico prima di scrivere uno script da 10.000 caratteri.
Cosa non risolve nemmeno una sintassi perfetta
Una buona struttura aumenta la probabilità di successo, ma non rende la generazione deterministica. La fedeltà esatta di identità, logo e prodotto resta probabilistica: i wrapper API sviluppati dalla community dichiarano esplicitamente di non poter garantire una coerenza a livello di singolo frame, e gli esempi più solidi delle librerie di prompt impongono l'identità con lunghi blocchi di vincoli, non con garanzie misurate. I <tag> inline per suoni non verbali sono sperimentali nella community e producono risultati variabili a seconda della generazione. Valuta l'output in base al costo per secondo approvato, non al costo per richiesta, e tieni aperte in una scheda le guide ufficiali base e reference mentre scrivi.
Approfondimenti correlati: la panoramica sul lancio di MiniMax H3 spiega cos'è il modello, mentre MiniMax H3 vs LTX 2.3 lo confronta con l'alternativa dal costo al secondo più basso.